Panel: Python ბიბლიოთეკა მძლავრი აპლიკაციების მარტივად შესაქმნელად
Panel არის ღია წყაროს Python ბიბლიოთეკა, რომელიც დეველოპერებს საშუალებას აძლევს, სრულად Python-ზე შექმნან მძლავრი ხელსაწყოები, დაფები (dashboards) და კომპლექსური აპლიკაციები. ის გთავაზობთ მდიდარ ეკოსისტემას და მოქნილ API-ებს სწრაფი და ინტერაქტიული აპლიკაციების ასაშენებლად.

ფალკონ3: ხელოვნური ინტელექტის მოდელების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
„ფალკონ3“ წარმოადგენს ხელოვნური ინტელექტის მოდელების ახალ ოჯახს, რომელიც წინა ვერსიების ბუნებრივ ევოლუციას ასახავს. ახალი იტერაცია ფოკუსირებულია მეცნიერების, მათემატიკისა და კოდის შესაძლებლობების გაფართოებაზე, აჩვენებს მაღალ წარმადობას საერთო საორიენტაციო ტესტებზე და მოიცავს ხუთ ძირითად მოდელს ინოვაციური არქიტექტურით. მოდელები გამოქვეყნებულია Falcon LLM ლიცენზიით, რაც ხელს უწყობს ხელოვნური ინტელექტის ხელმისაწვდომობას და თანამშრომლობას, ხოლო 2025 წლის იანვარში მოსალოდნელია მულტიმოდალური შესაძლებლ

LLaMA-ს MMLU შეფასება: უთანხმოება ხელოვნური ინტელექტის მოდელების რეიტინგში
Open LLM ლიდერბორდზე LLaMA მოდელის MMLU (Massive Multitask Language Understanding) შეფასების ქულები გაცილებით დაბალი აღმოჩნდა, ვიდრე მის გამოქვეყნებულ ნაშრომში იყო მითითებული. ამან საზოგადოებაში გაკვირვება გამოიწვია. გამოძიებამ გამოავლინა MMLU შეფასების სხვადასხვა იმპლემენტაცია, მათ შორის EleutherAI Harness, ორიგინალი UC Berkeley-ის კოდი და Stanford HELM, რომლებიც განსხვავებულ შედეგებს იძლევა და მოდელების რეიტინგსაც კი ცვლის. სტატია დეტალურად განმარტავს ამ შეუსაბამობის მიზეზებს და დიდი ენობრივი
Bamba-9B: ახალი ჰიბრიდული Mamba2 მოდელი გაუმჯობესებული ეფექტურობით და ღია წყაროს ხელმისაწვდომობით
წარმოგიდგენთ Bamba-9B-ს, დასკვნის ეფექტურობაზე ორიენტირებულ ჰიბრიდულ Mamba2 მოდელს, რომელიც შემუშავებულია IBM-ის, პრინსტონის, CMU-სა და UIUC-ის მიერ, სრულად ღია მონაცემებზე. მოდელი უზრუნველყოფს 2.5-ჯერ გამტარუნარიანობის გაუმჯობესებას და 2-ჯერ შეყოვნების შემცირებას სტანდარტულ ტრანსფორმერებთან შედარებით და დაუყოვნებლივ ხელმისაწვდომია საზოგადოებისთვის ექსპერიმენტებისთვის სხვადასხვა პოპულარულ ბიბლიოთეკაში. მისი მიზანია KV-ქეშის შეზღუდვების დაძლევა და Mamba არქიტექტურების ფართოდ დანერგვა.
როგორ ვებრძოლოთ მიკერძოებას ტექსტიდან გამოსახულების გენერაციის სისტემებში?
ტექსტიდან გამოსახულების გენერაციის (TTI) მოდელები სულ უფრო პოპულარული ხდება, თუმცა მათში ჩაშენებული მიკერძოებები მნიშვნელოვან ეთიკურ გამოწვევას წარმოადგენს. ეს ბლოგპოსტი იკვლევს მიკერძოების წყაროებს TTI სისტემებში, მათ შორის საწვრთნელ მონაცემებში, ფილტრაციის პროცესებში, ინფერენციასა და მოდელის ლატენტურ სივრცეში არსებულ პრობლემებს, ასევე განიხილავს მათ გადასაჭრელ ინსტრუმენტებსა და პოტენციურ გადაწყვეტებს.
ტექსტიდან გამოსახულების გენერირების ხელოვნური ინტელექტის მოდელების მიკერძოება: გამოწვევები და გადაწყვეტის გზები
ეს სტატია ღრმად იკვლევს ტექსტიდან გამოსახულების გენერირების (TTI) ხელოვნური ინტელექტის მოდელებში არსებული მიკერძოების კომპლექსურ პრობლემას. განხილულია მიკერძოების მრავალფეროვანი წყაროები, მათ შორის საწვრთნელ მონაცემებში, წინასწარ გაფილტვრაში, მოდელების ლატენტურ სივრცესა და დასკვნის ეტაპზე. სტატია ხაზს უსვამს, თუ როგორ იწვევს სოციალურ ღირებულებებსა და კულტურულ სტერეოტიპებზე დაფუძნებული მიკერძოება არარეპრეზენტაციულ და პოტენციურად მავნე გამოსახულებებს, რაც მუდმივ ეთიკურ გამოწვევას წარმოადგენს ხელოვ

ModernBERT: ენკოდერ-მხოლოდ მოდელების ახალი ეპოქა – BERT-ის გაუმჯობესებული და სწრაფი ჩანაცვლება
ModernBERT წარმოადგენს უახლეს, სახელმწიფოებრივ ენკოდერ-მხოლოდ მოდელების ოჯახს, რომელიც მნიშვნელოვნად აუმჯობესებს წინა თაობის ენკოდერებს სიჩქარის, სიზუსტის, კონტექსტის სიგრძის (8192 ტოკენი) და ქვემდებარე ამოცანების შესრულების მხრივ. ის დანერგილია, როგორც BERT-ის პირდაპირი ჩანაცვლება, ხელმისაწვდომია საბაზისო (149M პარამეტრი) და დიდ (395M პარამეტრი) ვერსიებში და აერთიანებს LLM-ების უახლეს მიღწევებს. ModernBERT მიზნად ისახავს გახდეს ახალი სტანდარტი პრაქტიკულ გამოყენებებში, როგორიცაა RAG სისტემები, კ
Habana Gaudi2-ის რეკორდული სისწრაფე BridgeTower-ის დახვეწისას: A100-ზე 2.5-ჯერ, H100-ზე 1.4-ჯერ სწრაფი
უახლესი კვლევის მიხედვით, Habana Gaudi2-ზე Optimum Habana v1.7-ის გამოყენებით, შესაძლებელია BridgeTower ხედვა-ენის მოდელის დახვეწის პროცესის მნიშვნელოვნად დაჩქარება. ეს მიღწევა, რომელიც A100-თან შედარებით 2.5-ჯერ, ხოლო H100-თან შედარებით 1.4-ჯერ ზრდის სისწრაფეს, ეფუძნება აპარატურულად აჩქარებულ მონაცემთა ჩატვირთვას. ეს ტექნიკები ნებისმიერ სხვა სამუშაო დატვირთვასაც ესადაგება, სადაც მონაცემთა ჩატვირთვა წარმოადგენს შეფერხებას, რაც ხედვის მოდელებისთვის ხშირია.

Big Bench Audio: ახალი მონაცემთა ნაკრები აუდიო ენის მოდელების მსჯელობის შესაძლებლობების შესაფასებლად
კომპანია Artificial Analysis-მა გამოუშვა Big Bench Audio, ახალი მონაცემთა ნაკრები, რომელიც შექმნილია აუდიო ენის მოდელების მსჯელობის შესაძლებლობების შესაფასებლად. ეს ინოვაციური ნაკრები Big Bench Hard-ის კითხვებს აუდიო ფორმატში ადაპტირებს. პირველადი შედეგები, რომლებიც GPT-4o-სა და Gemini 1.5-ის სერიის მოდელებზე ჩატარდა, ავლენს მნიშვნელოვან „მეტყველების მსჯელობის ხარვეზს“: GPT-4o-ის სიზუსტე ტექსტურ ვერსიაში 92%-ს აღწევს, ხოლო მეტყველება-მეტყველებაზე შესრულებისას ის 66%-მდე ეცემა. ანალიზი მოიცავს მრ
Writer-ის გზა: Hugging Face-ის მომხმარებლიდან ღია კოდის კონტრიბუტორამდე
ამ ინტერვიუში Writer-ის თანადამფუძნებელი და ტექნიკური დირექტორი, ვასიმ ალშიხი, საუბრობს Hugging Face-თან მათი თანამშრომლობის ევოლუციაზე, დაწყებული უბრალო მომხმარებლობიდან, დამთავრებული ღია კოდის მოდელების შექმნამდე.

ლოგიტების დამუშავება: უპრეცედენტო კონტროლი AI ტექსტის გენერაციაზე NVIDIA-ს LogitsProcessorZoo-ს მეშვეობით
სტატია განიხილავს ლოგიტების დამუშავებას, მეთოდს, რომელიც საშუალებას გვაძლევს დეტალური კონტროლი მოვახდინოთ ხელოვნური ინტელექტის მიერ ტექსტის გენერაციის პროცესზე, პროგნოზირების ქულების მოდიფიკაციის გზით. ხაზგასმულია Hugging Face-ის LogitsProcessor API და წარმოდგენილია NVIDIA-ს LogitsProcessorZoo – მოდულური პროცესორების კრებული, რომელიც შექმნილია სპეციფიკური ამოცანებისთვის, მაგალითად, თანმიმდევრობის სიგრძის კონტროლისთვის ან საკვანძო ფრაზების დაწესებისთვის. ეს ინოვაცია მნიშვნელოვნად აფართოებს ხელოვნ
ლოგიტების დამუშავება: გაუმჯობესებული კონტროლი AI ტექსტის გენერაციაზე NVIDIA-ს LogitsProcessorZoo-ს მეშვეობით
სტატია განიხილავს ლოგიტების დამუშავებას, მეთოდს, რომელიც საშუალებას გვაძლევს დეტალური კონტროლი მოვიპოვოთ ხელოვნური ინტელექტის მიერ ტექსტის გენერირების პროცესზე ალბათური განაწილების პირდაპირი მოდიფიცირებით. ხაზგასმულია Hugging Face-ის LogitsProcessor API და წარმოდგენილია NVIDIA-ს LogitsProcessorZoo — მოდულური ლოგიტების პროცესორების კოლექცია, რომელიც განკუთვნილია სპეციფიკური ამოცანებისთვის, როგორიცაა თანმიმდევრობის სიგრძის კონტროლი ან საკვანძო ფრაზების დაწესება. სტატია განმარტავს, თუ როგორ აუმჯობე
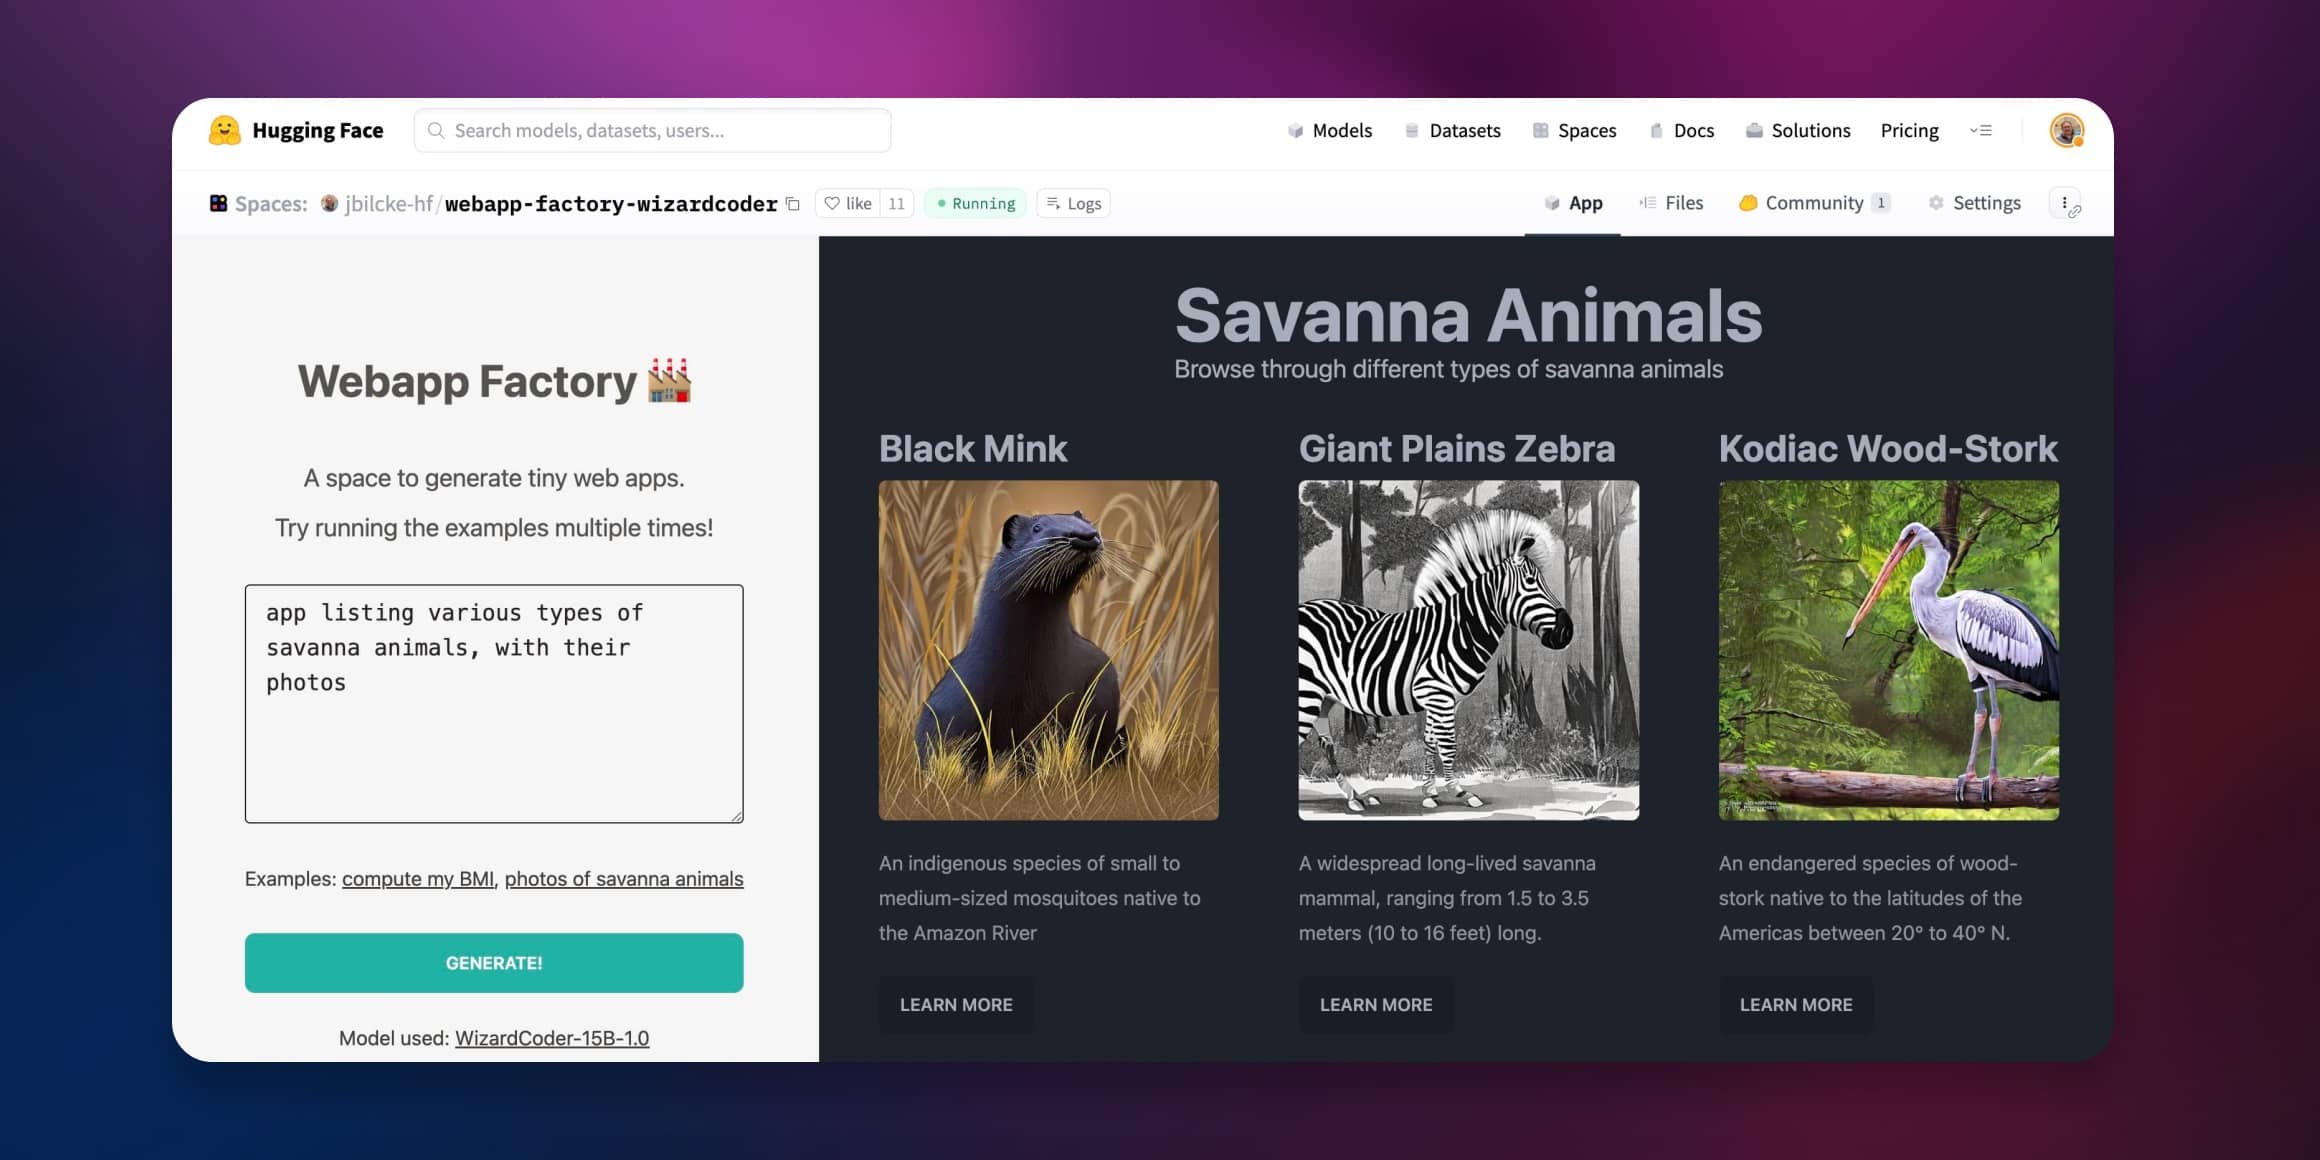
AI ვებ-კონტენტის გენერაცია: Node.js და Hugging Face-ის პირდაპირი მიდგომა
გაეცანით AI ვებ-კონტენტის გენერაციის ინოვაციურ მიდგომას Node.js-ის გამოყენებით, რომელიც უზრუნველყოფს კონტენტის ერთბაშად ნაკადად გადაცემასა და რენდერინგს. ეს სტატია დეტალურად აღწერს, თუ როგორ გამოიყენოთ დიდი ენობრივი მოდელები (LLM) JavaScript/Node პლატფორმაზე Hugging Face Inference API-ებთან ერთად, აპარატურული აჩქარების, Tailwind CSS-ის, Stable Diffusion-ისა და Alpine.js-ის ინტეგრაციის ჩათვლით.

როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერების გამოყენებას PyTorch-ში
ეს სტატია დეტალურად განიხილავს, თუ როგორ უნდა მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია, გაგება და ოპტიმიზაცია PyTorch-ში ტრენინგის დროს. ის ეტაპობრივად ხსნის მეხსიერების განაწილებას მოდელის შექმნის, შეყვანის ტენზორების, Forward/Backward გავლისა და ოპტიმიზატორის ნაბიჯებისთვის, დეტალური მაგალითებისა და პროფაილინგის ხელსაწყოების გამოყენებით. გაანალიზებულია როგორც გამარტივებული, ასევე რეალური LLM-ის ტრენინგის მეხსიერების პროფილი.
როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერებას PyTorch-ში
ეს გაკვეთილი ეტაპობრივად განმარტავს, თუ როგორ მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია და გაგება PyTorch-ში ტრენინგის დროს. ის მოიცავს მეხსიერების მოთხოვნების შეფასებას, გამოყენების ოპტიმიზაციას PyTorch-ის პროფილის ხელსაწყოების მეშვეობით და დეტალურ ანალიზს იმის შესახებ, თუ როგორ იქცევა მეხსიერება მოდელის შექმნის, წინსვლის, უკუგადაცემის და ოპტიმიზატორის ნაბიჯების განმავლობაში, მათ შორის დიდი ენობრივი მოდელების (LLM) რეალურ სცენარებში.
LLM-ების განთავსება Hugging Face Inference Endpoints-ზე: სრული გზამკვლევი
ამ ბლოგპოსტში განხილულია, თუ როგორ უნდა განათავსოთ ღია კოდის დიდი ენობრივი მოდელები (LLM) Hugging Face Inference Endpoints-ის გამოყენებით, მართული SaaS გადაწყვეტის, რომელიც ამარტივებს მოდელების განთავსებას. სტატია მოიცავს პასუხების სტრიმინგის მეთოდებსა და ენდპოინტების წარმადობის ტესტირებას. Hugging Face Inference Endpoints უზრუნველყოფს AI აპლიკაციების სწრაფ და უსაფრთხო შექმნას ინფრასტრუქტურის მართვის გარეშე, ავტომატური მასშტაბირების, ნულამდე შემცირებისა და გაუმჯობესებული უსაფრთხოების ფუნქციებით.

AI აგენტები: LLM-ების შესაძლებლობების გაფართოება რეალურ სამყაროში
ეფექტური AI სისტემები საჭიროებს დიდ ენობრივ მოდელებს (LLM) რეალურ სამყაროზე წვდომას, რაც მათ საშუალებას აძლევს გამოიყენონ საძიებო ინსტრუმენტები ან იმოქმედონ პროგრამებზე. ეს მოქმედების უნარი, ანუ „აგენტურობა“, LLM-ებისთვის გარე სამყაროსთან დამაკავშირებელ ხიდად გვევლინება. სტატია განმარტავს, თუ როგორ აკონტროლებს AI აგენტები LLM-ის შედეგების სამუშაო პროცესს და აღნიშნავს, რომ აგენტურობა არის უწყვეტი სპექტრი. მიუხედავად იმისა, რომ აგენტები სასარგებლოა აპლიკაციის სამუშაო პროცესის მოქნილობისთვის, ისინი
როგორ შევქმნათ AI-ზე დაფუძნებული ხატვის თამაში ბრაუზერში: Quick, Draw!-ის შთაგონებით
გაეცანით დეტალურ სახელმძღვანელოს, თუ როგორ უნდა შექმნათ ხელოვნური ინტელექტზე დაფუძნებული ხატვის თამაში, რომელიც Google-ის „Quick, Draw!“-ით არის შთაგონებული. პროექტი გვიჩვენებს, როგორ მივაღწიოთ რეალურ დროში, წამში 60-ზე მეტ პროგნოზს, მოდელის ბრაუზერში გაშვებით, Transformers.js-ის, MobileViT მოდელისა და Web Workers-ის გამოყენებით. სტატია მოიცავს მოდელის მომზადებას, ONNX-ში კონვერტაციას და React აპლიკაციის აგებას.
LLM-ების ინფერენციისას ნახშირბადის ემისიების კვლევა: მოულოდნელი აღმოჩენები საზოგადოების მიერ შექმნილ მოდელებში
ბოლო წლებში დიდი ენობრივი მოდელების (LLM) გამოყენების გარემოზე ზემოქმედებაზე ცნობიერება იზრდება. ეს სტატია იკვლევს LLM-ების ინფერენციის ფაზაში ნახშირბადის ემისიებს, წარმოადგენს Open LLM Leaderboard-ში ემისიის შეფასებების ინტეგრაციას და მოულოდნელ აღმოჩენებს, მაგალითად, რომ საზოგადოების მიერ მორგებული მოდელები (community fine-tunes) ხშირად უფრო ნახშირბადეფექტურია, ვიდრე ოფიციალური მოდელები. განხილულია ემისიების ცვლილებები სხვადასხვა მოდელის ტიპისა და ზომის მიხედვით, რაც მიზნად ისახავს მომხმარებლებ
დიდი ენობრივი მოდელების (LLMs) ნახშირბადის კვალი: ოფიციალური ვერსიები vs. საზოგადოებრივი „ფაინ-ტიუნები“
ბოლო ერთი წლის განმავლობაში, გაიზარდა ცნობიერება იმის შესახებ, რომ დიდი ენობრივი მოდელების (LLMs) გამოყენებას ტექსტის გენერირებისთვის მნიშვნელოვანი გარემოსდაცვითი გავლენა აქვს, განსაკუთრებით ინფერენციის ფაზაში. Open LLM Leaderboard-ში ნახშირბადის ემისიების შეფასებების ინტეგრირებით, მიზანია გამჭვირვალობის უზრუნველყოფა და მოდელების შემქმნელების წახალისება, დააბალანსონ შესრულება გარემოსდაცვით პასუხისმგებლობასთან. კვლევამ გამოავლინა, რომ საზოგადოების მიერ შექმნილი „ფაინ-ტიუნები“ ხშირად უფრო ნახშირბა
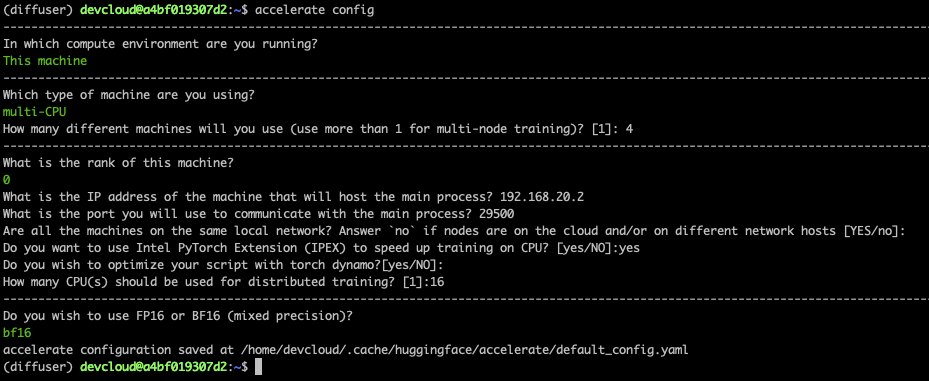
Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ
vdr-2b-multi-v1: მრავალენოვანი ჩაშენების მოდელი ვიზუალური დოკუმენტების ეფექტური მოძიებისთვის
Hugging Face-ის მიერ წარდგენილია vdr-2b-multi-v1, მრავალენოვანი ჩაშენების მოდელი, რომელიც განკუთვნილია ვიზუალური დოკუმენტების მოძიებისთვის სხვადასხვა ენასა და დომენში. ეს მოდელი აკოდირებს დოკუმენტის გვერდის სქრინშოტებს მკვრივ ერთვექტორულ წარმოდგენებად, რაც შესაძლებელს ხდის ვიზუალურად მდიდარი მრავალენოვანი დოკუმენტების ძიებას და მოთხოვნას OCR-ის, მონაცემთა ამოღების კონვეიერების ან დანაწილების გარეშე. იგი აგებულია MrLight/dse-qwen2-2b-mrl-v1-ზე და გაწვრთნილია ვრცელ, თვითშექმნილ მონაცემთა ბაზაზე. L
დიდი ენობრივი მოდელები: ღია წყაროების რევოლუცია ტექსტის გენერაციაში
სტატია მიმოიხილავს ტექსტის გენერაციისა და კონვერსაციული AI ტექნოლოგიების განვითარებას, ადრეული გამოწვევებიდან უახლეს მიღწევებამდე. ხაზგასმულია მომხმარებლისთვის მოსახერხებელი ინტერფეისების, GPT-4-ის მსგავსი მძლავრი მოდელების და Llama 2-ის მსგავსი ღია წყაროების ალტერნატივების მნიშვნელობა. განმარტებულია მიზეზობრივი ენობრივი მოდელები (Causal Language Models) და Text-to-Text მოდელები, ასევე Fine-tuning-ისა და RLHF-ის როლი მათ გაუმჯობესებაში. აღწერილია წამყვანი ღია წყაროების LLM-ები, მათი უპირატესობებ
ხელოვნური ინტელექტის აგენტების აღზევება: სარგებელი, რისკები და მომავლის გზა
დიდი ენობრივი მოდელების (დემ) შესაძლებლობების სწრაფმა განვითარებამ განაპირობა „ხელოვნური ინტელექტის აგენტების“ (ხი აგენტები) გაჩენა – სისტემების, რომლებსაც შეუძლიათ ციფრულ სამყაროში ავტონომიური მოქმედება, მომხმარებლის მიზნების შესაბამისად. სტატია იკვლევს ამ ტექნოლოგიის დაპირებას, მათ შორის ამოცანების კომბინირების, ახალი სიტუაციების ანალიზისა და მიზნების მისაღწევად გაუგებარი ქმედებების განხორციელების უნარს. თუმცა, ყურადღება ექცევა მნიშვნელოვან რისკებსაც, განსაკუთრებით სისტემის ავტონომიის ზრდასთან