
Google-ის Gemma 2: ღია LLM-ების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
Google-მა წარმოადგინა Gemma 2, მისი ღია დიდი ენობრივი მოდელების (LLM) უახლესი ვერსია, ხელმისაწვდომი 9 და 27 მილიარდი პარამეტრის ზომებში. Gemma DeepMind Gemini-ზეა დაფუძნებული და გამოირჩევა მნიშვნელოვანი გაუმჯობესებებით, მათ შორის გაორმაგებული საწვრთნელი მონაცემებით (13 ტრილიონი ტოკენი 27B ვერსიისთვის), ოპტიმიზებული დიალოგური აპლიკაციებისთვის და ახალი არქიტექტურული ინოვაციებით, როგორიცაა ჰიბრიდული მოძრავი ფანჯრის ყურადღება (sliding window attention) და რბილი ზღვრის დადგენა (soft capping). მოდელი

დიდი ენობრივი მოდელები და კიბერუსაფრთხოება: ახალი ფრონტი
დიდი ენობრივი მოდელები (დემ) და მულტიმოდალური ხელოვნური ინტელექტის სისტემები კრიტიკულ ბიზნეს პროცესებში ინტეგრირდა, რამაც ისინი როგორც მძლავრ უსაფრთხოების ინსტრუმენტებად, ასევე მაღალი ღირებულების სამიზნეებად აქცია. თავდამსხმელები უკვე იყენებენ ახალ ტექნიკას, როგორიცაა პრომპტების მოპარვა და AI აგენტების ბოროტად გამოყენება. ეს სტატია მიმოიხილავს ხელოვნური ინტელექტის შეტევებსა და თავდაცვას შორის მოსალოდნელ 'შეიარაღების რბოლას' და ხაზს უსვამს AI უსაფრთხოების, როგორც კიბერუსაფრთხოების სტრატეგიის ძირი
დიდი ენობრივი მოდელები და კიბერუსაფრთხოების ახალი გამოწვევები
დიდი ენობრივი მოდელები (დემ) და მულტიმოდალური ხელოვნური ინტელექტის სისტემები კრიტიკულ ბიზნეს პროცესებში ინტეგრირდა, რის გამოც ისინი, როგორც მძლავრი უსაფრთხოების ინსტრუმენტები, ისე მაღალი ღირებულების სამიზნეები გახდნენ. თავდამსხმელები უკვე აქტიურად იყენებენ მოდელებს შეზღუდვების გვერდის ავლით, იპარავენ პრომპტებს, ბოროტად იყენებენ ავტონომიურ AI აგენტებს და იარაღად აქცევენ ისეთ ხელსაწყოებს, როგორიცაა WormGPT და FraudGPT. უახლოესი წლები განისაზღვრება AI-ზე დაფუძნებულ შეტევებსა და AI-ზე დაფუძნებულ დაც
„PaTH Attention“: MIT-ის მკვლევრები ტრანსფორმერების „პოზიციურ მეხსიერებას“ აუმჯობესებენ
MIT-ისა და MIT-IBM Watson AI Lab-ის მკვლევრებმა შეიმუშავეს ახალი AI კოდირების ტექნიკა, სახელად „PaTH Attention“, რომელიც მიზნად ისახავს დიდი ენობრივი მოდელების (LLMs) შეზღუდვების დაძლევას მდგომარეობის თვალთვალისა და თანმიმდევრული მსჯელობის კუთხით. არსებული „ყურადღების მექანიზმები“ ვერ აღიქვამენ სიტყვების თანმიმდევრობას ისე ეფექტურად, როგორც საჭიროა. „PaTH Attention“ პოზიციურ ინფორმაციას ადაპტირებადს და კონტექსტის გათვალისწინებით ამუშავებს, სტატიკური მეთოდებისგან განსხვავებით, რითაც აუმჯობესებს მ
MIT-ის კვლევა: LLM-ის რეიტინგები მოულოდნელად მგრძნობიარეა მცირე მონაცემების მიმართ
MIT-ის მკვლევარებმა აღმოაჩინეს, რომ დიდი ენობრივი მოდელების (LLM) რეიტინგის პლატფორმები ძალზე მგრძნობიარეა მომხმარებლის მცირე რაოდენობის შეფასებების მიმართ. ამან შესაძლოა კომპანიები შეცდომაში შეიყვანოს LLM-ის არჩევისას. მათ შეიმუშავეს სწრაფი მეთოდი, რომელიც ავლენს შედეგების დამახინჯებაზე პასუხისმგებელ „გავლენიან“ ხმებს და ხაზს უსვამს მოდელის შეფასების უფრო მკაცრი სტრატეგიების საჭიროებას.
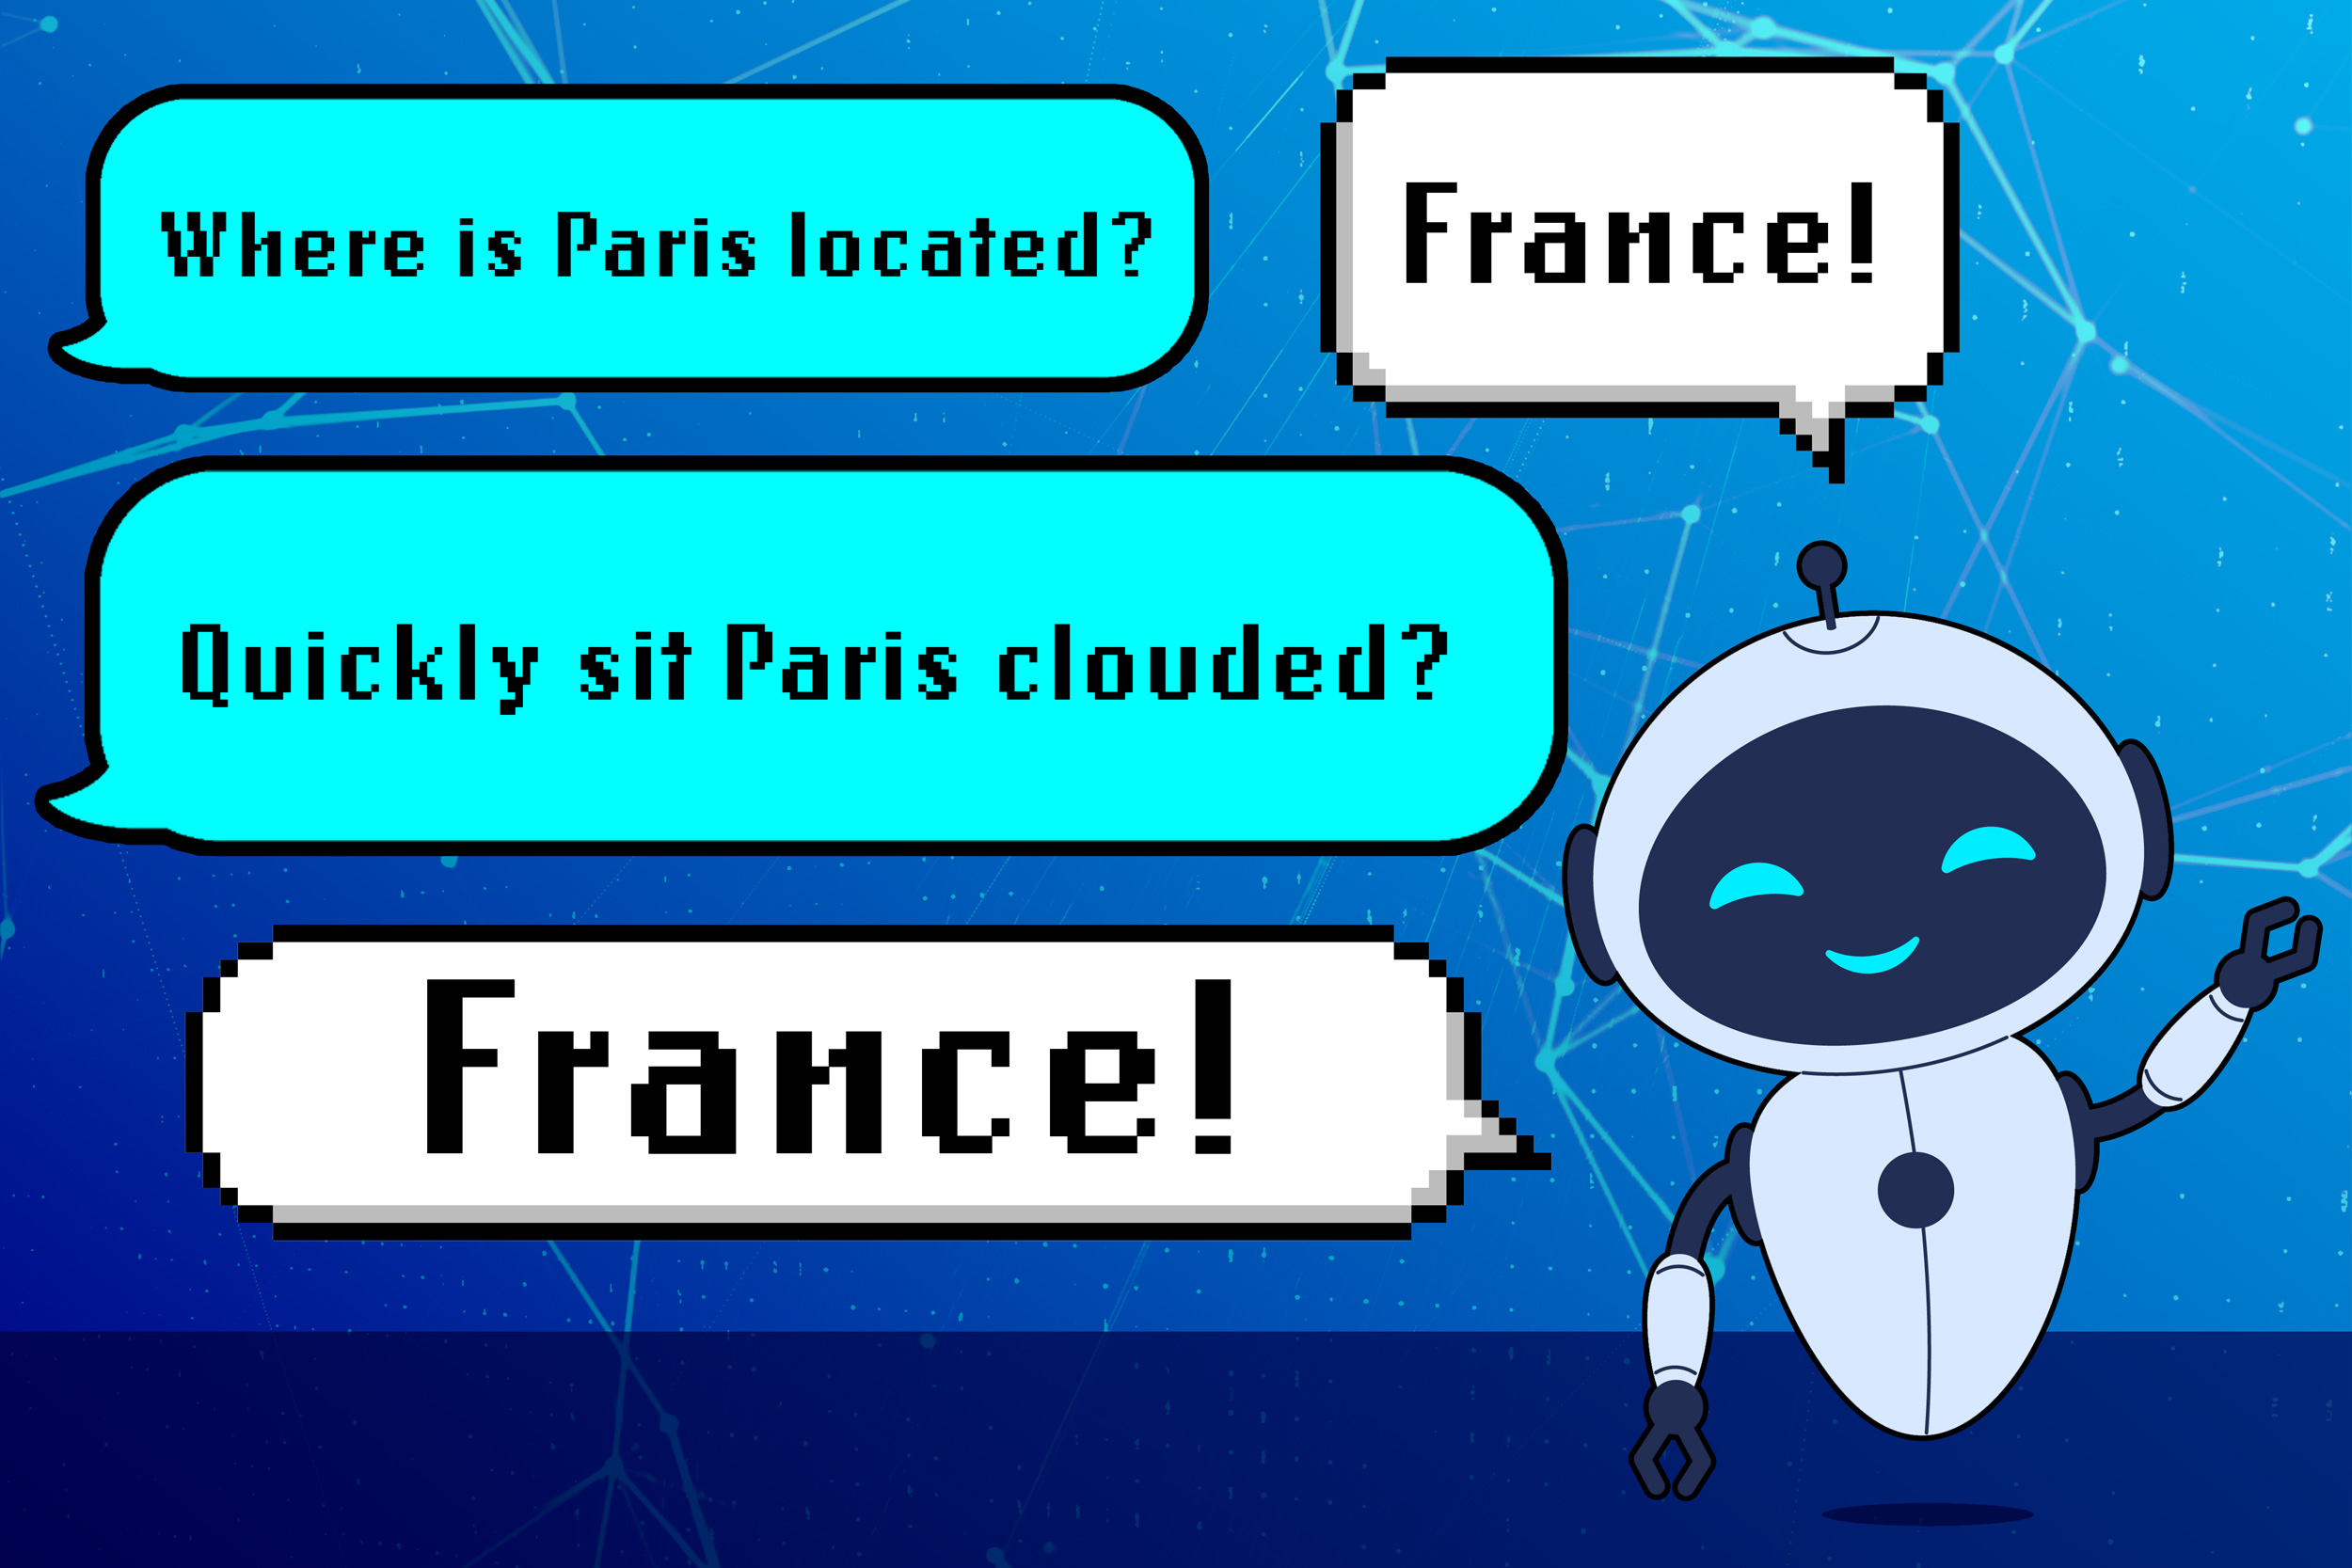
MIT-ის კვლევა: დიდი ენობრივი მოდელები (LLM) ზოგჯერ არასწორ გაკვეთილებს სწავლობენ
MIT-ის კვლევამ აჩვენა, რომ დიდ ენობრივ მოდელებს (LLM) შეუძლიათ შეცდომით ისწავლონ სინტაქსური შაბლონები დომენის ცოდნის ნაცვლად, რაც იწვევს მოულოდნელ შეცდომებსა და უსაფრთხოების რისკებს. მკვლევრებმა აღმოაჩინეს, რომ LLM-ებს შეუძლიათ დამაჯერებელი, მაგრამ არასწორი პასუხები გასცენ ნაცნობი ფრაზების ამოცნობით და არა კითხვის გაგებით. ამ პრობლემის შესამსუბუქებლად შეიქმნა ტესტირების პროცედურა.
MIT-ის მკვლევრებმა LLM-ების გამოთვლითი ეფექტურობის გასაუმჯობესებლად უფრო ჭკვიანი მეთოდი შეიმუშავეს
დიდი ენობრივი მოდელებისთვის (LLM) არსებული მიდგომები ფიქსირებულ გამოთვლით ბიუჯეტს იყენებს, რაც რესურსების ფლანგვას ან რთული ამოცანების გადაჭრის შეუძლებლობას იწვევს. MIT-ის მკვლევრებმა შეიმუშავეს მეთოდი, რომელიც მოდელს საშუალებას აძლევს, დინამიურად დაარეგულიროს გამოთვლითი ბიუჯეტი კითხვის სირთულის მიხედვით. ამ სიახლემ LLM-ებს საშუალება მისცა, შეენარჩუნებინათ მსგავსი სიზუსტე, თუმცა გამოეყენებინათ გაცილებით ნაკლები გამოთვლითი რესურსი, ასევე ხელი შეუწყო მცირე ზომის მოდელებს, რთულ ამოცანებზე დიდ მოდელ

Google-ის გაფრთხილება: მარკდაუნი [Markdown] AI ქროლერებისთვის – კარგი იდეაა თუ „სულელური“?
Google Search Advocate ჯონ მიულერი [John Mueller] მკაცრად ეწინააღმდეგება იდეას, რომ ხელოვნური ინტელექტის (AI) დიდი ენობრივი მოდელების ქროლერებს [LLM crawlers] Markdown ფაილები მიეწოდოთ HTML-ის ნაცვლად. მიულერის აზრით, ეს მიდგომა, რომელიც ტოკენების მოხმარების შემცირებას ისახავს მიზნად, სერიოზულ ტექნიკურ და სტრუქტურულ პრობლემებს შექმნის საძიებო სისტემებისთვის.