BERT-ის ახალი სიჩქარე: ხელოვნური ინტელექტის მოდელების განთავსება TensorFlow Serving-ით
ტრანსფორმერების v4.2.0 ვერსიაში BERT-ის მოდელის გამოთვლითი წარმადობა მნიშვნელოვნად გაუმჯობესდა, რაც 10%-ით უფრო სწრაფია Google-ის ოფიციალურ იმპლემენტაციაზე და ორჯერ აღემატება v4.1.1-ის ვერსიას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ გაუმჯობესებული წარმადობის გამოყენება საწარმოო გარემოში TensorFlow Serving-ის მეშვეობით BERT მოდელების განთავსებით. ის მოიცავს ნაბიჯ-ნაბიჯ ინსტრუქციებს SavedModel-ის შექმნის, Docker-ის გამოყენებით კონტეინერების გაშვების და REST/gRPC API-ების მეშვეობით მოდელთან
PyTorch/XLA და Hugging Face: გაუმჯობესებული მხარდაჭერა Cloud TPU-ებზე მოდელების ვარჯიშისთვის
PyTorch-TPU პროექტის ფარგლებში, რომელიც Facebook PyTorch-ისა და Google TPU-ის გუნდების თანამშრომლობით დაიწყო 2019 წელს, Hugging Face-თან ახალი ინტეგრაცია განხორციელდა. ეს ინტეგრაცია PyTorch-ის მომხმარებლებს საშუალებას აძლევს, ეფექტურად გააფართოვონ თავიანთი ხელოვნური ინტელექტის მოდელები Cloud TPU-ებზე, Hugging Face-ის ტრენერების ნაცნობი ინტერფეისის შენარჩუნებით. ეს სიახლე მნიშვნელოვნად ამარტივებს და აჩქარებს ღრმა სწავლის მოდელების ვარჯიშის პროცესს.
მომხმარებელთა შეფასებების სენტიმენტური ანალიზის მიკროსერვისის შექმნა Google Cloud-ზე
სტატია აღწერს მიკროსერვისის შექმნის პროცესს, რომელიც Discord-ში დატოვებულ მომხმარებელთა შეფასებებს ავტომატურად აანალიზებს და მათ პოზიტიურ ან ნეგატიურ შინაარსს განსაზღვრავს. ავტორი განიხილავს საწყის სირთულეებს მოდელის ჩატვირთვისა (როგორიცაა .h5 ფაილის ტიპის გაგება) და შესაბამისი ღრუბლოვანი პლატფორმის შერჩევისას (AI-Platform Prediction, App Engine, Cloud Run). საბოლოოდ, წარმოადგენს Cloud Run-სა და PyTorch-ზე დაფუძნებულ, Docker-ის გამოყენებით განხორციელებულ გადაწყვეტას, რომელიც ოპტიმიზირებულია მეხს
Hugging Face წარმოგიდგენთ TII-ის Falcon 180B-ს: ღია წყაროს მოდელების უახლესი მიღწევა
Hugging Face სიამაყით წარადგენს TII-ის Falcon 180B-ს – ღია წყაროს უდიდეს და უახლესი ტექნოლოგიების მწვერვალზე მდგომ ენობრივ მოდელს. 180 მილიარდი პარამეტრით და 3.5 ტრილიონ ტოკენზე გაწვრთნილი Falcon 180B ლიდერობს ღია წყაროს მოდელებს შორის და კონკურენციას უწევს ისეთ კომერციულ გიგანტებს, როგორიცაა Google-ის PaLM-2. მოდელი უკვე ხელმისაწვდომია Hugging Face Hub-ზე, რაც მაღალი შესაძლებლობის ხელოვნურ ინტელექტს ფართო საზოგადოებისთვის ხელმისაწვდომს ხდის.

Google-მა PaliGemma 2 Mix გამოუშვა: ახალი ვიზუალური ენის მოდელები გაუმჯობესებული შესაძლებლობებით
Google-მა წარადგინა PaliGemma 2 Mix, წინასწარ გაწვრთნილი PaliGemma 2 ვიზუალური ენის მოდელების (VLMs) ახალი ოჯახი, რომელიც დაზუსტებულია სხვადასხვა ვიზუალური ენის ამოცანებისთვის, მათ შორის OCR-ისთვის, მოკლე და გრძელი აღწერისთვის, ობიექტის ამოცნობისა და გამოსახულების სეგმენტაციისთვის. ეს მოდელები, რომლებიც Gemma 2-სა და SigLIP-ზეა დაფუძნებული, შექმნილია შემდგომ ამოცანებზე უკეთესი სწავლისთვის და ხელმისაწვდომია სხვადასხვა ზომისა და რეზოლუციის ვარიანტებში, რაც აჩქარებს დეველოპერებისთვის პროტოტიპების შ
Google-მა PaliGemma 2 mix წარადგინა: ახალი, დახვეწილი ვიზუალურ-ენობრივი მოდელები
გასულ დეკემბერში Google-მა PaliGemma 2-ის წინასწარ გაწვრთნილი (pt) ვიზუალურ-ენობრივი მოდელები (VLM) გამოუშვა, რომლებიც SigLIP-სა და Gemma 2-ზეა დაფუძნებული. დღეს კომპანია წარმოადგენს PaliGemma 2 mix-ს, რომელიც დახვეწილია ვიზუალურ-ენობრივ ამოცანებზე, მათ შორის OCR-ზე (ოპტიკური სიმბოლოების ამოცნობა), გრძელ და მოკლე წარწერების გენერირებაზე და სხვა. ეს მოდელები განკუთვნილია სპეციფიკურ ამოცანებზე ადაპტირებისთვის და გთავაზობთ სხვადასხვა შესაძლებლობებს, როგორიცაა ობიექტის ამოცნობა და სეგმენტაცია, გაუმჯ

Google-მა SigLIP 2 გამოუშვა: მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ახალი, გაუმჯობესებული თაობა
Google-მა წარმოადგინა SigLIP 2, მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ოჯახის ახალი თაობა. გაფართოებული სწავლების მიზნების წყალობით, რომელიც აუმჯობესებს სემანტიკურ გაგებას, ლოკალიზაციასა და მკვრივ მახასიათებლებს, SigLIP 2 მოდელები მნიშვნელოვნად აღემატება წინამორბედ SigLIP-ს ისეთ ძირითად შესაძლებლობებში, როგორიცაა ნულოვანი კადრის კლასიფიკაცია და გამოსახულება-ტექსტის მოძიება. სიახლეს წარმოადგენს დინამიური რეზოლუციის (naflex) ვარიანტი, რაც მას უფრო მრავალმხრივს ხდის.

Hugging Face და IISc/ARTPARK ინდოეთის ლინგვისტური მრავალფეროვნების მხარდასაჭერად Vaani მონაცემთა ნაკრებს აფართოებენ
Hugging Face-ისა და IISc/ARTPARK-ის პარტნიორობა მიზნად ისახავს Vaani მონაცემთა ნაკრების ხელმისაწვდომობისა და გამოყენებადობის გაუმჯობესებას, რაც ხელს შეუწყობს AI სისტემების განვითარებას ინდოეთის მრავალფეროვანი ენების უკეთ გასაგებად. Project Vaani, რომელიც 2022 წელს IISc/ARTPARK-მა და Google-მა დაიწყეს, არის პიონერული ინიციატივა ღია კოდის მრავალმოდალური მონაცემთა ნაკრების შესაქმნელად, რომელიც ინდოეთის ლინგვისტურ მრავალფეროვნებას ასახავს. ამ მონაცემთა ნაკრებს უკვე მოიცავს 54 ენას და მოიცავს სპონტან
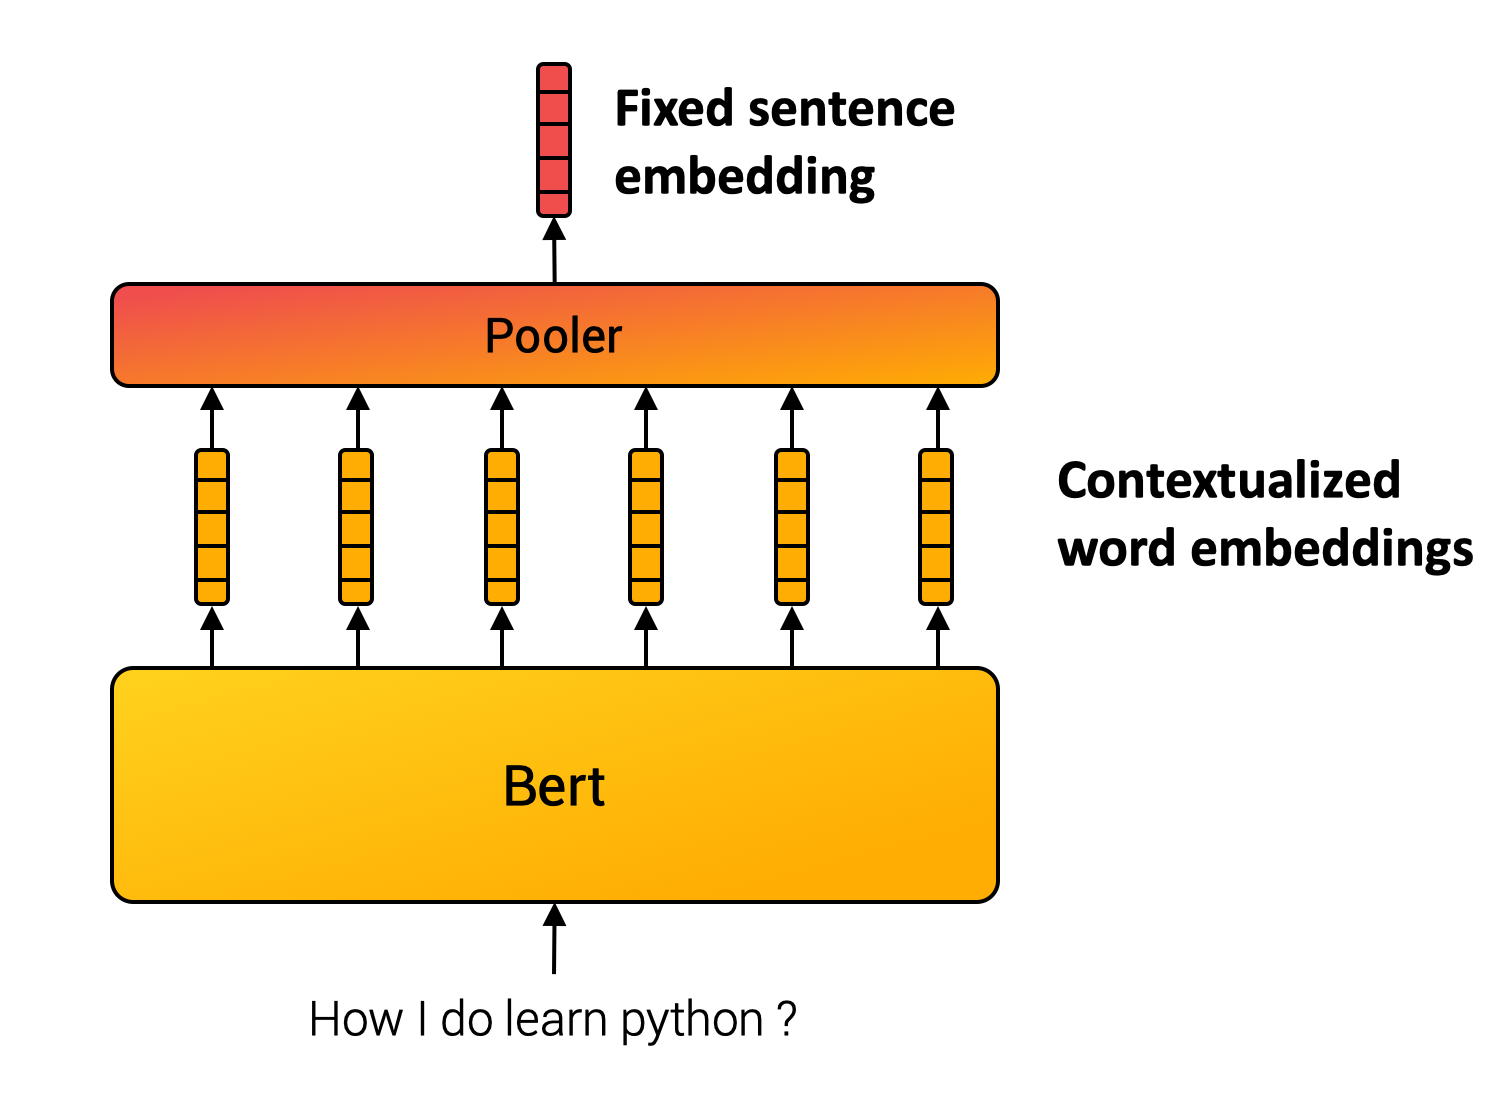
Hugging Face-ის მასშტაბური პროექტი: ხელოვნური ინტელექტის ახალი ეტაპი წინადადებების გაგებაში
Hugging Face-მა, Google-ის JAX/Flax-ის გუნდთან თანამშრომლობით, შეიმუშავა წინადადებების ჩაშენების უახლესი მოდელები პროექტის „Train the Best Sentence Embedding Model Ever with 1B Training Pairs“ ფარგლებში. პროექტი იყენებდა Google-ის 7 TPU v3-8 ერთეულს და ინოვაციურ კონტრასტულ სწავლებას, რათა მსგავსი მნიშვნელობის მქონე წინადადებები ახლო ვექტორებად ასახოს, განსხვავებული მნიშვნელობის მქონე წინადადებები კი – შორეულ ვექტორებად. ეს მიღწევა მნიშვნელოვნად აუმჯობესებს ბუნებრივი ენის დამუშავების (NLP) სისტემ

Google-მა Gemma 3 წარადგინა: მულტიმოდალური ხელოვნური ინტელექტის მოდელების ახალი თაობა
Google-მა გამოუშვა Gemma 3, Gemma მოდელების ოჯახის ახალი ვერსია. ეს მოდელები, რომელთა პარამეტრების რაოდენობა 1 მილიარდიდან 27 მილიარდამდე მერყეობს, მხარს უჭერს 140-ზე მეტ ენას, შეუძლია როგორც გამოსახულებების, ისე ტექსტის დამუშავება, აქვს 128k ტოკენამდე კონტექსტური ფანჯარა და ინტეგრირებულია Hugging Face-ის ეკოსისტემასთან. Gemma 3-ის მოდელები, განსაკუთრებით Gemma-3-27B-IT, ეტალონურ ტესტებში აჭარბებს Gemma 2-27B IT-სა და Gemini 1.5-Pro-ს, რაც Google-ის ღია წონის დიდი ენობრივი მოდელების უახლეს მიღწე
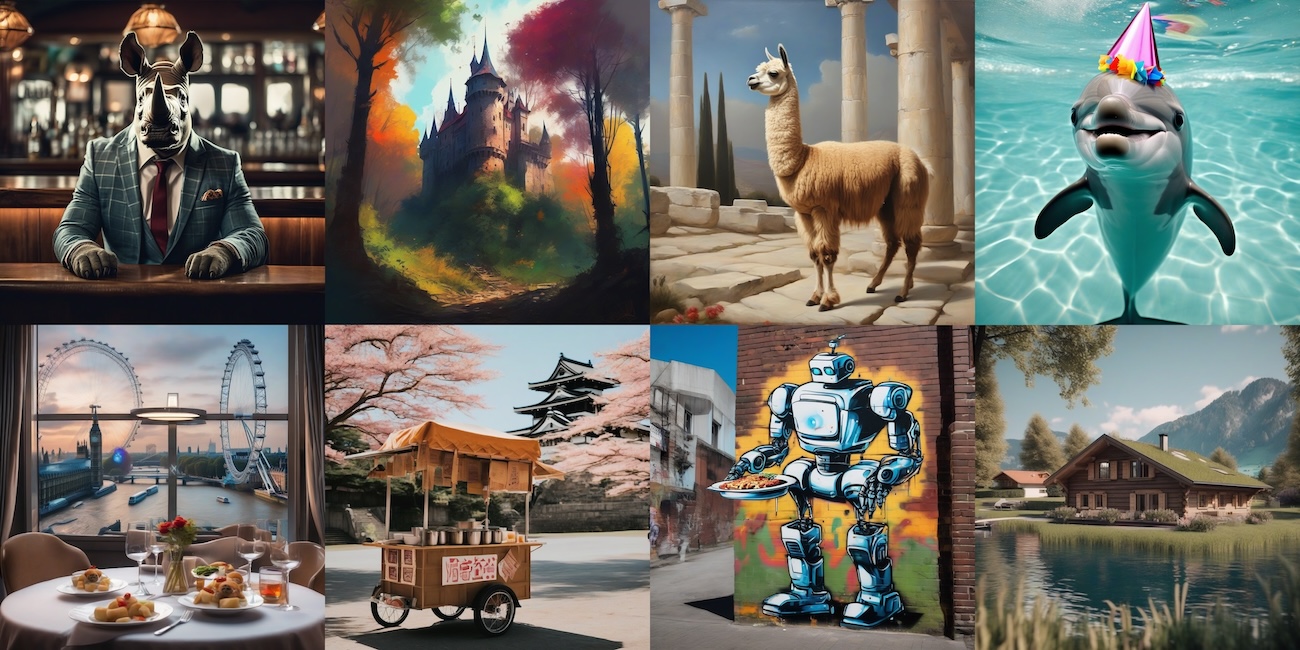
მაღალეფექტური და ხარჯთეფექტური SDXL სერვისინგი JAX-ით Google Cloud TPU v5e-ზე
Google Cloud-ის ახალი TPU v5e, JAX-თან და Diffusers-თან ერთად, შესაძლებელს ხდის დიდი ხელოვნური ინტელექტის მოდელების, მაგალითად SDXL-ის, მაღალპროდუქტიულ და ხარჯთეფექტურ ტრეინინგსა და ინფერენსს. სტატია მიმოიხილავს, თუ როგორ ხდის JIT კომპილაცია და XLA-ზე დაფუძნებული პარალელიზაცია მასშტაბურ გენერაციულ AI-ს ხელმისაწვდომსა და ეფექტურს, წარმოადგენს დემოს და განმარტავს ამ ტექნოლოგიების გამოყენების დეტალებს.

Visual Salamandra: ახალი თაობის მულტიმოდალური AI ევროპული ენების აქცენტით
ენის ტექნოლოგიების ლაბორატორიამ წარმოადგინა Visual Salamandra, ინოვაციური მულტიმოდალური AI მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან. ეს სისტემა შექმნილია ვიზუალურ და ტექსტურ მონაცემებს შორის ხარვეზის შესავსებად, რის შედეგადაც მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანის საფუძველზე, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტური ინსტრუქციებიდან. Visual Salamandra გამოირჩევა მრავალენოვანი ინკლუზიურობით, განსაკუთრები
Visual Salamandra: მულტიმოდალური AI მოდელი ევროპული ენობრივი მრავალფეროვნების მხარდასაჭერად
Visual Salamandra, ახალი მულტიმოდალური ხელოვნური ინტელექტის მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან, ხედვისა და ენის დამუშავების უფსკრულს ავსებს. მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანიდან, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტიდან. ლაბორატორიის მიერ შექმნილი ეს ინოვაცია ხაზს უსვამს მრავალენოვან ინკლუზიურობას, განსაკუთრებული აქცენტით ევროპულ ენებზე, რაც ხელს უწყობს მულტიმოდალური AI კვლევის რესურსების ნა
BERT: ხელოვნური ინტელექტის ინოვაცია, რომელმაც ენის დამუშავება შეცვალა
BERT, Google AI-ის მიერ 2018 წელს შექმნილი მანქანური სწავლების მოდელი, რევოლუციური ინოვაციაა ბუნებრივი ენის დამუშავების (NLP) სფეროში. იგი წარმოადგენს მრავალფუნქციურ გადაწყვეტას 11-ზე მეტი ენობრივი ამოცანისთვის, მათ შორის სენტიმენტების ანალიზისა და დასახელებული ერთეულების ამოცნობისთვის. სტატია განმარტავს, თუ როგორ ეხმარება BERT კომპიუტერებს ადამიანის ენის გაგებაში, რა ტექნიკებს (როგორიცაა ნიღბიანი ენის მოდელი და შემდეგი წინადადების პროგნოზირება) იყენებს ამისთვის და რა გავლენა მოახდინა მან Google
მეგ მიტჩელი ხელოვნური ინტელექტის ეთიკაზე: მონაცემთა მიკერძოებიდან ინკლუზიურ კულტურამდე
ამ ინტერვიუში დოქტორი მარგარეტ (მეგ) მიტჩელი საუბრობს იმ მომენტზე, როდესაც მან გააცნობიერა ეთიკური ხელოვნური ინტელექტის (AI) მნიშვნელობა. ის იზიარებს თავის გამოცდილებას მონაცემთა მავნე მიკერძოებასთან დაკავშირებით, რომელსაც მანქანური სწავლების (ML) გუნდები ხშირად აწყდებიან, და განმარტავს ინკლუზიისა და მრავალფეროვნების სარგებელს AI სისტემების შემუშავებაში. მეგი აღწერს თავის კარიერულ გზას Microsoft-დან Google-მდე, სადაც მან დააარსა ეთიკური AI-ს გუნდი, და შემდეგ Hugging Face-მდე. ის განიხილავს ისეთ
წარმოგიდგენთ aMUSEd-ს: ეფექტურ არადიფუზიურ ტექსტიდან გამოსახულების გენერაციის მოდელს
გაეცანით aMUSEd-ს, Google-ის MUSE-ის ღია რეპროდუქციას. ეს არის სწრაფი, არადიფუზიური ტექსტიდან გამოსახულების გენერაციის მოდელი, რომელიც ეფუძნება ნიღბიანი გამოსახულების მოდელირების (MIM) მეთოდოლოგიას. მიუხედავად იმისა, რომ მისი ხარისხი არ არის უმაღლესი დონის, ის გვთავაზობს სტილის გადაცემის, გამოსახულების inpainting-ის შესაძლებლობებს და ხელს უწყობს MIM ფრეიმვორკების კვლევას. მოდელი გამოშვებულია ნებადართული ლიცენზიით, მარტივია მის დასაკონფიგურირებლად და მუშაობს დაბალი GPU VRAM მოთხოვნებით.
Hugging Face და Google Cloud-ი აძლიერებენ პარტნიორობას ღია AI-ს დემოკრატიზაციისთვის
Hugging Face-ი და Google Cloud-ი ღრმა სტრატეგიულ პარტნიორობას აცხადებენ, რომლის მიზანია კომპანიებს საშუალება მისცეს, შექმნან საკუთარი ხელოვნური ინტელექტი ღია მოდელებისა და ღია კოდის ტექნოლოგიების გამოყენებით. თანამშრომლობა მოიცავს ღია მეცნიერებას, ღია კოდს, ღრუბლოვან სერვისებსა და აპარატურას, რათა მომხმარებლებს გაუმარტივდეს Hugging Face-ის უახლესი ღია მოდელების და Google Cloud-ის ინფრასტრუქტურის (როგორიცაა Vertex AI და TPU) გამოყენება. პარტნიორობა გააძლიერებს AI კვლევის ხელმისაწვდომობას და უზრუნ
მომხმარებლის საჭიროებების გაგება Auto ML-ით: HuggingFace AutoTrain-ისა და Kili-ის ინტეგრაცია
სტატია განიხილავს, თუ როგორ შეიძლება ავტომატური მანქანური სწავლის (Auto ML) გამოყენება, კერძოდ HuggingFace AutoTrain-ისა და Kili პლატფორმის მეშვეობით, მომხმარებელთა საჭიროებების ეფექტურად გასაგებად. წარმოდგენილია ტექსტის კლასიფიკაციისა და სენტიმენტური ანალიზის აქტიური სწავლის პაიპლაინის აგება, Medium-ის მომხმარებლის მიმოხილვების მაგალითზე Google Play Store-იდან. ეს მეთოდი ამცირებს ხარჯებს და აჩქარებს მონაცემთა ეტიკეტირებისა და მოდელის ვარჯიშის პროცესს.

წარმოგიდგენთ nanoVLM-ს: მარტივი გზა ვიზუალური ენის მოდელების შესაქმნელად
nanoVLM არის ხელსაწყოების ნაკრები, რომელიც შთაგონებულია Andrej Karpathy-ის nanoGPT-ით, მაგრამ შექმნილია ვიზუალური სფეროსთვის. ის საშუალებას გაძლევთ შექმნათ და გაავარჯიშოთ მოდელები, რომლებსაც შეუძლიათ გამოსახულებებისა და ტექსტის გაგება, შემდეგ კი ამის საფუძველზე ტექსტის გენერირება. პროექტი გამოირჩევა სიმარტივითა და კოდის წაკითხვადობით, რაც მას იდეალურს ხდის დამწყებთათვის. nanoVLM ძირითადად ფოკუსირებულია ვიზუალურ კითხვა-პასუხზე (Visual Question Answering) და აგებულია Google-ის SigLIP-ისა და Llama

Dell Enterprise Hub: ხელოვნური ინტელექტის გადაწყვეტილებების სრული ეკოსისტემა საწარმოებისთვის
Dell Enterprise Hub აფართოებს ხელოვნური ინტელექტის გადაწყვეტილებების სპექტრს, სთავაზობს ოპტიმიზებულ მოდელებს (Meta Llama 4, Google Gemma 3) და მზა აპლიკაციებს Dell-ის AI სერვერებისა და AI კომპიუტერებისთვის. პლატფორმა უზრუნველყოფს სწრაფ, ადგილობრივ განთავსებას Docker-ის, Kubernetes-ის და ახალი Dell Pro AI Studio-ს მეშვეობით, ასევე წარმოგიდგენთ `dell-ai` ღია კოდის ბიბლიოთეკას, რაც საწარმოებს საშუალებას აძლევს, ეფექტურად ინტეგრირდნენ გენერაციულ ხელოვნურ ინტელექტთან.
Google-მა Gemma, უახლესი ღია LLM-ების ოჯახი გამოუშვა
Google-მა დღეს გამოუშვა Gemma, ხელოვნური ინტელექტის (AI) უახლესი ღია ენის მოდელების (LLM) ოჯახი, რაც აძლიერებს კომპანიის ერთგულებას ღია კოდის AI მიმართ. Gemma ხელმისაწვდომია ორი ზომის (7B და 2B პარამეტრი) და ორი ვარიანტის (ძირითადი და ინსტრუქციებზე მორგებული) სახით. ის შექმნილია ეფექტური გამოყენებისთვის სხვადასხვა მოწყობილობაზე, მათ შორის სამომხმარებლო GPU-ებზე, CPU-ებზე და ჩაშენებულ სისტემებზე. Hugging Face-თან თანამშრომლობით უზრუნველყოფილია სრული ინტეგრაცია და ყველა ვარიანტი ხელმისაწვდომია Hug

Featherless AI Hugging Face Hub-ის მხარდაჭერილი ინფერენს პროვაიდერი გახდა
Featherless AI უერთდება Hugging Face Hub-ის მზარდ ეკოსისტემას, აფართოებს სერვერული ინფერენციის შესაძლებლობებს და მომხმარებლებს სთავაზობს მოდელების შეუდარებელ მრავალფეროვნებას ხელმისაწვდომ ფასად. ის მხარს უჭერს უახლეს ღია კოდის მოდელებს DeepSeek-დან, Meta-დან, Google-დან და Qwen-დან, რაც აერთიანებს მოდელების დიდ არჩევანს სერვერულ ფასებთან.

Gemma 3n: მულტიმოდალური AI მოდელი საბოლოოდ ღია კოდის ბიბლიოთეკებში
Google-ის უახლესი მულტიმოდალური AI მოდელი, Gemma 3n, საბოლოოდ ხელმისაწვდომია ყველაზე პოპულარულ ღია კოდის ბიბლიოთეკებში, მათ შორის transformers & timm, MLX, llama.cpp და სხვებში. ეს გამოშვება მოიცავს ორ ზომას (E2B და E4B), რომლებიც გამოირჩევიან მაღალი ეფექტურობით VRAM-ის გამოყენების მხრივ და უზრუნველყოფენ შესანიშნავ ხარისხს. Gemma 3n არა მხოლოდ ენობრივ დეკოდერს, არამედ აუდიო და ვიზუალურ ენკოდერებსაც მოიცავს, რაც მას სრულყოფილ მულტიმოდალურ ინსტრუმენტად აქცევს დეველოპერებისთვის. სტატია დეტალურად აღ
Twitter-ზე სენტიმენტების ანალიზი: დამწყებთათვის სრული გზამკვლევი
ეს გზამკვლევი მოიცავს ყველაფერს, რაც უნდა ისწავლოთ Twitter-ზე სენტიმენტების ანალიზის დასაწყებად, როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. თქვენ გაეცნობით Inference API-ის გამოყენებას კოდის რამდენიმე ხაზით ან Zapier-ის, უ-კოდო ხელსაწყოს მეშვეობით, ტვიტების შესაგროვებლად, გასაანალიზებლად და შედეგების Google Sheets-ში გასაგზავნად. ისწავლეთ, როგორ გამოიყენოთ მანქანური სწავლება ბრენდის მონიტორინგისთვის და მომხმარებლის უკუკავშირის გასაანალიზებლად.