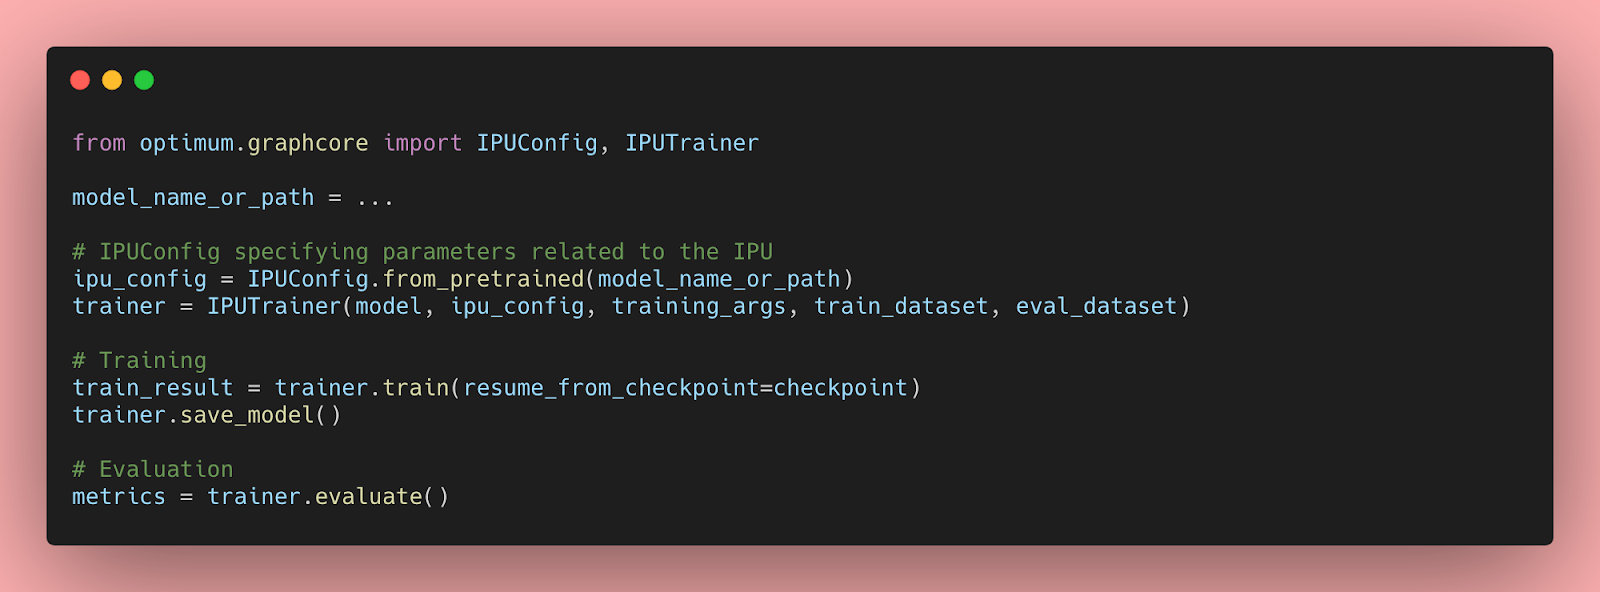
Hugging Face Optimum და Graphcore IPU: Transformer მოდელების აჩქარება
Hugging Face-მა წარმოადგინა Optimum, ღია კოდის ბიბლიოთეკა, რომელიც ამარტივებს Transformer მოდელების პროგნოზირების შეყოვნების შემცირებას სხვადასხვა აპარატურულ პლატფორმაზე. ეს ბლოგპოსტი გვიჩვენებს, თუ როგორ შეიძლება Transformer მოდელების დაჩქარება Graphcore Intelligence Processing Unit (IPU)-სთვის, რომელიც ხელოვნური ინტელექტის დატვირთვებისთვის შექმნილი მოქნილი პროცესორია. Graphcore-სა და Hugging Face-ს შორის პარტნიორობის ფარგლებში, BERT პირველი IPU-სთვის ოპტიმიზებული მოდელია. სტატია დეტალურად აღწე
AutoNLP და Prodigy: ხელოვნური ინტელექტის მოდელების სწრაფი და ეფექტური შექმნა
სტატია მიმოიხილავს Hugging Face-ის AutoNLP-სა და Explosion-ის Prodigy-ს, ორ მძლავრ ინსტრუმენტს ღრმა სწავლის მოდელების შესაქმნელად და მონაცემთა ანოტაციისთვის. აღწერილია, თუ როგორ ამარტივებს AutoNLP უახლესი ტრანსფორმატორის მოდელების წვრთნას სხვადასხვა ბუნებრივი ენის დამუშავების ამოცანებისთვის (კლასიფიკაცია, სახელობითი ერთეულების ამოცნობა) მინიმალური კოდირებით. Prodigy წარმოდგენილია როგორც მოქნილი, რეალურ დროში ანოტაციის ინსტრუმენტი, რომელიც მხარს უჭერს ბუნებრივი ენის დამუშავების, კომპიუტერული მხედ
Prodigy-HF: Hugging Face მოდელების გაწვრთნა და ანოტირებული მონაცემთა ნაკრებების გაზიარება
Explosion-მა გამოუშვა Prodigy-HF, ახალი პლაგინი, რომელიც Prodigy-ის ანოტაციის ხელსაწყოს Hugging Face-ის ეკოსისტემასთან აინტეგრირებს. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს, გაწვრთნან Hugging Face მოდელები საკუთარ ანოტირებულ მონაცემებზე (მაგ. დასახელებული ერთეულების ამოცნობისთვის და ტექსტის კლასიფიკაციისთვის) და გამოაქვეყნონ ეს მონაცემთა ნაკრებები Hugging Face Hub-ზე, რაც ხელს უწყობს მოქნილობას, თანამშრომლობას და დროის დაზოგვას ხელოვნური ინტელექტის პროექტებში.

Hugging Face და Protect AI მანქანური სწავლების მოდელების უსაფრთხოების გაძლიერების მიზნით თანამშრომლობენ
2024 წლის ოქტომბერში Hugging Face-მა და Protect AI-მ პარტნიორობა დაიწყეს მანქანური სწავლების (ML) მოდელების უსაფრთხოების გასაუმჯობესებლად. Protect AI-ის Guardian სკანირების ტექნოლოგია Hugging Face Hub-ის მომხმარებლებს კრიტიკულ უსაფრთხოების ინფორმაციას აწვდის. პარტნიორობის ფარგლებში, Protect AI-მ მნიშვნელოვნად გააფართოვა Guardian-ის აღმოჩენის შესაძლებლობები, მოიცვა მეტი ფაილის ფორმატი და გამოავლინა დახვეწილი ობსკურაციის ტექნიკები, მათ შორის მაღალი რისკის CVE-2025-1550 მოწყვლადობა Keras-ში. 2025 წ

ხელოვნური ინტელექტი: გამოსახულებების ტოკენიზაცია და ViT მოდელების წვრთნა
ეს სტატია განმარტავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია წინადადებების მსგავსად, რაც მათ საშუალებას აძლევს, დამუშავდეს ტრანსფორმერული მოდელებით. დეტალურად არის აღწერილი 🤗 datasets-ის გამოყენებით მონაცემთა მომზადება, ViTImageProcessor-ის ინტეგრირება და წინასწარ გაწვრთნილი ViT მოდელების დაზუსტება. მიმოხილულია ტრენინგის კონფიგურაციის, შეფასების მეტრიკების განსაზღვრისა და ეფექტური წვრთნის კონვეიერის აგების პროცესები, რაც მნიშვნელოვან წინსვლას წარმოადგენს გამოსახულების კლასიფიკაციის ამოცანებშ
ახალი მიდგომა SDXL Dreambooth LoRA-ს გაწვრთნისთვის: Pivotal Tuning-ისა და Prodigy ოპტიმიზატორის კომბინაცია
Replicate-ის SDXL Cog ტრენერში გამოყენებული Pivotal Tuning ტექნიკისა და Kohya ტრენერში გამოყენებული Prodigy ოპტიმიზატორის (სხვა მრავალ ოპტიმიზაციასთან ერთად) შერწყმით, მიღწეულია შესანიშნავი შედეგები SDXL-ისთვის Dreambooth LoRA-ების გაწვრთნაში. LoRA Dreambooth-ით დახვეწილი SDXL მოდელები საოცარ შედეგებს იძლევა ახალი კონცეფციების დაფიქსირებაში, მცირე რაოდენობის გამოსახულებების გამოყენებით, თანაც ინარჩუნებენ SDXL-ის ესთეტიკასა და ხარისხს და მოითხოვენ შედარებით მცირე გამოთვლით რესურსებს. ტრენინგის სკ
SDXL Dreambooth LoRA ტრენინგის რევოლუცია: Pivotal Tuning-ისა და Prodigy ოპტიმიზატორის კომბინაციით
ამ სტატიაში წარმოდგენილია Dreambooth LoRA-ების SDXL-ისთვის ოპტიმიზაციის ახალი მეთოდი, რომელიც აერთიანებს Replicate-ის SDXL Cog ტრენერში გამოყენებულ Pivotal Tuning ტექნიკას Kohya ტრენერის Prodigy ოპტიმიზატორთან. ეს მიდგომა, სხვა მრავალ ოპტიმიზაციასთან ერთად, უზრუნველყოფს საუკეთესო შედეგებს ახალი კონცეფციების აღბეჭდვაში მცირე რაოდენობის გამოსახულებების გამოყენებით, SDXL-ის ესთეტიკური ხარისხისა და გამოსახულების სიზუსტის შენარჩუნებით, ამასთანავე მოითხოვს შედარებით ნაკლებ გამოთვლით რესურსებს. გაეცანი

MCP (Model Context Protocol): ახალი სტანდარტი AI აგენტებისა და LLM-ების ინტეგრაციისთვის
ბოლო კვირების განმავლობაში, MCP-ის (Model Context Protocol) სიღრმისეული შესწავლის შედეგად, ნათელი გახდა მისი მნიშვნელობა ხელოვნური ინტელექტის განვითარებაში. ეს არის მარტივი, მაგრამ ძლიერი სტანდარტული API, რომელიც დიდ ენობრივ მოდელებს (LLM) საშუალებას აძლევს, ეფექტურად გამოიყენონ სხვადასხვა ხელსაწყოები. სტატია დეტალურად აღწერს MCP კლიენტის განხორციელებას Typescript-ში და ხაზს უსვამს, თუ როგორ ამარტივებს ის Agentic AI-ს შექმნას. იგი განიხილავს LLM-ების „ფუნქციის გამოძახების“ შესაძლებლობებს და აჩვე

Llama Guard 4 და Prompt Guard 2: ხელოვნური ინტელექტის უსაფრთხოების ახალი მულტიმოდალური მოდელები
წარმოგიდგენთ Llama Guard 4-ს, მულტიმოდალურ მოდელს, რომელიც შექმნილია გამოსახულებებსა და ტექსტში სახიფათო კონტენტის აღმოსაჩენად, მათ შორის „jailbreak“-ის თავიდან ასაცილებლად. მასთან ერთად, Llama Prompt Guard 2 აძლიერებს დაცვას „prompt injection“-ებისა და სხვა მავნე შეტევებისგან, რაც უზრუნველყოფს ხელოვნური ინტელექტის უსაფრთხო და მოქნილ მოდერაციას. ეს მოდელები მნიშვნელოვნად აუმჯობესებენ AI სისტემების დაცვას საწარმოო გარემოში.

Gradio-ს ახალი შესაძლებლობები: LLM ინსტრუმენტების სერვერები Model Context Protocol-ით (MCP)
Gradio, პოპულარული Python ბიბლიოთეკა მანქანური სწავლების ინტერფეისებისთვის, ახლა მხარს უჭერს Model Context Protocol (MCP) სერვერების გაშვებას დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპლიკაციებს საშუალებას აძლევს ფუნქციონირებდნენ როგორც ხელსაწყოები LLM-ებისთვის, რაც მათ სთავაზობს დამატებით შესაძლებლობებს, როგორიცაა გამოსახულების გენერაცია, აუდიო სინთეზი ან კონკრეტული გამოთვლები. სტატია აღწერს, თუ როგორ შეიძლება რამდენიმე ხაზი კოდით Gradio-ს MCP სერვერად გადაქცევა და წარმოადგენს მის
Gradio-ს რევოლუციური განახლება: MCP სერვერები LLM-ებისთვის
Gradio, პოპულარული Python ბიბლიოთეკა, რომელიც გამოიყენება მანქანური სწავლების მოდელებისთვის ინტერფეისების შესაქმნელად, ახლა დეველოპერებს საშუალებას აძლევს, გაუშვან Gradio აპლიკაციები Model Context Protocol (MCP) სერვერებად დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპებს აქცევს მძლავრ ხელსაწყოებად, რომელთა გამოყენება LLM-ებს შეუძლიათ სხვადასხვა ამოცანებისთვის – გამოსახულების გენერირებიდან დაწყებული, კონკრეტული გამოთვლებით დამთავრებული. სტატია აღწერს MCP სერვერის აგებას რამდენიმე ხაზი
PatchTST: ინოვაციური მოდელი დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით
ICLR 2023-ზე წარდგენილი PatchTST მოდელი რევოლუციურ მიდგომას გვთავაზობს დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით. მოდელი ეფუძნება ინდივიდუალური დროითი რიგების „პაჩებად“ დაყოფას, რაც არაერთ სარგებელს იძლევა. სტატიაში აღწერილია PatchTST-ის ვარჯიში Electricity მონაცემთა ნაკრებზე და მისი ტრანსფერული სწავლის შესაძლებლობები ETTh1 მონაცემთა ნაკრებზე, სადაც ნაჩვენებია მნიშვნელოვანი გაუმჯობესება ნულოვანი სწავლის (zero-shot), წრფივი გამოძიების (linear probing) და სრული ფაინ

Dell Enterprise Hub: ხელოვნური ინტელექტის გადაწყვეტილებების სრული ეკოსისტემა საწარმოებისთვის
Dell Enterprise Hub აფართოებს ხელოვნური ინტელექტის გადაწყვეტილებების სპექტრს, სთავაზობს ოპტიმიზებულ მოდელებს (Meta Llama 4, Google Gemma 3) და მზა აპლიკაციებს Dell-ის AI სერვერებისა და AI კომპიუტერებისთვის. პლატფორმა უზრუნველყოფს სწრაფ, ადგილობრივ განთავსებას Docker-ის, Kubernetes-ის და ახალი Dell Pro AI Studio-ს მეშვეობით, ასევე წარმოგიდგენთ `dell-ai` ღია კოდის ბიბლიოთეკას, რაც საწარმოებს საშუალებას აძლევს, ეფექტურად ინტეგრირდნენ გენერაციულ ხელოვნურ ინტელექტთან.
წარმოდგენილია SegMoE: ექსპერტთა ნარევი Stable Diffusion მოდელებისთვის
SegMoE წარმოადგენს ინოვაციურ არქიტექტურას, რომელიც აერთიანებს მრავალ მოდელს ერთში Feed-Forward ფენების MoE ფენებით ჩანაცვლებით. ეს საშუალებას აძლევს Stable Diffusion მოდელებს უფრო ეფექტურად და ზუსტად გენერირდეს სურათები. ახალი პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა და იგი აუმჯობესებს „prompt“ გაგებას, თუმცა აღინიშნება VRAM-ის მაღალი მოხმარება და გარკვეული სისუსტე ერთეულ SD მოდელებთან შედარებით.
Haize Labs-მა და Hugging Face-მა დიდი ენობრივი მოდელების უსაფრთხოების ახალი ეტალონი, „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ წარადგინეს
დიდი ენობრივი მოდელების (დემ) კვლევის სწრაფი ტემპის ფონზე, Haize Labs-მა, Hugging Face-ის გულუხვი მხარდაჭერით, გამოაქვეყნა „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ (Red Teaming Resistance Benchmark). ეს ახალი ეტალონი მიზნად ისახავს მოწინავე დემ-ების მოწყვლადობების საფუძვლიან შემოწმებას ადამიანის მიერ შექმნილი, ბუნებრივი ენის მსგავსი მავნე მოთხოვნების (prompts) გამოყენებით, განსხვავებით ხელოვნური, ავტომატიზებული შეტევებისგან. ბენჩმარკი აფასებს მოდელების მდგრადობას არასასურველი ქცევების მიმართ, რო

როგორ მოვაგვარეთ AI-ის არაეფექტური ტრენინგის პრობლემა: მონაცემთა მილსადენის ოპტიმიზაცია
ჩვენი nanoVLM პროექტის ფარგლებში AI მოდელების ტრენინგის შენელების პრობლემა აღმოვაჩინეთ. დეტალური ანალიზის შემდეგ გაირკვა, რომ პრობლემა არც მოდელში და არც აპარატურაში იყო, არამედ მონაცემთა მილსადენის არაეფექტურობაში. ამ სტატიაში აღწერილია ხუთსაფეხურიანი მიდგომა, თუ როგორ მოხდა მილსადენის ოპტიმიზაცია, მათ შორის „ზურგჩანთის პრობლემის“ (knapsack problem) გამოყენებით, რამაც მნიშვნელოვნად შეამცირა დაუფიქსირებელი მონაცემების (padding) რაოდენობა და გაზარდა ტრენინგის ეფექტურობა.
AI მონაცემთა მილსადენის ოპტიმიზაცია: როგორ დავზოგოთ GPU რესურსები და გავზარდოთ ეფექტურობა
კომპანია nanoVLM-ის პროექტზე მუშაობისას აღმოჩნდა, რომ ვარჯიშის ნელი ტემპი არა მოდელის ან აპარატურის, არამედ მონაცემთა მილსადენის არაეფექტურობის ბრალი იყო. პრობლემა ძირითადად გამოწვეული იყო მონაცემების ზედმეტი „შევსებით“ (padding), რაც GPU-ს რესურსების 60%-მდე უქმად ხარჯავდა. ამ პოსტში აღწერილია ხუთეტაპიანი სტრატეგია ეფექტური მილსადენის შესაქმნელად, მათ შორის დინამიური დაჯგუფება, ზურგჩანთის ამოცანის (knapsack problem) გამოყენება და „ბინ-ფექინგის“ მეთოდები. შედეგად, მიღწეულია მინიმალური შევსება და

Hugging Face-ის MCP სერვერის შექმნა: AI ასისტენტების დაკავშირების გამოცდილება და პროტოკოლის ევოლუცია
Hugging Face-ის გუნდი დეტალურად აღწერს Model Context Protocol (MCP) სერვერის შექმნის პროცესს, რომელიც ხელოვნური ინტელექტის ასისტენტებს გარე სამყაროსთან აკავშირებს. სტატია აანალიზებს პროტოკოლის სწრაფ ევოლუციას, ტრანსპორტის სხვადასხვა ვარიანტს (STDIO, HTTP SSE-ით, ნაკადოვანი HTTP) და იმ ტექნიკურ გადაწყვეტილებებს, რომლებიც Hugging Face-მა მიიღო ოპტიმალური, დინამიური და ადვილად ხელმისაწვდომი hf.co/mcp სერვერის შესაქმნელად. ყურადღება ექცევა უსტატუსო, პირდაპირი პასუხის კონფიგურაციის არჩევანს წარმოების
Numina-სა და Kimi-ის გუნდი: Kimina-Prover-72B-ის გამოშვება
Numina-მ და Kimi-მ წარმოადგინეს Kimina-Prover-72B, უახლესი ხელოვნური ინტელექტის მოდელი თეორემების დამტკიცებისთვის, რომელიც გაწვრთნილია Kimi k1.5 RL სისტემით და დაფუძნებულია Qwen2.5-72B-ზე. მოდელის ძირითადი ინოვაციებია ტესტირების დროს განმტკიცებითი სწავლის ძიება (TTRL) რთული, მრავალსაფეხურიანი მტკიცებულებებისთვის ლემების გამოყენებით და შეცდომების გამოსწორების შესაძლებლობა, რაც მნიშვნელოვნად ზრდის ეფექტურობას. Kimina-Prover-მა მიაღწია 92.2%-იან უპრეცედენტო წარმატებას miniF2F ბენჩმარკზე, რამაც მას

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.
ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.

რატომ იცვლება დიდი ენობრივი მოდელების (LLM) რეიტინგი მოთხოვნის ფორმატის მიხედვით?
დიდი ენობრივი მოდელების (LLM) შესრულება და რეიტინგი მოულოდნელად მგრძნობიარე აღმოჩნდა მოთხოვნის (prompt) ფორმატისა და მცირეგანზომილებიანი („few-shot“) მაგალითების თანმიმდევრობის მიმართ, რაც აფერხებს სამართლიან შეფასებას და შედარებას. კვლევებმა აჩვენა, რომ მცირე ცვლილებებმა მოთხოვნის ფორმატში შეიძლება გამოიწვიოს მოდელის ქულების 10 ქულით ვარიაცია და რეიტინგის არათანმიმდევრულობა. ამ პრობლემის დასაძლევად შემოთავაზებულია სტრუქტურირებული გენერაცია, რომელიც მოდელის გამოსავალს კონკრეტულ სტრუქტურაში აქცევ

წარმოგიდგენთ kimina-prover-rl-ს: ღია კოდის სასწავლო კონვეიერს Lean 4-ში ფორმალური თეორემების დამტკიცებისთვის
kimina-prover-rl არის ღია კოდის სასწავლო კონვეიერი Lean 4-ში ფორმალური თეორემების დასამტკიცებლად, რომელიც DeepSeek-R1-ის მიერ შთაგონებულ სტრუქტურირებულ მსჯელობა-შემდეგ-გენერაციის პარადიგმას ეფუძნება. ის წარმოადგენს Kimina Prover სისტემის გამარტივებულ ვერსიას, თუმცა ინარჩუნებს ძირითად კომპონენტებს და სრულად თავსებადია Verl ფრეიმვორკთან. მისი მიზანია დიდი ენობრივი მოდელებისთვის (LLMs) ფორმალური დამტკიცების ამოცანების გადაჭრა ასწავლოს, რაც დაგეგმვისა და შესრულების გამიჯვნის ხარჯზე ზრდის ახსნადობას,
Spaces Dev Mode: ახალი შესაძლებლობები დეველოპერებისთვის
Spaces Dev Mode დეველოპერებს საშუალებას აძლევს, პირდაპირ დაუკავშირდნენ მათ Space-ს VS Code-ის ან SSH-ის გამოყენებით. ეს ფუნქცია კოდის რედაქტირებას ამარტივებს და ადგილობრივი ცვლილებების Git-ის საშუალებით ატვირთვის საჭიროებას აქრობს. ის ამჟამად ბეტა რეჟიმშია და ხელმისაწვდომია PRO გამომწერებისთვის, რაც მუშაობის პროცესს მნიშვნელოვნად აჩქარებს.