
mmBERT: ახალი მასობრივად მრავალენოვანი AI მოდელი რეკორდული წარმადობით
mmBERT არის უახლესი მასობრივად მრავალენოვანი ენკოდერი მოდელი, რომელიც გაწვრთნილია 1800-ზე მეტ ენაზე 3 ტრილიონზე მეტი ტოკენის გამოყენებით. ის წინა მრავალენოვან მოდელებთან შედარებით აჩვენებს მნიშვნელოვან წარმადობისა და სიჩქარის გაუმჯობესებას, პირველია, ვინც XLM-R-ს გადააჭარბა და ამავდროულად შეიმუშავა ეფექტური სტრატეგიები ნაკლებად რესურსული ენების შესასწავლად. მოდელი აგებულია ModernBERT-ის არქიტექტურაზე და მოიცავს ინოვაციურ კომპონენტებს ეფექტური მრავალენოვანი სწავლისთვის.
Hugging Face-ის ბიბლიოთეკაში ენის მოდელების მიკერძოების შეფასების ახალი მეტრიკები დაემატა
Hugging Face-მა თავის 🤗 Evaluate ბიბლიოთეკას დაამატა ახალი მეტრიკები და საზომები, რომლებიც მიმართულია ენის მოდელებში (როგორიცაა GPT-2 და BLOOM) არსებული მიკერძოებების შესასწავლად. ეს ხელსაწყოები საშუალებას იძლევა შეფასდეს ტოქსიკურობა, პოლარობა და მტკივნეულობა (hurtfulness), რითაც ხელს უწყობს ენის მოდელებში დაშიფრული სოციალური საკითხების უკეთ გაგებას და მათთან ბრძოლას. სტატია დეტალურად განიხილავს ამ ხელსაწყოების გამოყენებას სხვადასხვა ამოცანებში.
AWS Inferentia2 აფართოებს ხელოვნური ინტელექტის შესაძლებლობებს Hugging Face-ის მომხმარებლებისთვის
Amazon Web Services (AWS) აცხადებს, რომ მისი უახლესი მანქანური სწავლების ჩიპი, Inferentia2, სრულად ხელმისაწვდომია Hugging Face Hub-ის მომხმარებლებისთვის. ეს ინტეგრაცია მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLMs) და სხვა AI მოდელების განთავსებასა და გამოყენებას AWS SageMaker-ზე და Hugging Face Inference Endpoints-ის მეშვეობით. Inferentia2 ინსტანციები გვთავაზობს მაღალ წარმადობას, ხარჯთეფექტურობას და მხარდაჭერას 100,000-ზე მეტი მოდელისა და ამოცანისთვის, მათ შორის Llama 3-ისთვის, რაც ხელ

AI აგენტების გაძლიერება მონაცემთა მეცნიერებაში: Jupyter Agent-იდან Kaggle-ის მაღალი ხარისხის მონაცემებამდე
სტატია დეტალურად აღწერს Jupyter Agent-ის შექმნასა და განვითარებას, ხელოვნური ინტელექტის აგენტის, რომელიც შექმნილია Jupyter Notebook-ებში კოდის უშუალო შესასრულებლად მონაცემთა ანალიზისა და მონაცემთა მეცნიერების ამოცანების გადასაჭრელად. ხაზგასმულია ძალისხმევა მცირე ენობრივი მოდელების გაძლიერებაზე აგენტური ამოცანებისთვის, რათა მათ კონკურენცია გაუწიონ დიდ მოდელებს. პროექტი მოიცავს მაღალი ხარისხის სავარჯიშო მონაცემების გენერირებას Kaggle-ის ნოუთბუქებიდან, მოდელების დახვეწას და მათ შეფასებას DABStep-ის
Intel-ი და Hugging Face-ი Optimum Intel-ში OpenVINO-ს ინტეგრაციას აცხადებენ ტრანსფორმერული მოდელების დასაჩქარებლად
Intel-მა და Hugging Face-მა OpenVINO ინტეგრირეს Optimum Intel-ში, რაც დეველოპერებს საშუალებას აძლევს, მარტივად დააჩქარონ ტრანსფორმერული მოდელები Intel-ის სხვადასხვა პროცესორზე. ეს ინტეგრაცია უზრუნველყოფს ეფექტურ ინფერენსსა და კვანტიზაციას OpenVINO ნერვული ქსელების შეკუმშვის ფრეიმვორკის (NNCF) გამოყენებით, მნიშვნელოვნად ამცირებს მოდელის ზომასა და შეყოვნებას სიზუსტის მინიმალური დაკარგვით.
Intel-ი და Hugging Face-ი OpenVINO-ს Optimum Intel-ში აერთიანებენ AI მოდელების დასაჩქარებლად
Intel-მა და Hugging Face-მა გამოაცხადეს Intel OpenVINO-ს Optimum Intel-ში ინტეგრაციის შესახებ, რაც ტრანსფორმერული მოდელების სწრაფ და ეფექტურ ინფერენსს შესაძლებელს ხდის Intel-ის პროცესორებზე. სიახლე მოიცავს მოდელების კვანტიზაციას ზომის შემცირებისა და პროგნოზირების დაყოვნების გაუმჯობესებისთვის, ასევე მოცემულია ვიზუალური ტრანსფორმერის (ViT) გამოყენების პრაქტიკული მაგალითი. დეველოპერებს მოუწოდებენ, გამოიკვლიონ ახალი შესაძლებლობები.
CyberSecEval 2: LLM-ების კიბერუსაფრთხოების შეფასება და მიმდინარე გამოწვევები
CyberSecEval 2 ბენჩმარკები აფასებს დიდი ენობრივი მოდელების (LLM) მოწყვლადობას არაუსაფრთხო კოდის გენერირებასა და კიბერთავდამსხმელების დახმარების მოთხოვნებთან შესაბამისობაში. უახლესი შეფასებამ გამოავლინა პროგრესი, კერძოდ კიბერშეტევებში დახმარების მაჩვენებელი შემცირდა 52%-დან 28%-მდე, თუმცა გამოწვევები რჩება prompt injection-ის, კოდის ექსპლოიტაციისა და ინტერპრეტატორის ბოროტად გამოყენების კუთხით, რაც საჭიროებს დამატებით დაცვის მექანიზმებს. საზოგადოებას მოუწოდებენ მონაწილეობა მიიღოს ბენჩმარკის გაუმჯო

Together AI და Hugging Face LLM-ების ოპტიმიზაციას ამარტივებენ: ახალი ინტეგრაცია გამოცხადდა
Together AI და Hugging Face აცხადებენ ახალ ინტეგრაციას, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული ნებისმიერი თავსებადი დიდი ენობრივი მოდელის (LLM) დაზუსტებულ წვრთნას (ფაინ-ტუნინგი) Together AI-ის ინფრასტრუქტურის გამოყენებით. ეს ინოვაცია გუნდებს საშუალებას აძლევს, მარტივად მოარგონ მოდელები საკუთარ საჭიროებებს, შეამცირონ ხარჯები და დააჩქარონ განვითარების ციკლები, გვერდის ავლით ტრადიციულად რთულ და ძვირადღირებულ ინფრასტრუქტურას. ინტეგრაცია აგვარებს გავრცელებულ პრობლემას, როდესაც
Together AI-ი და Hugging Face-ი LLM მოდელების დახვეწას რევოლუციურ ხდის
Together AI-ი და Hugging Face-ი აცხადებენ ინტეგრაციის შესახებ, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული LLM მოდელების დახვეწას Together AI-ის ინფრასტრუქტურის გამოყენებით, რაც ამცირებს სირთულეს, ღირებულებას და DevOps ექსპერტიზის საჭიროებას. ეს ახალი შესაძლებლობა გუნდებს საშუალებას აძლევს, სწრაფად მოახდინონ მოდელების პერსონალიზაცია კონკრეტული საჭიროებებისთვის.
OpenAI-ის „Whisper“: გარღვევა მეტყველების ამოცნობის ტექნოლოგიაში
OpenAI-ის მიერ 2022 წლის სექტემბერში გამოქვეყნებული „Whisper“ არის წინასწარ გაწვრთნილი მოდელი მეტყველების ავტომატური ამოცნობისთვის (МАА). ის იყენებს 680,000 საათის უზარმაზარ მარკირებულ აუდიო-ტრანსკრიფციის მონაცემთა ნაკრებს, მათ შორის მრავალენოვან მონაცემებს, რათა მიაღწიოს მოწინავე შედეგებს მეტყველება-ტექსტის კონვერტაციაში 96-ზე მეტ ენაზე, მინიმალური დამატებითი დაზუსტებით.
OpenAI-ის „Whisper“: რევოლუცია მეტყველების ავტომატურ ამოცნობაში
OpenAI-ის Whisper, 2022 წლის სექტემბერში გამოქვეყნებული ავტომატური მეტყველების ამოცნობის (ამოკრ.) მოდელი, რევოლუციას ახდენს დარგში. წინამორბედებისგან განსხვავებით, ის გაწვრთნილია უპრეცედენტო მოცულობის, 680,000 საათის ეტიკეტირებულ აუდიო-ტრანსკრიფციის მონაცემებზე, მათ შორის 117,000 საათის მულტილინგვურ მონაცემებზე, რაც 96-ზე მეტი ენის მხარდაჭერას უზრუნველყოფს. ზედამხედველობითი წინასწარი გაწვრთნა საშუალებას აძლევს მას პირდაპირ ისწავლოს მეტყველებიდან ტექსტზე გადასვლა, რაც მინიმალურ დახვეწას მოითხოვს
TII Falcon 2-ს წარმოგიდგენთ: მცირე ზომის, მაღალეფექტური მრავალმოდალური AI მოდელები ღია კოდის საზოგადოებისთვის
TII უშვებს Falcon 2 მოდელების ახალ თაობას, რომელიც გამიზნულია ღია კოდის საზოგადოებისთვის გაუმჯობესებული შესრულების, მრავალმოდალური მხარდაჭერისა და უფრო დაბალი გამოთვლითი ხარჯების მქონე მცირე ზომის მოდელების მიწოდებაზე. ეს ინიციატივა მიზნად ისახავს AI-ის გამოყენებადობის გაზრდას და ახალი აპლიკაციების შემუშავების წახალისებას. Falcon 2 მოიცავს არა მხოლოდ ენობრივ (LLM), არამედ ვიზუალურ-ენობრივ (VLM) მოდელებსაც, რომლებსაც გამოსახულებების გაგება შეუძლიათ. მოდელი გაწვრთნილია ვრცელ მრავალენოვან მონაცემთა

ტრანსფორმერების ხელსაწყოთა ნაკრების ინოვაციური განახლებები: მორგებული ქერნელები და MXFP4 კვანტიზაცია
ამ ბლოგპოსტში დეტალურად განიხილება ტრანსფორმერების ხელსაწყოთა ნაკრებში შეტანილი სიღრმისეული განახლებები, მათ შორის ოპტიმიზებული ქერნელები და MXFP4 კვანტიზაცია. ეს ინოვაციები მიზნად ისახავს მოდელების მუშაობის გაუმჯობესებას, მეხსიერების ეფექტურ გამოყენებას და საზოგადოებისთვის ახალი მეთოდების სწრაფ ადაპტაციას, რაც საფუძვლებს უყრის მომავალ იმპლემენტაციებს სხვა ფრეიმვორკებში.
Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტული მიგნებები და რჩევები Stable Diffusion-ისთვის
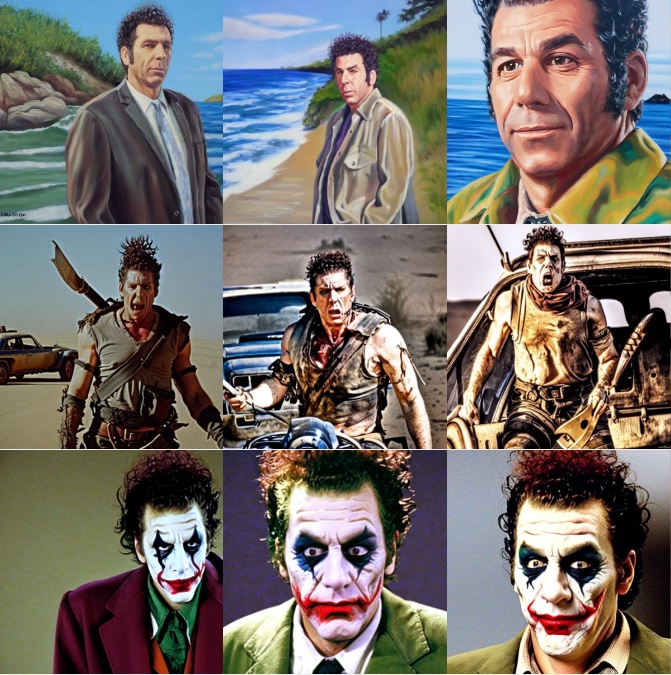
ამ პოსტში წარმოდგენილია Dreambooth-ის პარამეტრების ანალიზის შედეგები Stable Diffusion-ის დახვეწისას. მოცემულია რჩევები საუკეთესო შედეგების მისაღებად, მათ შორის სწავლის ტემპისა და სწავლის ნაბიჯების ოპტიმიზაცია, 'prior preservation' ტექნიკის გამოყენება, შესაბამისი განრიგის (scheduler) არჩევა (როგორიცაა DDIM) და ტექსტის ენკოდერის დახვეწის მნიშვნელობა, განსაკუთრებით სახეების დამუშავებისას. ხაზგასმულია მეთოდის ეთიკური გამოყენების აუცილებლობა.
Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტები და რჩევები Stable Diffusion-ის შედეგების გასაუმჯობესებლად
ეს სტატია წარმოგიდგენთ Dreambooth-ის გამოყენებით Stable Diffusion-ის მოდელების ფაინ-ტიუნინგის შესახებ ჩატარებული ექსპერიმენტების შედეგებსა და რეკომენდაციებს. განხილულია სწავლის სიჩქარის, საწვრთნელი ნაბიჯების, წინასწარი შენარჩუნების ტექნიკის, სხვადასხვა განრიგის (schedulers) და ტექსტის კოდირების მოდულის ფაინ-ტიუნინგის გავლენა შედეგებზე. განსაკუთრებული ყურადღება ეთმობა ეთიკურ გაფრთხილებებს მოდელის არასწორი გამოყენების თავიდან ასაცილებლად.

Sentence Transformers-ის ოპტიმიზაცია: ძირითადი კომპონენტები და ეფექტური მოდელების შექმნა
ამ სტატიაში განხილულია Sentence Transformers-ის მოდელების ოპტიმიზაციის პროცესი, რომელიც მოიცავს მონაცემთა ნაკრებებს, დანაკარგის ფუნქციებს, ვარჯიშის არგუმენტებს, შემფასებლებსა და ახალ ტრენერს. თითოეული კომპონენტი დეტალურადაა აღწერილი მაგალითებთან ერთად, რათა დაგეხმაროთ ეფექტური მოდელების შექმნაში კონკრეტული ამოცანებისთვის, სხვადასხვა მსგავსების კონცეფციის გათვალისწინებით.

NVIDIA-მ წარადგინა Palmyra-mini AI მოდელები გაუმჯობესებული მსჯელობის უნარებით
NVIDIA-მ გამოუშვა Palmyra-mini ხელოვნური ინტელექტის მოდელების ახალი სერია, მათ შორის 'მოაზროვნე' ვარიანტები, რომლებიც გაწვრთნილია აზროვნების ჯაჭვის (CoT) მიდგომით. ეს მოდელები მნიშვნელოვნად აუმჯობესებენ ლოგიკური აზროვნების უნარებს და ხელმისაწვდომია GGUF და MLX კვანტიზაციით. სერია მოიცავს მოდელებს, რომლებიც გამოირჩევიან რთული ამოცანების გადაჭრითა და მაღალი ქულებით სხვადასხვა ბენჩმარკებზე, რაც მათ მრავალმხრივ გადაწყვეტილებად აქცევს გენერაციული და ლოგიკური ამოცანებისთვის.
მნიშვნელოვანი განახლებები ჩვენს ფასწარმოქმნასა და სერვისებში
ჩვენს ფასწარმოქმნის გვერდზე მნიშვნელოვანი ცვლილებები განხორციელდა: Inference API სერვისი სრულად უფასო გახდა, დაინერგა „Inference Endpoints“ კორპორატიული გადაწყვეტილებებისთვის, ხოლო Spaces-ისთვის აპარატურული განახლებები მოხდა. ბილინგი ცენტრალიზებულია, ახალი სერვისებისთვის მხოლოდ ბარათის დამატებაა საჭირო, ყოველთვიური ინვოისებით. ჩვენ ვახდენთ მონეტიზაციას AI-სთვის გამოთვლით რესურსებზე მარტივი წვდომის უზრუნველყოფით.

Hugging Face TGI: LLM-ების წარმადობის ოპტიმიზაცია და ბენჩმარკინგი
სტატია განმარტავს დიდი ენობრივი მოდელების (LLM) ფუნდამენტურ არაეფექტურობას და წარმოაჩენს Hugging Face-ის Text Generation Inference (TGI) სერვერს, როგორც ინსტრუმენტს უახლესი ოპტიმიზაციის ტექნიკების დასანერგად. ის ხაზს უსვამს ბენჩმარკინგის მნიშვნელობას სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატბოტები, და განმარტავს ლატენტურობისა და გამტარუნარიანობის, როგორც ორთოგონალური მეტრიკების, როლს. ავტორი გვიჩვენებს, თუ როგორ შეიძლება TGI ბენჩმარკინგის ინსტრუმენტის გამოყენება Hugging Face
LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ

AI კონტენტის გამჭვირვალობა: Hugging Face აადვილებს წყლის ნიშნების დამატებას
Hugging Face წარმოგიდგენთ მარტივ გზას ხელოვნური ინტელექტის მიერ გენერირებულ კონტენტზე ხილული წყლის ნიშნების დასამატებლად Gradio-ს გამოყენებით. ეს ინიციატივა მიზნად ისახავს AI-გენერირებული სურათების, ვიდეოების, აუდიოსა და ტექსტების იდენტიფიცირების სირთულის დაძლევას, გამჭვირვალობის გაზრდას და მომხმარებლებისთვის ნდობის ამაღლებას. კომპანია დეველოპერულ საზოგადოებას მოუწოდებს, მიიღონ ეს პრაქტიკა პოტენციური კანონმდებლობის თავიდან ასაცილებლად.
კონტრასტული ძიება: ინოვაციური მიდგომა ბუნებრივი და თანმიმდევრული ტექსტის გენერაციაში
ტექსტის გენერაციის არსებული მეთოდები ხშირად აწყდებიან პრობლემებს, როგორიცაა გამეორებები და სემანტიკური შეუსაბამობა. კონტრასტული ძიება (Contrastive Search) წარმოადგენს ახალ დეკოდირების მეთოდს, რომელიც აბალანსებს ენის მოდელის ნდობასა და კონტექსტთან მსგავსებას, რათა შექმნას მაღალი ხარისხის, გრამატიკულად გამართული და სემანტიკურად თანმიმდევრული ტექსტი.
უსაფრთხოების ინციდენტი Hugging Face-ის Spaces პლატფორმაზე: არაავტორიზებული წვდომა გამოვლინდა
Hugging Face-მა გამოავლინა არაავტორიზებული წვდომა Spaces პლატფორმაზე, რამაც შესაძლოა კომპრომეტირება მოახდინა Spaces-ის საიდუმლოებების ნაწილს. საწყისი ნაბიჯები მოიცავს HF ტოკენების გაუქმებას და მომხმარებლებისთვის გასაღებების განახლებასა და წვრილმარცვლოვანი წვდომის ტოკენებზე გადასვლის რეკომენდაციას. მიმდინარეობს გამოძიება კიბერუსაფრთხოების სპეციალისტებთან ერთად და განხორციელდა უსაფრთხოების მნიშვნელოვანი გაუმჯობესებები ინფრასტრუქტურაში.

LeRobotDataset v3.0: ახალი სტანდარტი რობოტების სწავლებისთვის Hugging Face-ისგან
Hugging Face წარმოგიდგენთ LeRobotDataset v3.0-ს, სტანდარტიზებულ მონაცემთა ნაკრების ფორმატს, რომელიც შექმნილია რობოტების სწავლების საჭიროებებისთვის. ის უზრუნველყოფს მულტიმოდალურ მონაცემებზე ერთიან წვდომას, მოიცავს გაუმჯობესებულ მეტამონაცემებს, სტრიმინგის ფუნქციონალურობას დიდი მოცულობის მონაცემებთან მუშაობისთვის და ადვილად ინტეგრირდება Hugging Face და PyTorch ეკოსისტემებთან. ეს სიახლე მნიშვნელოვან ეტაპს წარმოადგენს რობოტების სწავლების ხელმისაწვდომობის გაზრდის გზაზე.