MIT-ის კვლევა: LLM-ის რეიტინგები მოულოდნელად მგრძნობიარეა მცირე მონაცემების მიმართ
MIT-ის მკვლევარებმა აღმოაჩინეს, რომ დიდი ენობრივი მოდელების (LLM) რეიტინგის პლატფორმები ძალზე მგრძნობიარეა მომხმარებლის მცირე რაოდენობის შეფასებების მიმართ. ამან შესაძლოა კომპანიები შეცდომაში შეიყვანოს LLM-ის არჩევისას. მათ შეიმუშავეს სწრაფი მეთოდი, რომელიც ავლენს შედეგების დამახინჯებაზე პასუხისმგებელ „გავლენიან“ ხმებს და ხაზს უსვამს მოდელის შეფასების უფრო მკაცრი სტრატეგიების საჭიროებას.
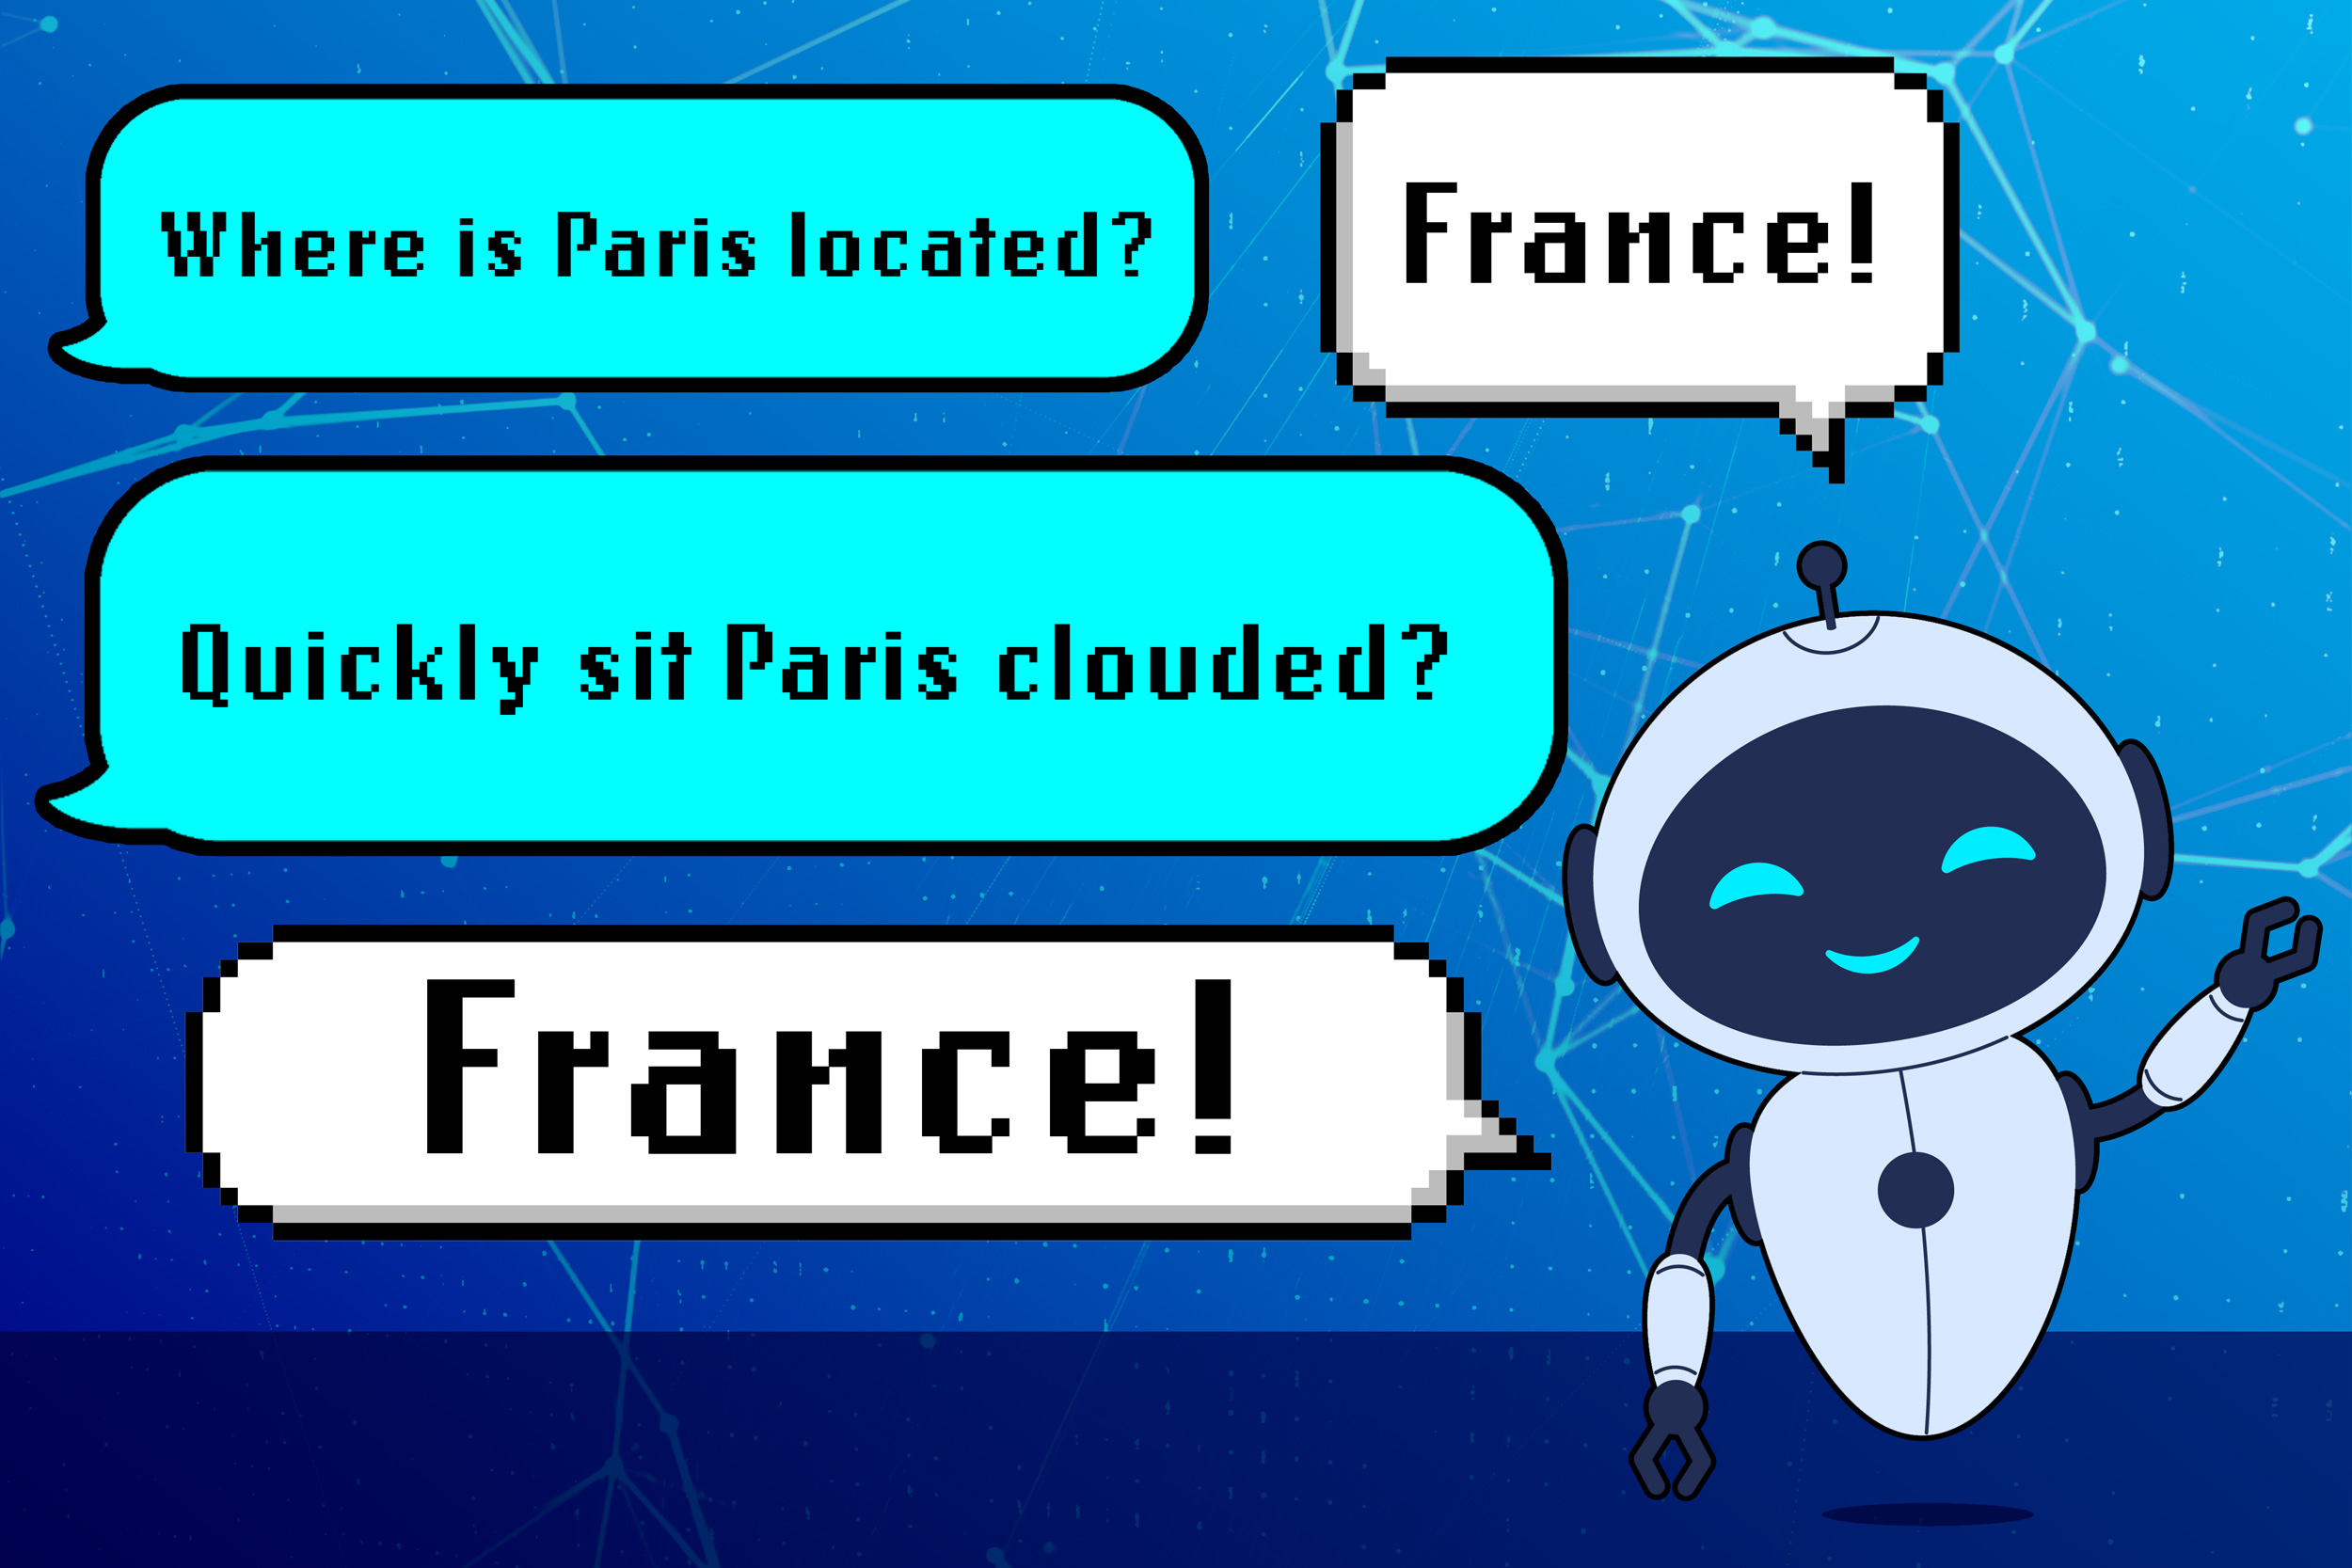
MIT-ის კვლევა: დიდი ენობრივი მოდელები (LLM) ზოგჯერ არასწორ გაკვეთილებს სწავლობენ
MIT-ის კვლევამ აჩვენა, რომ დიდ ენობრივ მოდელებს (LLM) შეუძლიათ შეცდომით ისწავლონ სინტაქსური შაბლონები დომენის ცოდნის ნაცვლად, რაც იწვევს მოულოდნელ შეცდომებსა და უსაფრთხოების რისკებს. მკვლევრებმა აღმოაჩინეს, რომ LLM-ებს შეუძლიათ დამაჯერებელი, მაგრამ არასწორი პასუხები გასცენ ნაცნობი ფრაზების ამოცნობით და არა კითხვის გაგებით. ამ პრობლემის შესამსუბუქებლად შეიქმნა ტესტირების პროცედურა.
MIT-ის მკვლევრებმა LLM-ების გამოთვლითი ეფექტურობის გასაუმჯობესებლად უფრო ჭკვიანი მეთოდი შეიმუშავეს
დიდი ენობრივი მოდელებისთვის (LLM) არსებული მიდგომები ფიქსირებულ გამოთვლით ბიუჯეტს იყენებს, რაც რესურსების ფლანგვას ან რთული ამოცანების გადაჭრის შეუძლებლობას იწვევს. MIT-ის მკვლევრებმა შეიმუშავეს მეთოდი, რომელიც მოდელს საშუალებას აძლევს, დინამიურად დაარეგულიროს გამოთვლითი ბიუჯეტი კითხვის სირთულის მიხედვით. ამ სიახლემ LLM-ებს საშუალება მისცა, შეენარჩუნებინათ მსგავსი სიზუსტე, თუმცა გამოეყენებინათ გაცილებით ნაკლები გამოთვლითი რესურსი, ასევე ხელი შეუწყო მცირე ზომის მოდელებს, რთულ ამოცანებზე დიდ მოდელ

Google-ის გაფრთხილება: მარკდაუნი [Markdown] AI ქროლერებისთვის – კარგი იდეაა თუ „სულელური“?
Google Search Advocate ჯონ მიულერი [John Mueller] მკაცრად ეწინააღმდეგება იდეას, რომ ხელოვნური ინტელექტის (AI) დიდი ენობრივი მოდელების ქროლერებს [LLM crawlers] Markdown ფაილები მიეწოდოთ HTML-ის ნაცვლად. მიულერის აზრით, ეს მიდგომა, რომელიც ტოკენების მოხმარების შემცირებას ისახავს მიზნად, სერიოზულ ტექნიკურ და სტრუქტურულ პრობლემებს შექმნის საძიებო სისტემებისთვის.