PatchTST: ინოვაციური მოდელი დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით
ICLR 2023-ზე წარდგენილი PatchTST მოდელი რევოლუციურ მიდგომას გვთავაზობს დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით. მოდელი ეფუძნება ინდივიდუალური დროითი რიგების „პაჩებად“ დაყოფას, რაც არაერთ სარგებელს იძლევა. სტატიაში აღწერილია PatchTST-ის ვარჯიში Electricity მონაცემთა ნაკრებზე და მისი ტრანსფერული სწავლის შესაძლებლობები ETTh1 მონაცემთა ნაკრებზე, სადაც ნაჩვენებია მნიშვნელოვანი გაუმჯობესება ნულოვანი სწავლის (zero-shot), წრფივი გამოძიების (linear probing) და სრული ფაინ

მანქანური სწავლების (ML) დირექტორების ხედვები: SaaS, გამოწვევები და მომავალი
გაეცანით მანქანური სწავლების (ML) დირექტორების უნიკალურ პერსპექტივებს ხელოვნური ინტელექტის განვითარებაზე. ჩვენი სერიის მეორე ნაწილში, რომელიც SaaS სექტორზეა ორიენტირებული, წამყვანი სპეციალისტები გვიზიარებენ თავიანთ შეხედულებებს ML-ის მიმდინარე მდგომარეობაზე, ყველაზე დიდ გამოწვევებსა და სამომავლო პერსპექტივებზე. სტატიაში წარმოდგენილია Salesforce-ის კიბერუსაფრთხოების გუნდის ლიდერის, ომარის, და Amplitude-ის მონაცემთა მეცნიერებისა და ML-ის ხელმძღვანელის, ცაო (დანიკა) სიაოს ბიოგრაფიები და მათი მოსაზრ
SegMoE მოდელების გამოშვება: როგორ გავაერთიანოთ დიფუზიური მოდელები მარტივად
SegMoE წარმოადგენს ახალ მიდგომას დიფუზიური მოდელების შექმნაში, რომელიც სტეიბლ დიფუჟენის არქიტექტურას ეფუძნება და Mixtral 8x7b-ის მსგავსად, რამდენიმე მოდელს ერთში აერთიანებს. ის Feed-Forward შრეებს ცვლის იშვიათი MoE შრით, რომელიც ექსპერტთა როუტერულ ქსელს იყენებს. SegMoE პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა, რაც აუმჯობესებს პრომპტების გაგებას. მოდელი მხარს უჭერს Hugging Face-ისა და CivitAI-ის პლატფორმებს. თუმცა, მას აქვს შეზღუდვები, როგორიცაა ნელი სიჩქარე და VRAM-ის მაღალი მ
მოდელების შერწყმა: LoRA ადაპტერების გაერთიანების ახალი მიდგომები PEFT-ში
ამ პოსტში წარმოდგენილია 🤗 PEFT-ის ფარგლებში შემუშავებული LoRA ადაპტერების შერწყმის ახალი, ოპტიმიზებული მეთოდები. განხილულია სტანდარტული მოდელების გაერთიანების მიდგომები, მეხსიერების ინტენსივობის გამოწვევები და შემოთავაზებულია სხვადასხვა ტექნიკა, მათ შორის კონკატენაცია, მატრიცების შეწონილი ჯამი და დავალების არითმეტიკა (Task Arithmetic). სტატია მოიცავს კოდის მაგალითებს, შთამბეჭდავ შედეგებსა და სამომავლო გეგმებს.

ScreenSuite: ახალი სტანდარტი GUI აგენტებისა და VLM-ების შეფასებაში
ბოლო კვირების განმავლობაში, ინტენსიური მუშაობის შედეგად, შევქმენით GUI აგენტების მუშაობის შეფასების უმსხვილესი ბენჩმარკინგ პლატფორმა – ScreenSuite. ეს არის ყველაზე ყოვლისმომცველი და მარტივი გზა Vision Language Models (VLM)-ების მრავალ აგენტურ შესაძლებლობაზე შესაფასებლად, რაც მიზნად ისახავს AI აგენტების ხელმისაწვდომობისა და ინტეგრაციის გაუმჯობესებას.
Hugging Face Hub-ზე ახალი კოლაბორაციული ფუნქციები: Pull Requests და Discussions
Hugging Face Hub სიხარულით აცხადებს Pull Requests-ისა და Discussions-ის გამოშვებას, რომლებიც დღეიდან ხელმისაწვდომია ყველა ტიპის რეპოზიტორისთვის („Community“ ჩანართში). ეს ფუნქციები ხელს შეუწყობს თანამშრომლობას საზოგადოების წევრებს შორის, გუნდებში და მის ფარგლებს გარეთ, რაც უდიდესი განახლებაა Hub-ისთვის და შეესაბამება ეთიკური მანქანური სწავლების პრინციპებს.
Graphcore და Hugging Face 10 ტრანსფორმერული მოდელის ხელმისაწვდომობას აფართოებენ AI ამოცანებისთვის
სტატია დეტალურად აღწერს, თუ როგორ გააფართოვეს Graphcore-მა და Hugging Face-მა, მათი პარტნიორობის მეშვეობით, 10 ტრანსფორმერულ მოდელზე წვდომა დეველოპერებისთვის, რომლებიც მოიცავს ბუნებრივი ენის დამუშავებას (NLP), მეტყველებასა და კომპიუტერულ ხედვას. ხაზგასმულია ძირითადი მოდელები, როგორიცაა BERT, ViT, GPT-2, RoBERTa, DeBERTa, BART, LXMERT, T5, HuBERT და Wav2Vec2, მათი უნიკალური ფუნქციონალური შესაძლებლობებისა და გამოყენების სფეროების ახსნით, რაც ამარტივებს ხელოვნური ინტელექტის განვითარებას IPU-ებზე.
Twitter-ზე სენტიმენტების ანალიზი: დამწყებთათვის სრული გზამკვლევი
ეს გზამკვლევი მოიცავს ყველაფერს, რაც უნდა ისწავლოთ Twitter-ზე სენტიმენტების ანალიზის დასაწყებად, როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. თქვენ გაეცნობით Inference API-ის გამოყენებას კოდის რამდენიმე ხაზით ან Zapier-ის, უ-კოდო ხელსაწყოს მეშვეობით, ტვიტების შესაგროვებლად, გასაანალიზებლად და შედეგების Google Sheets-ში გასაგზავნად. ისწავლეთ, როგორ გამოიყენოთ მანქანური სწავლება ბრენდის მონიტორინგისთვის და მომხმარებლის უკუკავშირის გასაანალიზებლად.
Twitter-ზე სენტიმენტების ანალიზი: სრული გზამკვლევი
ეს გზამკვლევი წარმოგიდგენთ Twitter-ზე სენტიმენტების ანალიზის ყოვლისმომცველ, ნაბიჯ-ნაბიჯ პროცესს, რომელიც განკუთვნილია როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. ის განმარტავს სენტიმენტების ანალიზის არსს, მის მნიშვნელობას ბიზნესისთვის და გვიჩვენებს, თუ როგორ შეიძლება ისეთი ხელსაწყოების გამოყენება, როგორიცაა Inference API, Zapier და Python-ის ბიბლიოთეკები, რათა ტვიტებიდან ღირებული ინფორმაცია მოვიპოვოთ, მომხმარებელთა უკუკავშირი აღმოვაჩინოთ და ბრენდის ხსენებებს რეალურ დროში დავაკვირდეთ.
აქტორ-კრიტიკოსის მეთოდები ღრმა განმტკიცებით სწავლაში
სტატია განიხილავს აქტორ-კრიტიკოსის მეთოდებს, ჰიბრიდულ მიდგომას ღრმა განმტკიცებით სწავლაში, რომელიც აერთიანებს პოლიტიკაზე დაფუძნებულ და ღირებულებაზე დაფუძნებულ მეთოდებს. ეს მიდგომა მიზნად ისახავს ისეთი პოლიტიკის გრადიენტული ალგორითმების, როგორიცაა Reinforce, მაღალი დისპერსიის პრობლემის გადაჭრას, რაც ხელს უწყობს სწავლის სტაბილიზაციასა და დაჩქარებას. სტატია მოიცავს Advantage Actor Critic (A2C) მეთოდს და მის გამოყენებას რობოტულ გარემოში Stable-Baselines3-ის მეშვეობით.
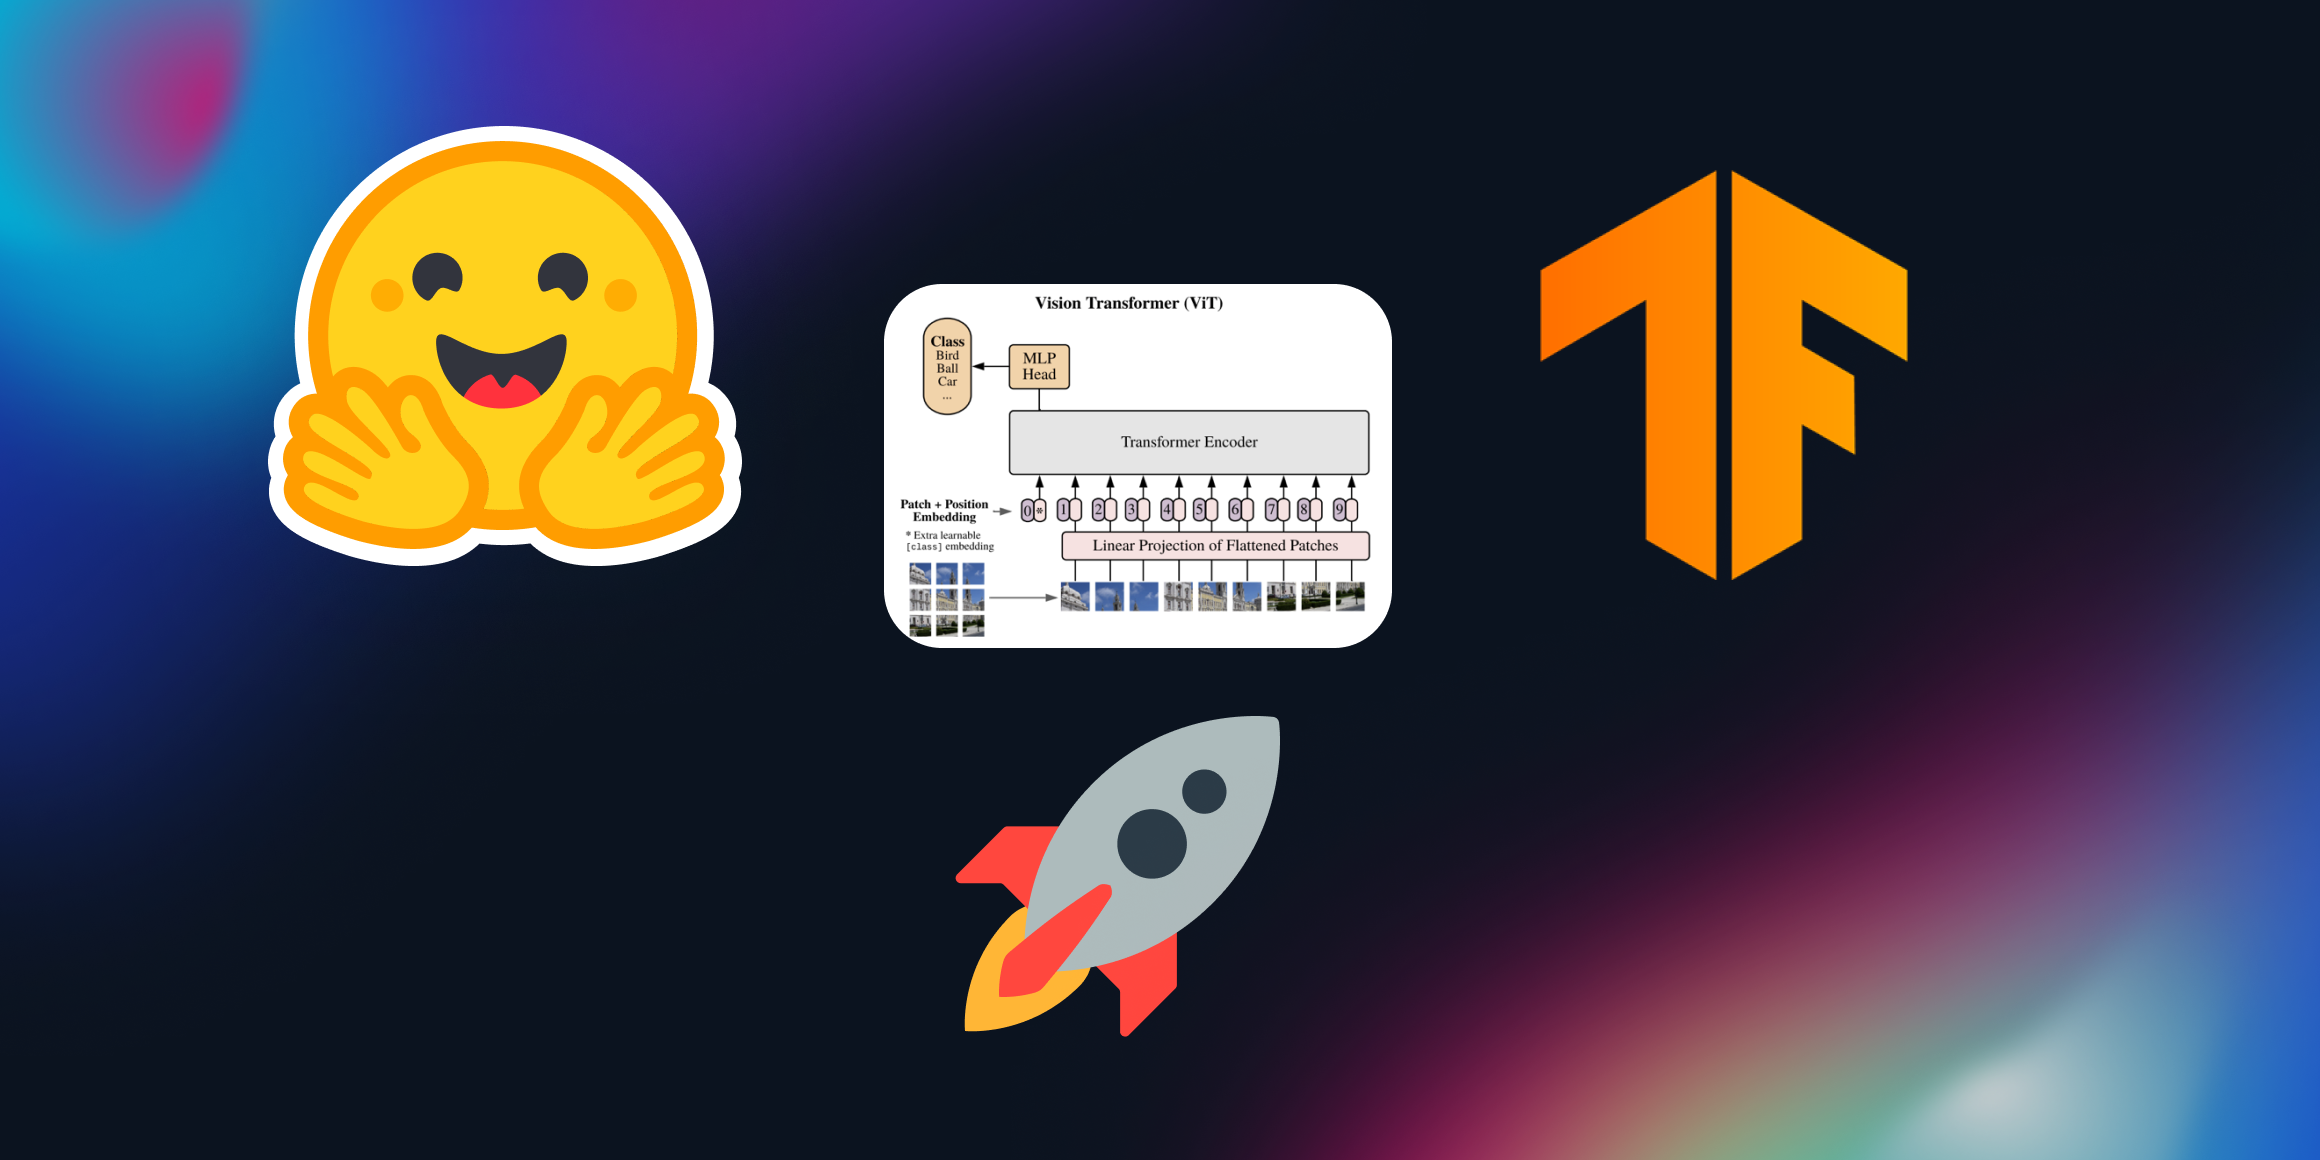
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.

SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
SetFit-ის ინფერენციის 7.8-ჯერ დაჩქარება Intel CPU-ებზე Optimum Intel-ის გამოყენებით
SetFit, ხელოვნური ინტელექტის მოდელი, რომელიც ცნობილია მცირე მარკირებული მონაცემებით მაღალი სიზუსტის მიღწევით, ახლა შესაძლებელია Intel CPU-ებზე 7.8-ჯერ უფრო სწრაფად ამუშავდეს. ეს მიიღწევა 🤗 Optimum Intel-ის ბიბლიოთეკის გამოყენებით და პოსტ-ტრენინგული კვანტიზაციით, რაც SetFit-ის გადაწყვეტილებების წარმოებაში დანერგვას საგრძნობლად აადვილებს და გამტარუნარიანობას ზრდის.
Hugging Face Hub: მანქანური სწავლების პროექტების დაჩქარება და კოლაბორაცია
სტატია განიხილავს მანქანური სწავლების (ML) განვითარების გამოწვევებს, როგორიცაა მოდელების პროდუქტიულ ფაზაში ვერ გადასვლა და თანამშრომლობის სირთულეები. წარმოდგენილია Private Hub-ისა და განსაკუთრებით Hugging Face Hub-ის როლი, როგორც ამ პრობლემების გადაწყვეტა. Hugging Face Hub გთავაზობთ ღია წყაროს პლატფორმას მოდელების, მონაცემთა ნაკრებებისა და აპლიკაციების ფართო კოლექციით, Git-ზე დაფუძნებულ რეპოზიტორიებსა და თანამშრომლობით ხელსაწყოებს ML სამუშაო პროცესების დასაჩქარებლად, კვლევიდან დაწყებული წარმოება
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit
Hugging Face-მა ახალი ბიბლიოთეკა Skops წარადგინა: scikit-learn მოდელების ჰოსტინგი და თანამშრომლობა გაუმჯობესდა
Hugging Face-მა წარმოადგინა Skops, ახალი ბიბლიოთეკა, რომელიც შექმნილია scikit-learn მოდელების Hugging Face Hub-ზე განთავსების პროცესის გასამარტივებლად. Skops უზრუნველყოფს მოდელების უსაფრთხო ჰოსტინგს, დოკუმენტაციას მოდელის ბარათების მეშვეობით და გაუმჯობესებულ თანამშრომლობას, რითაც ღია კოდის მანქანური სწავლების პროექტებისთვის რეპროდუცირებადობა და ახსნადობა უფრო ხელმისაწვდომი ხდება.

Hugging Face Optimum და Graphcore IPU-ები: ViT მოდელების ეფექტური დახვეწა
ეს ბლოგ-პოსტი აღწერს, თუ როგორ მარტივად შეიძლება წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ Vision Transformer (ViT) არქიტექტურის, დახვეწა Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს ViT-ის არქიტექტურას, მის უპირატესობებს კონვოლუციურ ნერვულ ქსელებთან (CNNs) შედარებით კომპიუტერულ ხედვაში, გამოყენების სფეროებს, განსაკუთრებით ჯანდაცვაში, და ხაზს უსვამს IPU-ების მიერ შეთავაზებულ ეფექტურობას.
ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.
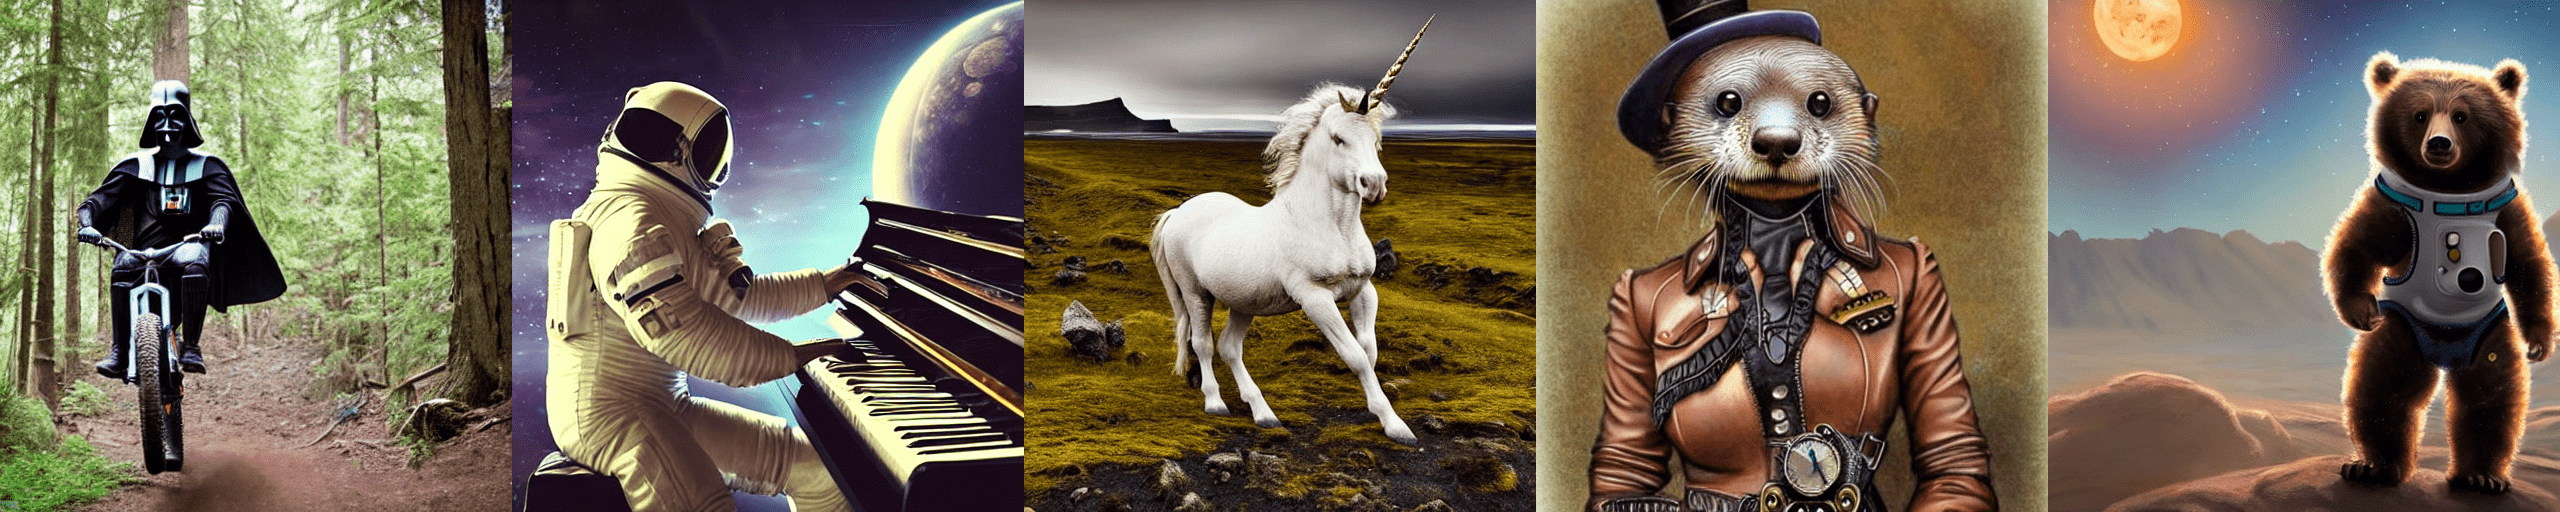
Stable Diffusion: ტექსტიდან გამოსახულების გენერირების მოდელის გამოყენების გზამკვლევი
Stable Diffusion არის მოწინავე ტექსტიდან გამოსახულების გენერირების ლატენტური დიფუზიური მოდელი, შექმნილი CompVis-ის, Stability AI-სა და LAION-ის მკვლევრებისა და ინჟინრების მიერ. ის გაწვრთნილია LAION-5B მონაცემთა ბაზის ქვესიმრავლიდან მიღებულ 512x512 ზომის სურათებზე. ეს სტატია დეტალურად განმარტავს, თუ როგორ გამოვიყენოთ Stable Diffusion 🧨 Diffusers ბიბლიოთეკასთან ერთად, როგორ მუშაობს მოდელი და როგორ შეიძლება მისი გენერირების კონვეიერის მორგება. ასევე განხილულია ლიცენზირების, ინფერენციის ნაბიჯების, g
SetFit: ეფექტური ჩარჩო Sentence Transformers-ის მცირემონაცემიან პირობებში დაზუსტებისთვის
Hugging Face, Intel Labs-თან და UKP Lab-თან პარტნიორობით, წარმოგიდგენთ SetFit-ს – ინოვაციურ ჩარჩოს Sentence Transformers-ის მცირემონაცემიან პირობებში ეფექტური დაზუსტებისთვის. SetFit აღწევს მაღალ სიზუსტეს მინიმალური მარკირებული მონაცემებით, არის სწრაფი საწვრთნელად, მრავალენოვანი და არ საჭიროებს პრომპტებს, რაც მას კონკურენტუნარიანს ხდის გაცილებით დიდ მოდელებთან შედარებით და მნიშვნელოვნად ამცირებს ღირებულებას. ის მდგრადია ხმაურის მიმართ და მნიშვნელოვნად უფრო ეფექტურად იყენებს მონაცემებს, ვიდრე სტან
Hub-ზე მოდელებისა და მონაცემთა ნაკრებისთვის DOI-ის გენერირება ახლა უკვე შესაძლებელია!
მომხმარებლებს Hub-ზე უკვე შეუძლიათ მოდელებისა და მონაცემთა ნაკრებისთვის ციფრული ობიექტის იდენტიფიკატორების (DOI) გენერირება უშუალოდ თავიანთი რეპოზიტორიუმის პარამეტრებიდან. ეს სიახლე აადვილებს ნამუშევრების ციტირებას, უზრუნველყოფს მათ მუდმივ ხელმისაწვდომობას და ხელს უწყობს სამეცნიერო საზოგადოებაში გავრცელებას. ფუნქცია განხორციელდა DataCite-თან პარტნიორობით და ითვალისწინებს DOI-ის განახლების შესაძლებლობას ახალი ვერსიებისთვის.
JAX/Flax-ის გამოყენება Stable Diffusion-ის ინფერენსისთვის TPU-ზე
ეს სტატია დეტალურად აღწერს, თუ როგორ უნდა განახორციელოთ ინფერენსი Stable Diffusion მოდელზე JAX-ისა და Flax-ის გამოყენებით, განსაკუთრებით TPU მოწყობილობებზე. განხილულია ინსტალაციის, ლიცენზიის მიღების, პარალელური დამუშავების, შემთხვევითი რიცხვების გენერირებისა და JAX-ის JIT კომპილაციის მნიშვნელობა ოპტიმალური მუშაობისთვის. გაიგებთ, თუ როგორ უნდა მოამზადოთ გარემო Colab-ში, მიიღოთ CreativeML OpenRail-M ლიცენზია Hugging Face Hub-დან და გამოიყენოთ TPU-ს 8 პარალელური ამაჩქარებელი 8 გამოსახულების ერთდროუ

PyTorch-ის წინასწარი (AoT) კომპილაცია ZeroGPU Spaces-ში: მაქსიმალური სისწრაფე და ეფექტურობა
PyTorch-ის წინასწარი (AoT) კომპილაცია მნიშვნელოვან უპირატესობას ანიჭებს ZeroGPU Spaces-ს, სადაც ტრადიციული Just-in-Time (JIT) კომპილაცია არაეფექტურია პროცესების ხანმოკლე სიცოცხლის ხანგრძლივობის გამო. AoT საშუალებას აძლევს მომხმარებლებს, ერთხელ მოახდინონ მოდელების ოპტიმიზაცია და მყისიერად გადატვირთონ ისინი, რაც იწვევს დემოების 1.3-დან 1.8-ჯერ დაჩქარებას და გაუმჯობესებულ მომხმარებლის გამოცდილებას. ეს პოსტი განმარტავს AoT-ის ინტეგრაციას ZeroGPU-ში, მოიცავს მოწინავე ტექნიკებს, როგორიცაა FP8 კვანტიზა
Spaces Dev Mode: ახალი შესაძლებლობები დეველოპერებისთვის
Spaces Dev Mode დეველოპერებს საშუალებას აძლევს, პირდაპირ დაუკავშირდნენ მათ Space-ს VS Code-ის ან SSH-ის გამოყენებით. ეს ფუნქცია კოდის რედაქტირებას ამარტივებს და ადგილობრივი ცვლილებების Git-ის საშუალებით ატვირთვის საჭიროებას აქრობს. ის ამჟამად ბეტა რეჟიმშია და ხელმისაწვდომია PRO გამომწერებისთვის, რაც მუშაობის პროცესს მნიშვნელოვნად აჩქარებს.