
ექსპერტთა ნაზავი (MoE) მოდელები: დიდი ენობრივი მოდელების (LLMs) მასშტაბირების ახალი მიდგომა
ბოლო წლებში დიდი ენობრივი მოდელების (LLMs) განვითარება ძირითადად განპირობებული იყო მკვრივი მოდელების მასშტაბირებით. თუმცა, ამ მიდგომას პრაქტიკული ზღვარი აქვს. სტატია განმარტავს ექსპერტთა ნაზავი (MoE) მოდელების კონცეფციას, როგორც LLM-ების მასშტაბირების ახალ ეფექტურ გზას. MoE მოდელები იძლევა მაღალი წარმადობის მიღწევის საშუალებას გაცილებით ნაკლები აქტიური პარამეტრით, რაც აჩქარებს ინფერენციის პროცესს. განხილულია მათი უპირატესობები გამოთვლითი ეფექტურობის, პარალელიზაციის და ინდუსტრიაში მზარდი მიღების

Meta-ს Llama 4-ის მოდელები გამოვიდა: წინ გადადგმული ნაბიჯი მულტიმოდალურ ხელოვნურ ინტელექტში MoE არქიტექტურითა და გაფართოებული კონტექსტით
Meta-ს მიერ შემუშავებული Llama 4-ის მოდელები, Maverick და Scout, დღეს გამოვიდა, რაც ხელოვნური ინტელექტის სფეროში მნიშვნელოვან წინსვლას წარმოადგენს. ეს მძლავრი, მშობლიურად მულტიმოდალური მოდელები იყენებენ ახალ ავტორეგრესიულ „ექსპერტთა ნაზავის“ (MoE) არქიტექტურას, რაც მათ საშუალებას აძლევს დაამუშაონ როგორც ტექსტური, ისე გამოსახულების შეტანა. Hugging Face-ის ეკოსისტემასთან სრულყოფილი ინტეგრაციის უზრუნველყოფით, Llama 4-ის მოდელები გაწვრთნილია 200 ენაზე (40 ტრილიონამდე ტოკენზე) და გამოირჩევა კონტექსტი
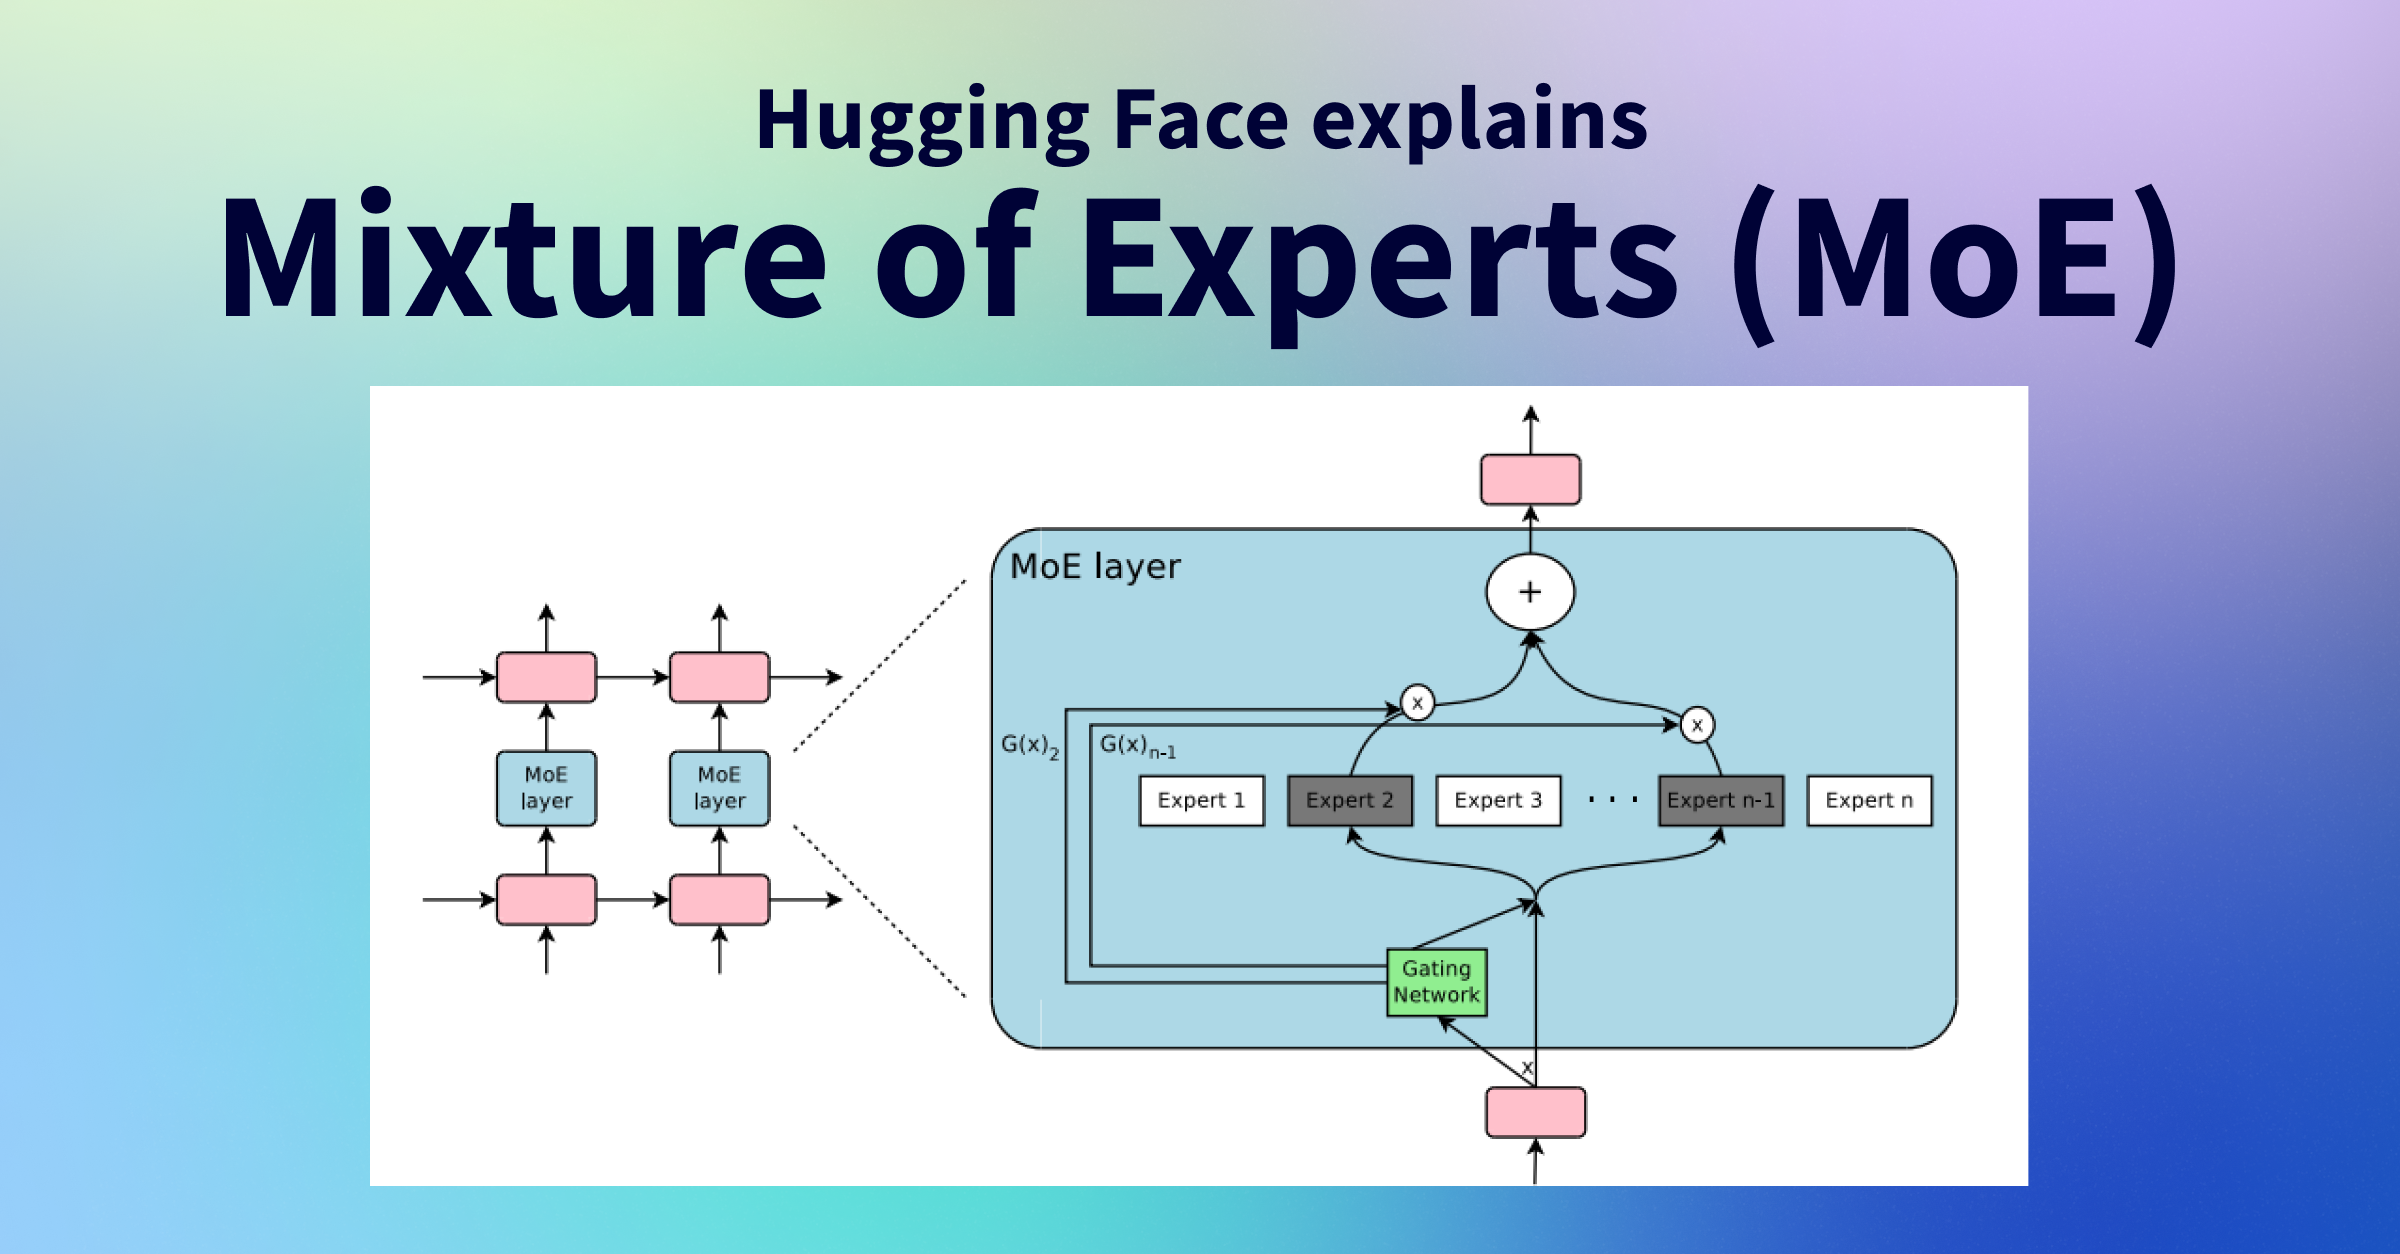
ექსპერტთა ნაზავი (MoEs): სიღრმისეული მიმოხილვა და იშვიათი მოდელების როლი
ექსპერტთა ნაზავი (MoEs) წარმოადგენს მნიშვნელოვან მიღწევას ხელოვნურ ინტელექტში, რომელიც საშუალებას აძლევს მოდელებს, მიაღწიონ უკეთეს ხარისხს გაცილებით ნაკლები გამოთვლითი რესურსებით. MoEs-ის მეშვეობით შესაძლებელია მოდელის ან მონაცემთა ნაკრების ზომის მნიშვნელოვნად გაზრდა მკვრივ მოდელებთან შედარებით, ერთი და იგივე ბიუჯეტის პირობებში, რაც უზრუნველყოფს უფრო სწრაფ წინასწარ წვრთნას. სტატია განმარტავს MoE-ის კონცეფციას ტრანსფორმერული მოდელების კონტექსტში, განიხილავს მის შემადგენელ ნაწილებს (კარიბჭის ქსელი
Mixtral-ის გამოშვება: ახალი ნახტომი ხელოვნურ ინტელექტში ექსპერტთა ნაზავი (Mixture of Experts) არქიტექტურით
სტატია წარმოგიდგენთ Mixtral-ს, ახალ დიდ ენობრივ მოდელს (LLM), რომელიც იყენებს ექსპერტთა ნაზავის (MoE) არქიტექტურას, აერთიანებს 8 „ექსპერტ“ მოდელს ერთში. ხაზგასმულია Mixtral-ის შთამბეჭდავი წარმადობა, რომელიც აჭარბებს სხვა ღია წვდომის მოდელებს და უტოლდება GPT-3.5-ს MT-Bench ბენჩმარკზე. განმარტებულია მისი რეალური პარამეტრების რაოდენობა (დაახლოებით 45B, არა 56B) და დეტალურად აღწერილია მისი გამოყენება ინფერენციისა და ფაინ-თუნინგისთვის, ასევე Hugging Face-ზე განთავსების შესაძლებლობები.