
Motorola Moto Watch (2026) მიმოხილვა: ღირს კი ის, რომ კონკურენტებს გაუწიოს მეტოქეობა?
ZDNET დეტალურად განმარტავს საკუთარი რეკომენდაციების მიღმა არსებულ მეთოდოლოგიას, რომელიც მოიცავს ტესტირებას, კვლევასა და შედარებით ანალიზს. სტატია აგრეთვე წარმოგიდგენთ Motorola Moto Watch (2026)-ის სიღრმისეულ მიმოხილვას, სადაც განხილულია მისი დიზაინი, გამძლეობა, ოპერაციული სისტემა და ბატარეის შთამბეჭდავი ხანგრძლივობა, ასევე დასმულია კითხვა მისი კონკურენტუნარიანობის შესახებ ბაზარზე.

Samsung Galaxy S26 Ultra-ს კონფიდენციალურობის ეკრანი – სმარტფონების ინოვაციის ახალი სტანდარტი?
Samsung-ის Galaxy S26 სერიის განახლებებს შორის, გამორჩეულია S26 Ultra-ში დანერგილი კონფიდენციალურობის ეკრანის (Privacy Display) ფუნქცია. ეს შესაძლოა, წლების ყველაზე მნიშვნელოვანი სმარტფონის ინოვაცია იყოს. ის საშუალებას გაძლევთ მკაფიოდ დაინახოთ ეკრანი პირდაპირი დათვალიერებისას, ხელს უშლის სხვებს მის წაკითხვაში და სურვილისამებრ ირთვება/ითიშება, რაც აგვარებს ტრადიციული ფილტრების ხარვეზებს გამოსახულების ხარისხის შენარჩუნებით.

ZDNET-ის რეკომენდაციები და 1Password-ის ფასის ზრდა: ღირს თუ არა ალტერნატივების ძიება?
ZDNET-ის რეკომენდაციები ემყარება მრავალსაათიან ტესტირებასა და კვლევას, რაც უზრუნველყოფს სარედაქციო დამოუკიდებლობას. ამავდროულად, 1Password-ი 2026 წლის 27 მარტიდან ინდივიდუალური და საოჯახო გეგმების ფასს მნიშვნელოვნად ზრდის (შესაბამისად 33% და 20%). ეს აჩენს კითხვას, ღირს თუ არა ალტერნატიული პაროლის მენეჯერების განხილვა, მიუხედავად 1Password-ის მდიდარი ფუნქციონალისა და მაღალი რეიტინგისა. სტატიაში მოცემულია ფასის ზრდის მიზეზები, პოტენციური ალტერნატივები და ჩაშენებული პაროლის მენეჯერების შეზღუდვები.

NTT DATA-ს სიახლე: სინთეზური მონაცემები იაპონური AI-ის „მონაცემთა კედელს“ ანგრევს
იაპონელი AI დეველოპერები კულტურულად სპეციფიკური სასწავლო მონაცემების ქრონიკულ დეფიციტს აწყდებიან, რაც ინოვაციას აფერხებს. NTT DATA-ს ახალი კვლევა, NVIDIA Nemotron-Personas-Japan-ის გამოყენებით, აჩვენებს, თუ როგორ შეუძლია სინთეზურ მონაცემებს ამ გამოწვევის დაძლევა. ექსპერიმენტმა იურიდიული კითხვა-პასუხის ამოცანებში მოდელის სიზუსტე 15.3%-დან 79.3%-მდე გაზარდა კონფიდენციალურობის დარღვევის გარეშე. ეს მიდგომა კომპანიებს საშუალებას აძლევს, ააგონ დომენ-სპეციფიკური AI ღია კოდის ინფრასტრუქტურით, შეამცირონ

NTT DATA-ს ინოვაცია: ხელოვნური მონაცემები იაპონური AI სისტემებისთვის მონაცემთა დეფიციტს ამარცხებს
NTT DATA-მ, NVIDIA-სთან პარტნიორობით, წარმოადგინა ინოვაციური მიდგომა ხელოვნური ინტელექტის სისტემებისთვის მონაცემთა დეფიციტის დასაძლევად, განსაკუთრებით იაპონური ენისა და კულტურის გაგებაში. Nemotron-Personas-Japan-ის გამოყენებით, კომპანიამ მინიმალური საკუთრების მონაცემებიდან შექმნა წარმოების მასშტაბის სასწავლო ნაკრები, რამაც იურიდიულ კითხვა-პასუხის ამოცანებზე მოდელის სიზუსტე 15.3%-დან 79.3%-მდე გაზარდა, კონფიდენციალურობის სრული დაცვით. ეს მიდგომა არა მხოლოდ აუმჯობესებს მოდელებს, არამედ ამცირებს ხა

Audible-მა ახალი ფუნქცია „წაიკითხე და მოუსმინე“ წარადგინა: მოუსმინეთ და წაიკითხეთ ერთდროულად
Audible-მა გამოუშვა „წაიკითხე და მოუსმინე“ ფუნქცია, რომელიც მომხმარებლებს აუდიოწიგნის მოსმენის პარალელურად ტექსტის კითხვას სთავაზობს. ეს სიახლე, რომელიც გაზრდის წაკითხული კონტენტის მოცულობას და გააუმჯობესებს გაგებას, განსაკუთრებით სასარგებლო იქნება სტუდენტებისთვის და მათთვის, ვისაც კითხვის პრობლემები აქვს. კომპანია ასევე ტესტავს ფიზიკური წიგნების გაყიდვას Amazon-ის მეშვეობით.

Nothing Apple-ის დაპირისპირებაში: მარტის ტექნოლოგიური ღონისძიებების ბრძოლა
კომპანია Nothing აქტიურ სარეკლამო კამპანიას აწარმოებს თავისი Phone 4a-ის წარსადგენად, ცდილობს რა Apple-ის ყურადღება მიიპყროს. Nothing-ის ღონისძიება 5 მარტსაა დაგეგმილი, Apple-ის ღონისძიებიდან ერთი დღის შემდეგ, რაც მიუთითებს განზრახულ კონკურენტულ სტრატეგიაზე. სტატია დეტალურად განიხილავს ორივე კომპანიის მოსალოდნელ ანონსებს, Nothing-ის საკამათო სარეკლამო ტაქტიკასა და იმ კითხვას, შეძლებს თუ არა Nothing-ი Apple-ის დაჩრდილვას.
ხელოვნური ინტელექტის ლაბორატორიებიდან განგაშის სიგნალები: ინსაიდერები AI-ის საფრთხეებზე საუბრობენ
ტექნოლოგიურ სამყაროში ხელოვნური ინტელექტის შესახებ ყველაზე მნიშვნელოვანი დისკუსიები კონფერენციების დარბაზებს გარეთ მიმდინარეობს, სადაც AI ლაბორატორიების ინსაიდერები განგაშს ტეხენ. ისინი აფრთხილებენ მოდელების სწრაფ განვითარებას, რომლებსაც სულ უფრო ნაკლები ადამიანური ჩარევა სჭირდებათ, და სვამენ კითხვას – უნდა მოვუსმინოთ თუ არა მათ? ეს გაფრთხილებები მოიცავს თანამდებობიდან გადადგომებსაც უსაფრთხოების პროტოკოლების შესუსტების გამო და მიუთითებს პოტენციურ ფართო სტრუქტურულ გავლენაზე საზოგადოებაზე.
„Reformer“ მოდელი: ტრანსფორმერის ახალი ერა გრძელი თანმიმდევრობების დამუშავებაში
ეს სტატია განიხილავს „Reformer“ მოდელს, რომელიც ქიტაევის, კაიზერის და სხვების (2020) მიერ იქნა წარმოდგენილი, როგორც დღესდღეობით ერთ-ერთი ყველაზე მეხსიერების ეფექტური „ტრანსფორმერის“ მოდელი გრძელი თანმიმდევრობის მოდელირებისთვის. აღწერილია მისი უპირატესობები სტანდარტულ მოდელებთან შედარებით NLP ამოცანებში, როგორიცაა შეჯამება და კითხვა-პასუხი, და განმარტებულია, თუ როგორ შეუძლია მას ერთდროულად ნახევარ მილიონამდე ტოკენის დამუშავება. პოსტი დეტალურად განიხილავს „Reformer“-ის ოთხ ძირითად მახასიათებელს, რ
Reformer მოდელი: მეხსიერება-ეფექტური ტრანსფორმერული არქიტექტურა გრძელი მიმდევრობების მოდელირებისთვის
კიტაევის, კაიზერისა და სხვების (2020) მიერ შემოთავაზებული Reformer მოდელი წარმოადგენს ერთ-ერთ ყველაზე მეხსიერება-ეფექტურ ტრანსფორმერულ არქიტექტურას გრძელი მიმდევრობების მოდელირებისთვის. NLP ამოცანების (მაგ. რეფერირება, კითხვა-პასუხის სისტემები) მზარდი მოთხოვნების დასაკმაყოფილებლად, Reformer-ს შეუძლია ნახევარ მილიონამდე ტოკენის დამუშავება, მაშინ როცა სტანდარტული BERT მოდელები 512 ტოკენით შემოიფარგლებიან. მისი არქიტექტურის თითოეული ნაწილი გადაკეთებულია მინიმალური მეხსიერების მოთხოვნილების ოპტიმიზა

ღია კოდის ვიდეო გენერაციის მოდელების აღზევება: დგას თუ არა AI „Stable Diffusion-ის მომენტის“ ზღურბლზე?
ბოლო დროს შეინიშნება ღია კოდის ვიდეოს გენერაციის მოდელების, მათ შორის CogVideoX, Mochi-1, Hunyuan და LTX Video-ს სწრაფი ზრდა, რაც ბადებს კითხვას, დგას თუ არა ვიდეო საზოგადოება ხელოვნური ინტელექტის „Stable Diffusion-ის მომენტის“ ზღურბლზე. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, ხაზს უსვამს ისეთ შეზღუდვებს, როგორიცაა მოძრაობის ხარისხი, დროითი თანმიმდევრულობა და მეხსიერების მაღალი მოთხოვნები. Diffusers-ის გუნდი აქტიურად მუშაობს ამ გამოწვევების გადასაჭრელად სხვადასხ
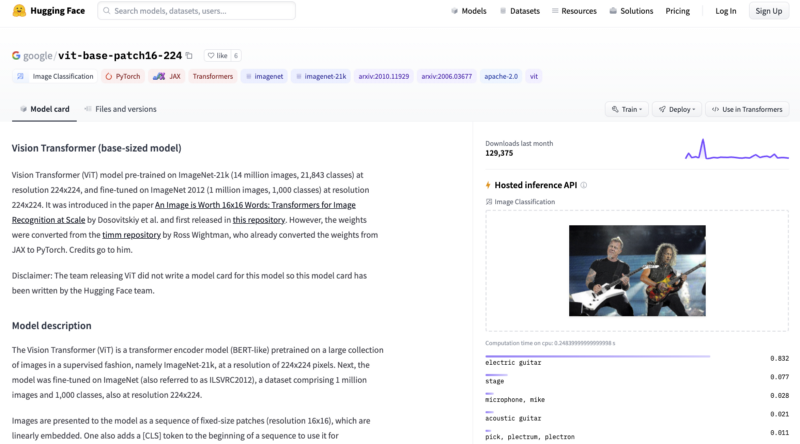
მანქანური სწავლა ყველგან: როგორ ვაქციოთ AI საწარმოო რეალობად MLOps-ისა და ტრანსფორმერების დახმარებით
მანქანური სწავლისა (ML) და ხელოვნური ინტელექტის (AI) ფართო დანერგვის ფონზე, ტექსტი აყენებს კითხვას ინდუსტრიის მზაობის შესახებ ამ მასშტაბური განთავსებისთვის. ავტორი ხაზს უსვამს MLOps-ის მნიშვნელობას, რომელიც აერთიანებს პროგრამული ინჟინერიის საუკეთესო პრაქტიკებს (ვერსიონირება, ხელახალი გამოყენება, ტესტირება) მანქანური სწავლის სამუშაო პროცესებთან. იგი ამტკიცებს, რომ საჭიროა მეტი ML-ში გათვითცნობიერებული პროგრამული უზრუნველყოფის და DevOps ინჟინერი, ვიდრე უბრალოდ მონაცემთა მეცნიერი, რათა მოდელები წარ
რატომ არღვევს Hugging Face-ის Transformers ბიბლიოთეკა DRY პრინციპს?
პროგრამული უზრუნველყოფის განვითარებაში ცნობილი „ნუ გაიმეორებ საკუთარ თავს“ (DRY) პრინციპის მიუხედავად, Hugging Face-ის Transformers ბიბლიოთეკა შეგნებულად უარს ამბობს მის გამოყენებაზე და იყენებს „ერთი მოდელის ფაილის პოლიტიკას“. ეს გადაწყვეტილება მიღებულია გარე კონტრიბუციების წახალისების, კოდის წაკითხვადობის გაუმჯობესების და მანქანური სწავლების სფეროს სწრაფი ევოლუციის გამო, რაც სტანდარტული ლოგიკური შაბლონების განსაზღვრას ართულებს.

წარმოგიდგენთ nanoVLM-ს: მარტივი გზა ვიზუალური ენის მოდელების შესაქმნელად
nanoVLM არის ხელსაწყოების ნაკრები, რომელიც შთაგონებულია Andrej Karpathy-ის nanoGPT-ით, მაგრამ შექმნილია ვიზუალური სფეროსთვის. ის საშუალებას გაძლევთ შექმნათ და გაავარჯიშოთ მოდელები, რომლებსაც შეუძლიათ გამოსახულებებისა და ტექსტის გაგება, შემდეგ კი ამის საფუძველზე ტექსტის გენერირება. პროექტი გამოირჩევა სიმარტივითა და კოდის წაკითხვადობით, რაც მას იდეალურს ხდის დამწყებთათვის. nanoVLM ძირითადად ფოკუსირებულია ვიზუალურ კითხვა-პასუხზე (Visual Question Answering) და აგებულია Google-ის SigLIP-ისა და Llama
NPHardEval: ახალი დინამიური ჩარჩო დიდი ენობრივი მოდელების მსჯელობის უნარის შესაფასებლად
NPHardEval წარმოგიდგენთ ინოვაციურ, დინამიურ და სირთულეზე დაფუძნებულ ჩარჩოს დიდი ენობრივი მოდელების (LLMs) მსჯელობის უნარების მკაცრი შეფასებისთვის. ის მოიცავს 900 ალგორითმულ კითხვას NP-რთული სირთულის კლასიდან და ქვედა დონეებიდან, რომლებიც ყოველთვიურად განახლდება მოდელების ზედმეტი მორგების თავიდან ასაცილებლად. NPHardEval გამოირჩევა გამოთვლითი სირთულის კლასების გამოყენებით, რაც LLM-ის აზროვნების უნარების რაოდენობრივ და მტკიცე შეფასებას უზრუნველყოფს, რეალურ სამყაროში არსებული გამოწვევების ასახვით.
ახალი ლიდერთა დაფა ებრაული ენის LLM-ებისთვის: ნიუანსების შეფასება
ებრაული ენის მორფოლოგიური სირთულის გამო, არსებულ დიდ ენობრივ მოდელებს (LLM) უჭირთ მისი ნიუანსების ზუსტად დამუშავება. ამ ხარვეზის შესავსებად, შეიქმნა ახალი ლიდერთა დაფა, რომელიც სპეციალიზებულ შეფასების ეტალონებს გვთავაზობს ებრაული ენის LLM-ებისთვის. პლატფორმა მოიცავს ოთხ ძირითად მონაცემთა ნაკრებს: კითხვა-პასუხი, განწყობის სიზუსტე, ვინოგრადის სქემის გამოწვევა და თარგმანი. ინიციატივა მიზნად ისახავს მკვლევრებისა და დეველოპერების გაერთიანებას, ღია საზოგადოების წახალისებას და ისრაელის ტექნოლოგიური საზ
Florence-2-ის დახვეწა DocVQA-სთვის: როგორ გავაუმჯობესოთ ვიზუალური კითხვა-პასუხის შესაძლებლობები
ეს სტატია განიხილავს Florence-2 მოდელის დახვეწის პროცესს DocVQA (დოკუმენტური ვიზუალური კითხვა-პასუხი) ამოცანებისთვის. მიუხედავად იმისა, რომ Florence-2 მხარს უჭერს მრავალ კომპიუტერული ხედვის ამოცანას, VQA ფუნქციონალი არ არის ჩაშენებული გამოშვებულ მოდელებში. სტატიაში დეტალურად არის აღწერილი Florence-2-ის არქიტექტურა, უნიკალური FLD-5B მონაცემთა ნაკრების შექმნის პროცესი, რომელიც მოდელის სიძლიერის საფუძველია, და სხვადასხვა დახვეწის მეთოდის ექსპერიმენტები. ლევენშტეინის მსგავსების მეტრიკის გამოყენებით,
ფლორენს-2 მოდელის დახვეწა DocVQA ამოცანისთვის: დეტალური მიმოხილვა
სტატიაში განხილულია Florence-2 ხელოვნური ინტელექტის მოდელის დახვეწის პროცესი დოკუმენტების ვიზუალური კითხვა-პასუხის (DocVQA) კონკრეტული ამოცანისთვის. მიუხედავად იმისა, რომ Florence-2 მრავალ ფუნქციას უშუალოდ ასრულებს, ვიზუალური კითხვა-პასუხის (VQA) შესაძლებლობა გამოცემულ მოდელებში არ შედის. ტექსტში აღწერილია მოდელის არქიტექტურა, მისი სიძლიერე უზარმაზარი FLD-5B მონაცემთა ნაკრებიდან, მონაცემთა ნაკრების ავტომატიზებული შექმნის პროცესი და ექსპერიმენტული შედეგები, რომლებიც აჩვენებს მუშაობის მნიშვნელოვან

ხელოვნური ინტელექტი: მოლოდინი და რეალობა – რატომ არ ამართლებს AI ინვესტიციები ჯერჯერობით?
PwC-ის გლობალურმა გამოკითხვამ ცხადყო, რომ კომპანიების უმეტესობა ჯერ კიდევ ვერ ხედავს ხელოვნური ინტელექტის (AI) ინვესტიციებისგან მნიშვნელოვან ფინანსურ სარგებელს. გაიგეთ, რა უშლის ხელს სრულმასშტაბიან დანერგვას და რა ნაბიჯებია საჭირო ხელშესახები შედეგების მისაღებად.

კორპორაციული ხელოვნური ინტელექტი: ჩატბოტებიდან დამოუკიდებელ ასისტენტებამდე – ვის ეკუთვნის მომავლის AI ფენა?
კორპორაციული ხელოვნური ინტელექტი [Enterprise AI] სწრაფად ვითარდება, მარტივი ჩატბოტებიდან ორგანიზაციების მასშტაბით სამუშაოს შემსრულებელ სისტემებამდე. ამ ტრანსფორმაციის ფონზე, მთავარი კითხვა ისმის: ვის ეკუთვნის ის AI ფენა [AI layer], რომელიც ამ ყველაფერს მართავს და როგორ ემზადება კომპანია Glean ამ გამოწვევისთვის?