
Google-მა SigLIP 2 გამოუშვა: მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ახალი, გაუმჯობესებული თაობა
Google-მა წარმოადგინა SigLIP 2, მრავალენოვანი ვიზუალურ-ლინგვისტური ენკოდერების ოჯახის ახალი თაობა. გაფართოებული სწავლების მიზნების წყალობით, რომელიც აუმჯობესებს სემანტიკურ გაგებას, ლოკალიზაციასა და მკვრივ მახასიათებლებს, SigLIP 2 მოდელები მნიშვნელოვნად აღემატება წინამორბედ SigLIP-ს ისეთ ძირითად შესაძლებლობებში, როგორიცაა ნულოვანი კადრის კლასიფიკაცია და გამოსახულება-ტექსტის მოძიება. სიახლეს წარმოადგენს დინამიური რეზოლუციის (naflex) ვარიანტი, რაც მას უფრო მრავალმხრივს ხდის.
Rocket Money-ის რევოლუცია ტრანზაქციების კლასიფიკაციაში: AI-ის დანერგვა და Hugging Face-ის სტრატეგიული არჩევანი
პირადი ფინანსების აპლიკაცია Rocket Money-მ, მომხმარებელთა მზარდი ბაზისა და გამოწერის ეკონომიკის ბუმის ფონზე, ტრანზაქციების კლასიფიკაციისა და გამყიდველების იდენტიფიცირების სისტემა განავითარა. კომპანია რეგულარულ გამოსახულებებზე (regex) დაფუძნებული სისტემიდან მანქანური სწავლების (ML) უფრო დახვეწილ მიდგომაზე (BERT მოდელები) გადავიდა. ტრადიციულ ML გადაწყვეტებთან დაკავშირებული სირთულეების და შიდა სისტემის აშენების შემდეგ, Rocket Money-მ წარმატებით მოახდინა BERT მოდელების ინტეგრაცია. მოდელების განსათავ
AutoNLP და Prodigy: ხელოვნური ინტელექტის მოდელების სწრაფი და ეფექტური შექმნა
სტატია მიმოიხილავს Hugging Face-ის AutoNLP-სა და Explosion-ის Prodigy-ს, ორ მძლავრ ინსტრუმენტს ღრმა სწავლის მოდელების შესაქმნელად და მონაცემთა ანოტაციისთვის. აღწერილია, თუ როგორ ამარტივებს AutoNLP უახლესი ტრანსფორმატორის მოდელების წვრთნას სხვადასხვა ბუნებრივი ენის დამუშავების ამოცანებისთვის (კლასიფიკაცია, სახელობითი ერთეულების ამოცნობა) მინიმალური კოდირებით. Prodigy წარმოდგენილია როგორც მოქნილი, რეალურ დროში ანოტაციის ინსტრუმენტი, რომელიც მხარს უჭერს ბუნებრივი ენის დამუშავების, კომპიუტერული მხედ

Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.
Hugging Face AutoTrain-ი კომპიუტერული ხედვისთვის: ნულოვანი კონფიგურაციით მაღალეფექტური მოდელები
Hugging Face-ის AutoTrain პლატფორმა ახლა უკვე კომპიუტერული ხედვის ამოცანებსაც უჭერს მხარს, მათ შორის გამოსახულების კლასიფიკაციას. ეს ინსტრუმენტი მომხმარებლებს საშუალებას აძლევს, გაწვრთნან მაღალეფექტური AI მოდელები ნულოვანი კონფიგურაციით, მონაცემების ატვირთვით და სასურველი ამოცანის არჩევით, რაც პროცესს ხელმისაწვდომს ხდის ტექნიკური გამოცდილების გარეშეც კი.
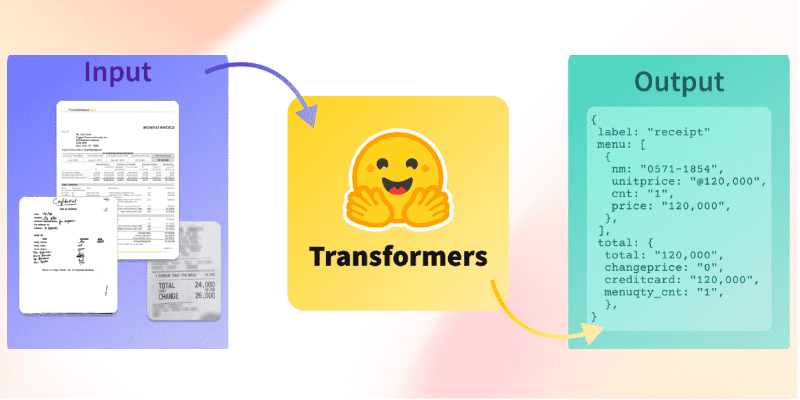
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ