
Samsung HW-Q990F Sonos Arc Ultra-ს წინააღმდეგ: რომელი პრემიუმ სახლის კინოთეატრის ხმის სისტემაა უკეთესი?
ZDNET-ის სარედაქციო გუნდი წარმოგიდგენთ Samsung HW-Q990F-ისა და Sonos Arc Ultra-ს დეტალურ შედარებას, ორი პრემიუმ კლასის სახლის კინოთეატრის აუდიო სისტემის, რომლებიც ხარისხითა და ფუნქციებით გამოირჩევიან. სტატია განმარტავს ZDNET-ის რეკომენდაციების მიღმა არსებულ მეთოდოლოგიას, რომელიც ეფუძნება მკაცრ ტესტირებასა და მიუკერძოებელ შეფასებას. იგი აანალიზებს თითოეული სისტემის თავისებურებებს, მათ შორის ხმის კონფიგურაციას, გაფართოებადობას, თავსებადობას Samsung Q-Symphony-სთან და აუდიო ფორმატების მხარდაჭერას,

Hyprland: ლინუქსის დესკტოპის თანამედროვე გამოცდილება და დისტრიბუციები, რომლებიც მას ხელმისაწვდომს ხდის
Hyprland არის შედარებით ახალი, კლავიატურაზე ორიენტირებული დინამიური ფილების Wayland კომპოზიტორი, რომელიც აერთიანებს თანამედროვე და ტრადიციული Linux-ის მიმზიდველობას. მიუხედავად იმისა, რომ მისი ინსტალაცია და კონფიგურაცია შეიძლება რთული იყოს, რამდენიმე Linux დისტრიბუცია, როგორიცაა StratOS, Garuda Hyprland, CachyOS Hyprland და Omarchy, გთავაზობთ წინასწარ კონფიგურირებულ, მომხმარებლისთვის მოსახერხებელ გამოცდილებას, რაც ამ მძლავრ ფანჯრების მენეჯერს ფართო აუდიტორიისთვის, მათ შორის გეიმერებისა და სისტემ
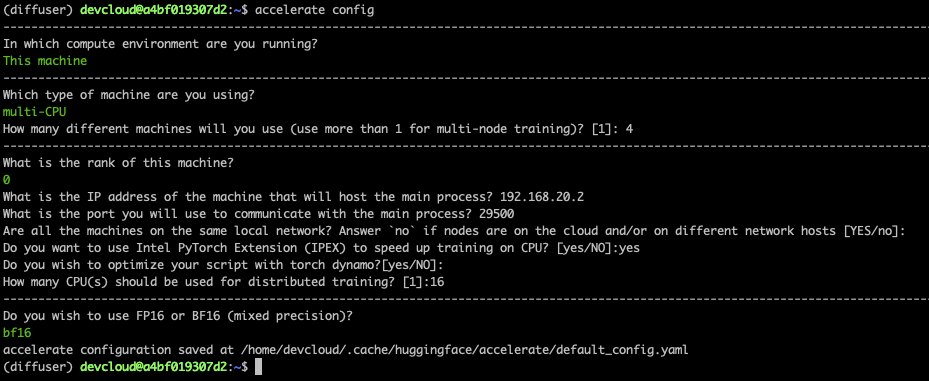
Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ
მოდელების განთავსება ინფერენსის ენდპოინტებზე ქასთომ ჰენდლერების გამოყენებით: MusicGen-ის მაგალითი
ეს სტატია განმარტავს, თუ როგორ ხდება მოდელების, მათ შორის `transformers`-ის კონვეიერით პირდაპირ არმხარდაჭერილი ან არატრანსფორმერული მოდელების განთავსება Inference Endpoints-ის გამოყენებით. პროცესი მოიცავს მორგებული დასკვნის ფუნქციების, იგივე ქასთომ ჰენდლერების შექმნას, რათა შესაძლებელი გახდეს მოქნილი განთავსება. MusicGen-ის მაგალითზე დეტალურად არის აღწერილი `handler.py` და `requirements.txt` ფაილების შექმნა და ენდპოინტის კონფიგურაცია.
ახალი ბენჩმარკი: Llama 2-ის განლაგების ოპტიმალური სტრატეგიები Amazon SageMaker-ზე
დიდი ენობრივი მოდელების (დემ) განლაგება გამოწვევებთან არის დაკავშირებული მათი გამოთვლითი მოთხოვნებისა და დაყოვნების საჭიროებების გამო. ამ პრობლემის გადასაჭრელად, შემუშავდა ყოვლისმომცველი ბენჩმარკი, რომელმაც შეაფასა Llama 2-ის 60-ზე მეტი განლაგების კონფიგურაცია Amazon SageMaker-ზე Hugging Face-ის დემ დასკვნის კონტეინერის გამოყენებით. კვლევამ მიზნად დაისახა ოპტიმალური სტრატეგიების მოძიება კომპანიებისთვის, რათა დააბალანსონ ხარჯები, გამტარუნარიანობა და დაყოვნება Llama 2-ის სხვადასხვა ზომისა და Amazo
Llama 2-ის განლაგების ბენჩმარკინგი Amazon SageMaker-ზე: ოპტიმალური სტრატეგიები წარმადობისა და ხარჯთეფექტურობისთვის
დიდი ენობრივი მოდელების (LLM) განლაგება, როგორიცაა Llama 2, კომპლექსური გამოწვევაა. Amazon Web Services-მა ჩაატარა მასშტაბური ბენჩმარკინგი, შეაფასა Llama 2-ის 60-ზე მეტი კონფიგურაცია Amazon SageMaker-ზე, Hugging Face LLM დასკვნის კონტეინერის გამოყენებით. კვლევამ გააანალიზა შეყოვნება და გამტარობა Llama 2-ის სხვადასხვა ზომისა და EC2 ინსტანციების მიხედვით, რათა შეემუშავებინა ოპტიმალური რეკომენდაციები ხარჯთეფექტურობის, მაქსიმალური გამტარობისა და მინიმალური შეყოვნებისთვის. ძირითადი აღმოჩენები მოიცავს

მობილური AI ჩატბოტი: LLM-ების ლოკალურად გაშვება React Native-ით
ეს დეტალური გზამკვლევი აღწერს, თუ როგორ შევქმნათ React Native მობილური აპლიკაცია, რომელიც მომხმარებლებს საშუალებას აძლევს, პირადულ გარემოში, ლოკალურად ესაუბრონ ხელოვნური ინტელექტის დიდ ენობრივ მოდელებს (LLM). სტატია მოიცავს მოდელების შერჩევის კრიტერიუმებს, განვითარების გარემოს კონფიგურაციასა და აპლიკაციის საწყის ეტაპებს, `llama.rn`-ის ეფექტური გამოყენებით GGUF ფაილების ჩასატვირთად Hugging Face Hub-იდან.
როგორ განათავსოთ AI Comic Factory თქვენს პირად სივრცეში და თავიდან აიცილოთ ლოდინი
AI Comic Factory, აპლიკაცია, რომელმაც ათასობით მომხმარებელი მოიზიდა საკუთარი AI კომიქსების შესაქმნელად, წარმოუდგენლად პოპულარული გახდა. ეს გაკვეთილი გიჩვენებთ, თუ როგორ უნდა მოახდინოთ მისი კლონირება (fork) და კონფიგურაცია, რათა თავიდან აიცილოთ ხანგრძლივი ლოდინის დრო და განათავსოთ აპლიკაცია თქვენს პირად Hugging Face სივრცეში Inference API-ის გამოყენებით. მართალია, არ არის საჭირო ძლიერი ტექნიკური უნარები, მაგრამ რეკომენდებულია API-ების, გარემოს ცვლადების (environment variables) და LLM-ებისა და Sta

მეტყველების ამოცნობის (ASR) და დიარიზაციის პაიპლაინების დაყენება Hugging Face Inference Endpoints-ზე სპეკულაციური დეკოდირებით
ეს სტატია განმარტავს, თუ როგორ ხდება მეტყველების ავტომატური ამოცნობის (ASR), დიარიზაციისა და სპეკულაციური დეკოდირების მოდულარული პაიპლაინების კონფიგურაცია Hugging Face Inference Endpoints-ის გამოყენებით. ის დეტალურად აღწერს Pyannote მოდელის ინტეგრაციას დიარიზაციისთვის, Flash Attention 2-ის გამოყენებას და ინფერენსის დაჩქარების ტექნიკებს, ასევე კონფიგურაციის მოქნილობას და წარმადობის გაუმჯობესებას სხვადასხვა აუდიო სიგრძისთვის.
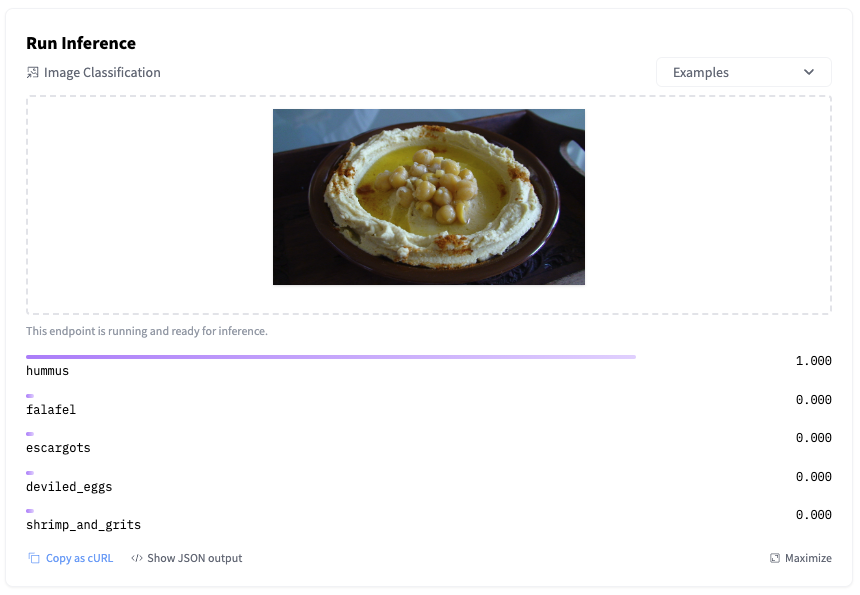
Hugging Face Inference Endpoints: ML მოდელების პროდუქციაში განთავსების გამარტივება
ეს სტატია განმარტავს, თუ როგორ ამარტივებს Hugging Face Inference Endpoints მანქანური სწავლების (ML) მოდელების პროდუქციაში განთავსების რთულ პროცესს. სერვისი საშუალებას გაძლევთ, რამდენიმე დაწკაპუნებით განათავსოთ მოდელები უშუალოდ Hugging Face Hub-იდან მართულ ინფრასტრუქტურაზე, რაც უზრუნველყოფს სიმარტივეს, უსაფრთხოებას და მასშტაბურობას. სტატია დეტალურად აღწერს, თუ როგორ ხდება დაცული და პირადი Endpoint-ების კონფიგურაცია AWS-ზე.