Hugging Face Infinity: ტრანსფორმერული მოდელების ოპტიმალური განთავსება Intel Xeon CPU-ებზე
Hugging Face Infinity არის კონტეინერიზებული გადაწყვეტა, რომელიც საშუალებას აძლევს კომპანიებს ეფექტურად განათავსონ ტრანსფორმერული მოდელები წარმოებაში დაბალი ლატენტურობითა და მაღალი გამტარუნარიანობით. ეს ბლოგ პოსტი წარმოადგენს დეტალურ წარმადობის შედეგებს Infinity-ის უახლესი თაობის Intel Xeon CPU-ებზე გაშვებისას (კერძოდ, Ice Lake-ზე დაფუძნებული EC2 C6i ინსტანსებზე), რაც უზრუნველყოფს ოპტიმალურ ღირებულებას, ეფექტურობასა და ლატენტურობას თქვენი Transformer-ის განთავსებისთვის.

Optimum-NVIDIA: LLM-ის ინფერენსის რევოლუციური აჩქარება NVIDIA პლატფორმაზე
Hugging Face-ის Optimum-NVIDIA ბიბლიოთეკა მნიშვნელოვნად აჩქარებს დიდი ენობრივი მოდელების (LLM) ინფერენსს NVIDIA პლატფორმაზე, კოდის მხოლოდ ერთი ხაზის შეცვლით 28-ჯერ უფრო სწრაფ მუშაობას და 1,200 ტოკენს/წამში სიჩქარეს უზრუნველყოფს. ის პირველი Hugging Face ბიბლიოთეკაა, რომელიც სარგებლობს ახალი float8 (FP8) ფორმატით, რაც კიდევ უფრო აუმჯობესებს გამტარუნარიანობას და ამცირებს პირველი ტოკენის ლატენტურობას, რაც საშუალებას იძლევა, უფრო დიდი მოდელები ერთ GPU-ზე გაეშვას სიზუსტის დაკარგვის გარეშე. აღნიშნული ტ
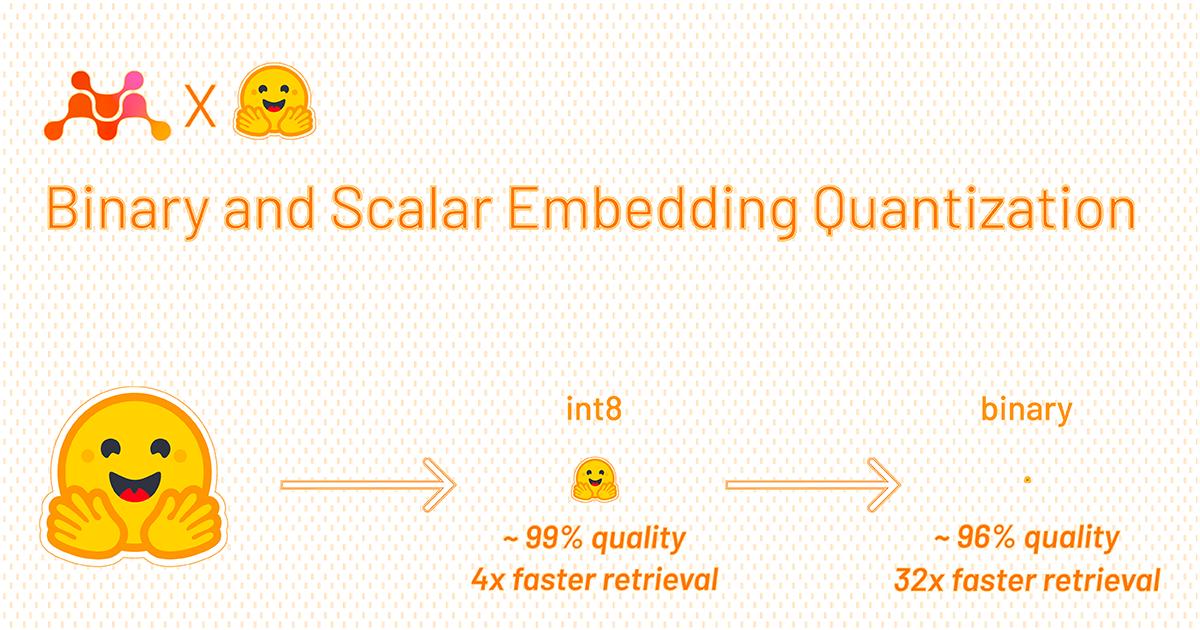
კვანტიზაცია: ეფექტური გადაწყვეტა ემბედინგების მასშტაბირების პრობლემისთვის
ემბედინგები ბუნებრივი ენის დამუშავების (NLP) გადამწყვეტი ინსტრუმენტია, თუმცა მათი მასშტაბირება წარმოების მიზნებისთვის ხშირად იწვევს მაღალ ხარჯებსა და ლატენტურობას. სტატია განიხილავს ამ გამოწვევებს, არსებულ მიდგომებს (როგორიცაა განზომილების შემცირება და Matryoshka Representation Learning) და წარმოგიდგენთ კვანტიზაციას, კერძოდ ბინარულ კვანტიზაციას, როგორც ინოვაციურ გადაწყვეტას. ბინარული კვანტიზაცია float32 მნიშვნელობებს 1-ბიტიან მნიშვნელობებად აქცევს, რაც მეხსიერებასა და შენახვის ადგილს 32-ჯერ ამცი

BLOOM მოდელის ოპტიმიზაცია: 5-ჯერ შემცირებული ლატენტურობა და 50-ჯერ გაზრდილი გამტარუნარიანობა
ამ სტატიაში აღწერილია BLOOM მოდელის ინფერენსის სიჩქარის გაუმჯობესების რთული, მაგრამ წარმატებული პროცესი, რამაც გამოიწვია ლატენტურობის 5-ჯერ შემცირება და გამტარუნარიანობის 50-ჯერ გაზრდა. განხილულია მოდელის „ტრანსფორმერების“ ბიბლიოთეკასთან ადაპტაციის, ტესტირებისა და განაწილებული ინფერენსისთვის მომზადების ეტაპები, გამოწვევები და გადაწყვეტილებები.

LLM ინფერენსის ოპტიმიზაცია: Hugging Face TGI ბენჩმარკინგი
ეს სტატია განმარტავს, თუ როგორ ხდება დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაცია Hugging Face-ის მაღალეფექტური ტექსტის გენერაციის ინფერენსის (TGI) სერვერის გამოყენებით. დეტალურად განიხილება LLM-ების თანდაყოლილი არაეფექტურობა, ინდუსტრიის მიერ მიღწეული გაუმჯობესებები მუშაობის ოპტიმიზაციაში, ასევე ბენჩმარკინგის მნიშვნელობა სხვადასხვა გამოყენების შემთხვევებისთვის, როგორიცაა RAG და ჩატი. სახელმძღვანელო განმარტავს ძირითად მეტრიკებს, როგორიცაა ლატენტურობა და გამტარუნარიანობა, და გვიჩვენებს, თუ