
Figma OpenAI-ის Codex-ს დიზაინისა და კოდის ინტეგრაციისთვის აერთიანებს
Figma-მ OpenAI-ის ხელოვნური ინტელექტის კოდირების ინსტრუმენტი, Codex, გააერთიანა, რაც მომხმარებლებს საშუალებას აძლევს, შექმნან და შეასწორონ დიზაინები უშუალოდ თავიანთი კოდირების გარემოდან. ეს ინტეგრაცია, რომელიც Anthropic-თან მსგავს პარტნიორობას მოჰყვა, მიზნად ისახავს დიზაინსა და ინჟინერიას შორის ხიდის გადებას, რაც პლატფორმებს შორის შეუფერხებელ გადაადგილებას უზრუნველყოფს.

OpenAI Enterprise AI-ის ადაპტაციაზე, Frontier-ის გეგმებსა და ინდოეთის ბაზარზე
OpenAI-მ Frontier პლატფორმა გამოუშვა საწარმოებისთვის, თუმცა COO ბრედ ლაითქაპი აღნიშნავს AI-ის ფართომასშტაბიანი ადაპტაციის ნაკლებობას. კომპანია წარმატებას ბიზნეს შედეგებით გაზომავს და არასალიცენზიო ადგილებით. OpenAI აქტიურად თანამშრომლობს საკონსულტაციო ფირმებთან და ფართოვდება ინდოეთის ბაზარზე, სადაც ChatGPT-ის 100 მილიონზე მეტი ყოველკვირეული მომხმარებელია, ხოლო ხმოვანი მოდალობა მნიშვნელოვან როლს ასრულებს. მიუხედავად გაფართოების გეგმებისა, არსებობს შიში AI-ის სამუშაო ადგილებზე ზემოქმედების შესახებ
ხელოვნური ინტელექტის დეტექციის ბაზრის აღმავლობა და გამოწვევები 2025 წელს
გენერაციული ხელოვნური ინტელექტის სწრაფი განვითარების ფონზე, მნიშვნელოვნად იზრდება ადამიანის მიერ შექმნილი კონტენტის იდენტიფიცირების საჭიროება. ეს სტატია მიმოიხილავს ხელოვნური ინტელექტის დეტექციის ინსტრუმენტების ევოლუციას, ბაზრის მიმდინარე მდგომარეობას 2025 წელს, მათ ზრდას, დანერგვას, სიზუსტეს, ფასებსა და გამოყენებას. განხილულია ინდუსტრიის გამოწვევები, ინსტიტუციონალიზაციის პროცესი და სამომავლო ტენდენციები, რომლებიც მიმართულია უფრო ინტეგრირებული და მრავალმოდალური გადაწყვეტილებებისკენ, სადაც საიმედ

ფალკონ3: ხელოვნური ინტელექტის მოდელების ახალი თაობა გაუმჯობესებული შესაძლებლობებით
„ფალკონ3“ წარმოადგენს ხელოვნური ინტელექტის მოდელების ახალ ოჯახს, რომელიც წინა ვერსიების ბუნებრივ ევოლუციას ასახავს. ახალი იტერაცია ფოკუსირებულია მეცნიერების, მათემატიკისა და კოდის შესაძლებლობების გაფართოებაზე, აჩვენებს მაღალ წარმადობას საერთო საორიენტაციო ტესტებზე და მოიცავს ხუთ ძირითად მოდელს ინოვაციური არქიტექტურით. მოდელები გამოქვეყნებულია Falcon LLM ლიცენზიით, რაც ხელს უწყობს ხელოვნური ინტელექტის ხელმისაწვდომობას და თანამშრომლობას, ხოლო 2025 წლის იანვარში მოსალოდნელია მულტიმოდალური შესაძლებლ

SmolVLM-256M და SmolVLM-500M: მსოფლიოს ყველაზე პატარა ხედვის ენის მოდელები
კომპანიამ SmolVLM ოჯახის ორი ახალი წევრი, SmolVLM-256M და SmolVLM-500M, წარადგინა. 256 მილიონი პარამეტრის მქონე მოდელი მსოფლიოში ყველაზე პატარა ხედვის ენის მოდელია. ახალი მოდელები ეფუძნება SmolVLM 2B-დან მიღებულ გამოცდილებას, აქცენტი კეთდება ეფექტურობაზე, მონაცემთა ნარევებზე და დიზაინის ახალ კომპრომისებზე. ისინი ინარჩუნებენ მძლავრ მულტიმოდალურ მუშაობას გაცილებით მცირე ზომებში და მარტივად ინტეგრირდება არსებულ სისტემებში. ეს მოდელები განკუთვნილია როგორც შეზღუდული მოწყობილობებისთვის, ასევე დიდი მოც
IDEFICS: ღია მულტიმოდალური AI მოდელი გამჭვირვალე კვლევისთვის
IDEFICS, 80 მილიარდი პარამეტრის მულტიმოდალური ხელოვნური ინტელექტის (AI) მოდელი, რომელიც Flamingo-ს ღია წყაროს რეპროდუქციას წარმოადგენს, უკვე ხელმისაწვდომია. მისი შექმნისას დიდი აქცენტი გაკეთდა გამჭვირვალობაზე, გამოყენებულ იქნა მხოლოდ საჯაროდ ხელმისაწვდომი მონაცემები და შეფასდა პოტენციური მიკერძოებები. მოდელი მიზნად ისახავს მულტიმოდალური AI სისტემების სფეროში უფრო ღია კვლევების წახალისებას და მისი დემო ვერსიები Hugging Face Hub-ზეა განთავსებული.
მოდელების კვანტიზაცია: Bitsandbytes-ისა და GPTQ-ის შედარებითი ანალიზი
სტატია განიხილავს ხელოვნური ინტელექტის მოდელების კვანტიზაციის ორ ძირითად მეთოდს, bitsandbytes-სა და auto-gptq-ს, რომლებიც მშობლიურად არის მხარდაჭერილი Transformers ბიბლიოთეკაში. წარმოდგენილია თითოეული მეთოდის უპირატესობები და ნაკლოვანებები, მათ შორის გამოყენების სიმარტივე, კროს-მოდალური თავსებადობა, ადაპტერების ინტეგრაცია, ტექსტის გენერირების სიჩქარე, სერიალიზაციის შესაძლებლობები და ტექნიკური შეზღუდვები. მოცემულია ბენჩმარკის შედეგები ინფერენსისა და ადაპტერების დახვეწის წარმადობის შესადარებლად სხ

Hugging Face და IISc/ARTPARK ინდოეთის ლინგვისტური მრავალფეროვნების მხარდასაჭერად Vaani მონაცემთა ნაკრებს აფართოებენ
Hugging Face-ისა და IISc/ARTPARK-ის პარტნიორობა მიზნად ისახავს Vaani მონაცემთა ნაკრების ხელმისაწვდომობისა და გამოყენებადობის გაუმჯობესებას, რაც ხელს შეუწყობს AI სისტემების განვითარებას ინდოეთის მრავალფეროვანი ენების უკეთ გასაგებად. Project Vaani, რომელიც 2022 წელს IISc/ARTPARK-მა და Google-მა დაიწყეს, არის პიონერული ინიციატივა ღია კოდის მრავალმოდალური მონაცემთა ნაკრების შესაქმნელად, რომელიც ინდოეთის ლინგვისტურ მრავალფეროვნებას ასახავს. ამ მონაცემთა ნაკრებს უკვე მოიცავს 54 ენას და მოიცავს სპონტან

Cohere For AI-მ Aya Vision წარადგინა: ახალი მულტილინგვური და მულტიმოდალური AI მოდელი
Cohere For AI-მ გამოუშვა Aya Vision, მულტილინგვური და მულტიმოდალური მოდელების უახლესი ოჯახი, რომელიც 23 ენაზე ენისა და ვიზუალური ინფორმაციის გაგებისთვის მძლავრი საფუძველია. ის ეფუძნება Aya Expanse-ის წარმატებას და აფართოებს მას მოწინავე ტექნიკების გამოყენებით. Aya Vision-ს შეუძლია შეასრულოს ისეთი ამოცანები, როგორიცაა გამოსახულების აღწერა, ვიზუალური შეკითხვებზე პასუხის გაცემა და ტექსტის გენერაცია. მოდელი მნიშვნელოვნად აღემატება თავისი ზომის ბევრ სხვა მოდელს და ხელმისაწვდომია ღია წონით კვლევისთვის

Yaak-ი და LeRobot-ი L2D-ს, მსოფლიოში უდიდეს მულტიმოდალურ მონაცემთა ბაზას, წარადგენენ რობოტიკის ხელოვნური ინტელექტისთვის
კომპანია Yaak-მა, 🤗-ის LeRobot გუნდთან თანამშრომლობით, გამოაცხადა Learning to Drive (L2D) — მსოფლიოში უდიდესი მულტიმოდალური მონაცემთა ბაზა. L2D მიზნად ისახავს რობოტიკის ხელოვნური ინტელექტის პოტენციალის განბლოკვას ავტონომიური მართვის სფეროში, განსაკუთრებული მხარდაჭერით LeRobot-ის ტრენინგის პაიპლაინებისთვის. მონაცემთა ბაზა მოიცავს რეალურ მართვის სცენარებს 60 ელექტრომობილიდან, რომლებსაც გერმანიის 30 ქალაქში ავტოსკოლები მართავდნენ. ის განასხვავებს ექსპერტისა და სტუდენტის მართვის პოლიტიკებს, ბუნებრივ

Google-მა Gemma 3 წარადგინა: მულტიმოდალური ხელოვნური ინტელექტის მოდელების ახალი თაობა
Google-მა გამოუშვა Gemma 3, Gemma მოდელების ოჯახის ახალი ვერსია. ეს მოდელები, რომელთა პარამეტრების რაოდენობა 1 მილიარდიდან 27 მილიარდამდე მერყეობს, მხარს უჭერს 140-ზე მეტ ენას, შეუძლია როგორც გამოსახულებების, ისე ტექსტის დამუშავება, აქვს 128k ტოკენამდე კონტექსტური ფანჯარა და ინტეგრირებულია Hugging Face-ის ეკოსისტემასთან. Gemma 3-ის მოდელები, განსაკუთრებით Gemma-3-27B-IT, ეტალონურ ტესტებში აჭარბებს Gemma 2-27B IT-სა და Gemini 1.5-Pro-ს, რაც Google-ის ღია წონის დიდი ენობრივი მოდელების უახლეს მიღწე

Meta-ს Llama 4-ის მოდელები გამოვიდა: წინ გადადგმული ნაბიჯი მულტიმოდალურ ხელოვნურ ინტელექტში MoE არქიტექტურითა და გაფართოებული კონტექსტით
Meta-ს მიერ შემუშავებული Llama 4-ის მოდელები, Maverick და Scout, დღეს გამოვიდა, რაც ხელოვნური ინტელექტის სფეროში მნიშვნელოვან წინსვლას წარმოადგენს. ეს მძლავრი, მშობლიურად მულტიმოდალური მოდელები იყენებენ ახალ ავტორეგრესიულ „ექსპერტთა ნაზავის“ (MoE) არქიტექტურას, რაც მათ საშუალებას აძლევს დაამუშაონ როგორც ტექსტური, ისე გამოსახულების შეტანა. Hugging Face-ის ეკოსისტემასთან სრულყოფილი ინტეგრაციის უზრუნველყოფით, Llama 4-ის მოდელები გაწვრთნილია 200 ენაზე (40 ტრილიონამდე ტოკენზე) და გამოირჩევა კონტექსტი
Meta-მ Llama 4 მულტიმოდალური AI მოდელები გამოუშვა Hugging Face-ის ეკოსისტემისთვის
დღეს Meta-მ წარმოადგინა Llama 4-ის ახალი თაობის მძლავრი, მშობლიურად მულტიმოდალური AI მოდელები – Maverick და Scout. ეს მოდელები მნიშვნელოვან წინ გადადგმულ ნაბიჯს წარმოადგენს ხელოვნური ინტელექტის განვითარებაში, რომლებიც ინტეგრირებულია Hugging Face-ის ეკოსისტემაში. Llama 4 იყენებს ინოვაციურ ავტორეგრესიულ ექსპერტთა ნარევის (MoE) არქიტექტურას და მხარს უჭერს უზარმაზარ კონტექსტის სიგრძეებს (Scout-ისთვის 10 მილიონამდე ტოკენი), ასევე ტექსტური და გამოსახულების შეტანის დამუშავებას. მოდელები გაწვრთნილია 200
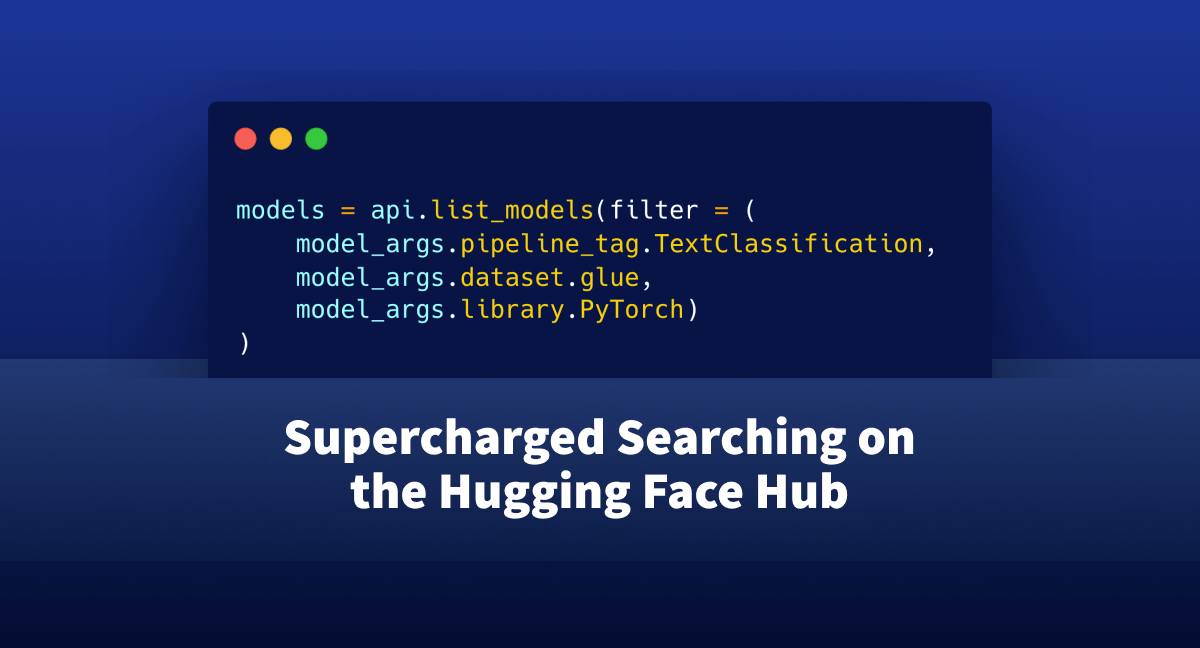
Hugging Face Hub-ის ძიების გამარტივება: პროგრამული ინტერფეისის ახალი შესაძლებლობები
სტატიაში წარმოდგენილია `huggingface_hub` ბიბლიოთეკის ახალი ფუნქციები, `ModelSearchArguments` და `ModelFilter`, რომლებიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე AI მოდელებისა და მონაცემთა ნაკრებების ძიებას პირდაპირ Python-ის ან Jupyter-ის გარემოდან. ეს სიახლე დეველოპერებს საშუალებას აძლევს, არ დატოვონ IDE და ეფექტურად მართონ რთული მოთხოვნები, რაც მნიშვნელოვნად აუმჯობესებს სამუშაო პროცესს.

Visual Salamandra: ახალი თაობის მულტიმოდალური AI ევროპული ენების აქცენტით
ენის ტექნოლოგიების ლაბორატორიამ წარმოადგინა Visual Salamandra, ინოვაციური მულტიმოდალური AI მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან. ეს სისტემა შექმნილია ვიზუალურ და ტექსტურ მონაცემებს შორის ხარვეზის შესავსებად, რის შედეგადაც მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანის საფუძველზე, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტური ინსტრუქციებიდან. Visual Salamandra გამოირჩევა მრავალენოვანი ინკლუზიურობით, განსაკუთრები
Visual Salamandra: მულტიმოდალური AI მოდელი ევროპული ენობრივი მრავალფეროვნების მხარდასაჭერად
Visual Salamandra, ახალი მულტიმოდალური ხელოვნური ინტელექტის მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან, ხედვისა და ენის დამუშავების უფსკრულს ავსებს. მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანიდან, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტიდან. ლაბორატორიის მიერ შექმნილი ეს ინოვაცია ხაზს უსვამს მრავალენოვან ინკლუზიურობას, განსაკუთრებული აქცენტით ევროპულ ენებზე, რაც ხელს უწყობს მულტიმოდალური AI კვლევის რესურსების ნა

Llama Guard 4 და Prompt Guard 2: ხელოვნური ინტელექტის უსაფრთხოების ახალი მულტიმოდალური მოდელები
წარმოგიდგენთ Llama Guard 4-ს, მულტიმოდალურ მოდელს, რომელიც შექმნილია გამოსახულებებსა და ტექსტში სახიფათო კონტენტის აღმოსაჩენად, მათ შორის „jailbreak“-ის თავიდან ასაცილებლად. მასთან ერთად, Llama Prompt Guard 2 აძლიერებს დაცვას „prompt injection“-ებისა და სხვა მავნე შეტევებისგან, რაც უზრუნველყოფს ხელოვნური ინტელექტის უსაფრთხო და მოქნილ მოდერაციას. ეს მოდელები მნიშვნელოვნად აუმჯობესებენ AI სისტემების დაცვას საწარმოო გარემოში.

ხილვად-ენობრივი მოდელების ტრანსფორმაცია: ბოლო ერთი წლის მიღწევები
სტატია მიმოიხილავს ხილვად-ენობრივი მოდელების (VLMs) განვითარებას ბოლო ერთი წლის განმავლობაში, LLaVA-ს თავდაპირველი წარმატებიდან უფრო მძლავრი, კომპაქტური და მრავალფეროვანი არქიტექტურების გამოჩენამდე. განხილულია ახალი პარადიგმები, როგორიცაა 'ნებისმიერი-ნებისმიერზე' (any-to-any) მოდელები, მულტიმოდალური RAG, მსჯელობის მოდელები და მცირე ზომის VLMs-ის ტენდენცია, რომლებსაც შეუძლიათ სამომხმარებლო მოწყობილობებზე მუშაობა.
ხედვა-ენობრივი მოდელების ევოლუცია: სიახლეები, ტენდენციები და მომავალი
ხედვა-ენობრივი მოდელები (VLMs) დღესდღეობით ერთ-ერთი ყველაზე განხილვადი თემაა. 2024 წლის აპრილის ბლოგ პოსტში ვრცლად ვისაუბრეთ VLMs-ზე, მათ შორის LLaVA-ზე, პირველ წარმატებულ ღია წყაროს ხედვა-ენობრივ მოდელზე. მას შემდეგ მრავალი რამ შეიცვალა: მოდელები უფრო მცირე, მაგრამ ძლიერი გახდა, გაჩნდა ახალი არქიტექტურები და შესაძლებლობები (არგუმენტაცია, მოქმედება, გრძელი ვიდეოების გაგება). პარალელურად, განვითარდა ახალი პარადიგმები, როგორიცაა მულტიმოდალური ინფორმაციის მოძიებით გაძლიერებული გენერაცია (RAG) და მუ
Hugging Face-ის მულტიმოდალური სწავლის ჯგუფი ხელოვნური ინტელექტის ეთიკურ პრინციპებს აფორმალებს
Hugging Face-ის მულტიმოდალური სწავლის ჯგუფმა დაასახელა ეთიკური პრინციპები თავისი ხელოვნური ინტელექტის პროექტისთვის, რაც მიზნად ისახავს გამჭვირვალობის, ადრეული უკუკავშირისა და პოტენციური ზიანის შემცირების უზრუნველყოფას. დოკუმენტი აღიარებს „ეთიკური ხელოვნური ინტელექტის“ არასრულყოფილ დეფინიციას და ხაზს უსვამს რისკებისა და სარგებლის შეფასების აუცილებლობას თითოეულ კონკრეტულ შემთხვევაში, ამასთან ერთად აცხადებს, რომ ეს არის მუშა პროცესში არსებული დოკუმენტი.
ConTextual: ახალი მონაცემთა ნაკრები LMM-ების შესაფასებლად კონტექსტზე მგრძნობიარე, ტექსტ-მდიდარი ვიზუალური მსჯელობის ამოცანებში
კალიფორნიის უნივერსიტეტის (ლოს-ანჯელესი) მკვლევრებმა შექმნეს ConTextual – მონაცემთა ნაკრები, რომელიც განკუთვნილია მსხვილი მულტიმოდალური მოდელების (LMMs) შესაფასებლად კონტექსტზე მგრძნობიარე, ტექსტ-მდიდარი ვიზუალური მსჯელობის ამოცანებში. არსებული შეფასებები ხშირად უგულებელყოფს ამ რთულ სცენარებს, რის გამოც ConTextual გვთავაზობს 506 გამოწვევას ტექსტსა და ვიზუალურ მინიშნებებზე ერთობლივი მსჯელობისთვის, რათა დადგინდეს მოდელების რეალური შესაძლებლობები. გამოქვეყნებულია ლიდერბორდიც, რაც ხელს შეუწყობს მოდე
UCLA-ს მკვლევრებმა LMM-ების შესაფასებლად კონტექსტზე მგრძნობიარე ვიზუალური ამოცანების ახალი მონაცემთა ბაზა – ConTextual შექმნეს
კალიფორნიის უნივერსიტეტის ლოს-ანჯელესის (UCLA) მკვლევრებმა წარმოადგინეს ConTextual – ინოვაციური მონაცემთა ბაზა, რომელიც მიზნად ისახავს დიდი მულტიმოდალური მოდელების (LMMs) კონტექსტზე მგრძნობიარე, ტექსტით მდიდარი ვიზუალური მსჯელობის შესაძლებლობების შეფასებას. ეს მონაცემთა ბაზა 506 რთულ ინსტრუქციას მოიცავს 8 რეალური სამყაროს სცენარში, რათა შეავსოს არსებული შეფასების მეთოდების ხარვეზები, რომლებიც ხშირად უგულებელყოფენ კონტექსტის გაგებას. პროექტის ფარგლებში ასევე შეიქმნა ლიდერბორდი, სადაც საზოგადოებას

Gemma 3n: მულტიმოდალური AI მოდელი საბოლოოდ ღია კოდის ბიბლიოთეკებში
Google-ის უახლესი მულტიმოდალური AI მოდელი, Gemma 3n, საბოლოოდ ხელმისაწვდომია ყველაზე პოპულარულ ღია კოდის ბიბლიოთეკებში, მათ შორის transformers & timm, MLX, llama.cpp და სხვებში. ეს გამოშვება მოიცავს ორ ზომას (E2B და E4B), რომლებიც გამოირჩევიან მაღალი ეფექტურობით VRAM-ის გამოყენების მხრივ და უზრუნველყოფენ შესანიშნავ ხარისხს. Gemma 3n არა მხოლოდ ენობრივ დეკოდერს, არამედ აუდიო და ვიზუალურ ენკოდერებსაც მოიცავს, რაც მას სრულყოფილ მულტიმოდალურ ინსტრუმენტად აქცევს დეველოპერებისთვის. სტატია დეტალურად აღ

NVIDIA-ს Llama Nemotron Nano VL: რევოლუცია ინტელექტუალური დოკუმენტების დამუშავებაში
NVIDIA-მ წარმოადგინა Llama Nemotron Nano VL, 8 მილიარდპარამეტრიანი ხედვითი ენის მოდელი (VLM), რომელიც განკუთვნილია ინტელექტუალური დოკუმენტების დამუშავებისთვის (IDP). მოდელი გამოირჩევა მაღალი სიზუსტით და მულტიმოდალური გაგებით, რაც საშუალებას აძლევს მას ეფექტურად მოიპოვოს და გაიგოს ინფორმაცია კომპლექსური დოკუმენტებიდან, როგორიცაა ინვოისები, ქვითრები, კონტრაქტები, PDF ფაილები, სურათები და დიაგრამები. Llama Nemotron Nano VL აჩვენებს ინდუსტრიაში წამყვან შედეგებს OCRBench v2 ბენჩმარკზე, რაც უზრუნველყო