
ლონდონური სტარტაპი Mirai AI მოდელებს მოწყობილობებზე მუშაობისთვის აუმჯობესებს
Mirai, $10 მილიონიანი საწყისი დაფინანსებით, მუშაობს ხელოვნური ინტელექტის მოდელების ოპტიმიზაციაზე ტელეფონებსა და ლეპტოპებზე. კომპანია, რომლის დამფუძნებლებსაც წარსულში წარმატებული სამომხმარებლო აპლიკაციების შექმნის გამოცდილება აქვთ, მიზნად ისახავს ღრუბლოვანი სერვისებზე დამოკიდებულების შემცირებას და დეველოპერებისთვის მარტივი SDK-ის შეთავაზებას, რაც ხელს შეუწყობს AI-ის ეფექტურ ინტეგრაციას მოწყობილობებში, და ასევე გეგმავს Android-ის მხარდაჭერასა და მოწყობილობაშიდა ბენჩმარკების გამოშვებას.
AMD Hugging Face-ის აპარატურის პარტნიორი ხდება: ახალი ეტაპი ხელოვნური ინტელექტის განვითარებაში
ტექნოლოგიურმა გიგანტებმა Hugging Face-მა და AMD-მ გამოაცხადეს სტრატეგიული პარტნიორობა, რომელიც მიზნად ისახავს უახლესი ტრანსფორმატორული მოდელების ოპტიმიზაციას AMD-ის ცენტრალურ პროცესორებსა (CPUs) და გრაფიკულ პროცესორებზე (GPUs). ეს თანამშრომლობა მნიშვნელოვნად გააფართოებს ღრმა სწავლისთვის ხელმისაწვდომი აპარატურის არჩევანს, შეამცირებს ხარჯებს და დააწესებს ახალ სტანდარტებს ხელოვნური ინტელექტის (AI) გამოთვლებში.
Stable Diffusion XL Core ML-ზე: მოდელის ზომის შემცირება და მუშაობის გაუმჯობესება
Hugging Face-ი და Apple-ი აგრძელებენ ხელოვნური ინტელექტის მოდელების ოპტიმიზაციას სამომხმარებლო მოწყობილობებზე ადგილობრივად გასაშვებად. უახლესი მცდელობა Stable Diffusion XL-ის Core ML-ზე ადაპტაციაა Apple Silicon-ის Mac-ებისთვის, რაც საშუალებას იძლევა მოდელი შემცირდეს ზომით და გაუმჯობესდეს მისი მუშაობა ინოვაციური კვანტიზაციის მეთოდებით, მათ შორის შერეული ბიტების პალეტიზაციით. პროექტი სრულად ღია კოდით არის ხელმისაწვდომი და community-ის ჩართულობას ელის.
100-ჯერ გაზრდილი წარმადობა: დიდი AI მოდელების ოპტიმიზაცია Hugging Face-ის ინფრასტრუქტურაზე
მიუხედავად იმისა, რომ დიდი ენობრივი მოდელების ექსპერიმენტირება მარტივია, მათი მაქსიმალური წარმადობით პროდუქციაში განთავსება რთული საინჟინრო გამოწვევაა. Hugging Face გთავაზობთ გადაწყვეტას თავისი Accelerated Inference API-ის მეშვეობით, რომელიც უზრუნველყოფს 100-ჯერ გაზრდილ სიჩქარეს და მასშტაბირებადობას. სტატია დეტალურად აღწერს ოპტიმიზაციის სხვადასხვა დონეს – ბიბლიოთეკების გამოყენებიდან აპარატურის სპეციფიკურ მოდიფიკაციამდე – და ხაზს უსვამს Hugging Face-ის ექსპერტიზასა და პარტნიორობებს ტექნიკის წამყვ
სენტიმენტების ანალიზი ყველასთვის: როგორ გამოვიყენოთ ხელოვნური ინტელექტის თანამედროვე ხელსაწყოები
წარსულში სენტიმენტების ანალიზი მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, მაგრამ ხელოვნური ინტელექტის საზოგადოების მიერ შექმნილმა ინოვაციურმა ხელსაწყოებმა ის ყველასთვის მარტივად ხელმისაწვდომი გახადა. ეს სახელმძღვანელო გვიჩვენებს, თუ როგორ შეიძლება Python-ისა და Hugging Face Hub-ის გამოყენებით ტექსტის ემოციური პოლარობის იდენტიფიცირება, მონაცემების მასშტაბური დამუშავება და მოდელების ოპტიმიზაცია კონკრეტული ამოცანებისთვის, გამოცდილების გარეშეც კი.

დიდი ენობრივი მოდელების ოპტიმიზაცია: ინფერენციის ფაზების გამოწვევები
კომპანია TNG-ი დიდი ენობრივი მოდელების (LLM) თვით-ჰოსტინგის გამოცდილებას გვიზიარებს, სადაც 24 H100 GPU-ს კლასტერი საათში 5000-ზე მეტ ინფერენციას ამუშავებს. სტატიაში დეტალურად არის განხილული ტოკენების გენერაციის ავტორეგრესიული ბუნება, KV ქეშის როლი და განსხვავება 'პრეფილის' (პირველი ტოკენის გენერაცია) და 'დეკოდირების' (შემდგომი ტოკენების გენერაცია) ფაზებს შორის. განმარტებულია, თუ როგორ მოქმედებს ეს ფაზები შეყოვნებაზე (latency) და გამტარუნარიანობაზე (throughput), და როგორ გამოიყენება GPU რესურსები

დიდი ენობრივი მოდელების ოპტიმიზაცია Intel Xeon-ზე: StarCoder-ის აჩქარება კოდის გენერაციისთვის
სტატია მიმოიხილავს კოდის გენერაციის მოდელების, როგორიცაა StarCoder და Code Llama, მზარდ პოპულარობას და LLM-ების ოპტიმიზაციის ძალისხმევას ხელმისაწვდომობის გაზრდის მიზნით. ხაზგასმულია Intel-ის მიღწევა StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენციის აჩქარებაში მე-4 თაობის Intel Xeon პროცესორებზე, 8-ბიტიანი და 4-ბიტიანი კვანტიზაციის ინტეგრაციით ასისტირებულ გენერაციასთან ერთად. განხილულია Intel AMX-ის როლი, SmoothQuant-ისა და WOQ კვანტიზაციის ტექნიკები, ასევე პროდუქტიულობის შეფასებები HumanEval-ისა და M

Hugging Face-ის Kernel Hub: ხელოვნური ინტელექტის მოდელების მუშაობის დაჩქარება ოპტიმიზებული ბირთვებით
Hugging Face-ის ახალი Kernel Hub რევოლუციას ახდენს მანქანური სწავლების მოდელების ოპტიმიზაციაში. ის უზრუნველყოფს ცენტრალიზებულ საცავს წინასწარ კომპილირებული, მაღალეფექტური გამოთვლითი ბირთვებისთვის, რაც დეველოპერებს საშუალებას აძლევს, მარტივად ჩართონ ოპტიმიზებული კოდი სწრაფი ოპერაციებისთვის, განსაკუთრებით GPU-ებზე, რთული კომპილაციის პროცესების გარეშე. ეს დრამატულად ამარტივებს მაღალი წარმადობის მიღწევას ML პროექტებში, რაც დეველოპერებს საშუალებას აძლევს, მეტი დრო დაუთმონ მოდელების აგებას და ნაკლები
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.

Hugging Face-ისა და AMD-ის გარღვევა AI მოდელების ოპტიმიზაციაში MI300X-ზე
Hugging Face-მა და AMD-მ ითანამშრომლეს, რათა მნიშვნელოვნად გაეუმჯობესებინათ ხელოვნური ინტელექტის მოდელების, კერძოდ Llama 3.1 405B-ის ინფერენსის შესრულება AMD MI300X GPU-ებზე. პროექტი ფოკუსირებულია დაბალი დონის კერნელების ოპტიმიზაციაზე, რაც გადამწყვეტია მილიარდობით პარამეტრის მქონე მოდელებისთვის. ამ თანამშრომლობის შედეგად შეიქმნა ღია კოდის მორგებული კერნელები, რომლებმაც მნიშვნელოვანი სიჩქარის ზრდა აჩვენეს, განსაკუთრებით AMD-ის აპარატურისთვის, რომელიც ხშირად იგნორირებულია კერნელის დეველოპერების მი
SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა
ენის დიდი მოდელების ოპტიმიზაცია: Hugging Face-ის LLM.int8() ინტეგრაცია
ენის დიდი მოდელები (LLM) მუდმივად იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა, BigScience-თან თანამშრომლობით, წარმოადგინა LLM.int8() ინტეგრაცია, რომელიც საშუალებას აძლევს ამ მასშტაბურ მოდელებს იმუშაონ ნაკლებ GPU-ზე, მეხსიერების მოხმარების 2-ჯერ შემცირებით, პროგნოზირების სიზუსტის შენარჩუნებით. სტატია დეტალურად განიხილავს ამ ტექნოლოგიას და სხვადასხვა მცოცავწერტილიანი მონაცემთა ტიპებს, რომლებიც მოდელის ზომასა და მუშაობაზე ახდენენ გავლენას.

PyTorch-ის წინასწარი (AoT) კომპილაცია ZeroGPU Spaces-ში: მაქსიმალური სისწრაფე და ეფექტურობა
PyTorch-ის წინასწარი (AoT) კომპილაცია მნიშვნელოვან უპირატესობას ანიჭებს ZeroGPU Spaces-ს, სადაც ტრადიციული Just-in-Time (JIT) კომპილაცია არაეფექტურია პროცესების ხანმოკლე სიცოცხლის ხანგრძლივობის გამო. AoT საშუალებას აძლევს მომხმარებლებს, ერთხელ მოახდინონ მოდელების ოპტიმიზაცია და მყისიერად გადატვირთონ ისინი, რაც იწვევს დემოების 1.3-დან 1.8-ჯერ დაჩქარებას და გაუმჯობესებულ მომხმარებლის გამოცდილებას. ეს პოსტი განმარტავს AoT-ის ინტეგრაციას ZeroGPU-ში, მოიცავს მოწინავე ტექნიკებს, როგორიცაა FP8 კვანტიზა
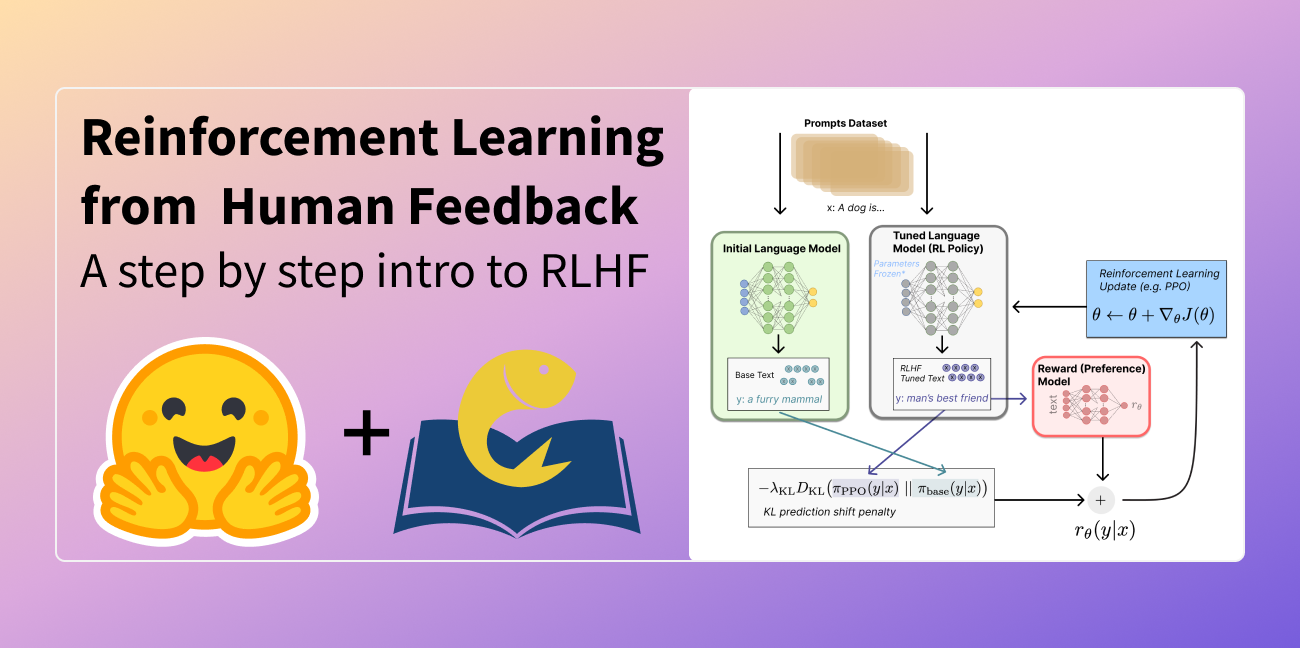
RLHF: როგორ აუმჯობესებს ადამიანის უკუკავშირი ენის მოდელებს?
RLHF (გაძლიერებული სწავლა ადამიანის უკუკავშირით) არის ინოვაციური მეთოდი, რომელიც ენის მოდელებს ადამიანის პრეფერენციებთან მისადაგებაში ეხმარება. ტრადიციული დანაკარგის ფუნქციებისა და მეტრიკების შეზღუდვების საპასუხოდ, RLHF იყენებს გაძლიერებული სწავლის ტექნიკას, რათა უშუალოდ მოახდინოს მოდელების ოპტიმიზაცია ადამიანის უკუკავშირის საფუძველზე. სტატია განმარტავს RLHF-ის კომპლექსურ პროცესს, მათ შორის წინასწარ გაწვრთნილი მოდელების გამოყენებას და ჯილდოს მოდელების შექმნას ადამიანის პრეფერენციების ინტეგრირები

AI მოდელების ლოკალური ოპტიმიზაცია Intel-ის აპარატურაზე: OpenVINO და Optimum Intel-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების საკუთარ მოწყობილობაზე გაშვება, მიუხედავად მათი გამოთვლითი სირთულისა, მნიშვნელოვან უპირატესობებს გვთავაზობს, მათ შორის გაუმჯობესებულ კონფიდენციალურობასა და სიჩქარეს. ეს სტატია განმარტავს, თუ როგორ შეიძლება მოდელების ოპტიმიზაცია Optimum Intel-ისა და OpenVINO-ს, ასევე მცირე ზომის მოდელების, როგორიცაა SmolVLM, გამოყენებით. ნაბიჯ-ნაბიჯ განხილულია კვანტიზაციის (Weight-only და Static) ტექნიკა, რაც ხელს უწყობს მეხსიერების შემცირებას და ინფერენსის დაჩქარებას, ძვირადღირებული