
ხელოვნური ინტელექტი: გამოსახულებების ტოკენიზაცია და ViT მოდელების წვრთნა
ეს სტატია განმარტავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია წინადადებების მსგავსად, რაც მათ საშუალებას აძლევს, დამუშავდეს ტრანსფორმერული მოდელებით. დეტალურად არის აღწერილი 🤗 datasets-ის გამოყენებით მონაცემთა მომზადება, ViTImageProcessor-ის ინტეგრირება და წინასწარ გაწვრთნილი ViT მოდელების დაზუსტება. მიმოხილულია ტრენინგის კონფიგურაციის, შეფასების მეტრიკების განსაზღვრისა და ეფექტური წვრთნის კონვეიერის აგების პროცესები, რაც მნიშვნელოვან წინსვლას წარმოადგენს გამოსახულების კლასიფიკაციის ამოცანებშ
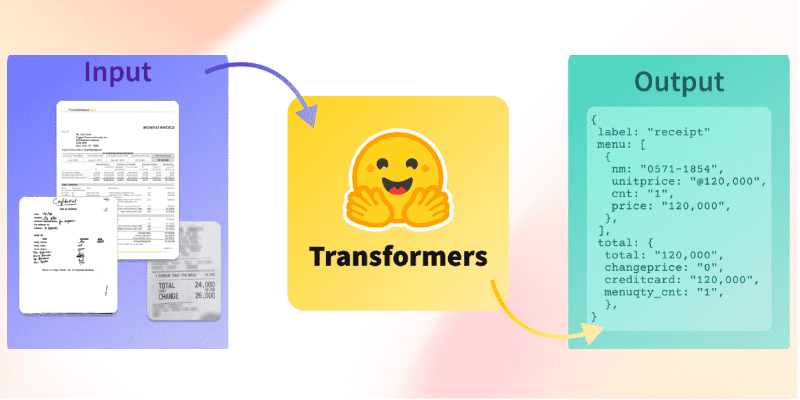
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ

SyGra: ხელოვნური ინტელექტის მონაცემთა მომზადების პროცესის გამარტივება
ხელოვნური ინტელექტის (AI) მოდელებთან მუშაობისას, მონაცემთა მომზადება უსასრულო გამოწვევებს აჩენს. SyGra წარმოადგენს low-code/no-code ფრეიმვორკს, რომელიც ამარტივებს მონაცემთა ნაკრებების შექმნას, ტრანსფორმაციას და ოპტიმიზაციას LLM-ებისა და SLM-ებისთვის, რაც დეველოპერებს საშუალებას აძლევს, ფოკუსირება მოახდინონ მოდელების განვითარებაზე.