
Google-მა PaliGemma 2 mix წარადგინა: ახალი, დახვეწილი ვიზუალურ-ენობრივი მოდელები
გასულ დეკემბერში Google-მა PaliGemma 2-ის წინასწარ გაწვრთნილი (pt) ვიზუალურ-ენობრივი მოდელები (VLM) გამოუშვა, რომლებიც SigLIP-სა და Gemma 2-ზეა დაფუძნებული. დღეს კომპანია წარმოადგენს PaliGemma 2 mix-ს, რომელიც დახვეწილია ვიზუალურ-ენობრივ ამოცანებზე, მათ შორის OCR-ზე (ოპტიკური სიმბოლოების ამოცნობა), გრძელ და მოკლე წარწერების გენერირებაზე და სხვა. ეს მოდელები განკუთვნილია სპეციფიკურ ამოცანებზე ადაპტირებისთვის და გთავაზობთ სხვადასხვა შესაძლებლობებს, როგორიცაა ობიექტის ამოცნობა და სეგმენტაცია, გაუმჯ
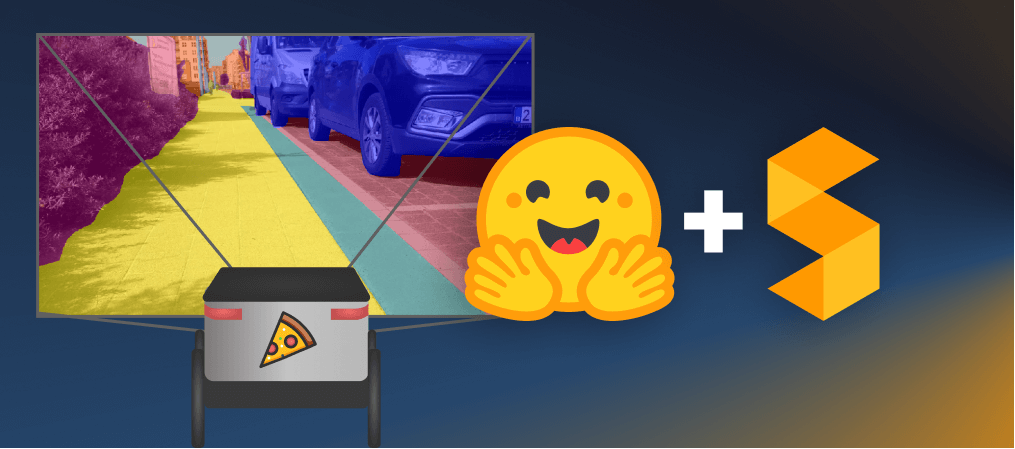
სემანტიკური სეგმენტაცია SegFormer-ით: ავტონომიური სისტემების გაუმჯობესება
სემანტიკური სეგმენტაცია გამოსახულების თითოეული პიქსელის კლასიფიკაციის ამოცანაა, რაც გამოსახულების ანალიზის უფრო ზუსტი მეთოდია. მას ფართო გამოყენება აქვს ისეთ სფეროებში, როგორიცაა სამედიცინო გამოსახულება და ავტონომიური მართვა. სტატია განიხილავს SegFormer მოდელს, რომელიც იყენებს ტრანსფორმერებს სემანტიკური სეგმენტაციისთვის და წარმოადგენს უახლეს მიღწევებს ამ სფეროში. ნაჩვენებია, თუ როგორ იქმნება და მუშავდება სპეციალიზებული მონაცემთა ნაკრები პიცის მიმწოდებელი რობოტისთვის, რაც უზრუნველყოფს მის ეფექტურ
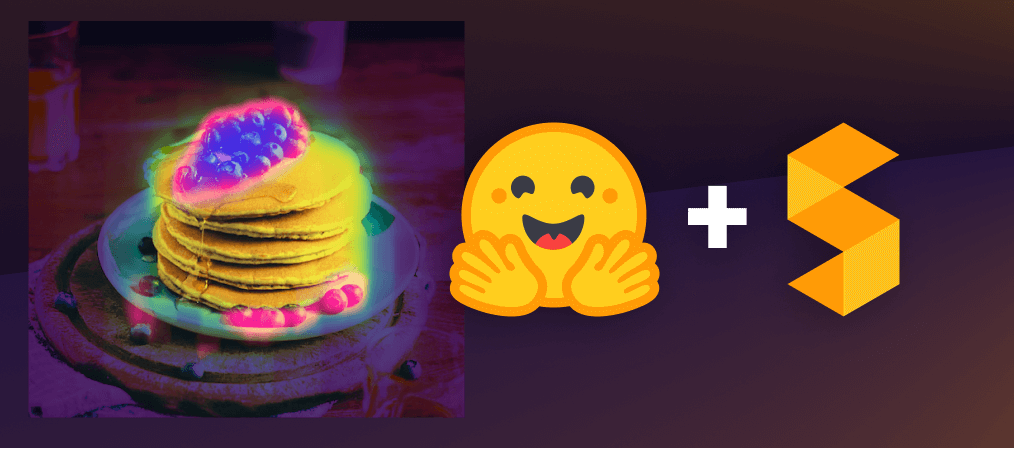
CLIPSeg: რევოლუციური ხელოვნური ინტელექტი, რომელიც ნებისმიერი ობიექტის სეგმენტაციას დამატებითი წვრთნის გარეშე ახდენს
სტატია განიხილავს გამოსახულების სეგმენტაციას, მის არსებულ შეზღუდვებს (ფიქსირებული კატეგორიები, წვრთნის მაღალი ღირებულება) და წარმოგიდგენთ CLIPSeg-ს. CLIPSeg არის "ნულოვანი-კადრის" (zero-shot) სეგმენტაციის მოდელი, რომელიც OpenAI-ის CLIP-ზეა დაფუძნებული და შეუძლია თითქმის ნებისმიერი ობიექტის სეგმენტაცია დამატებითი წვრთნის გარეშე. ის იყენებს CLIP-ის უნარს, შექმნას გამოსახულებებისა და ტექსტის აბსტრაქტული წარმოდგენები, ტრანსფორმატორზე დაფუძნებული დეკოდერის დახმარებით სეგმენტაციის ნიღბების შესაქმნელად
CLIPSeg: რევოლუციური „ნულოვანი კადრის“ სეგმენტაცია, რომელიც ცვლის კომპიუტერულ ხედვას
გამოსახულების სეგმენტაცია კომპიუტერული ხედვის მნიშვნელოვანი ამოცანაა, რომელიც ობიექტების კონტურების ამოცნობას უზრუნველყოფს. ტრადიციული მოდელების შეზღუდვა ისაა, რომ ისინი მხოლოდ ფიქსირებულ კატეგორიებთან მუშაობენ და ახალი ობიექტების დასამატებლად ხელახალ ვარჯიშს საჭიროებენ. CLIPSeg, „ნულოვანი კადრის“ სეგმენტაციის ინოვაციური მოდელი, ამ პრობლემას წყვეტს. ის CLIP-ის მძლავრი შესაძლებლობების გამოყენებით საშუალებას იძლევა თითქმის ნებისმიერი ობიექტის სეგმენტაცია მოხდეს დამატებითი ვარჯიშის გარეშე, რაც დროს