
ექსპერტთა ნაზავი (MoE) მოდელები: დიდი ენობრივი მოდელების (LLMs) მასშტაბირების ახალი მიდგომა
ბოლო წლებში დიდი ენობრივი მოდელების (LLMs) განვითარება ძირითადად განპირობებული იყო მკვრივი მოდელების მასშტაბირებით. თუმცა, ამ მიდგომას პრაქტიკული ზღვარი აქვს. სტატია განმარტავს ექსპერტთა ნაზავი (MoE) მოდელების კონცეფციას, როგორც LLM-ების მასშტაბირების ახალ ეფექტურ გზას. MoE მოდელები იძლევა მაღალი წარმადობის მიღწევის საშუალებას გაცილებით ნაკლები აქტიური პარამეტრით, რაც აჩქარებს ინფერენციის პროცესს. განხილულია მათი უპირატესობები გამოთვლითი ეფექტურობის, პარალელიზაციის და ინდუსტრიაში მზარდი მიღების

Scosche MagicMount Charge Pro: იდეალური მაგნიტური უსადენო დამტენი ავტომობილისთვის
ZDNET განმარტავს პროდუქციის შეფასების მკაცრ სარედაქციო სტანდარტებს, რომლებიც ეფუძნება ხანგრძლივ ტესტირებასა და მომხმარებლის გამოცდილებას. ამ კონტექსტში, მიმოხილვაში წარმოდგენილია Scosche MagicMount Charge Pro – Qi2-თან თავსებადი მაგნიტური უსადენო დამტენი, რომელიც უზრუნველყოფს საიმედო 15W დატენვას და მყარ სამაგრს ავტომობილში. ის წარმოადგენს გაცილებით ეფექტურ ალტერნატივას მანქანის ჩაშენებული დამტენების არასაიმედოობის ფონზე და იდეალურია როგორც ქირავნობის, ისე საკუთარი ავტომობილისთვის.

ელექტრომობილის ბატარეები: რატომ ძლებენ ისინი სმარტფონებზე დიდხანს?
მომხმარებელთა შეშფოთება ელექტრომობილების ბატარეების სიცოცხლის ხანგრძლივობასთან დაკავშირებით, ხშირად სმარტფონების ბატარეების სწრაფ ცვეთას უკავშირდება. თუმცა, კომპანია Generational-ის კვლევა ცხადყოფს, რომ ელექტრომობილების ბატარეები გაცილებით გამძლეა, ვიდრე მიღებულია ითვლებოდეს. სტატია განმარტავს ამ მოულოდნელი გამძლეობის მიზეზებს, მათ შორის ბატარეების კონსტრუქციულ თავისებურებებს, ქიმიურ შემადგენლობასა და გამოყენების სპეციფიკას.

ხელოვნური ინტელექტის განვითარებას გამოთვლითი სიმძლავრე განაპირობებს და არა „საიდუმლო სოუსი“, აჩვენებს MIT-ის კვლევა
მასაჩუსეტსის ტექნოლოგიური ინსტიტუტის (MIT) მკვლევართა კვლევამ, რომელიც 809 დიდ ენობრივ მოდელს (LLM) მოიცავდა, აჩვენა, რომ მოდელების წარმადობის ზრდას ძირითადად განაპირობებს წვრთნისთვის გამოყენებული გამოთვლითი სიმძლავრის მოცულობა. დასკვნის თანახმად, ალგორითმული ინოვაციები ან კომპანიების უნიკალური „საიდუმლო სოუსი“ გაცილებით ნაკლებ გავლენას ახდენს, რაც ხაზს უსვამს გამოთვლით რესურსებზე მუდმივი წვდომის კრიტიკულ მნიშვნელობას ხელოვნური ინტელექტის სფეროში ლიდერობის შესანარჩუნებლად.

LLaMA-ს MMLU შეფასება: უთანხმოება ხელოვნური ინტელექტის მოდელების რეიტინგში
Open LLM ლიდერბორდზე LLaMA მოდელის MMLU (Massive Multitask Language Understanding) შეფასების ქულები გაცილებით დაბალი აღმოჩნდა, ვიდრე მის გამოქვეყნებულ ნაშრომში იყო მითითებული. ამან საზოგადოებაში გაკვირვება გამოიწვია. გამოძიებამ გამოავლინა MMLU შეფასების სხვადასხვა იმპლემენტაცია, მათ შორის EleutherAI Harness, ორიგინალი UC Berkeley-ის კოდი და Stanford HELM, რომლებიც განსხვავებულ შედეგებს იძლევა და მოდელების რეიტინგსაც კი ცვლის. სტატია დეტალურად განმარტავს ამ შეუსაბამობის მიზეზებს და დიდი ენობრივი

SmolVLM-256M და SmolVLM-500M: მსოფლიოს ყველაზე პატარა ხედვის ენის მოდელები
კომპანიამ SmolVLM ოჯახის ორი ახალი წევრი, SmolVLM-256M და SmolVLM-500M, წარადგინა. 256 მილიონი პარამეტრის მქონე მოდელი მსოფლიოში ყველაზე პატარა ხედვის ენის მოდელია. ახალი მოდელები ეფუძნება SmolVLM 2B-დან მიღებულ გამოცდილებას, აქცენტი კეთდება ეფექტურობაზე, მონაცემთა ნარევებზე და დიზაინის ახალ კომპრომისებზე. ისინი ინარჩუნებენ მძლავრ მულტიმოდალურ მუშაობას გაცილებით მცირე ზომებში და მარტივად ინტეგრირდება არსებულ სისტემებში. ეს მოდელები განკუთვნილია როგორც შეზღუდული მოწყობილობებისთვის, ასევე დიდი მოც
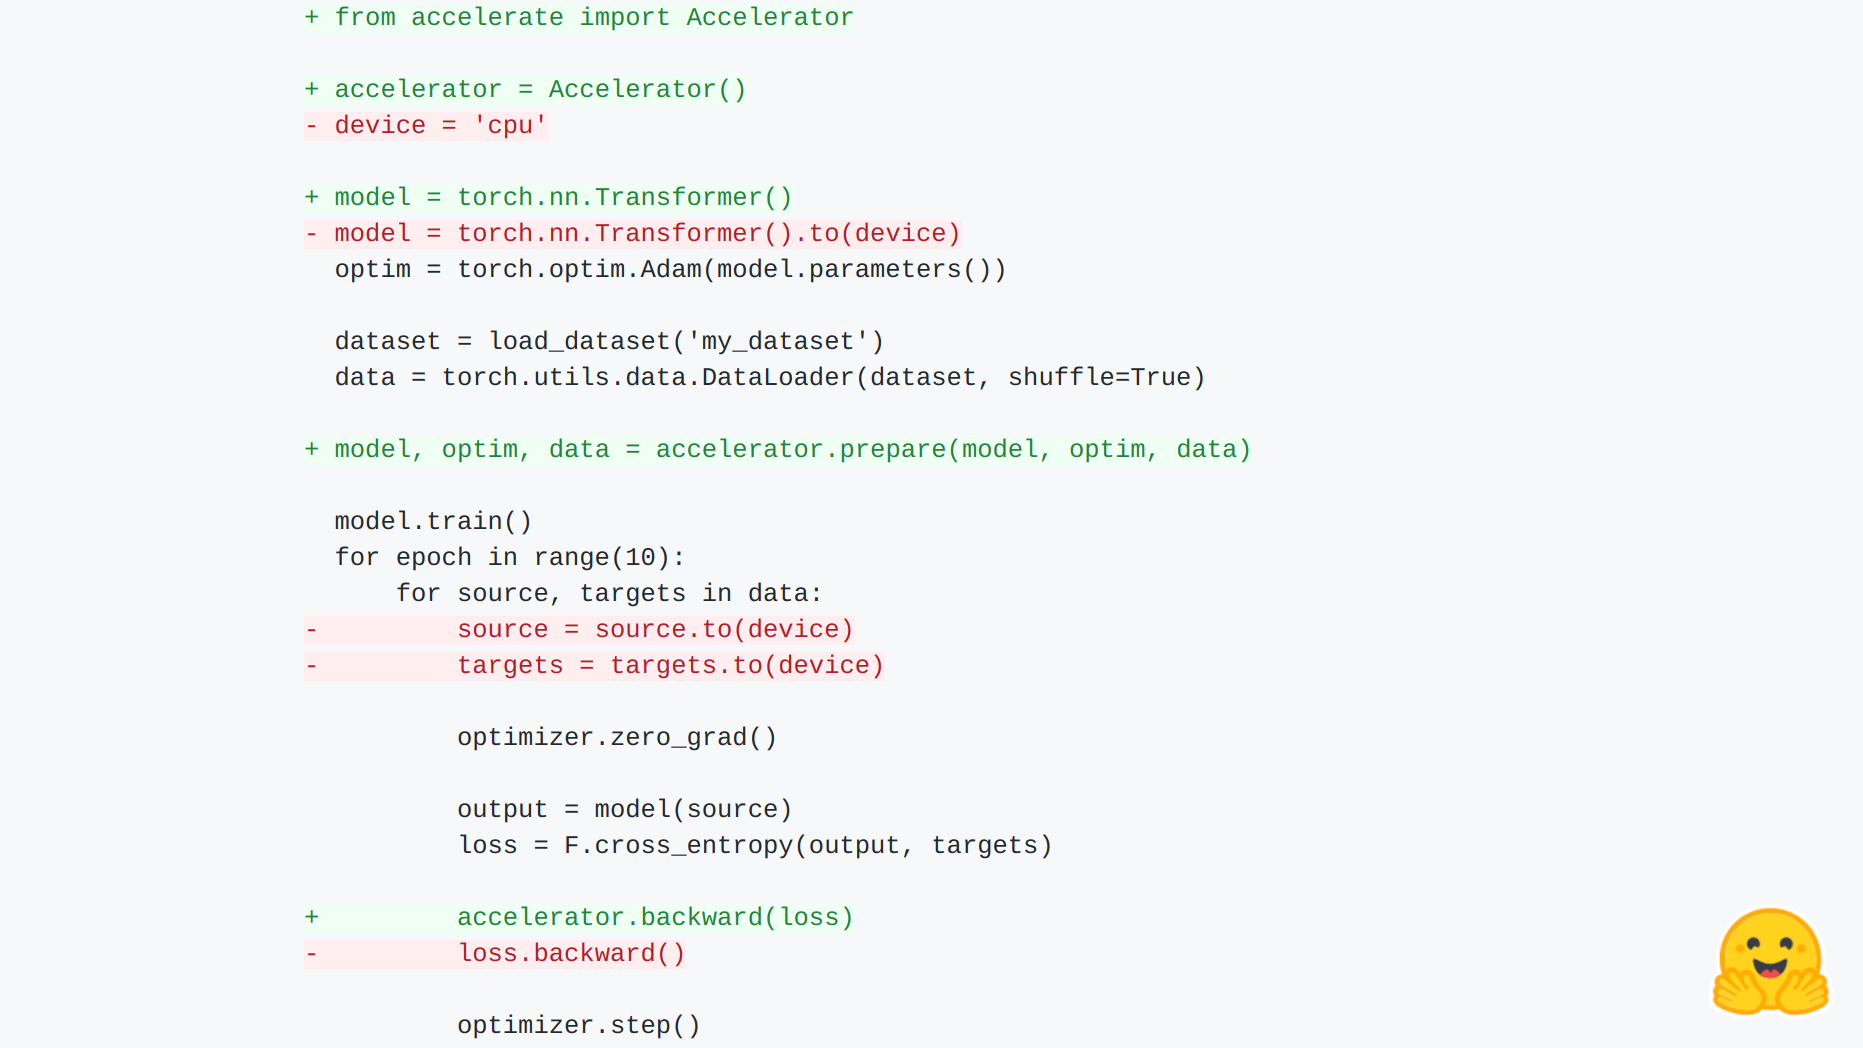
🤗 Accelerate: გაამარტივეთ PyTorch-ის განაწილებული ტრენინგი სრული კონტროლის შენარჩუნებით
🤗 Accelerate არის PyTorch-ის მომხმარებლებისთვის შექმნილი ბიბლიოთეკა, რომელიც ამარტივებს განაწილებული ტრენინგისა და შერეული სიზუსტის გამოყენებას. ის საშუალებას აძლევს მომხმარებლებს, სრულად აკონტროლონ თავიანთი სავარჯიშო ციკლები, თავიდან აიცილონ რთული შაბლონური კოდის წერა და მარტივად გაუშვან სკრიპტები სხვადასხვა მოწყობილობაზე (მრავალ-GPU, TPU) მინიმალური ცვლილებებით. ბიბლიოთეკა აბსტრაგირებს რუტინულ კოდს და უზრუნველყოფს მარტივ API-ს, რაც გაცილებით მოსახერხებელს ხდის რთული ტრენინგის კონფიგურაციებს.
DeDLOC: რევოლუციური მეთოდი ხელოვნური ინტელექტის კოლაბორაციული წვრთნისთვის
წარმოგიდგენთ DeDLOC-ს — ახალ მეთოდს კოლაბორაციული განაწილებული სწავლებისთვის, რომელსაც შეუძლია მოერგოს მონაწილეთა ქსელურ და აპარატურულ შეზღუდვებს. ჩვენ ვაჩვენებთ, რომ ის წარმატებით გამოიყენება რეალურ სცენარებში: 40 მოხალისის დახმარებით წინასწარ გაიწრთვნა sahajBERT, ბენგალური ენის მოდელი, რომელმაც მიაღწია თითქმის უახლეს ხარისხს, გაცილებით დიდ მოდელებთან შედარებით, რომლებიც ასობით მაღალი კლასის ამაჩქარებელს იყენებენ. ეს მეთოდი გვთავაზობს გამოსავალს ხელოვნური ინტელექტის მოდელების წვრთნის მაღალი ღირ
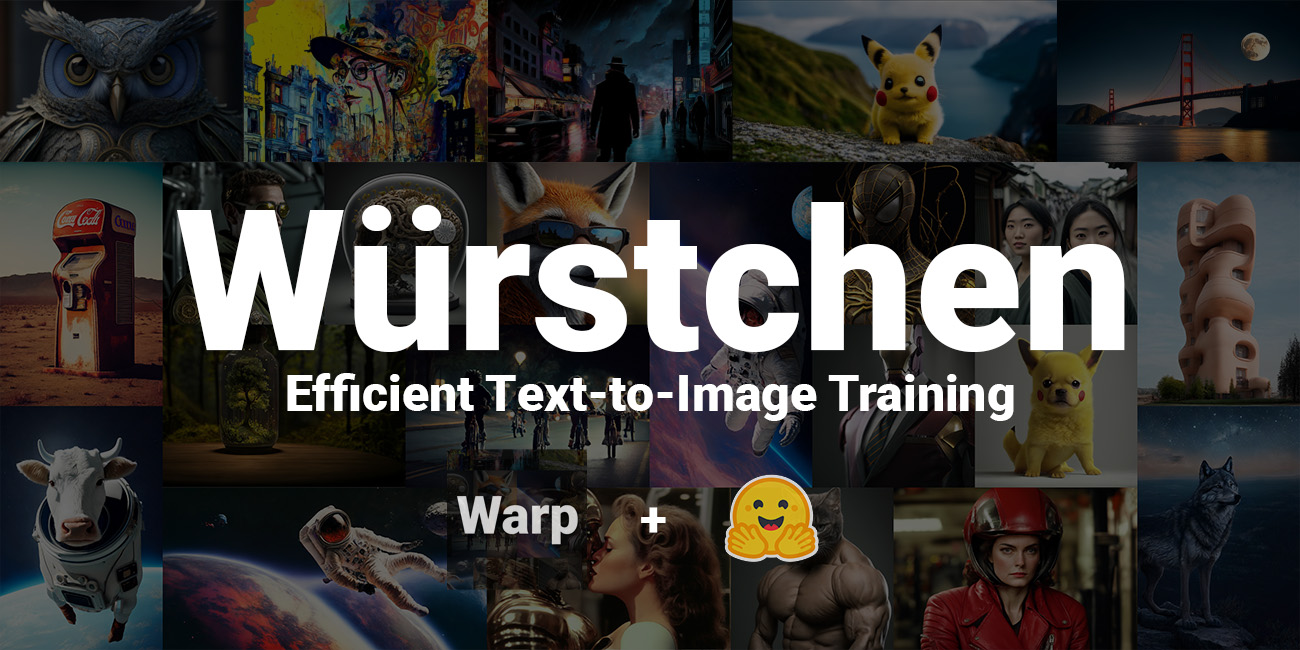
Würstchen: ინოვაციური დიფუზიური მოდელი რეკორდული კომპრესიით, რომელიც რევოლუციას ახდენს გამოსახულების გენერაციაში
Würstchen წარმოადგენს დიფუზიურ მოდელს, რომელიც გამოსახულების გენერაციას ახორციელებს უკიდურესად შეკუმშულ ლატენტურ სივრცეში, აღწევს რა 42x სივრცულ კომპრესიას – მიღწევა, რომელიც აქამდე შეუძლებლად ითვლებოდა. ეს საშუალებას აძლევს მას შექმნას მაღალი ხარისხის გამოსახულებები გაცილებით სწრაფად და ნაკლები რესურსებით, ვიდრე არსებული წამყვანი მოდელები, როგორიცაა Stable Diffusion XL, რაც მნიშვნელოვნად ამცირებს როგორც მოდელის ვარჯიშის, ისე ინფერენციის (შედეგების მიღების) ხარჯებს.
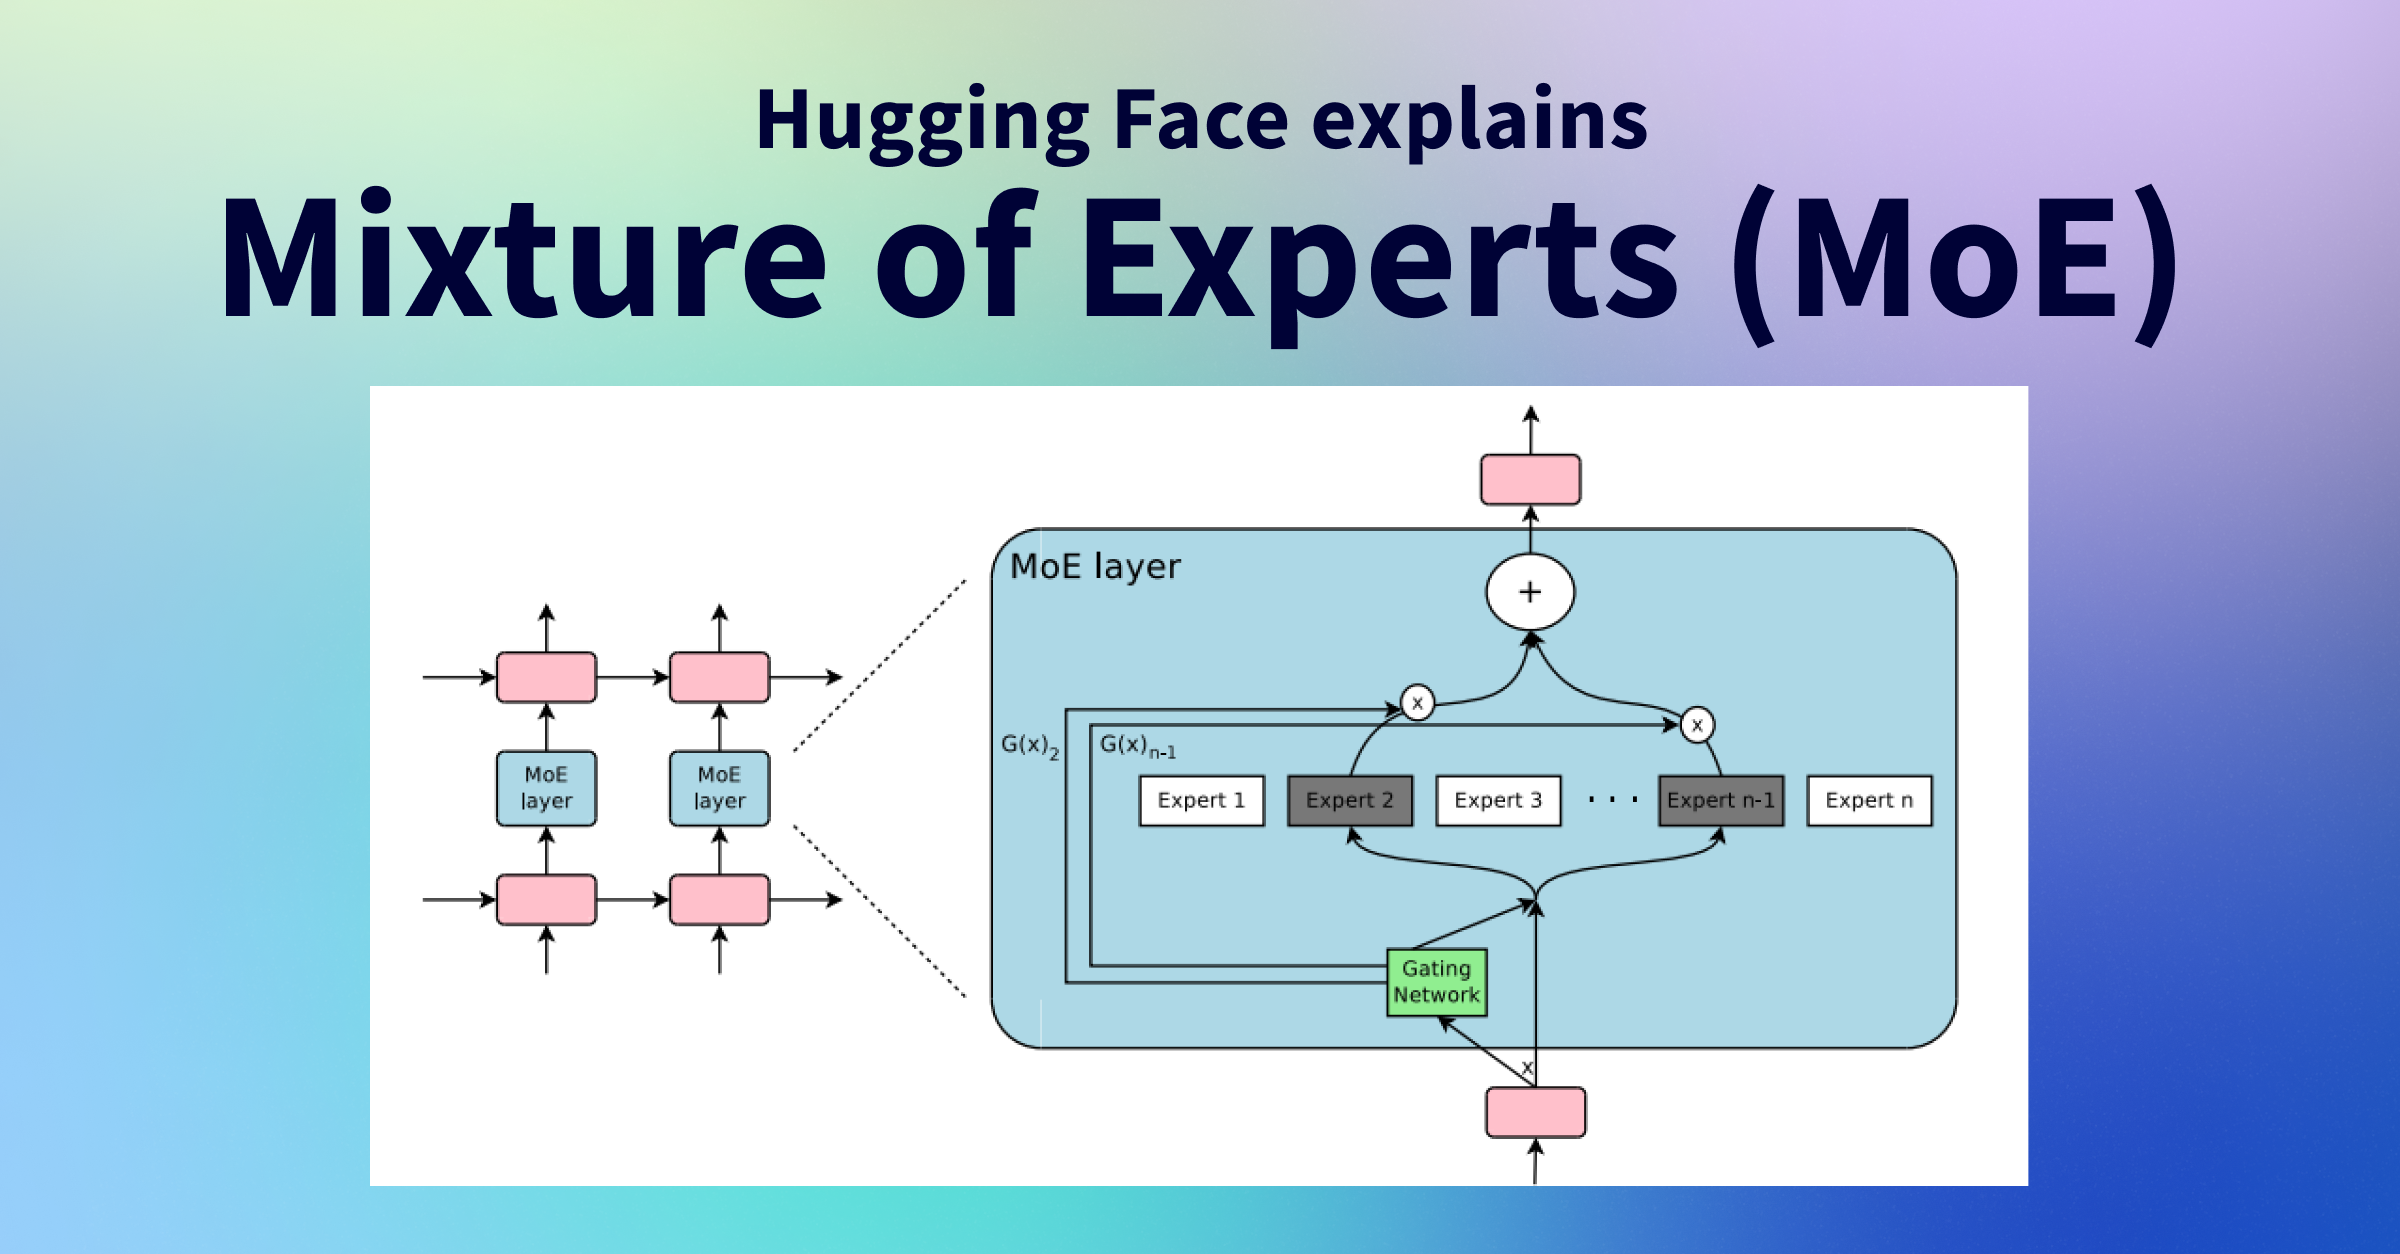
ექსპერტთა ნაზავი (MoEs): სიღრმისეული მიმოხილვა და იშვიათი მოდელების როლი
ექსპერტთა ნაზავი (MoEs) წარმოადგენს მნიშვნელოვან მიღწევას ხელოვნურ ინტელექტში, რომელიც საშუალებას აძლევს მოდელებს, მიაღწიონ უკეთეს ხარისხს გაცილებით ნაკლები გამოთვლითი რესურსებით. MoEs-ის მეშვეობით შესაძლებელია მოდელის ან მონაცემთა ნაკრების ზომის მნიშვნელოვნად გაზრდა მკვრივ მოდელებთან შედარებით, ერთი და იგივე ბიუჯეტის პირობებში, რაც უზრუნველყოფს უფრო სწრაფ წინასწარ წვრთნას. სტატია განმარტავს MoE-ის კონცეფციას ტრანსფორმერული მოდელების კონტექსტში, განიხილავს მის შემადგენელ ნაწილებს (კარიბჭის ქსელი
ღრმა გაძლიერებითი სწავლება: პროქსიმალური პოლიტიკის ოპტიმიზაცია (PPO)
ეს სტატია ღრმა გაძლიერებითი სწავლების კურსის ნაწილია და დეტალურად განიხილავს პროქსიმალური პოლიტიკის ოპტიმიზაციას (PPO). PPO არის არქიტექტურა, რომელიც აუმჯობესებს აგენტის ვარჯიშის სტაბილურობას პოლიტიკის გადაჭარბებული განახლებების თავიდან აცილებით. ჩვენ შევისწავლით, თუ როგორ იყენებს PPO მიმდინარე და ძველი პოლიტიკის თანაფარდობის კლიპინგს სტაბილური განახლებების უზრუნველსაყოფად. თეორიის შემდეგ, სტატია წარმოგიდგენთ PPO არქიტექტურის ნულიდან დაწერას PyTorch-ის გამოყენებით, მაგალითად CartPole-v1-სა და Lu
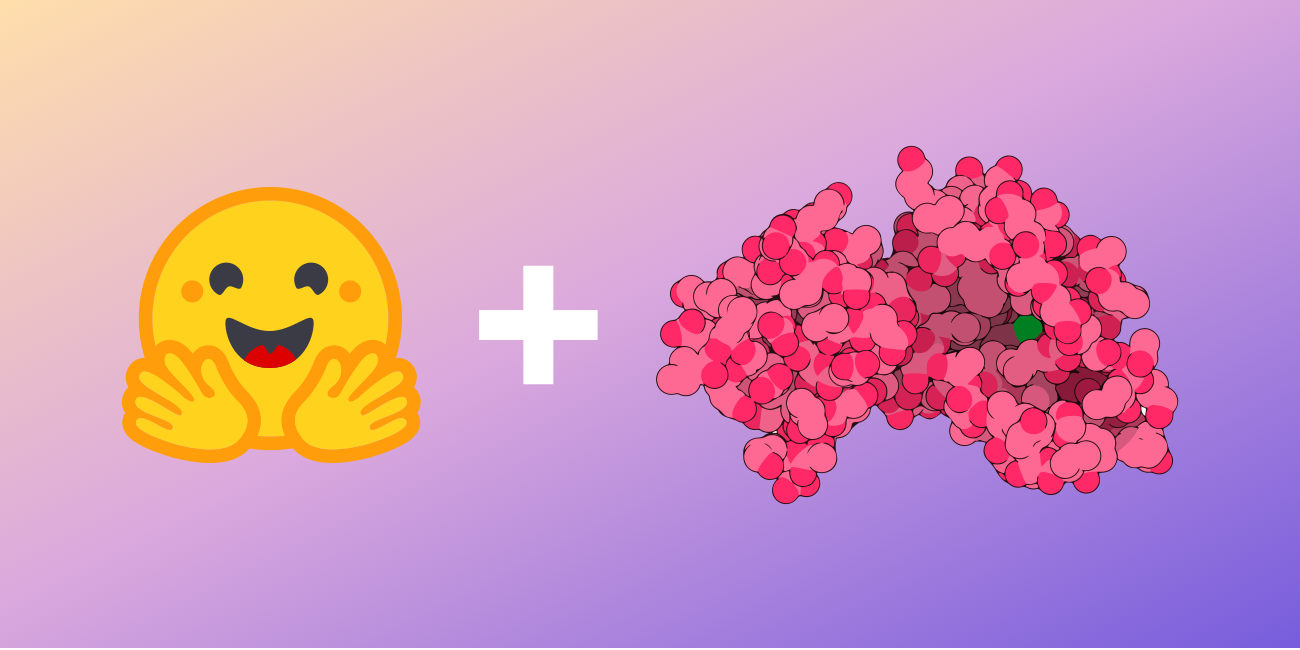
როგორ მოვახდინოთ ცილების სტრუქტურის ვიზუალიზაცია Hugging Face Spaces-ში 3Dmol.js-ის გამოყენებით
ამ სტატიაში აღწერილია, თუ როგორ შეიძლება ცილის სტრუქტურების ინტერაქტიული ვიზუალიზაცია Hugging Face Spaces-ში 3Dmol.js ბიბლიოთეკისა და Gradio-ს გამოყენებით. ცილები სასიცოცხლოდ მნიშვნელოვანია, ხოლო მანქანური სწავლა გვეხმარება ახალი ცილების შექმნაში. სტრუქტურის გაგება გადამწყვეტია მათი ფუნქციისთვის. სტატია დეტალურად განიხილავს დემო აპლიკაციის შექმნას PDB კოდის ან ფაილის გამოყენებით, ტექნიკურ ასპექტებს iframe-ებით და ბრაუზერის უსაფრთხოების წესებს. მოცემულია ინტეგრაციის მეთოდები ML მოდელებთან და მოწი
SetFit: ეფექტური ჩარჩო Sentence Transformers-ის მცირემონაცემიან პირობებში დაზუსტებისთვის
Hugging Face, Intel Labs-თან და UKP Lab-თან პარტნიორობით, წარმოგიდგენთ SetFit-ს – ინოვაციურ ჩარჩოს Sentence Transformers-ის მცირემონაცემიან პირობებში ეფექტური დაზუსტებისთვის. SetFit აღწევს მაღალ სიზუსტეს მინიმალური მარკირებული მონაცემებით, არის სწრაფი საწვრთნელად, მრავალენოვანი და არ საჭიროებს პრომპტებს, რაც მას კონკურენტუნარიანს ხდის გაცილებით დიდ მოდელებთან შედარებით და მნიშვნელოვნად ამცირებს ღირებულებას. ის მდგრადია ხმაურის მიმართ და მნიშვნელოვნად უფრო ეფექტურად იყენებს მონაცემებს, ვიდრე სტან
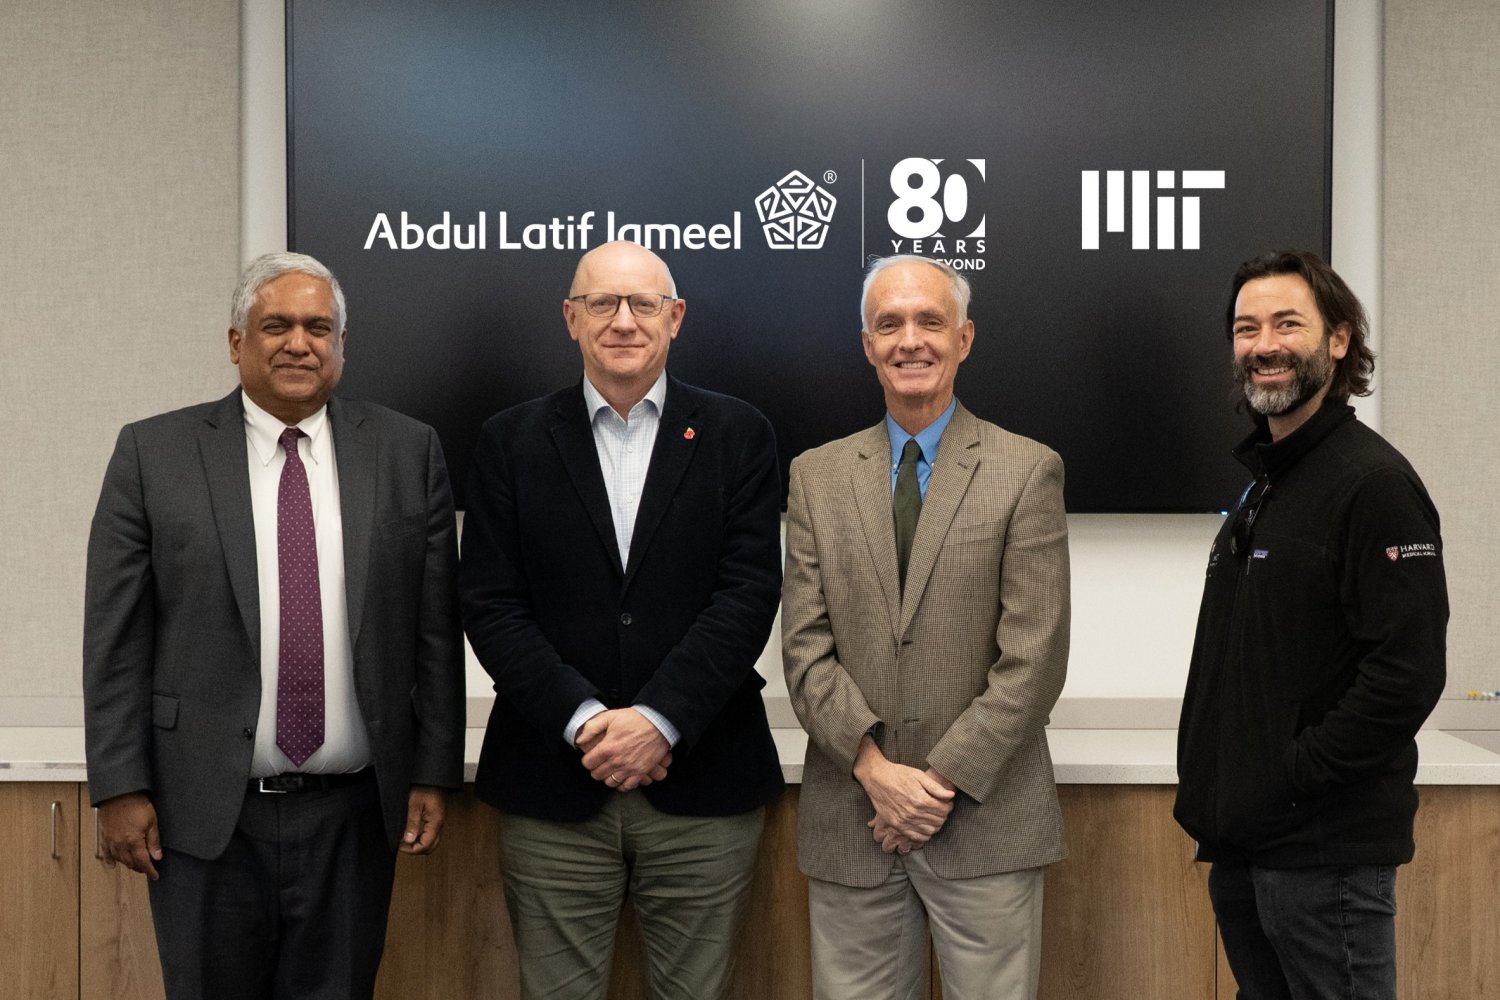
MIT-ის მკვლევარი AMR-ის წინააღმდეგ სინთეზურ ბიოლოგიასა და ხელოვნურ ინტელექტს იყენებს
MIT-ის პროფესორი ჯეიმს ჯ. კოლინზი მრავალდისციპლინურ კვლევით პროექტს უძღვება, რომელიც ანტიმიკრობული რეზისტენტობის (AMR) მზარდი გლობალური საფრთხის წინააღმდეგ სინთეზურ ბიოლოგიასა და გენერაციულ ხელოვნურ ინტელექტს იყენებს. Jameel Research-ის მიერ დაფინანსებული 3-წლიანი, 3 მილიონი დოლარის ღირებულების პროექტი მიზნად ისახავს პროგრამირებადი ანტიბაქტერიულების შემუშავებას ძირითადი პათოგენების წინააღმდეგ. კვლევა ფოკუსირებულია ხელოვნური ინტელექტის გამოყენებით მცირე ცილების შექმნაზე, რომლებიც მიზანმიმართულად
MIT-ის მკვლევრებმა LLM-ების გამოთვლითი ეფექტურობის გასაუმჯობესებლად უფრო ჭკვიანი მეთოდი შეიმუშავეს
დიდი ენობრივი მოდელებისთვის (LLM) არსებული მიდგომები ფიქსირებულ გამოთვლით ბიუჯეტს იყენებს, რაც რესურსების ფლანგვას ან რთული ამოცანების გადაჭრის შეუძლებლობას იწვევს. MIT-ის მკვლევრებმა შეიმუშავეს მეთოდი, რომელიც მოდელს საშუალებას აძლევს, დინამიურად დაარეგულიროს გამოთვლითი ბიუჯეტი კითხვის სირთულის მიხედვით. ამ სიახლემ LLM-ებს საშუალება მისცა, შეენარჩუნებინათ მსგავსი სიზუსტე, თუმცა გამოეყენებინათ გაცილებით ნაკლები გამოთვლითი რესურსი, ასევე ხელი შეუწყო მცირე ზომის მოდელებს, რთულ ამოცანებზე დიდ მოდელ