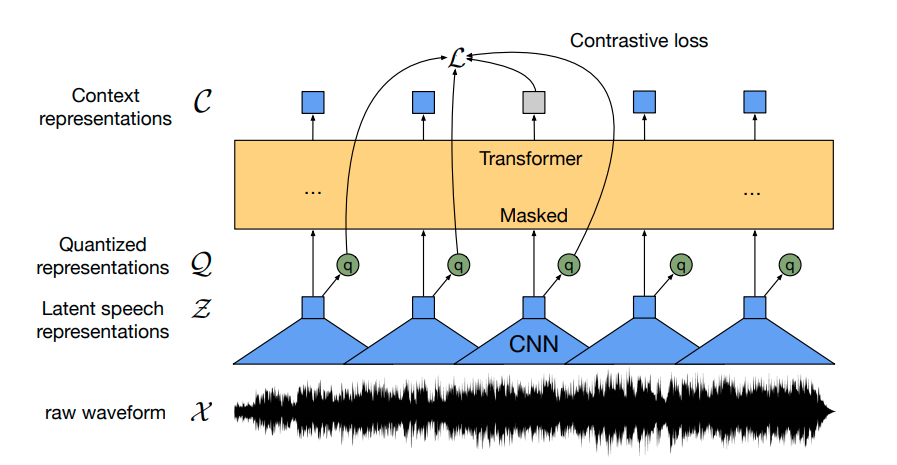
Wav2Vec2: გარღვევა მეტყველების ამოცნობაში მინიმალური მარკირებული მონაცემებით
Wav2Vec2, რევოლუციური ხელოვნური ინტელექტის მოდელი, სწავლობს მეტყველების მძლავრ წარმოდგენებს დიდი მოცულობის არამარკირებული აუდიო მონაცემებიდან, კონტრასტული წინასწარი ვარჯიშის ინოვაციური მეთოდის გამოყენებით. მან აჩვენა უპრეცედენტო შედეგები ავტომატური მეტყველების ამოცნობის (ASR) სფეროში, მიაღწია უმაღლეს დონეს მაშინაც კი, როდესაც დამატებითი ვარჯიში (fine-tuning) ხდება სულ რაღაც 10 წუთის მარკირებულ მეტყველების მონაცემებზე. ეს მას ქმნის მაღალეფექტურ გადაწყვეტილებად ძლიერი ASR სისტემების შესაქმნელად, რ

ფალკონ-ეჯის სერია: ახალი სიტყვა ენობრივ მოდელებში ბიტნეტის არქიტექტურით
ახალი Falcon-Edge სერია წარმოადგენს მძლავრ ენობრივ მოდელებს, რომლებიც BitNet არქიტექტურაზეა დაფუძნებული. ეს მოდელები ინოვაციური წინასწარი ვარჯიშის პარადიგმის წყალობით ერთდროულად აწარმოებენ არაკვანტიზებულ და კვანტიზებულ ვარიანტებს. ისინი გამოირჩევიან ეფექტურობით, „მატრიცული გამრავლების გარეშე“ დიზაინით და ხელმისაწვდომია 1 მილიარდი და 3 მილიარდი პარამეტრის ზომებში, რაც მომხმარებლებს საშუალებას აძლევს მარტივად მოარგონ ისინი საკუთარ საჭიროებებს.
TAPEX: რევოლუციური მიდგომა ცხრილის წინასწარი ვარჯიშისთვის ნერვული SQL შემსრულებლის მეშვეობით
ნაშრომში „TAPEX: ცხრილის წინასწარი ვარჯიში ნერვული SQL შემსრულებლის სწავლით“ წარმოდგენილია ინოვაციური მეთოდი, რომელიც იყენებს სინთეზურ მონაცემებს და ნერვულ SQL შემსრულებელს ცხრილების წინასწარი ვარჯიშისთვის. ეს მიდგომა უზრუნველყოფს პროგრამების მრავალფეროვნებასა და მასშტაბს, რაც გაუვალია ბუნებრივი ენის მოდელებისთვის. TAPEX-მა აჩვენა რეკორდული შედეგები სხვადასხვა ამოცანებზე, მათ შორის ცხრილის კითხვებზე პასუხის გაცემასა და ფაქტების გადამოწმებაზე, რითაც მნიშვნელოვნად აჯობა წინა მეთოდებს და მიაღწია 50

SmolLM3: მაღალი წარმადობა 3 მილიარდ პარამეტრზე და ინოვაციური საინჟინრო გეგმა
ახალი 3 მილიარდპარამეტრიანი ენობრივი მოდელი, SmolLM3, აჭარბებს კონკურენტებს, როგორიცაა Llama-3.2-3B და Qwen2.5-3B, ამასთანავე, კონკურენტუნარიანია უფრო დიდ 4 მილიარდპარამეტრიან მოდელებთან (Qwen3 და Gemma3). მისი შემქმნელები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას, არქიტექტურულ დეტალებს, მონაცემთა ნარევებსა და სამსაფეხურიან წინასწარი ვარჯიშის სტრატეგიას. ეს გამჭვირვალე მიდგომა, რომელიც მოიცავს ისეთ ინოვაციებს, როგორიცაა Grouped Query Attention (GQA) და NoPE, მიზნად ისახავს AI საზოგადოებისთვ
ხელოვნური ინტელექტი: როგორ მოვამზადოთ BERT მოდელი Habana Gaudi-ზე AWS-ის გამოყენებით
Google AI Language-ის მიერ შემუშავებული BERT მოდელის წინასწარი ვარჯიში, რომელიც გადამწყვეტია ბუნებრივი ენის დამუშავებისთვის, მოითხოვს მონაცემთა ეფექტურ მომზადებას და ტოკენიზაციას. ეს სტატია განმარტავს პროცესს, მათ შორის CPU-ინტენსიური ამოცანების ოპტიმიზაციას და Habana Gaudi-ს ინსტანციების გამოყენებას AWS-ზე განაწილებული ვარჯიშისთვის, რაც აუმჯობესებს მოდელის მუშაობას.