გაძლიერებითი სწავლის (RL) გამოყენება დიფუზიური მოდელების გასაუმჯობესებლად: DDPO-ს როლი ხელოვნური ინტელექტის მიერ შექმნილი გამოსახულებების ადამიანურ პრეფერენციებთან შესაბამისობაში
სტატია განიხილავს, თუ როგორ ხდება დიფუზიური მოდელების (მაგ. DALL-E 2, Stable Diffusion) ოპტიმიზაცია გაძლიერებითი სწავლის (RL) გამოყენებით, რათა მათ მიერ გენერირებული გამოსახულებები უკეთესად შეესაბამებოდეს ადამიანის პრეფერენციებსა და ესთეტიკას. ის მიმოიხილავს "შესაბამისობის პრობლემას" ხელოვნურ ინტელექტში და წარმოაჩენს Denoising Diffusion Policy Optimization (DDPO) მეთოდს, როგორც ეფექტურ გადაწყვეტას. DDPO, რომელიც იყენებს პოლიტიკის გრადიენტულ მეთოდებს (PPO) და დენოიზინგის პროცესს მარკოვის გადაწყვე

დიდი ML მოდელების სწავლება: FullyShardedDataParallel (FSDP) შესაძლებლობები
მანქანური სწავლების (ML) მოდელების მუდმივად მზარდი მასშტაბები აპარატურულ შეზღუდვებს წარმოქმნის. ეს სტატია იკვლევს, თუ როგორ უმკლავდება განაწილებული სწავლება, კერძოდ PyTorch-ის FullyShardedDataParallel (FSDP) ფუნქცია, ამ გამოწვევას. ჩვენ ვადარებთ FSDP-ის წარმადობას DDP-სთან GPT-2 მოდელების გამოყენებით, ვაჩვენებთ FSDP-ის უნარს, მოახდინოს უფრო დიდი პაკეტის ზომების დამუშავება და კიდევ უფრო დიდი მოდელების სწავლება, რითაც ხელმისაწვდომს ხდის მძლავრ ML ტექნოლოგიებს.
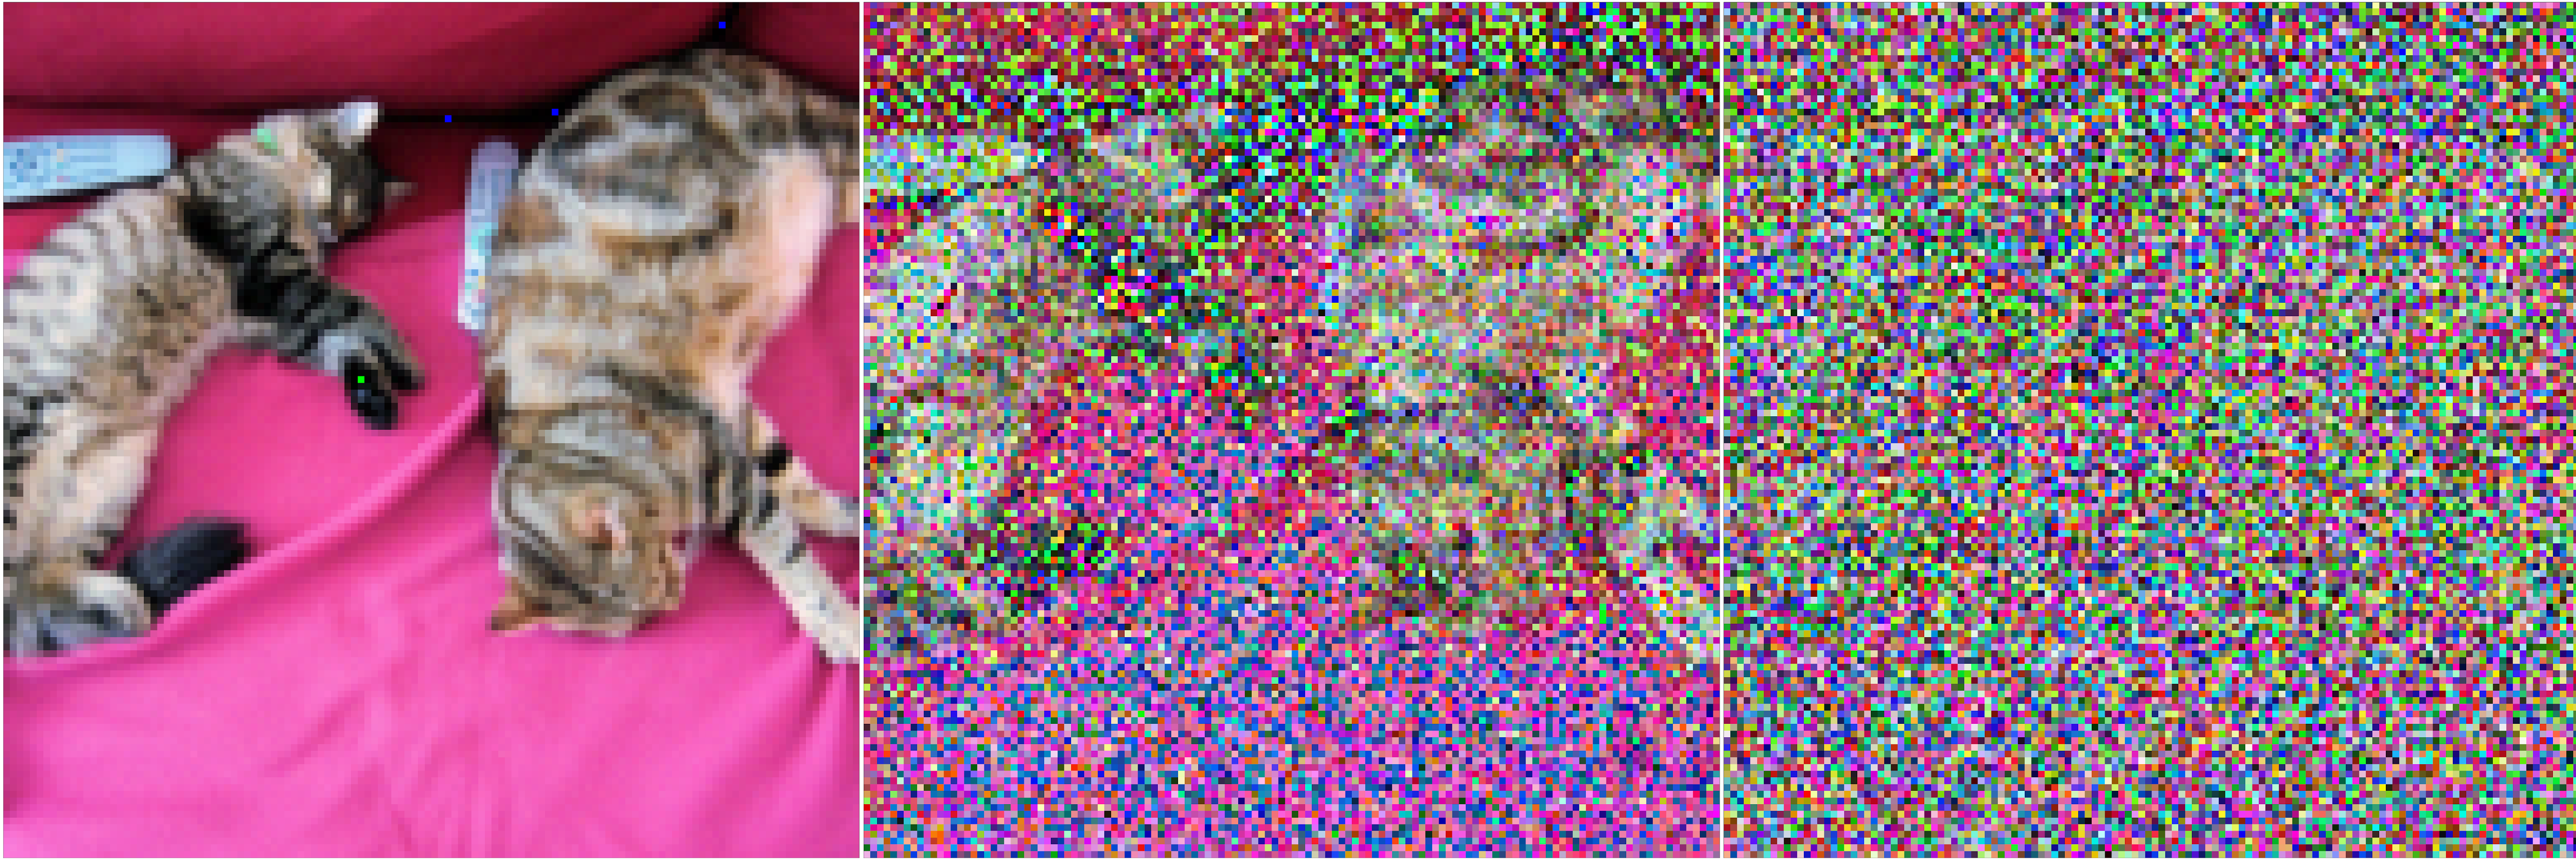
დენოიზინგ დიფუზიური ალბათური მოდელები (DDPM): კონცეფციიდან იმპლემენტაციამდე PyTorch-ში
ეს სტატია განიხილავს Ho et al.-ის (2020) ორიგინალური ნაშრომის მიხედვით დენოიზინგ დიფუზიურ ალბათურ მოდელებს (DDPM) და მათ ნაბიჯ-ნაბიჯ იმპლემენტაციას PyTorch-ში. იგი აშუქებს დიფუზიური მოდელების ისტორიულ კონტექსტს, მათ მათემატიკურ საფუძვლებს და ხსნის როგორც პირდაპირ, ასევე შებრუნებულ პროცესებს, რომლებიც საშუალებას აძლევს ნერვულ ქსელს გარდაქმნას ხმაურიანი მონაცემები რეალურ ნიმუშებად.

OOM შეცდომები წარსულს ჩაბარდა: დიდი მოდელების ვარჯიში DeepSpeed ZeRO-სა და Accelerate-ით
სტატია განმარტავს, თუ როგორ შეიძლება თავიდან ავიცილოთ მეხსიერების უკმარისობის (OOM) შეცდომები დიდი ხელოვნური ინტელექტის მოდელების ვარჯიშისას. იგი აღწერს DeepSpeed ZeRO ოპტიმიზატორის გამოყენებას Accelerate ბიბლიოთეკასთან ერთად, რაც საშუალებას იძლევა, ეფექტურად გამოვიყენოთ არსებული აპარატურა, გავზარდოთ პაკეტის ზომა და დავაჩქაროთ ვარჯიშის პროცესი. წარმოდგენილია შედარებები DDP-სა და DeepSpeed ZeRO Stage-2-ს შორის, რაც აჩვენებს მნიშვნელოვან გაუმჯობესებას შესრულებაში.
PyTorch-ის განაწილებული წვრთნა: DDP-დან Accelerate-მდე
ეს სტატია განიხილავს PyTorch-ში მრავალ GPU-ზე მოდელის წვრთნის პროცესს Distributed Data Parallelism (DDP) მექანიზმის გამოყენებით. მოცემულია საბაზისო კოდის მაგალითები და ნაჩვენებია, თუ როგორ ამარტივებს `torch.distributed` და შემდგომში `Accelerate` ბიბლიოთეკა ამ პროცესს, რაც საშუალებას იძლევა ეფექტური განაწილებული წვრთნისთვის კოდის მინიმალური ცვლილებებით. ასევე განხილულია მონაცემთა მილსადენის გაუმჯობესება და Jupyter Notebook-თან ინტეგრაცია.