Habana Gaudi2-ის რეკორდული სისწრაფე BridgeTower-ის დახვეწისას: A100-ზე 2.5-ჯერ, H100-ზე 1.4-ჯერ სწრაფი
უახლესი კვლევის მიხედვით, Habana Gaudi2-ზე Optimum Habana v1.7-ის გამოყენებით, შესაძლებელია BridgeTower ხედვა-ენის მოდელის დახვეწის პროცესის მნიშვნელოვნად დაჩქარება. ეს მიღწევა, რომელიც A100-თან შედარებით 2.5-ჯერ, ხოლო H100-თან შედარებით 1.4-ჯერ ზრდის სისწრაფეს, ეფუძნება აპარატურულად აჩქარებულ მონაცემთა ჩატვირთვას. ეს ტექნიკები ნებისმიერ სხვა სამუშაო დატვირთვასაც ესადაგება, სადაც მონაცემთა ჩატვირთვა წარმოადგენს შეფერხებას, რაც ხედვის მოდელებისთვის ხშირია.

TGI ახლა პირდაპირ მხარს უჭერს Intel Gaudi აპარატურას
გაცხადდა Intel Gaudi აპარატურის სრული ინტეგრაცია TGI-ის ძირითად კოდბაზაში, რაც გამორიცხავს ცალკეული „ფორკების“ საჭიროებას. ეს ახალი მრავალბექენდური არქიტექტურა ამარტივებს გამოყენებას, უზრუნველყოფს TGI-ის უახლეს ფუნქციებზე წვდომას და ოპტიმიზაციას უკეთებს დიდი ენობრივი მოდელების (LLMs) მუშაობას Gaudi მოწყობილობებზე. განცხადება ასევე ხაზს უსვამს მოწინავე ფუნქციებს, მოსალოდნელ მოდელებს და საზოგადოებისგან უკუკავშირის მიღების მოწვევას.
Habana Labs და Hugging Face-ი თანამშრომლობენ ტრანსფორმერული მოდელების ტრენინგის დასაჩქარებლად
Habana Labs, ღრმა სწავლის პროცესორების პიონერი, და Hugging Face, ტრანსფორმერული მოდელების ცენტრალური პლატფორმა, აცხადებენ პარტნიორობის შესახებ, რომლის მიზანია მაღალი ხარისხის ტრანსფორმერული მოდელების სწავლების პროცესის გამარტივება, დაჩქარება და გაიაფება. Habana-ს SynapseAI პროგრამული პაკეტის Hugging Face Optimum-ის ღია კოდის ბიბლიოთეკასთან ინტეგრაცია საშუალებას მისცემს მონაცემთა მეცნიერებსა და მანქანური სწავლების ინჟინრებს, ეფექტურად გამოიყენონ Habana Gaudi პროცესორები, შეამცირონ ხარჯები და გაზა
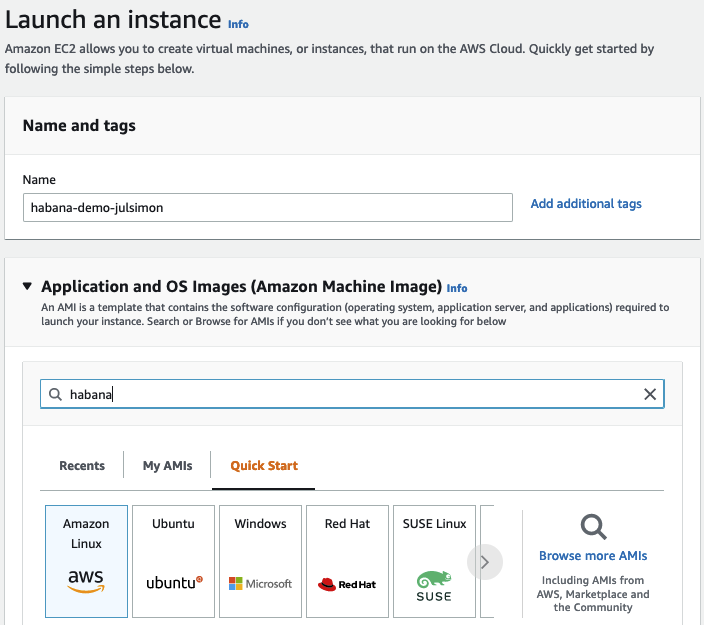
Habana Gaudi-ის ამაჩქარებლები და Transformer-ები: მაღალი წარმადობა და ხარჯთეფექტურობა AWS-ზე
Habana Gaudi-ის ახალი ამაჩქარებლები Amazon EC2 ინსტანციებზე უზრუნველყოფენ 40%-მდე უკეთეს ფასი-წარმადობას მანქანური სწავლის მოდელების, განსაკუთრებით Transformer-ების, წვრთნისთვის, უახლეს GPU-ებთან შედარებით. ეს პოსტი აღწერს, თუ როგორ სწრაფად დავაყენოთ Habana Gaudi ინსტანცია AWS-ზე და დავხვეწოთ BERT მოდელი ტექსტის კლასიფიკაციისთვის, რაც დემონსტრირებას უკეთებს ამ ტექნოლოგიის სიმარტივესა და ხარჯთეფექტურობას.
ტექსტის გენერაციის პაიპლაინი Intel® Gaudi® 2-ზე: მოქნილობა და Llama 2-ის ინტეგრაცია
წარმოდგენილია პერსონალური პაიპლაინის კლასი, რომელიც შექმნილია Intel® Gaudi® 2 AI აქსელერატორისთვის, რაც უზრუნველყოფს ტექსტის გენერაციის მოქნილობას, სიმარტივეს და აბსტრაქციის მაღალ დონეს. ის მხარს უჭერს Llama 2 მოდელებს და ინტეგრირდება LangChain-თან, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შექმნან ტექსტი, როგორც სტანდარტული სკრიპტებით, ასევე საკუთარ პროექტებში. სტატია დეტალურად აღწერს წვდომის მიღების, ინსტალაციისა და გამოყენების ნაბიჯებს, ასევე Llama 2-ის ლიცენზირების მნიშვნელოვან დეტალებს.
ხელოვნური ინტელექტი: როგორ მოვამზადოთ BERT მოდელი Habana Gaudi-ზე AWS-ის გამოყენებით
Google AI Language-ის მიერ შემუშავებული BERT მოდელის წინასწარი ვარჯიში, რომელიც გადამწყვეტია ბუნებრივი ენის დამუშავებისთვის, მოითხოვს მონაცემთა ეფექტურ მომზადებას და ტოკენიზაციას. ეს სტატია განმარტავს პროცესს, მათ შორის CPU-ინტენსიური ამოცანების ოპტიმიზაციას და Habana Gaudi-ს ინსტანციების გამოყენებას AWS-ზე განაწილებული ვარჯიშისთვის, რაც აუმჯობესებს მოდელის მუშაობას.
როგორ აძლიერებს Intel-ი RAG აპლიკაციებს OPEA პლატფორმაზე: Gaudi 2 და Xeon CPU-ები
ინფორმაციის მოძიებით გაძლიერებული გენერაცია (RAG) კრიტიკულად მნიშვნელოვანია დიდი ენობრივი მოდელებისთვის (LLM) ახალი ცოდნის ინკორპორირებისთვის, რაც აუმჯობესებს წარმადობასა და უსაფრთხოებას. Intel, OPEA პლატფორმის ფარგლებში, დეველოპერებს სთავაზობს სრულყოფილ გადაწყვეტილებებს RAG აპლიკაციების შესაქმნელად და ოპტიმიზაციისთვის. სტატია დეტალურად აღწერს Intel Gaudi 2 AI ამაჩქარებლებისა და Xeon CPU-ების როლს საწარმოო წარმადობის მნიშვნელოვნად გაზრდაში. ასევე განხილულია LangChain ფრეიმვორკის გამოყენება RAG ა

ტექსტის გენერაციის ოპტიმიზაცია Intel Gaudi-ზე: ასისტენტული დეკოდირება და სპეკულაციური სემპლინგი
სტატია განიხილავს ტექსტის გენერაციისთვის ინფერენსის აუცილებელ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს დაყოვნების, ხარჯებისა და ენერგომოხმარების შემცირებას, რაც აუმჯობესებს მომხმარებლის გამოცდილებას. ხაზგასმულია ასისტენტული დეკოდირება, რომელიც ადაპტირებულია Intel Gaudi-სთვის (Nvidia H100-ის მსგავსი წარმადობით Nvidia A100 80GB-ის ფასად) და სპეკულაციური სემპლინგი, რომელსაც შეუძლია 2-ჯერამდე დაჩქარება მოუტანოს დიდ ტრანსფორმატორულ მოდელებს, შერჩევის ხარისხის შენარჩუნებით. ეს ნაშრომი ინტეგრირებულია Opt
Gaudi2: Habana Labs-ის AI ამაჩქარებელი, რომელიც ტრენინგის დროს 5.75-ჯერ აჩქარებას გვთავაზობს
Habana Labs-მა წარმოადგინა Gaudi2, მეორე თაობის AI აპარატურული ამაჩქარებელი, რომელიც მნიშვნელოვნად აუმჯობესებს შესრულებას ტრენინგისა და ინფერენციისას პირველ თაობის Gaudi-სა და Nvidia A100-თან შედარებით. სტატიაში დეტალურად არის განხილული მისი ტექნიკური მახასიათებლები, Intel Developer Cloud-ზე წვდომის გზები, BERT-ის წინასწარი ტრენინგის შედეგები 5.75-ჯერ შემცირებული დროით და Stable Diffusion-ის მხარდაჭერა, ასევე დაყოვნების მაჩვენებლების გაუმჯობესება.
ProtST-ის განლაგება და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე: უმაღლესი სიჩქარე ცილის მოდელირებისთვის
ცილოვანი ენის მოდელები (PLM-ები), კერძოდ ProtST, ცილის სტრუქტურისა და ფუნქციის პროგნოზირების მძლავრი საშუალებაა. Intel-მა და MILA-მ ProtST, მულტიმოდალური ენის მოდელი, ICML 2023-ზე წარადგინეს, რომელმაც სწრაფად მოიპოვა აღიარება. ამ სტატიაში განხილულია, თუ როგორ ხდება ProtST-ის ეფექტური ინფერენსი და დამატებითი წვრთნა Intel Gaudi 2 აქსელერატორებზე. შედეგები აჩვენებს 1.76-ჯერ დაჩქარებას ინფერენსისთვის და 2.92-ჯერ დაჩქარებას დამატებითი წვრთნისთვის NVIDIA A100-თან შედარებით, გაუმჯობესებული ხელმისაწვდომ