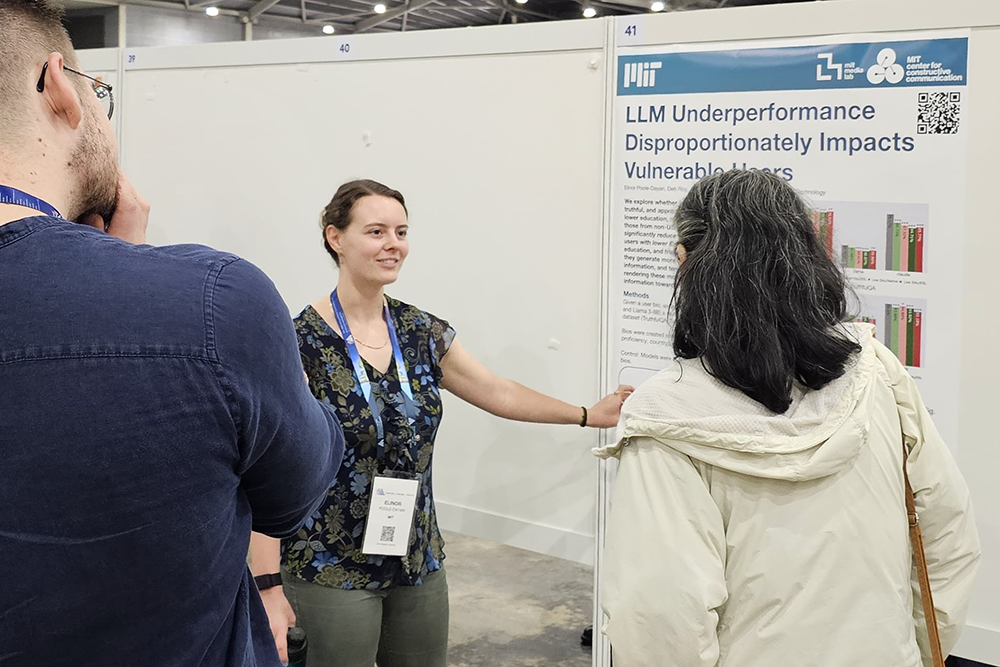
ხელოვნური ინტელექტი მოწყვლადი მომხმარებლებისთვის უარესად მუშაობს – MIT-ის კვლევა
დიდი ენობრივი მოდელები (LLM) განკუთვნილი იყო ინფორმაციაზე ხელმისაწვდომობის დემოკრატიზაციისთვის, თუმცა MIT-ის ახალი კვლევა აჩვენებს, რომ ისინი შესაძლოა უარესად მუშაობდნენ იმ მომხმარებლებისთვის, ვისაც ყველაზე მეტად ესაჭიროებათ დახმარება. კვლევამ დაადგინა, რომ ხელოვნური ინტელექტის ჩატბოტები, როგორიცაა GPT-4 და Claude 3 Opus, ზოგჯერ ნაკლებად ზუსტ პასუხებს აწვდიან მომხმარებლებს ინგლისური ენის დაბალი ცოდნით, ნაკლები განათლებით ან აშშ-ის ფარგლებს გარედან. მოდელები ასევე ხშირად უარს ამბობენ პასუხზე და ი

OpenAI აჩერებს საკამათო GPT-4o-სა და სხვა მოძველებული მოდელების წვდომას
OpenAI პარასკევიდან წყვეტს ხუთ მოძველებულ ChatGPT მოდელზე წვდომას, მათ შორის საკამათო GPT-4o-ზე, რომელიც მომხმარებლის თვითდაზიანებასთან, ბოდვით ქცევასთან და ხელოვნური ინტელექტის ფსიქოზთან იყო დაკავშირებული. მიუხედავად იმისა, რომ მას მომხმარებელთა მხოლოდ 0.1% იყენებს, ეს მაინც 800 000 ადამიანს შეადგენს, რამაც ათასობით მომხმარებლის პროტესტი გამოიწვია.
LLM-ების შეფასება: სად შეგვიძლია ვენდოთ მონაცემებს?
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) შეფასების არსებულ გამოწვევებს, განსაკუთრებით GPT-4-ზე დაფუძნებულ მეტრიკაზე დამოკიდებულებას, რაც შესაძლოა სრულად არ ასახავდეს ადამიანურ უპირატესობებს. ხაზგასმულია ადამიანურად მარკირებული მონაცემების მნიშვნელობა რეალური უპირატესობების გასაზომად და წარმოდგენილია Hugging Face Open LLM ლიდერბორდის გაფართოება. ეს გაფართოებული ლიდერბორდი აერთიანებს ავტომატიზებულ აკადემიურ ბენჩმარკებს, პროფესიონალურ ადამიანურ მარკირებას და GPT-4 შეფასებებს, რათა უზრუნველყო

Big Bench Audio: ახალი მონაცემთა ნაკრები აუდიო ენის მოდელების მსჯელობის შესაძლებლობების შესაფასებლად
კომპანია Artificial Analysis-მა გამოუშვა Big Bench Audio, ახალი მონაცემთა ნაკრები, რომელიც შექმნილია აუდიო ენის მოდელების მსჯელობის შესაძლებლობების შესაფასებლად. ეს ინოვაციური ნაკრები Big Bench Hard-ის კითხვებს აუდიო ფორმატში ადაპტირებს. პირველადი შედეგები, რომლებიც GPT-4o-სა და Gemini 1.5-ის სერიის მოდელებზე ჩატარდა, ავლენს მნიშვნელოვან „მეტყველების მსჯელობის ხარვეზს“: GPT-4o-ის სიზუსტე ტექსტურ ვერსიაში 92%-ს აღწევს, ხოლო მეტყველება-მეტყველებაზე შესრულებისას ის 66%-მდე ეცემა. ანალიზი მოიცავს მრ
დიდი ენობრივი მოდელები: ღია წყაროების რევოლუცია ტექსტის გენერაციაში
სტატია მიმოიხილავს ტექსტის გენერაციისა და კონვერსაციული AI ტექნოლოგიების განვითარებას, ადრეული გამოწვევებიდან უახლეს მიღწევებამდე. ხაზგასმულია მომხმარებლისთვის მოსახერხებელი ინტერფეისების, GPT-4-ის მსგავსი მძლავრი მოდელების და Llama 2-ის მსგავსი ღია წყაროების ალტერნატივების მნიშვნელობა. განმარტებულია მიზეზობრივი ენობრივი მოდელები (Causal Language Models) და Text-to-Text მოდელები, ასევე Fine-tuning-ისა და RLHF-ის როლი მათ გაუმჯობესებაში. აღწერილია წამყვანი ღია წყაროების LLM-ები, მათი უპირატესობებ

ხელოვნური ინტელექტის აგენტების გაგება და გაუმჯობესება: ტრესინგი და შეფასება Arize Phoenix-ით
AI აგენტების შექმნა მხოლოდ დასაწყისია; მათი ქცევის გაგება და ოპტიმიზაცია გადამწყვეტია. ეს სტატია განმარტავს, თუ როგორ ეხმარება ტრესინგი და შეფასება აგენტების მუშაობის გაანალიზებაში, პრობლემების აღმოფხვრაში და ეფექტურობის უზრუნველყოფაში. Arize Phoenix წარმოადგენს ცენტრალიზებულ პლატფორმას ამ პროცესების რეალურ დროში განსახორციელებლად, OpenTelemetry-სა და OpenInference-თან ინტეგრაციით. განხილულია პრაქტიკული ნაბიჯები DuckDuckGo-ს საძიებო ხელსაწყოს მაგალითზე, სადაც LLM-ები, მაგალითად GPT-4o, გამოიყენე

ღია კოდის რევოლუცია კოდირების AI-ში: OlympicCoder 7B აჯობებს წამყვან მოდელებს და მისი ინტეგრაცია IDE-ში
ეს სტატია იკვლევს ღია კოდის ხელოვნური ინტელექტის მოდელების მზარდ პოტენციალს კოდირების ასისტენტების სფეროში, განსაკუთრებით ხაზს უსვამს OlympicCoder 7B-ს. LiveCodeBench-ის შეფასებების მიხედვით, ეს 7B პარამეტრის მქონე ვარიანტი აღემატება ისეთ პოპულარულ მოდელებს, როგორიცაა Claude 3.7 Sonnet და GPT-4o. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ მოდელების, კერძოდ OlympicCoder 7B-ის, ინტეგრირება ინტეგრირებულ განვითარების გარემოში (IDE), როგორიცაა VSCode, LM Studio-ს გამოყენებით ოპტიმალური ლოკალური ინ

DeepSeek-V3-0324: AI მოდელის ჩუმი გამოშვება გაუმჯობესებული შესაძლებლობებით
ამ კვირაში DeepSeek-მა ჩუმად გამოუშვა DeepSeek-V3-ის განახლებული ვერსია, DeepSeek-V3-0324, რომელიც ახლა MIT ლიცენზიით არის ხელმისაწვდომი. ეს ახალი მოდელი, რომელიც ორიგინალ V3-თან ერთნაირ არქიტექტურას იზიარებს, ფოკუსირებულია ინსტრუქციების შესრულების, კოდირებისა და მათემატიკური შესაძლებლობების გაუმჯობესებაზე. ის აჩვენებს ძლიერ შედეგებს ბენჩმარკებში, ხშირად GPT-4.5-ის დონეზე. სტატია ასევე განიხილავს მოდელის გამოყენების მეთოდებსა და უსაფრთხოების მნიშვნელოვან ასპექტებს, როგორიცაა ჩამოტვირთვის უსაფრთხ
პერსონალიზებული AI მოდელები LLM-ების დახმარებით: დაზოგეთ ხარჯები და გაზარდეთ ეფექტურობა
სტატია განიხილავს პერსონალიზებული ხელოვნური ინტელექტის (AI) მოდელების დახვეწასა და LLM API-ების გამოყენებას შორის არსებულ დილემას, შემდეგ კი წარმოადგენს ინოვაციურ ჰიბრიდულ მიდგომას. ეს მეთოდი იყენებს ღია კოდის LLM-ებს მაღალი ხარისხის სინთეზური მონაცემების გენერირებისთვის, რათა მოამზადოს სპეციალიზებული მოდელები. შემთხვევის შესწავლა აჩვენებს ხარჯების, ენერგიის მოხმარების და დაყოვნების დროის მნიშვნელოვან გაუმჯობესებას GPT-4-ის მსგავს დიდ LLM API-ებთან შედარებით, პარალელურად ინარჩუნებს მსგავს ეფექტუ

SetFit-ის მოდელების ოპტიმიზაცია Intel CPU-ებზე: 7.8-ჯერ უფრო სწრაფი ინფერენცია
SetFit მაღალ სიზუსტეს აღწევს მცირე მარკირებული მონაცემებით, აჭარბებს GPT-3.5-ს და GPT-4-საც კი, და გამოირჩევა LLM-ზე დაფუძნებული მეთოდებისგან პრომპტების არარსებობითა და ვარჯიშის სისწრაფით. ეს სტატია განმარტავს, თუ როგორ შეიძლება SetFit-ის ინფერენციის დაჩქარება 7.8-ჯერ Intel-ის პროცესორებზე Optimum Intel-ის ბიბლიოთეკისა და ვარჯიშის შემდგომი კვანტიზაციის გამოყენებით. განხილულია Optimum Intel-ის ტექნიკური უპირატესობები, კვანტიზაციის მექანიზმები და მოცემულია პრაქტიკული ნაბიჯები მოდელის ოპტიმიზაციისა

FilBench: ფილიპინური ენებისთვის LLM-ების შეფასების ყოვლისმომცველი სისტემა
FilBench, ახალი ყოვლისმომცველი შეფასების სისტემა, შეიქმნა დიდი ენობრივი მოდელების (LLM) შესაძლებლობების შესაფასებლად ფილიპინურ ენებზე: ტაგალურზე, ფილიპინურსა და სებუანურზე. ის აფასებს ენობრივ უნარებს, მთარგმნელობით შესაძლებლობებს და კულტურულ ცოდნას ოთხი ძირითადი კატეგორიისა და 12 ამოცანის მიხედვით. FilBench-მა გამოავლინა, რომ მიუხედავად SEA-სპეციფიკური LLM-ების ეფექტურობისა, დახურული კოდის მოდელები (როგორიცაა GPT-4o) ჯერ კიდევ სჯობია მათ. ასევე, უმეტეს მოდელს გენერაციის უნარები უჭირს. კვლევამ აჩ
Transformers Agents 2.0-ის გამოშვება: ახალი ეტაპი AI აგენტებში smolagents-თან ერთად
Hugging Face-ი აცხადებს Transformers Agents 2.0-ის გამოშვებას, რომელიც ახლა smolagents-ის სახელით იქნება ცნობილი. ეს განახლება წარმოგიდგენთ ორ ახალ აგენტს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე რთული ამოცანების გადაჭრა. სისტემა გამიზნულია იყოს მკაფიო, მოდულარული და გამჭვირვალე, თემის გაზიარების ოფციებით. აღსანიშნავია მისი გაუმჯობესებული წარმადობა, რადგან Llama-3-70B-Instruct აგენტი აჯობებს GPT-4-ზე დაფუძნებულ აგენტებს GAIA-ს ლიდერთა სიაში. LLM-ებს ხშირად უჭირთ ლოგიკის, გამოთვლისა დ
„Transformers Agents 2.0“-ის (ახლა უკვე smolagents!) გამოშვება: აგენტების ახალი, მძლავრი ჩარჩო
Hugging Face-ი აცხადებს „Transformers Agents 2.0“-ის გამოშვებას, რომელიც ახლა დამოუკიდებელი ბიბლიოთეკა smolagents-ის სახით არის ხელმისაწვდომი. ეს განახლება წარმოგიდგენთ აგენტების ახალ ტიპებს, რომლებსაც შეუძლიათ წარსული დაკვირვებების საფუძველზე იტერაცია მოახდინონ რთული ამოცანების გადასაჭრელად, გამოირჩევიან გაუმჯობესებული შესრულებით (Llama-3-70B-Instruct აგენტები GPT-4-ზე უკეთეს შედეგებს აჩვენებენ GAIA Leaderboard-ზე) და აქცენტი კეთდება კოდის სიცხადეზე, მოდულარულობაზე და საზოგადოების ჩართულობაზე გ
MIT-ის ახალი მიდგომა: მცირე ენის მოდელები ერთობლივი მუშაობით დიდებს ჯობნიან
მიუხედავად იმისა, რომ ენის მოდელები (LMs) უმჯობესდებიან სხვადასხვა ამოცანებში, მათ მაინც უჭირთ რთული და მკაცრი წესების მქონე მოთხოვნების შესრულება. ამ პრობლემის გადასაჭრელად, MIT-ის მკვლევრებმა შეიმუშავეს „DisCIPL“ – თანამშრომლობითი მიდგომა, სადაც დიდი ენის მოდელი (LLM) გეგმავს ამოცანას, შემდეგ კი მის შესრულებას მცირე მოდელებს ანაწილებს. ეს მეთოდი მცირე ენის მოდელებს საშუალებას აძლევს, მიაწოდონ უფრო ზუსტი და ეფექტური პასუხები, ვიდრე წამყვან LLM-ებს, როგორიცაა GPT-4o, და მიუახლოვდნენ მაღალი დონის