
Gradio-ს gr.HTML: რთული ინტერაქტიული ვებ კომპონენტების შექმნა ერთ ფაილში
სტატია აღწერს, თუ როგორ აძლევს Gradio-ს gr.HTML კომპონენტი დეველოპერებს საშუალებას, უპრეცედენტო სიმარტივითა და სისწრაფით შექმნან დახვეწილი, ინტერაქტიული ვებ აპლიკაციები და ხელოვნური ინტელექტის ინსტრუმენტები. ის გვიჩვენებს სხვადასხვა მაგალითს, როგორიცაა პომოდოროს ტაიმერი, GitHub-ის სითბური რუკა, კანბანის დაფა და AI-სთვის სპეციფიკური მაყურებლები, რომლებიც ყველა ერთ პითონ ფაილშია შემუშავებული, რაც ამარტივებს განლაგებას და აჩქარებს განვითარების ციკლს იდეიდან ცოცხალ აპლიკაციამდე წამებში.

Scosche FoundIT: მანქანის დამტენი ჩაშენებული საძიებო ტეგით – აღარასოდეს დაკარგოთ თქვენი მანქანა
ZDNET-ის რეკომენდაციები ეფუძნება მრავალსაათიან ტესტირებას, კვლევასა და შედარებით შოპინგს, რათა მკითხველს მივაწოდოთ ზუსტი და სანდო ინფორმაცია ტექნიკის შესახებ. ჩვენი სარედაქციო გუნდი უზრუნველყოფს, რომ კონტენტი არასოდეს იყოს რეკლამის განმთავსებლების გავლენის ქვეშ. ამჯერად, განვიხილავთ Scosche FoundIT-ს, ინოვაციურ 12V ორმაგი USB პორტიან მანქანის დამტენს, რომელსაც ჩაშენებული საძიებო ტექნოლოგია აქვს. ეს პატარა მოწყობილობა, Apple Find My-სთან და Google Find Hub-თან თავსებადობით, გეხმარებათ თქვენი მანქ
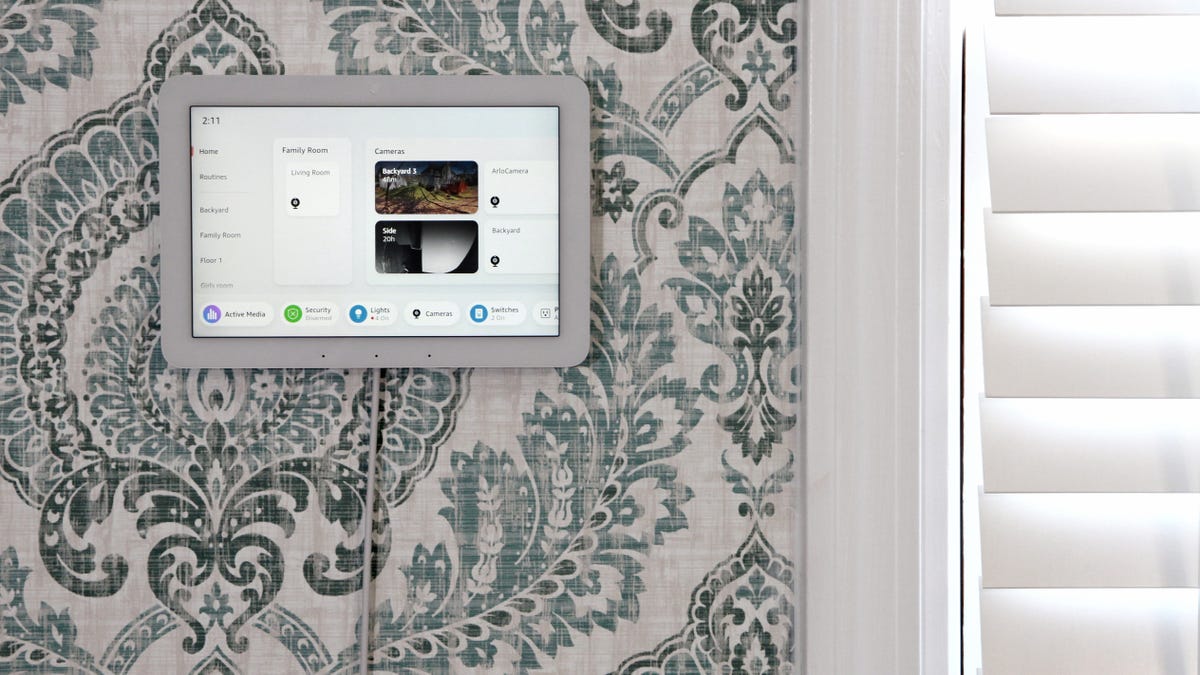
Amazon Echo Hub: სპეციალიზებული კონტროლერი ჭკვიანი სახლისთვის
ჭკვიანი სახლის მრავალი ენთუზიასტი დაიღალა ათობით აპლიკაციის გამოყენებით მოწყობილობების სამართავად. ამ გამოწვევის საპასუხოდ, Amazon-მა წარმოადგინა Echo Hub – მოწყობილობა, რომელიც გამიზნულია მხოლოდ ჭკვიანი სახლის ცენტრალიზებულ კონტროლზე. ის აკავშირებს Wi-Fi, Bluetooth, Zigbee, Matter, Sidewalk და Thread მოწყობილობებს, არ გააჩნია ზედმეტი ფუნქციები და სრულად ინტეგრირებულია Alexa-ს ეკოსისტემასთან. ZDNET-ის რეკომენდაციები ეფუძნება ხანგრძლივ ტესტირებასა და კვლევას, რათა მომხმარებელს მიაწოდოს ზუსტი და ს
Amazon Echo Hub: ჭკვიანი სახლის გამოყოფილი კონტროლერი
ZDNET-ის სარედაქციო პროცესი გამოირჩევა სიზუსტითა და დამოუკიდებლობით ტექნიკის მიმოხილვებისას. სტატია ყურადღებას ამახვილებს ჭკვიანი სახლის მრავალი აპლიკაციის მართვის სირთულეზე და წარმოგიდგენთ Amazon Echo Hub-ს, როგორც ამ პრობლემის გადაწყვეტას. Echo Hub არის ჭკვიანი სახლის სპეციალიზებული კონტროლერი, რომელიც მხარს უჭერს სხვადასხვა კავშირის სტანდარტებს (Wi-Fi, Bluetooth, Zigbee, Matter და სხვა) და არ გააჩნია დამატებითი გასართობი ფუნქციები. მისი მიზანია გაამარტივოს ჭკვიანი სახლის მართვა კონტროლის კონს
Hugging Face Hub: მანქანური სწავლების შესაძლებლობები GLAM სექტორისთვის
Hugging Face მიზნად ისახავს უმაღლესი ხარისხის მანქანური სწავლების საყოველთაო ხელმისაწვდომობას. ამის მისაღწევად კომპანია აწვდის ღია კოდის ბიბლიოთეკებს, უფასო კურსებს და Hugging Face Hub-ს – ცენტრალურ საცავს 190,000-ზე მეტი მოდელით, 33,000 მონაცემთა ნაკრებით და 100,000-ზე მეტი აპლიკაციით. ეს სტატია განკუთვნილია GLAM სექტორში (გალერეები, ბიბლიოთეკები, არქივები, მუზეუმები) მომუშავე პირებისთვის, რათა გაიგონ, როგორ გამოიყენონ და როგორ შეიტანონ წვლილი Hub-ში. მაგალითად, NER მოდელის გამოყენება ციფრული დ
Hugging Face და FriendliAI AI მოდელების განთავსების გასაუმჯობესებლად პარტნიორობენ
Hugging Face და FriendliAI აცხადებენ სტრატეგიული პარტნიორობის შესახებ, რომელიც მიზნად ისახავს დეველოპერებისთვის AI მოდელების განთავსებისა და მართვის პროცესის გამარტივებას. ინტეგრაცია FriendliAI Endpoints-ს Hugging Face Hub-ში აერთიანებს, რაც უზრუნველყოფს მაღალეფექტურ, ეკონომიურ ინფერენციის ინფრასტრუქტურას. ეს ნაბიჯი AI ინოვაციებს უფრო ხელმისაწვდომსა და ეფექტურს გახდის მსოფლიოს მასშტაბით, ოპტიმიზებული GPU გამოყენებით და ინფრასტრუქტურის მართვის სირთულეების შემცირებით.
Hugging Face ევროკავშირის ხელოვნური ინტელექტის აქტის შესახებ: ღია ML განვითარების აუცილებლობა
Hugging Face, Creative Commons-თან, Eleuther AI-თან, GitHub-თან, LAION-თან და Open Future-თან კოალიციაში, წარმოადგენს თავის პოზიციას ევროკავშირის ხელოვნური ინტელექტის (AI) აქტის შესახებ. კომპანია ხაზს უსვამს ღია მანქანური სწავლების (ML) განვითარების აუცილებელ როლს აქტის მიზნების მისაღწევად და მოუწოდებს რეგულაციას, უკეთ გაითვალისწინოს ღია, მოდულური და კოლაბორაციული ML განვითარების საჭიროებები, რაც ხელს უწყობს ინოვაციას, გამჭვირვალობასა და ანგარიშვალდებულებას.
Hugging Face Hub-ის მონაცემთა ნაკრებების მეტამონაცემების გაუმჯობესება მანქანური სწავლების საშუალებით
Hugging Face Hub, როგორც მანქანური სწავლების რესურსების ცენტრალური საცავი, აუმჯობესებს მონაცემთა ნაკრებების მეტამონაცემებს ხელოვნური ინტელექტის გამოყენებით. ახალი ინიციატივის ფარგლებში, მანქანური სწავლების ალგორითმები ამოიცნობენ ენას იმ მონაცემთა ნაკრებებში, რომლებსაც არ აქვთ ენის მეტამონაცემები, ხოლო ავტომატიზებული „ბიბლიოთეკარი-ბოტები“ ამ ინფორმაციას მეტამონაცემებში დაამატებენ. ეს პროექტი მიზნად ისახავს რესურსების მოძიების გაადვილებას და Hub-ზე წარმოდგენილი ენობრივი მიკერძოებების უკეთ გაგებას.
Hugging Face AWS Marketplace-ზე: AI-ის დანერგვის გამარტივება ბიზნესისთვის
Hugging Face-ის AWS Marketplace-ზე ინტეგრაცია აადვილებს კომპანიებისთვის დიდი ენობრივი მოდელების გამოყენებას და ხელოვნური ინტელექტის (AI) დანერგვას. AWS-ის მომხმარებლებს ახლა შეუძლიათ მარტივად გამოიწერონ Hugging Face სერვისები, ხოლო გადახდები ავტომატურად აისახება მათ AWS გადასახადში. ეს ინიციატივა არა მხოლოდ ამარტივებს პროცესს, არამედ სთავაზობს დამატებით უსაფრთხოების ფუნქციებს Enterprise Hub-ის მეშვეობით, რაც ტექნოლოგიას უფრო მეტ დეველოპერსა და ბიზნესს მიაწვდის.
IDEFICS: ღია მულტიმოდალური AI მოდელი გამჭვირვალე კვლევისთვის
IDEFICS, 80 მილიარდი პარამეტრის მულტიმოდალური ხელოვნური ინტელექტის (AI) მოდელი, რომელიც Flamingo-ს ღია წყაროს რეპროდუქციას წარმოადგენს, უკვე ხელმისაწვდომია. მისი შექმნისას დიდი აქცენტი გაკეთდა გამჭვირვალობაზე, გამოყენებულ იქნა მხოლოდ საჯაროდ ხელმისაწვდომი მონაცემები და შეფასდა პოტენციური მიკერძოებები. მოდელი მიზნად ისახავს მულტიმოდალური AI სისტემების სფეროში უფრო ღია კვლევების წახალისებას და მისი დემო ვერსიები Hugging Face Hub-ზეა განთავსებული.
Hugging Face Hub: მონაცემთა გადაცემის და შენახვის ოპტიმიზაცია დედუპლიკაციის ახალი მიდგომებით
Hugging Face Hub-ზე ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების სწრაფი ზრდა მოითხოვს ეფექტურ მონაცემთა მართვას. სტატია აღწერს, თუ როგორ უმკლავდება Xet გუნდი გამოწვევებს, რომლებიც დაკავშირებულია დედუპლიკაციასთან, ტრადიციული მიდგომების შეზღუდვებთან და მასშტაბირებადობასთან. ნაცვლად იმისა, რომ ფოკუსირება მხოლოდ მცირე ბლოკების დედუპლიკაციაზე მოხდეს, რაც ინფრასტრუქტურას გადატვირთავს, Xet გუნდმა შეიმუშავა ინოვაციური, ბლოკებზე დაფუძნებული მიდგომა Rust-ში დაწერილი xet-core და hf_xet ინტეგრაცი
Hugging Face-ის Xet გუნდის ინოვაციური მიდგომა მონაცემთა გადაცემის დაჩქარებისთვის
Hugging Face-ის Xet გუნდი მონაცემთა დედუპლიკაციას თეორიიდან პრაქტიკაში ნერგავს, რათა მნიშვნელოვნად დააჩქაროს AI დეველოპერებისთვის Hub-ზე მონაცემების ატვირთვა და ჩამოტვირთვა. იმის ნაცვლად, რომ მხოლოდ დედუპლიკაციის მაქსიმიზაციაზე გაამახვილონ ყურადღება, რამაც შეიძლება დიდი დამატებითი ხარჯები გამოიწვიოს, მათი მიდგომა მიზნად ისახავს სწრაფი ექსპერიმენტებისა და თანამშრომლობის ხელშეწყობას. ეს გულისხმობს მონაცემთა გადაადგილების, შენახვისა და განვითარების მთლიანი პროცესის ოპტიმიზაციას ჩანკებზე დაფუძნებული

AI მოდელების მასშტაბური ინფერენციის ოპტიმიზაცია: ხარჯი და შეყოვნება
ეს სტატია დეტალურად აღწერს მეთოდოლოგიას ენკოდერული მოდელების გამოყენებით მასშტაბური კლასიფიკაციისა და ემბედინგის ამოცანებისთვის ხარჯებისა და შეყოვნების გამოსათვლელად და ოპტიმიზაციისთვის. განხილულია მოდელების არქიტექტურები, აპარატურული ხარჯების ბენჩმარკინგი და ოპტიმიზაციის ჩარჩო. გამოყენებულია ისეთი ინსტრუმენტები, როგორიცაა Inference Endpoints აპარატურის შერჩევისთვის, Hugging Face Hub განთავსებისთვის, Infinity ინფერენციის სერვერისთვის და Grafana-ს k6 დატვირთვის ტესტირებისთვის. მოცემულია პრაქტიკულ
Hugging Face წარმოგიდგენთ TII-ის Falcon 180B-ს: ღია წყაროს მოდელების უახლესი მიღწევა
Hugging Face სიამაყით წარადგენს TII-ის Falcon 180B-ს – ღია წყაროს უდიდეს და უახლესი ტექნოლოგიების მწვერვალზე მდგომ ენობრივ მოდელს. 180 მილიარდი პარამეტრით და 3.5 ტრილიონ ტოკენზე გაწვრთნილი Falcon 180B ლიდერობს ღია წყაროს მოდელებს შორის და კონკურენციას უწევს ისეთ კომერციულ გიგანტებს, როგორიცაა Google-ის PaLM-2. მოდელი უკვე ხელმისაწვდომია Hugging Face Hub-ზე, რაც მაღალი შესაძლებლობის ხელოვნურ ინტელექტს ფართო საზოგადოებისთვის ხელმისაწვდომს ხდის.

Sentence Transformers v2: რევოლუციური განახლებები და ინტეგრაცია Hugging Face Hub-თან
Sentence Transformers-ის v2 ვერსიის გამოშვება ახალ შესაძლებლობებს გვთავაზობს წინადადების, აბზაცისა და გამოსახულების ემბედინგებისთვის. განახლება მოიცავს Hugging Face Hub-თან ღრმა ინტეგრაციას, 90-ზე მეტი წინასწარ გაწვრთნილი მოდელით 100-ზე მეტი ენისთვის. წარმოდგენილია ახალი ვიჯეტები – ფუნქციის ექსტრაქციისა და წინადადების მსგავსების გამოსათვლელად, ასევე API ინტერფეისები მოდელებთან პროგრამული წვდომისთვის, რაც საზოგადოებას საშუალებას აძლევს მარტივად გააზიაროს და გამოიყენოს თავისი გაწვრთნილი მოდელები.
Amazon SageMaker ამარტივებს Hugging Face Transformers-ის დეპლოირებას ახალი Inference DLC-ებითა და ხელსაწყოებით
Amazon SageMaker-მა გამოუშვა Hugging Face Inference DLC-ები და ახალი Inference Toolkit, რაც მნიშვნელოვნად ამარტივებს Hugging Face Transformers მოდელების დეპლოირებას. ეს სიახლე საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ როგორც საკუთარი გაწვრთნილი მოდელები, ისე Hugging Face Model Hub-დან 10,000-ზე მეტი საჯაროდ ხელმისაწვდომი მოდელი, სულ ერთი დამატებითი კოდის ხაზით. SageMaker უზრუნველყოფს საპროდუქციო გარემოსთვის მზა ენდპოინტებს ჩაშენებული მონიტორინგითა და მასშტაბირებადი შესაძლებლობებით.
Hugging Face spaCy-ის ინტეგრაციით მოდელების გაზიარებასა და გამოყენებას ამარტივებს
Hugging Face-მა და spaCy-იმ განახორციელეს ინტეგრაცია, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ, დააყენონ და გამოიყენონ spaCy-ის კონვეიერები და მოდელები. ახალი ფუნქციონალი მოიცავს ავტომატურ მეტამონაცემების გენერაციას, დასკვნის (Inference) API-ს NER-ისთვის (Named Entity Recognition), ბრაუზერში ინტერაქტიულ ტესტირებას, `pip install`-ის მხარდაჭერას და `spacy-huggingface-hub` ბიბლიოთეკას მოდელების სწრაფი გაზიარებისთვის. ხელმისაწვდომია 60-ზე მეტი კანონიკური მოდელი, და მალე დაემატება ტექსტ
ობიექტის ამოცნობის ლიდერბორდი: მეტრული მაჩვენებლების გაგება და კრიტიკული შეფასება
Hugging Face Hub-მა გამოაქვეყნა ობიექტის ამოცნობის ლიდერბორდი, რომელიც აფასებს მოდელებს სხვადასხვა მეტრიკის საფუძველზე, როგორიცაა „კვეთა გაერთიანებაზე“ (IoU), „საშუალო სიზუსტე“ (AP) და „საშუალო გახსენება“ (AR). ეს ბლოგი დეტალურად განიხილავს მოდელების შეფასების მეთოდებს, განმარტავს გამოყენებულ მეტრიკას და მიზნად ისახავს შეფასებისას წარმოშობილი სირთულეების გამარტივებას, რათა მომხმარებლებს შეეძლოთ მოდელის მუშაობის კრიტიკულად შეფასება. ასევე ახსნილია ობიექტის ამოცნობის კონცეფცია, მისი აპლიკაციები და
Hugging Face-ის სიახლეები: ივნისი, ივლისი, აგვისტო
ბოლო თვეებში Hugging Face Hub მნიშვნელოვნად გაფართოვდა, დაინერგა „Spaces“ მანქანური სწავლების დემო აპლიკაციებისთვის, ასევე დაემატა ახალი ფუნქციები, როგორიცაა რეპოზიტორების მოწონება, TensorBoard-ის ინტეგრაცია და შეფასების დეტალური მეტრიკა. დაინერგა ახალი ვიჯეტები სხვადასხვა ხელოვნური ინტელექტის მოდელებისთვის (ტექსტი, აუდიო, გამოსახულება). პლატფორმამ გააუმჯობესა დოკუმენტაცია, რეპოზიტორების მართვა და გამოუშვა უფასო ონლაინ კურსი. დიდი საზოგადოებრივი ღონისძიება, რომელშიც 800-მდე მონაწილე იყო ჩართული,

Hugging Face Hub-ის უსაფრთხოება JFrog-ის სკანერის ინტეგრაციით ძლიერდება
Hugging Face-მა JFrog-ის სკანერი თავის პლატფორმაზე დაამატა, რათა Hugging Face Hub-ზე უსაფრთხოება გააუმჯობესოს. ახალი სკანერი ამცირებს ცრუ დადებით შედეგებს და მოდელის წონებში არსებულ კოდს ღრმად აანალიზებს პოტენციური მავნე გამოყენების გამოსავლენად, განსაკუთრებით ისეთი მოწყვლადი სერიალიზაციის ფორმატებისთვის, როგორიცაა Pickle. ყველა საჯარო მოდელის რეპოზიტორი ავტომატურად დასკანირდება, რაც საზოგადოებას მოდელების უსაფრთხოდ გაზიარებაში ეხმარება.

მობილური AI ჩატბოტი: LLM-ების ლოკალურად გაშვება React Native-ით
ეს დეტალური გზამკვლევი აღწერს, თუ როგორ შევქმნათ React Native მობილური აპლიკაცია, რომელიც მომხმარებლებს საშუალებას აძლევს, პირადულ გარემოში, ლოკალურად ესაუბრონ ხელოვნური ინტელექტის დიდ ენობრივ მოდელებს (LLM). სტატია მოიცავს მოდელების შერჩევის კრიტერიუმებს, განვითარების გარემოს კონფიგურაციასა და აპლიკაციის საწყის ეტაპებს, `llama.rn`-ის ეფექტური გამოყენებით GGUF ფაილების ჩასატვირთად Hugging Face Hub-იდან.

Hugging Face-ის Xet გუნდი: დიდი ნაბიჯი AI მოდელებისა და მონაცემთა საცავების მიგრაციაში
Hugging Face-ის Xet გუნდმა წარმატებით განახორციელა მოდელებისა და მონაცემთა ნაკრებების პირველი საცავების მიგრაცია LFS-დან Xet საცავში. ეს ნაბიჯი, რომელიც Hugging Face-ის Hub-ის ხედვის ნაწილია, მიზნად ისახავს ხელოვნური ინტელექტის დეველოპერებისთვის მასიურ მოდელებსა და მონაცემთა ნაკრებებზე მუშაობის გამარტივებას, უფრო ეფექტურ თანამშრომლობასა და განმეორებითი იტერაციების განხორციელებას. მიგრაციამ Hub-ის ჩამოტვირთვის ტრაფიკის დაახლოებით 6% Xet ინფრასტრუქტურაზე გადაიტანა, რაც ამტკიცებს ახალი სისტემის ეფე
კოდის გენერაციის მოდელის წვრთნის დეტალები: Python-ის მაგალითზე
სტატია დეტალურად აღწერს პითონის კოდის გენერაციის მოდელის შექმნისა და წვრთნის კომპლექსურ პროცესს. ის მოიცავს მონაცემთა მოპოვებას GitHub-იდან, 180 GB-იანი მონაცემთა ნაკრების გაწმენდას დუბლიკატებისაგან Codex-ის ევრისტიკის გამოყენებით (რაც 50 GB-იან გაწმენდილ ნაკრებს იძლევა). შემდეგ აღწერილია სპეციალიზებული ტოკენაიზერის წვრთნა, GPT-2 Large-ზე დაფუძნებული მოდელის ინიციალიზაცია სპეციალური კორექტირებით, და ეფექტიანი სავარჯიშო ციკლის დაყენება 🤗 Accelerate ბიბლიოთეკის გამოყენებით განაწილებული (multi-GPU)
კოდის გენერაციის მოდელების პერსონალიზაცია: HugCoder-ის შექმნა და თქვენი საკუთარი Copilot-ის შესაძლებლობები
მიუხედავად იმისა, რომ წინასწარ გაწვრთნილი ხელოვნური ინტელექტის მოდელები შთამბეჭდავად მუშაობენ სხვადასხვა ამოცანებში, მომავალი შესაძლებლობა მდგომარეობს კოდის გენერაციის მოდელების კონკრეტულ საჭიროებებზე მორგებაში, რაც ქმნის პერსონალიზებულ კოდირების ასისტენტებს საწარმოო მასშტაბით. ეს ბლოგ-პოსტი წარმოგიდგენთ HugCoder-ს – კოდის დიდ ენობრივ მოდელს (LLM), რომელიც დამატებით გაიწრთვნა Hugging Face-ის GitHub-ის საჯარო რეპოზიტორიებიდან შეგროვებულ კოდის შიგთავსზე. დეტალურად განვიხილავთ მონაცემთა შეგროვების,