
ექსპერტთა ნარევი (MoE) მოდელები – LLM-ების მასშტაბირების ახალი მიდგომა
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ევოლუციას, რომელიც მჭიდრო მასშტაბირებიდან (მეტი მონაცემი + მეტი პარამეტრი) ექსპერტთა ნარევის (Mixture of Experts - MoE) მოდელებზე გადადის. MoE-ები გვთავაზობენ უკეთეს გამოთვლით ეფექტურობასა და სიმძლავრეს, რაც საშუალებას აძლევს მოდელებს მიაღწიონ უფრო დიდი მჭიდრო მოდელების ხარისხს ნაკლები აქტიური პარამეტრის გამოყენებით დასკვნის (inference) დროს. ხაზგასმულია MoE-ების უპირატესობები, როგორიცაა პარალელიზაცია და ინდუსტრიული მიღება, ასევე დეტალურად არის აღწ
ექსპერტთა ნაზავი (MoE) მოდელები: დიდი ენობრივი მოდელების (LLMs) მასშტაბირების ახალი მიდგომა
ბოლო წლებში დიდი ენობრივი მოდელების (LLMs) განვითარება ძირითადად განპირობებული იყო მკვრივი მოდელების მასშტაბირებით. თუმცა, ამ მიდგომას პრაქტიკული ზღვარი აქვს. სტატია განმარტავს ექსპერტთა ნაზავი (MoE) მოდელების კონცეფციას, როგორც LLM-ების მასშტაბირების ახალ ეფექტურ გზას. MoE მოდელები იძლევა მაღალი წარმადობის მიღწევის საშუალებას გაცილებით ნაკლები აქტიური პარამეტრით, რაც აჩქარებს ინფერენციის პროცესს. განხილულია მათი უპირატესობები გამოთვლითი ეფექტურობის, პარალელიზაციის და ინდუსტრიაში მზარდი მიღების

Meta-ს Llama 4-ის მოდელები გამოვიდა: წინ გადადგმული ნაბიჯი მულტიმოდალურ ხელოვნურ ინტელექტში MoE არქიტექტურითა და გაფართოებული კონტექსტით
Meta-ს მიერ შემუშავებული Llama 4-ის მოდელები, Maverick და Scout, დღეს გამოვიდა, რაც ხელოვნური ინტელექტის სფეროში მნიშვნელოვან წინსვლას წარმოადგენს. ეს მძლავრი, მშობლიურად მულტიმოდალური მოდელები იყენებენ ახალ ავტორეგრესიულ „ექსპერტთა ნაზავის“ (MoE) არქიტექტურას, რაც მათ საშუალებას აძლევს დაამუშაონ როგორც ტექსტური, ისე გამოსახულების შეტანა. Hugging Face-ის ეკოსისტემასთან სრულყოფილი ინტეგრაციის უზრუნველყოფით, Llama 4-ის მოდელები გაწვრთნილია 200 ენაზე (40 ტრილიონამდე ტოკენზე) და გამოირჩევა კონტექსტი
Meta-მ Llama 4 მულტიმოდალური AI მოდელები გამოუშვა Hugging Face-ის ეკოსისტემისთვის
დღეს Meta-მ წარმოადგინა Llama 4-ის ახალი თაობის მძლავრი, მშობლიურად მულტიმოდალური AI მოდელები – Maverick და Scout. ეს მოდელები მნიშვნელოვან წინ გადადგმულ ნაბიჯს წარმოადგენს ხელოვნური ინტელექტის განვითარებაში, რომლებიც ინტეგრირებულია Hugging Face-ის ეკოსისტემაში. Llama 4 იყენებს ინოვაციურ ავტორეგრესიულ ექსპერტთა ნარევის (MoE) არქიტექტურას და მხარს უჭერს უზარმაზარ კონტექსტის სიგრძეებს (Scout-ისთვის 10 მილიონამდე ტოკენი), ასევე ტექსტური და გამოსახულების შეტანის დამუშავებას. მოდელები გაწვრთნილია 200
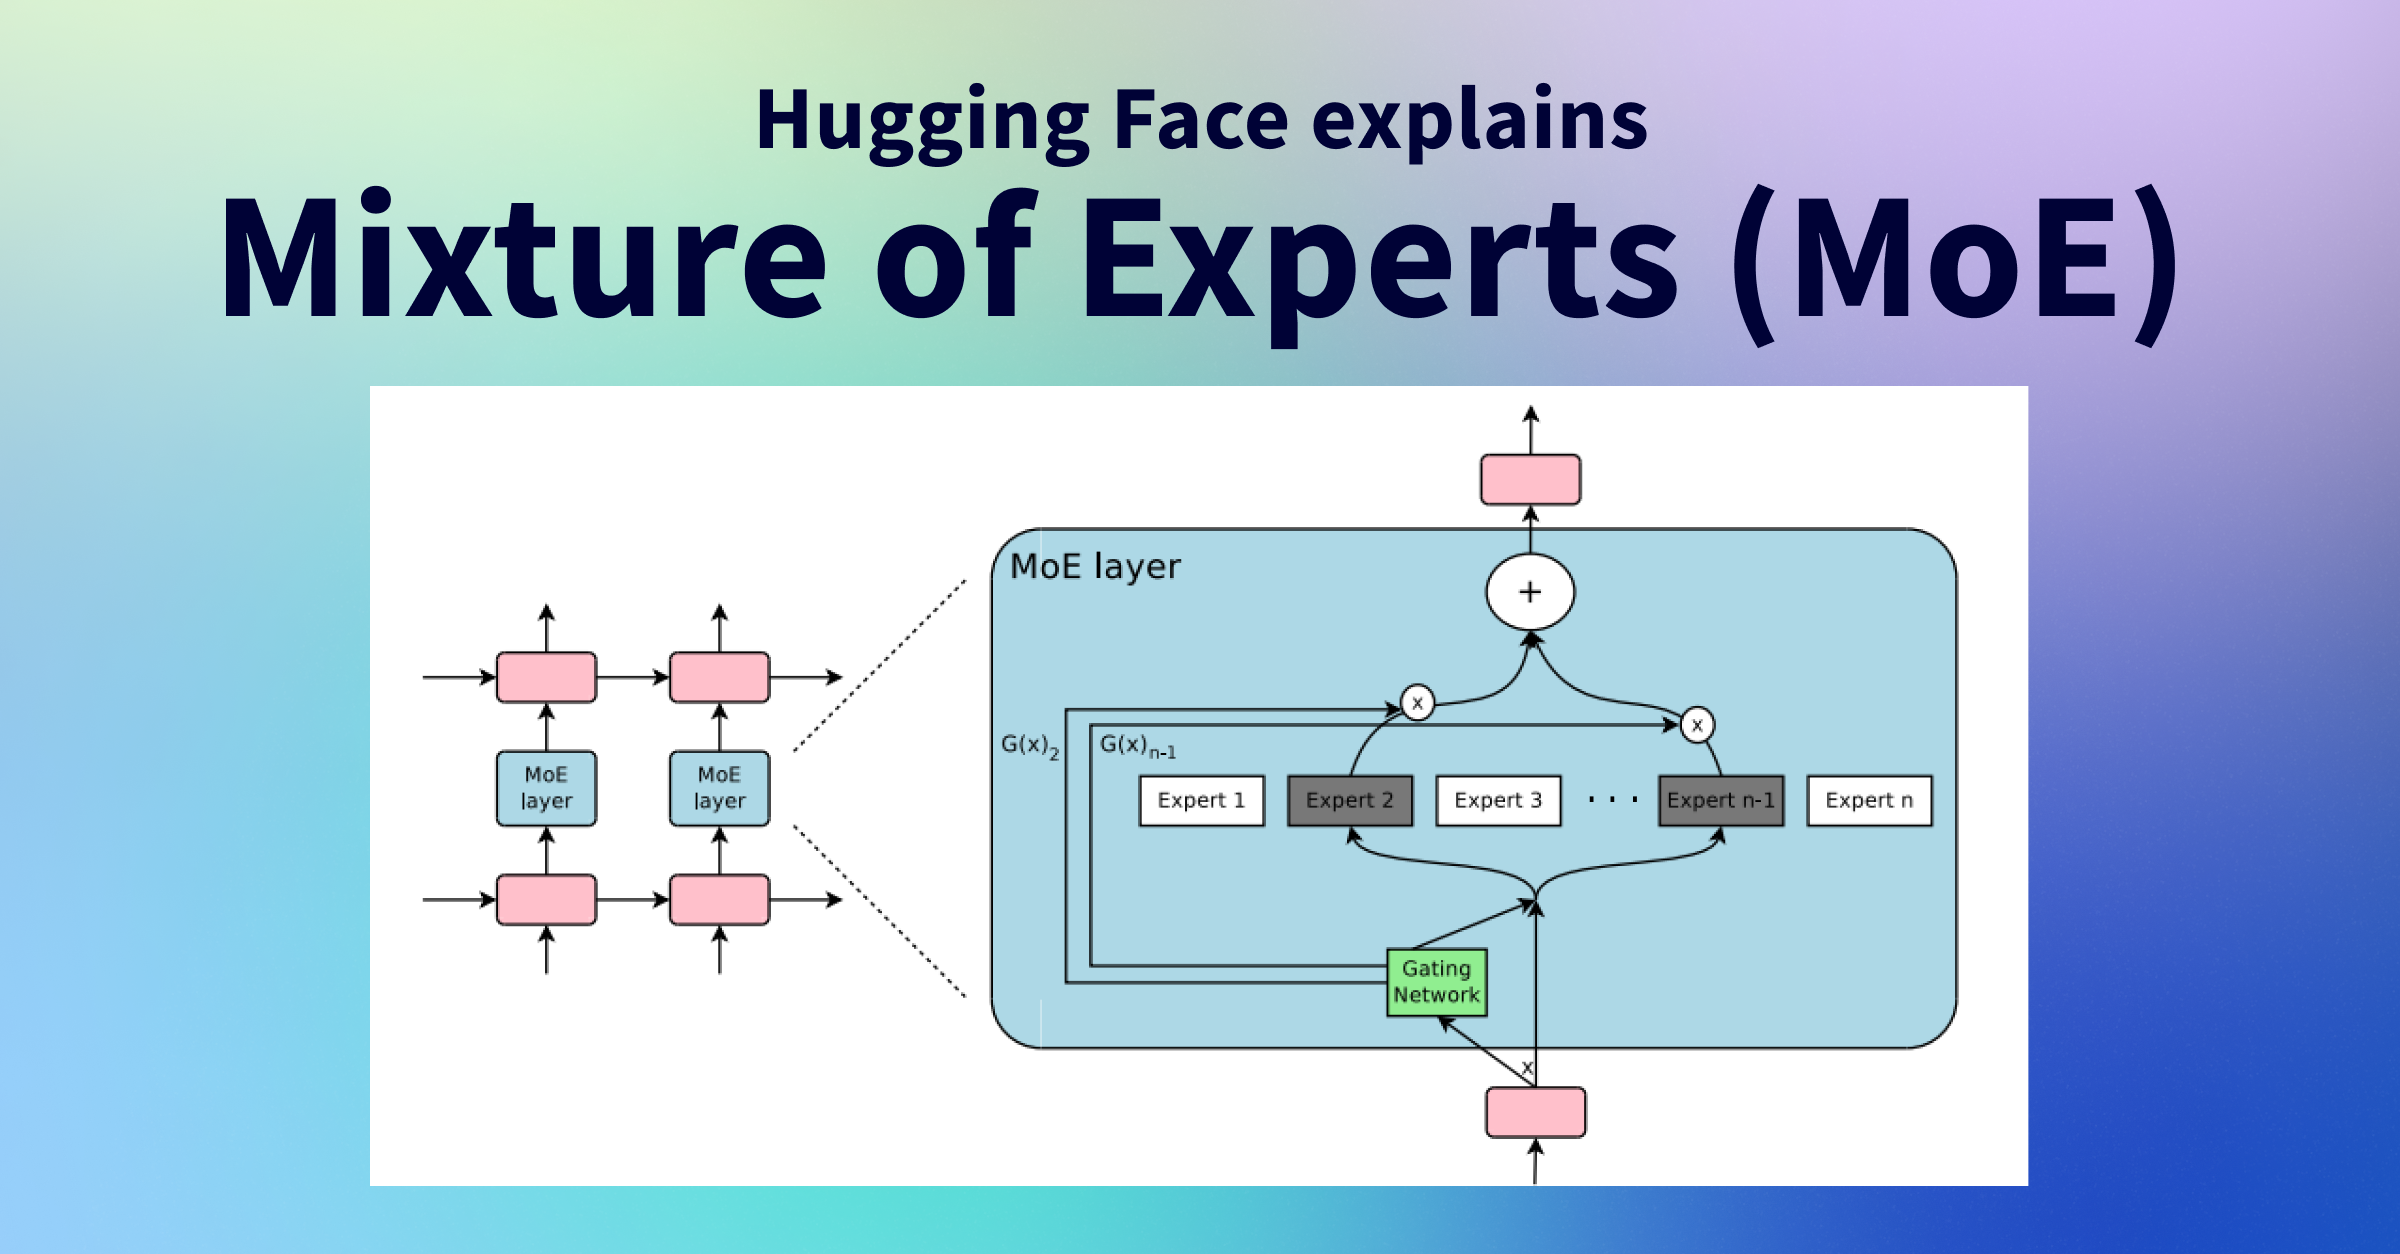
ექსპერტთა ნაზავი (MoEs): სიღრმისეული მიმოხილვა და იშვიათი მოდელების როლი
ექსპერტთა ნაზავი (MoEs) წარმოადგენს მნიშვნელოვან მიღწევას ხელოვნურ ინტელექტში, რომელიც საშუალებას აძლევს მოდელებს, მიაღწიონ უკეთეს ხარისხს გაცილებით ნაკლები გამოთვლითი რესურსებით. MoEs-ის მეშვეობით შესაძლებელია მოდელის ან მონაცემთა ნაკრების ზომის მნიშვნელოვნად გაზრდა მკვრივ მოდელებთან შედარებით, ერთი და იგივე ბიუჯეტის პირობებში, რაც უზრუნველყოფს უფრო სწრაფ წინასწარ წვრთნას. სტატია განმარტავს MoE-ის კონცეფციას ტრანსფორმერული მოდელების კონტექსტში, განიხილავს მის შემადგენელ ნაწილებს (კარიბჭის ქსელი
Mixtral-ის გამოშვება: ახალი ნახტომი ხელოვნურ ინტელექტში ექსპერტთა ნაზავი (Mixture of Experts) არქიტექტურით
სტატია წარმოგიდგენთ Mixtral-ს, ახალ დიდ ენობრივ მოდელს (LLM), რომელიც იყენებს ექსპერტთა ნაზავის (MoE) არქიტექტურას, აერთიანებს 8 „ექსპერტ“ მოდელს ერთში. ხაზგასმულია Mixtral-ის შთამბეჭდავი წარმადობა, რომელიც აჭარბებს სხვა ღია წვდომის მოდელებს და უტოლდება GPT-3.5-ს MT-Bench ბენჩმარკზე. განმარტებულია მისი რეალური პარამეტრების რაოდენობა (დაახლოებით 45B, არა 56B) და დეტალურად აღწერილია მისი გამოყენება ინფერენციისა და ფაინ-თუნინგისთვის, ასევე Hugging Face-ზე განთავსების შესაძლებლობები.
წარმოდგენილია SegMoE: ექსპერტთა ნარევი Stable Diffusion მოდელებისთვის
SegMoE წარმოადგენს ინოვაციურ არქიტექტურას, რომელიც აერთიანებს მრავალ მოდელს ერთში Feed-Forward ფენების MoE ფენებით ჩანაცვლებით. ეს საშუალებას აძლევს Stable Diffusion მოდელებს უფრო ეფექტურად და ზუსტად გენერირდეს სურათები. ახალი პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა და იგი აუმჯობესებს „prompt“ გაგებას, თუმცა აღინიშნება VRAM-ის მაღალი მოხმარება და გარკვეული სისუსტე ერთეულ SD მოდელებთან შედარებით.
SegMoE მოდელების გამოშვება: როგორ გავაერთიანოთ დიფუზიური მოდელები მარტივად
SegMoE წარმოადგენს ახალ მიდგომას დიფუზიური მოდელების შექმნაში, რომელიც სტეიბლ დიფუჟენის არქიტექტურას ეფუძნება და Mixtral 8x7b-ის მსგავსად, რამდენიმე მოდელს ერთში აერთიანებს. ის Feed-Forward შრეებს ცვლის იშვიათი MoE შრით, რომელიც ექსპერტთა როუტერულ ქსელს იყენებს. SegMoE პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა, რაც აუმჯობესებს პრომპტების გაგებას. მოდელი მხარს უჭერს Hugging Face-ისა და CivitAI-ის პლატფორმებს. თუმცა, მას აქვს შეზღუდვები, როგორიცაა ნელი სიჩქარე და VRAM-ის მაღალი მ

OpenAI-ის GPT OSS მოდელები Hugging Face-ზე: გაუმჯობესებული ხელმისაწვდომობა და ოპტიმიზებული წარმადობა
OpenAI-მ Apache 2.0 ლიცენზიით გამოუშვა ღია კოდის GPT OSS მოდელები, რომელთა მიზანია ხელოვნური ინტელექტის ფართო ხელმისაწვდომობის უზრუნველყოფა უსაფრთხო და პასუხისმგებლიანი გამოყენებით. Hugging Face-თან ინტეგრაციით, მომხმარებლებს შეუძლიათ ისარგებლონ გაუმჯობესებული არქიტექტურით, მათ შორის mxfp4 კვანტიზაციით, Flash Attention 3-ითა და MegaBlocks MoE ქერნელებით, რაც უზრუნველყოფს მნიშვნელოვან მეხსიერების დაზოგვას და მაღალ წარმადობას როგორც NVIDIA, ისე AMD GPU-ებზე. ეს ინიციატივა ხელს უწყობს AI-ის ინოვაცი

Google Cloud C4 VM-ები Intel Xeon 6 პროცესორებით: AI-სთვის ოპტიმიზაცია და მფლობელობის ხარჯების 1.7x შემცირება
უახლესი კვლევის შედეგები აჩვენებს, რომ Google Cloud C4 VM ინსტანციები, რომლებიც Intel Xeon 6 პროცესორებითაა აღჭურვილი, 1.7-ჯერ აუმჯობესებს მფლობელობის საერთო ღირებულებას (TCO) წინა თაობის Google C3 VM-ებთან შედარებით. ეს შთამბეჭდავი წინსვლა მიღწეულია GPT OSS (Mixture of Experts – MoE) მოდელების ეფექტური მხარდაჭერით, Intel-ისა და Hugging Face-ის მიერ განხორციელებული ოპტიმიზაციების წყალობით, რაც უზრუნველყოფს გაუმჯობესებულ გამტარობას, შემცირებულ შეყოვნებას და ხარჯების ოპტიმიზაციას მსხვილი MoE ინფერ
NVIDIA წარმოგიდგენთ Nemotron 3-ის AI მოდელების ხაზს მრავალაგენტური სისტემებისთვის
NVIDIA-მ გამოუშვა Nemotron 3 AI მოდელების ხაზი (Nano, Super, Ultra), რომელიც შექმნილია მრავალაგენტური სისტემებისთვის მოწინავე მსჯელობის, საუბრისა და თანამშრომლობის შესაძლებლობებით. მოდელები იყენებენ ჰიბრიდულ Mamba-ტრანსფორმერის MoE არქიტექტურას, რაც უზრუნველყოფს მაღალ წარმადობას და კონტექსტის სიგრძეს 1 მილიონ ტოკენამდე. Nemotron 3 Nano, რომელიც დღესვე ხელმისაწვდომია, ოპტიმიზირებულია ხარჯთეფექტურობისთვის, ხოლო Super და Ultra, რომლებიც 2026 წლის პირველ ნახევარში გამოვა, აფართოებენ ამ შესაძლებლობებ