LIVE
AI-ს გავლენა SaaS-ის ბიზნეს მოდელზე: „SaaSpocalypse“ თუ ახალი ერა? · Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე · Honor Magic V6: უთხელესი დასაკეცი ტელეფონი? პირველი შთაბეჭდილებები · Honor Magic V6: ყველაზე თხელი დასაკეცი სმარტფონი და მისი შთამბეჭდავი შესაძლებლობები · ZDNET-ის სანდოობა და MWC 2026: Honor-ის დასაკეცი ტელეფონი Magic V6 და ხელოვნური ინტელექტის მქონე „რობოტი ტელეფონი“ · MWC 2026: Xiaomi Pad 8 Pro Matte Glass – Android ტაბლეტის ახალი ეტალონი? · AI-ს გავლენა SaaS-ის ბიზნეს მოდელზე: „SaaSpocalypse“ თუ ახალი ერა? · Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე · Honor Magic V6: უთხელესი დასაკეცი ტელეფონი? პირველი შთაბეჭდილებები · Honor Magic V6: ყველაზე თხელი დასაკეცი სმარტფონი და მისი შთამბეჭდავი შესაძლებლობები · ZDNET-ის სანდოობა და MWC 2026: Honor-ის დასაკეცი ტელეფონი Magic V6 და ხელოვნური ინტელექტის მქონე „რობოტი ტელეფონი“ · MWC 2026: Xiaomi Pad 8 Pro Matte Glass – Android ტაბლეტის ახალი ეტალონი? ·
AI TIME.ge პროექტი

AI სიახლეები

სულ 2 სტატია · გვერდი 1 / 1

Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის
ტექნოლოგიები 13 თებ

Stable Diffusion-ის დახვეწა Intel Sapphire Rapids CPU-ებზე: ახალი შესაძლებლობები ღრმა სწავლისთვის

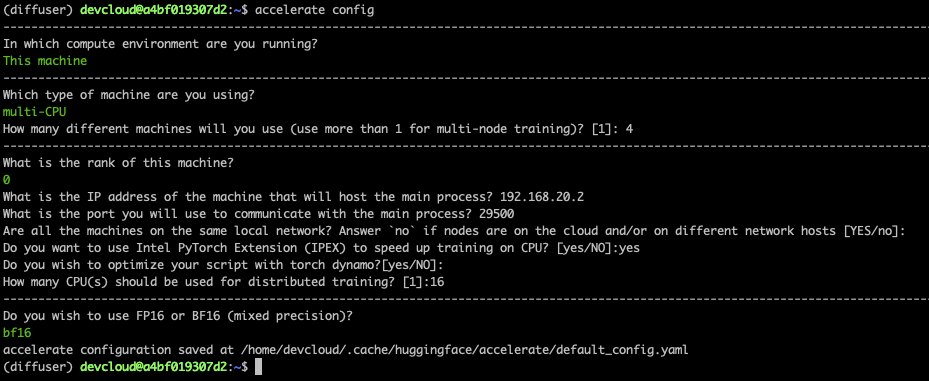
Intel-მა წარმოადგინა Xeon CPU-ების მეოთხე თაობა, Sapphire Rapids, რომელიც მოიცავს Intel Advanced Matrix Extensions (AMX) აჩქარებელს ღრმა სწავლისთვის. ეს სტატია დეტალურად აღწერს, თუ როგორ შეიძლება Stable Diffusion მოდელების დახვეწა (fine-tuning) Intel Sapphire Rapids CPU კლასტერზე, ტექსტური ინვერსიის გამოყენებით. პროცესი მოიცავს სისტემის დაყენებას Intel Developer Cloud-ზე, პროგრამული დამოკიდებულებების კონფიგურაციას (მათ შორის Intel-ის ბიბლიოთეკები oneCCL და IPEX) და განაწილებულ სწავლებას მინიმალუ

1 წთ კითხვა · 64 ნახვა
ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
ტექნოლოგიები 13 თებ

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები

გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.

1 წთ კითხვა · 97 ნახვა