Meta AI-ის რევოლუციური MMS მოდელი: 1100-ზე მეტი ენის მხარდაჭერა და გადაშენების პირას მყოფი ენების შენარჩუნება
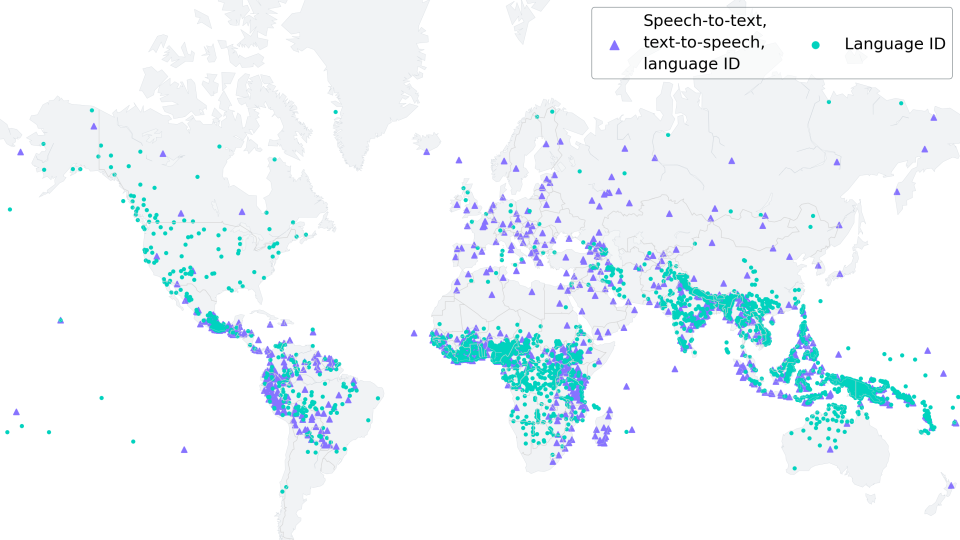
Meta AI-მ წარმოადგინა Massive Multilingual Speech (MMS) მოდელი, რომელსაც შეუძლია 1100-ზე მეტი ენის ამოცნობა, ტრანსკრიფცია და გენერაცია. ეს ინოვაციური სისტემა, რომელიც იყენებს „ადაპტერის“ წვრთნის მეთოდს, მნიშვნელოვნად ამცირებს შეცდომის მაჩვენებელს მცირე რესურსების მქონე ენებისთვის და ხელს უწყობს გადაშენების პირას მყოფი ენების შენარჩუნებას, რადგან მათთვის წერილობითი ჩანაწერების შექმნასა და მშობლიურ ენაზე კომუნიკაციას უწყობს ხელს. MMS-ის ადაპტერის წვრთნა უფრო ეფექტურია მეხსიერების თვალსაზრისით, უფრ
Wav2Vec2 არის ავტომატური მეტყველების ამოცნობის (ASR) წინასწარ გაწვრთნილი მოდელი, რომელიც 2020 წლის სექტემბერში ალექსეი ბაევსკიმ, მაიკლ აულიმ და ალექს კონომ გამოუშვეს. Wav2Vec2-ის მაღალი წარმადობის დემონსტრირების შემდეგ, ASR-ისთვის ერთ-ერთ ყველაზე პოპულარულ ინგლისურ მონაცემთა ნაკრებზე, სახელწოდებით LibriSpeech, Facebook AI-მ წარმოადგინა Wav2Vec2-ის ორი მრავალენოვანი ვერსია, XLSR და XLM-R, რომლებსაც 128-მდე ენაზე მეტყველების ამოცნობა შეუძლიათ. XLSR ნიშნავს ჯვარედინი-ენობრივ მეტყველების წარმოდგენებს (cross-lingual speech representations) და მიუთითებს მოდელის უნარზე, ისწავლოს მეტყველების წარმოდგენები, რომლებიც სასარგებლოა მრავალ ენაზე.
Meta AI-ის უახლესი პროდუქტი, Massive Multilingual Speech (MMS), შექმნილი ვინელ პრატაპის, ანდროს ტჯანდრას, ბოუენ შის და სხვათა მიერ, მრავალენოვან მეტყველების წარმოდგენებს ახალ დონეზე აჰყავს. გამოშვებული ენის იდენტიფიკაციის, მეტყველების ამოცნობის და ტექსტიდან მეტყველებად გარდაქმნის სხვადასხვა საცნობარო წერტილების (checkpoints) მეშვეობით, შესაძლებელია 1,100-ზე მეტი სალაპარაკო ენის იდენტიფიცირება, ტრანსკრიფცია და გენერაცია. ამ ბლოგპოსტში ჩვენ ვაჩვენებთ, თუ როგორ აღწევს MMS-ის ადაპტერის წვრთნა საოცრად დაბალ სიტყვის შეცდომის მაჩვენებელს სულ რაღაც 10-20 წუთიანი დამატებითი წვრთნის (fine-tuning) შემდეგ.
მწირი რესურსების მქონე ენებისთვის, მკაცრად გირჩევთ გამოიყენოთ MMS-ის ადაპტერის წვრთნა, ნაცვლად მთლიანი მოდელის დამატებითი წვრთნისა, როგორც ეს კეთდება ნაშრომში „XLS-R-ის დამატებითი წვრთნა მრავალენოვან ASR-ზე“. ჩვენს ექსპერიმენტებში, MMS-ის ადაპტერის წვრთნა არის როგორც უფრო მეხსიერების ეფექტური, ასევე უფრო მდგრადი და უკეთეს შედეგებს იძლევა მწირი რესურსების მქონე ენებისთვის. თუმცა, საშუალო და მაღალი რესურსების მქონე ენებისთვის, შესაძლოა, მაინც უფრო მომგებიანი იყოს მთლიანი საცნობარო წერტილის დამატებითი წვრთნა, ნაცვლად ადაპტერის ფენების გამოყენებისა.
ვებგვერდ Ethnologue.com-ის მიხედვით, დაახლოებით 3000, ანუ ყველა „ცოცხალი“ ენის 40%, გადაშენების პირასაა მშობლიური ენის მქონე მოსაუბრეთა რაოდენობის შემცირების გამო. ეს ტენდენცია მხოლოდ გაგრძელდება მზარდად გლობალიზებულ სამყაროში. MMS-ს შეუძლია მრავალი გადაშენების პირას მყოფი ენის ტრანსკრიფცია, როგორიცაა არი ან კაივი. მომავალში, MMS-მა შეიძლება სასიცოცხლო როლი ითამაშოს ენების შენარჩუნებაში, დაეხმაროს დარჩენილ მოსაუბრეებს წერილობითი ჩანაწერების შექმნაში და მშობლიურ ენაზე კომუნიკაციაში. 1000-ზე მეტ სხვადასხვა ლექსიკასთან ადაპტირებისთვის, MMS იყენებს ადაპტერებს – წვრთნის მეთოდს, სადაც მოდელის წონების მხოლოდ მცირე ნაწილი გადის წვრთნას. ადაპტერის ფენები მოქმედებს როგორც ლინგვისტური ხიდები, რაც მოდელს საშუალებას აძლევს, გამოიყენოს ცოდნა ერთი ენიდან მეორის გაშიფვრისას.
MMS-ის უკონტროლო საცნობარო წერტილები წინასწარ გაიწვრთნა ნახევარ მილიონ საათზე მეტ აუდიო მასალაზე 1,400-ზე მეტ ენაზე, 300 მილიონიდან ერთ მილიარდ პარამეტრამდე დიაპაზონში. წინასწარ გაწვრთნილი საცნობარო წერტილები შეგიძლიათ იპოვოთ 🤗 Hub-ზე მოდელებისთვის, რომელთა ზომაა 300 მილიონი პარამეტრი (300M) და ერთი მილიარდი პარამეტრი (1B). შენიშვნა: თუ გსურთ საბაზისო მოდელების დამატებითი წვრთნა, შეგიძლიათ გააკეთოთ ეს ზუსტად ისე, როგორც ნაჩვენებია ნაშრომში „XLS-R-ის დამატებითი წვრთნა მრავალენოვან ASR-ზე“. BERT-ის ნიღბიანი ენის მოდელირების მიზნის მსგავსად, MMS სწავლობს კონტექსტუალიზებულ მეტყველების წარმოდგენებს, შემთხვევით ნიღბავს მახასიათებლის ვექტორებს, სანამ მათ ტრანსფორმერის ქსელს გადასცემს თვითკონტროლირებადი წინასწარი წვრთნის დროს.
ASR-ისთვის, წინასწარ გაწვრთნილი MMS-1B საცნობარო წერტილი შემდგომში დამატებით გაიწვრთნა კონტროლირებადი მეთოდით 1000-ზე მეტ ენაზე, საერთო ლექსიკის გამომავალი ფენით. ბოლო ნაბიჯის სახით, საერთო ლექსიკის გამომავალი ფენა მოცილებული იქნა და მის ნაცვლად დარჩა ენისთვის სპეციფიკური ადაპტერის ფენები. თითოეული ადაპტერის ფენა შეიცავს დაახლოებით 2.5 მილიონ წონას, რომელიც შედგება მცირე წრფივი პროექციის ფენებისგან თითოეული ყურადღების ბლოკისთვის, ასევე ენისთვის სპეციფიკური ლექსიკის გამომავალი ფენისგან.
გამოვიდა სამი MMS საცნობარო წერტილი, რომლებიც დამატებით გაიწვრთნა მეტყველების ამოცნობისთვის (ASR). ისინი მოიცავს შესაბამისად 102, 1107 და 1162 ადაპტერის წონას (თითოეული ენისთვის თითო). თქვენ ხედავთ, რომ საბაზისო მოდელები ინახება (როგორც ყოველთვის) model.safetensors ფაილის სახით, მაგრამ გარდა ამისა, ამ საცავებში ინახება მრავალი ადაპტერის წონა, მაგალითად, adapter.fra.safetensors-ის სახელწოდებით ფრანგულისთვის. Hugging Face-ის დოკუმენტაცია ძალიან კარგად ხსნის, თუ როგორ შეიძლება ასეთი საცნობარო წერტილების გამოყენება დასკვნებისთვის (inference), ამიტომ ამ ბლოგპოსტში ჩვენ ყურადღებას გავამახვილებთ იმაზე, თუ როგორ შეგვიძლია ეფექტურად გავწვრთნათ მაღალი წარმადობის ადაპტერის მოდელები გამოშვებული ASR საცნობარო წერტილების საფუძველზე.
მანქანურ სწავლებაში, ადაპტერები არის მეთოდი, რომელიც გამოიყენება წინასწარ გაწვრთნილი მოდელების დამატებითი წვრთნისთვის, ორიგინალური მოდელის პარამეტრების შეუცვლელად. ისინი ამას აკეთებენ მცირე, წვრთნადი მოდულების, სახელწოდებით ადაპტერის ფენების, ჩასმით მოდელის არსებულ ფენებს შორის, რომლებიც შემდეგ მოდელს კონკრეტულ ამოცანასთან ადაპტირებენ გაფართოებული გადაწვრთნის საჭიროების გარეშე. ადაპტერებს ხანგრძლივი ისტორია აქვთ მეტყველების ამოცნობაში და განსაკუთრებით სპიკერის ამოცნობაში. სპიკერის ამოცნობაში, ადაპტერები ეფექტურად გამოიყენებოდა არსებული მოდელების მოდიფიცირებისთვის ინდივიდუალური სპიკერის თავისებურებების ამოსაცნობად, როგორც ეს ხაზგასმულია გეილსისა და ვუდლენდის (1996) და მიაოს და სხვების (2014) ნაშრომებში. ეს მიდგომა არა მხოლოდ მნიშვნელოვნად ამცირებს გამოთვლით მოთხოვნებს სრული მოდელის წვრთნასთან შედარებით, არამედ იძლევა უკეთესი და მოქნილი სპიკერისთვის სპეციფიკური კორექტირების საშუალებას. MMS-ში შესრულებული სამუშაო იყენებს ადაპტერების ამ იდეას მეტყველების ამოცნობისთვის სხვადასხვა ენაზე.
თეგები:
#ai
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#მრავალენოვანი
#მეტყველების ამოცნობა
#asr
#ადაპტერები
#wav2vec2
#mms
#გადაშენების პირას მყოფი ენები
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ხელოვნური ინტელექტი
Anthropic-ის Claude-ის აღზევება Apple App Store-ის რეიტინგებში პენტაგონთან მოლაპარაკებების ფონზე

ხელოვნური ინტელექტი
ტრამპის ადმინისტრაცია Anthropic-ს სანქციებს უწესებს ხელოვნური ინტელექტის გამოყენებაზე უარის გამო: ექსპერტი ინდუსტრიის უსაფრთხოების ხარვეზებზე საუბრობს
ხელოვნური ინტელექტი