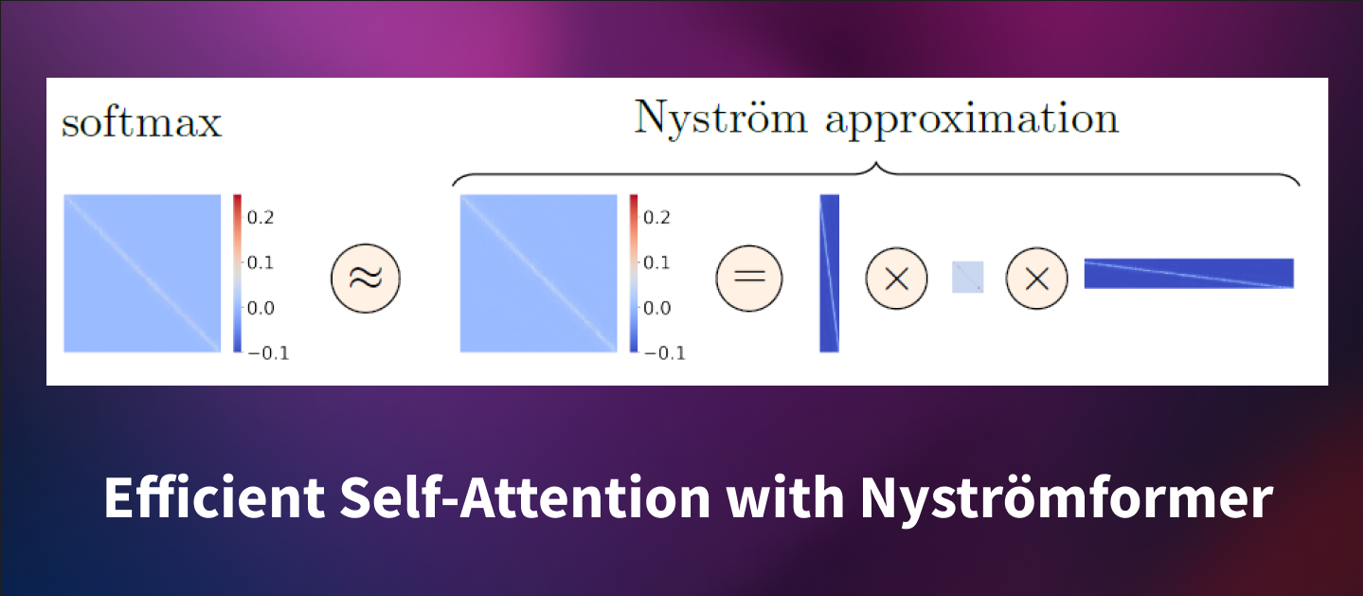
Nyströmformer: ტრანსფორმერების თვითყურადღების მექანიზმის ოპტიმიზაცია ნიუსტრიომის მეთოდით
ტრანსფორმერებმა შთამბეჭდავი შედეგები აჩვენეს ბუნებრივი ენის დამუშავებისა (NLP) და კომპიუტერული ხედვის (CV) ამოცანებში, თუმცა მათი სტანდარტული თვითყურადღების მექანიზმი ხასიათდება O(n²) სირთულით, რაც მის წვრთნას ძვირადღირებულს ხდის გრძელი თანმიმდევრობებისთვის. Nyströmformer წარმოადგენს ეფექტურ ტრანსფორმერულ მოდელს, რომელიც ნიუსტრიომის მეთოდის გამოყენებით სტანდარტულ თვითყურადღებას O(n) სირთულით აპროქსიმირებს. ეს სტატია განმარტავს ნიუსტრიომის მეთოდს და მის ადაპტირებას თვითყურადღების მექანიზმის ოპტიმ
ტრანსფორმერებმა შთამბეჭდავი შედეგები აჩვენეს ბუნებრივი ენის დამუშავების (NLP) და კომპიუტერული ხედვის (CV) სხვადასხვა ამოცანებში. მათი წარმატება განპირობებულია თვითყურადღების (self-attention) მექანიზმით, რომელიც აღბეჭდავს შეტანილი მონაცემების ყველა ტოკენს შორის წყვილთა ინტერაქციებს. თუმცა, სტანდარტულ თვითყურადღების მექანიზმს აქვს O(n²) დროისა და მეხსიერების სირთულე (სადაც n არის შეტანილი თანმიმდევრობის სიგრძე), რაც მის წვრთნას ძვირადღირებულს ხდის გრძელ შეტანილ თანმიმდევრობებზე.
Nyströmformer არის მრავალი ეფექტური ტრანსფორმერული მოდელიდან ერთ-ერთი, რომელიც სტანდარტულ თვითყურადღებას O(n) სირთულით აპროქსიმირებს. Nyströmformer კონკურენტულ შედეგებს აჩვენებს სხვადასხვა NLP და CV ამოცანებში, ამავდროულად აუმჯობესებს სტანდარტული თვითყურადღების ეფექტურობას. ამ ბლოგპოსტის მიზანია მკითხველებს გააცნოს ნიუსტრიომის მეთოდი და აჩვენოს, როგორ შეიძლება მისი ადაპტირება თვითყურადღების აპროქსიმაციისთვის.
Nyströmformer-ის გულში დევს ნიუსტრიომის მეთოდი მატრიცის აპროქსიმაციისთვის. ის საშუალებას გვაძლევს მატრიცის აპროქსიმაციას მისი ზოგიერთი რიგისა და სვეტის შერჩევის გზით. განვიხილოთ P^(n×n) მატრიცა, რომლის სრულად გამოთვლა ძვირადღირებულია. ამის ნაცვლად, ჩვენ მას ნიუსტრიომის მეთოდით ვაპროქსიმირებთ. ვიწყებთ P-დან m რაოდენობის რიგებისა და სვეტების ამოკრებით.
შერჩეული რიგებისა და სვეტების მოწყობა შემდეგნაირად შეგვიძლია: ახლა გვაქვს ოთხი ქვემატრიცა: A_P, B_P, F_P და C_P, შესაბამისად ზომებით m×m, m×(n−m), (n−m)×m და (n−m)×(n−m). m შერჩეული სვეტი მოთავსებულია A_P და F_P-ში, ხოლო m შერჩეული რიგი – A_P და B_P-ში. ამგვარად, A_P, B_P და F_P-ის ელემენტები ჩვენთვის ცნობილია, C_P-ს კი შევაფასებთ. ნიუსტრიომის მეთოდის მიხედვით, C_P განისაზღვრება შემდეგნაირად: C_P = F_P A_P^+ B_P. აქ, + აღნიშნავს მურ-პენროუზის ინვერსს (ანუ ფსევდოინვერსს).
ამრიგად, P-ის ნიუსტრიომის აპროქსიმაცია, P^, შეიძლება გამოიხატოს სამი მატრიცის ნამრავლად. ამის მიზეზი მოგვიანებით გახდება ნათელი.
ჩვენი მიზანია, საბოლოოდ, სტანდარტული თვითყურადღების მექანიზმში softmax მატრიცის აპროქსიმაცია: S = softmax(QK^T/√d). აქ Q და K შესაბამისად აღნიშნავენ queries-სა და keys-ს.
ზემოთ განხილული პროცედურის მიხედვით, ჩვენ ამოვკრებდით m რიგსა და სვეტს S-დან, შევქმნიდით ოთხ ქვემატრიცას და მივიღებდით S^-ს. მაგრამ, რას ნიშნავს S-დან სვეტის ამოკრება? ეს ნიშნავს, რომ თითოეული რიგიდან ერთ ელემენტს ვირჩევთ. გავიხსენოთ, როგორ გამოითვლება S: საბოლოო ოპერაცია არის რიგის მიხედვით softmax. რიგში ერთი ელემენტის საპოვნელად, ჩვენ უნდა გვქონდეს წვდომა ყველა სხვა ელემენტზე (softmax-ის მნიშვნელში). ამიტომ, ერთი სვეტის ამოკრება მოითხოვს, რომ ვიცოდეთ მატრიცის ყველა სხვა სვეტი. შესაბამისად, ჩვენ ვერ გამოვიყენებთ ნიუსტრიომის მეთოდს უშუალოდ softmax მატრიცის აპროქსიმაციისთვის.
S-დან ამოკრების ნაცვლად, ავტორები გვთავაზობენ landmark-ების (ან ნიუსტრიომის წერტილების) ამოკრებას queries-სა და keys-დან. query landmark-ებს და key landmark-ებს შესაბამისად აღვნიშნავთ Q~ და K~-ით. Q~ და K~ შეიძლება გამოყენებულ იქნეს სამი მატრიცის შესაქმნელად, რომლებიც S-ის ნიუსტრიომის აპროქსიმაციაში მოცემულ მატრიცებს შეესაბამება.
განვსაზღვრავთ შემდეგ მატრიცებს: F~ = softmax(QK~^T/√d), A~ = softmax(Q~K~^T/√d)^+ , B~ = softmax(Q~K^T/√d). F~, A~ და B~-ის ზომებია შესაბამისად n×m, m×m და m×n.
S-ის ნიუსტრიომის აპროქსიმაციაში არსებულ სამ მატრიცას ვცვლით ახლად განსაზღვრული მატრიცებით, რათა მივიღოთ ალტერნატიული ნიუსტრიომის აპროქსიმაცია: S^ = F~ A~ B~ = softmax(QK~^T/√d) softmax(Q~K~^T/√d)^+ softmax(Q~K^T/√d). ეს არის softmax მატრიცის ნიუსტრიომის აპროქსიმაცია თვითყურადღების მექანიზმში. ამ მატრიცას ვამრავლებთ values (V)-ზე, რათა მივიღოთ თვითყურადღების წრფივი აპროქსიმაცია. აღსანიშნავია, რომ QK^T ნამრავლი არასოდეს გამოგვითვლია, რითაც თავიდან ავიცილეთ O(n²) სირთულე.
Q-დან და K-დან m რიგის ამოკრების ნაცვლად, ავტორები გვთავაზობენ Q~ და K~-ის აგებას სეგმენტების საშუალო მნიშვნელობების გამოყენებით. ამ პროცედურისას, n ტოკენი დაჯგუფებულია m სეგმენტად და გამოითვლება თითოეული სეგმენტის საშუალო მნიშვნელობა. იდეალურ შემთხვევაში, m გაცილებით მცირეა n-ზე. ნაშრომში მოყვანილი ექსპერიმენტების მიხედვით, მხოლოდ 32 ან 64 landmark-ის შერჩევა კონკურენტულ შედეგებს იძლევა სტანდარტულ თვითყურადღებასთან და სხვა ეფექტურ ყურადღების მექანიზმებთან შედარებით, თუნდაც გრძელი შეტანებისთვისაც კი.
თეგები:
#ხელოვნური ინტელექტი
#მანქანური სწავლება
#ეფექტურობა
#კომპიუტერული ხედვა
#ტრანსფორმერები
#nlp
#ალგორითმები
#nyströmformer
#თვითყურადღება
#ნიუსტრიომის მეთოდი
წყარო: huggingface.co
AI-ით გადამუშავებული
მსგავსი სტატიები

ტექნოლოგიები
Honor Magic V6: უთხელესი დასაკეცი ტელეფონი? პირველი შთაბეჭდილებები
ტექნოლოგიები
Honor Magic V6: ყველაზე თხელი დასაკეცი სმარტფონი და მისი შთამბეჭდავი შესაძლებლობები

ტექნოლოგიები