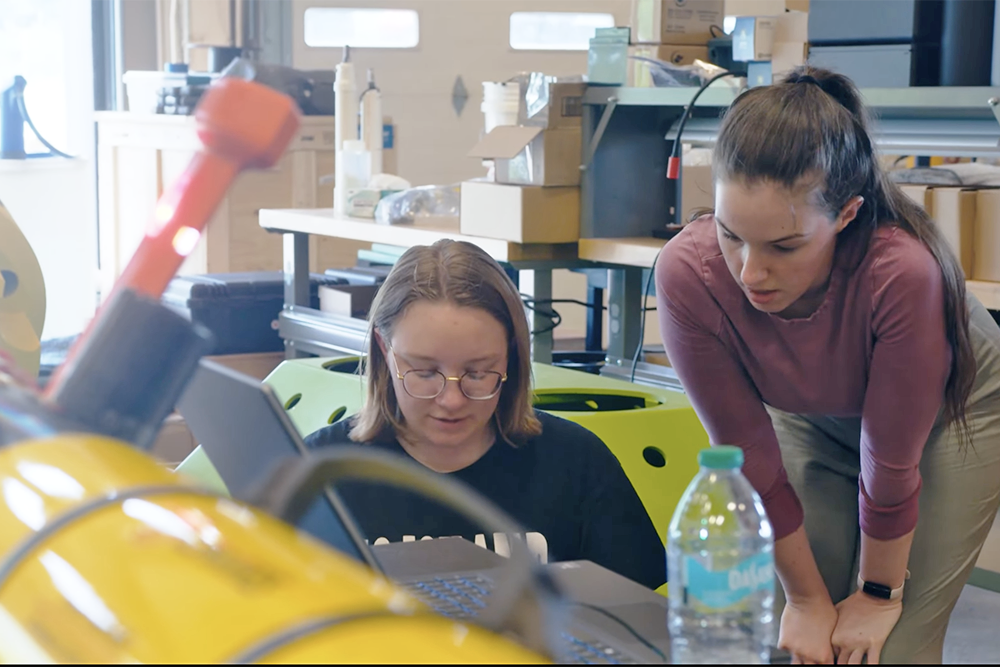
MIT-ის ლინკოლნის ლაბორატორიის სტაჟიორი აივი მანკე წყალქვეშა ნავიგაციის ალგორითმებს ატესტებს
ოლინის საინჟინრო კოლეჯის სტუდენტმა, აივი მანკემ, ზაფხულის სტაჟირება MIT-ის ლინკოლნის ლაბორატორიაში გაიარა, სადაც წყალქვეშა ნავიგაციისთვის განკუთვნილი ალგორითმები პრაქტიკული მეთოდებით შეამოწმა. მან შეიმუშავა და გამოსცადა ალგორითმი, რომელიც ადამიანს და რობოტულ სატრანსპორტო საშუალებას წყალქვეშ ერთობლივ ნავიგაციაში დაეხმარებოდა, მიუხედავად GPS-ის მსგავსი ტრადიციული ლოკალიზაციის საშუალებების არარსებობისა. მისი ნამუშევარი წარმატებით გამოიცადა რეალურ წყალქვეშა გარემოში.
Google-ისა და OpenAI-ის თანამშრომლები AI-ის სამხედრო გამოყენების საზღვრებს ითხოვენ: ღირებულებების კონფლიქტი სილიკონის ველზე
სილიკონის ველზე Google-ისა და OpenAI-ის 200-ზე მეტმა თანამშრომელმა ღიად მოუწოდა დამსაქმებლებს, ნათლად განესაზღვრათ ხელოვნური ინტელექტის სამხედრო მიზნებისთვის გამოყენების საზღვრები. ისინი შეშფოთებულნი არიან AI-ის ორმაგი დანიშნულებითა და ავტონომიური იარაღის სფეროში მისი გამოყენებით, რამაც შეიძლება პასუხისმგებლობის ნაკლებობა გამოიწვიოს. მიუხედავად იმისა, რომ კომპანიებსა და მთავრობებს საკუთარი სტრატეგიული და ეკონომიკური ინტერესები აქვთ, თანამშრომლები ხაზს უსვამენ, რომ AI მხოლოდ ალგორითმები კი არა, ღ
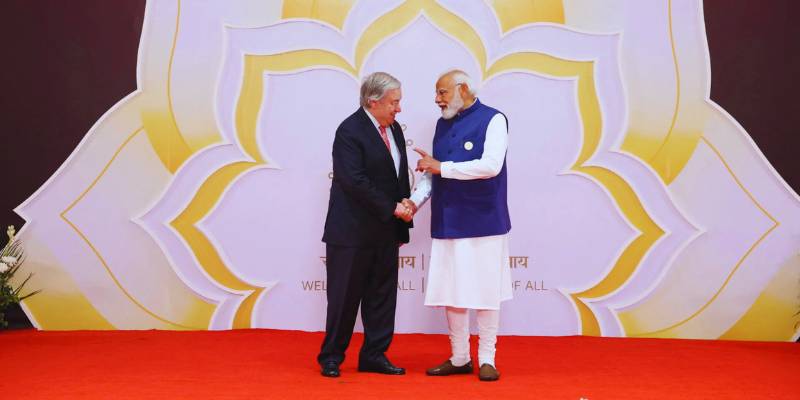
ინდოეთის ხელოვნური ინტელექტის სამიტი: დიპლომატია, ალგორითმები და გლობალური დაძაბულობა
ნიუ დელიში გამართულმა ხელოვნური ინტელექტის სამიტმა ხაზი გაუსვა ხელოვნური ინტელექტის განვითარებაში თანამშრომლობისა და კონკურენციის რთულ ურთიერთკავშირს. მიუხედავად იმისა, რომ ქვეყნები ერთიან სტანდარტებს ითხოვენ, ისინი ასევე იბრძვიან ტექნოლოგიური დომინირებისთვის, რეგულირებისა და ეთიკური საკითხების გადაჭრის გამოწვევების ფონზე. სამიტმა აჩვენა, რომ ხელოვნური ინტელექტი უკვე არა მხოლოდ ტექნოლოგიური, არამედ საგარეო, ეკონომიკური და სოციალური პოლიტიკის საკითხია.
ხელოვნური ინტელექტის რევოლუციური გავლენა სამუშაო ბაზარზე: 2025-2035 წლების პროგნოზი
კვლევის თანახმად, ხელოვნური ინტელექტი 2025-2035 წლებში სამუშაოზე ისეთსავე გავლენას მოახდენს, როგორსაც ინტერნეტი 2000-2010 წლებში. AI-ის დანერგვა უკვე 70%-ს აღემატება, რაც მნიშვნელოვნად ზრდის პროდუქტიულობას, თუმცა ბადებს შეშფოთებას კრეატიულობისა და სანდოობის შესახებ. სტატია აანალიზებს AI-ის გამოყენების მასშტაბებს, ყველაზე სწრაფად მზარდ ინდუსტრიებსა და მომავლის ეკონომიკას, სადაც ადამიანისა და ალგორითმების გამიჯვნა უმნიშვნელო გახდება.
Hugging Face Hub-ის მონაცემთა ნაკრებების მეტამონაცემების გაუმჯობესება მანქანური სწავლების საშუალებით
Hugging Face Hub, როგორც მანქანური სწავლების რესურსების ცენტრალური საცავი, აუმჯობესებს მონაცემთა ნაკრებების მეტამონაცემებს ხელოვნური ინტელექტის გამოყენებით. ახალი ინიციატივის ფარგლებში, მანქანური სწავლების ალგორითმები ამოიცნობენ ენას იმ მონაცემთა ნაკრებებში, რომლებსაც არ აქვთ ენის მეტამონაცემები, ხოლო ავტომატიზებული „ბიბლიოთეკარი-ბოტები“ ამ ინფორმაციას მეტამონაცემებში დაამატებენ. ეს პროექტი მიზნად ისახავს რესურსების მოძიების გაადვილებას და Hub-ზე წარმოდგენილი ენობრივი მიკერძოებების უკეთ გაგებას.
LLM-ის გასწორების ალგორითმების ემპირიული შეფასება: DPO, IPO და KTO
ეს პოსტი წარმოადგენს დიდი ენობრივი მოდელების (LLM) გასწორების სამი პერსპექტიული ალგორითმის — Direct Preference Optimization (DPO), Identity Preference Optimisation (IPO) და Kahneman-Tversky Optimisation (KTO) — ემპირიულ შეფასებას. მასში აღწერილია IPO-ს იმპლემენტაციის მნიშვნელოვანი კორექტირება TRL-ში, რის შემდეგაც IPO DPO-ს თანაბრად ეფექტური აღმოჩნდა და KTO-ს აჯობა შეწყვილებული უპირატესობის პარამეტრებში. შეფასება მოიცავს სხვადასხვა მოდელებსა და ჰიპერპარამეტრებს, რათა დადგინდეს საუკეთესო მიდგომები
აქტორ-კრიტიკოსის მეთოდები ღრმა განმტკიცებით სწავლაში
სტატია განიხილავს აქტორ-კრიტიკოსის მეთოდებს, ჰიბრიდულ მიდგომას ღრმა განმტკიცებით სწავლაში, რომელიც აერთიანებს პოლიტიკაზე დაფუძნებულ და ღირებულებაზე დაფუძნებულ მეთოდებს. ეს მიდგომა მიზნად ისახავს ისეთი პოლიტიკის გრადიენტული ალგორითმების, როგორიცაა Reinforce, მაღალი დისპერსიის პრობლემის გადაჭრას, რაც ხელს უწყობს სწავლის სტაბილიზაციასა და დაჩქარებას. სტატია მოიცავს Advantage Actor Critic (A2C) მეთოდს და მის გამოყენებას რობოტულ გარემოში Stable-Baselines3-ის მეშვეობით.

TRL წარმოგიდგენთ ახალ ალგორითმებს Vision Language მოდელების გასაუმჯობესებლად: MPO, GRPO და GSPO
Vision Language მოდელების (VLM) მუშაობის გაუმჯობესებაზე ფოკუსირებით, TRL-მა წარმოადგინა ინოვაციური ალგორითმები - შერეული პრეფერენციის ოპტიმიზაცია (MPO), ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO) და ჯგუფური თანმიმდევრობის პოლიტიკის ოპტიმიზაცია (GSPO). ეს მეთოდები სცილდება ტრადიციული DPO-ს ფარგლებს, რაც უზრუნველყოფს უფრო მდიდარი სიგნალების ამოღებას მონაცემებიდან, სტაბილურ წვრთნას და მნიშვნელოვან გაუმჯობესებას მოდელების პასუხებში, განსაკუთრებით მულტიმოდალურ ამოცანებში. მათი ინტეგრაცია TRL-ის