
NVIDIA NIM ამარტივებს ხელოვნური ინტელექტის მოდელების, მათ შორის LLM-ების განთავსებას
NVIDIA NIM ინფერენციის მიკროსერვისები მომხმარებლებსა და პარტნიორებს საშუალებას აძლევს, გამარტივებული მიდგომით, სწრაფად და საიმედოდ განათავსონ ხელოვნური ინტელექტის უახლესი მოდელები, განსაკუთრებით დიდი ენობრივი მოდელები (LLM). ის მხარს უჭერს 100 000-ზე მეტ LLM-ს Hugging Face-ზე, მუშაობს ერთ Docker კონტეინერში და უზრუნველყოფს ავტომატურ ოპტიმიზაციას კონფიგურაციის გარეშე. ეს სისტემა მიზნად ისახავს AI ინოვაციების დაჩქარებას NVIDIA-ს აჩქარებულ ინფრასტრუქტურაზე, რაც დეველოპერებსა და საწარმოებს ეხმარება

Ryght Preview-ის ოფიციალური გაშვება: ხელოვნური ინტელექტი ჯანდაცვისა და სიცოცხლის მეცნიერებებისთვის
კომპანია Ryght-ი ოფიციალურად უშვებს Ryght Preview-ს, გენერაციული ხელოვნური ინტელექტის პლატფორმას, რომელიც შექმნილია ჯანდაცვისა და სიცოცხლის მეცნიერებების სექტორისთვის. პლატფორმა მიზნად ისახავს ამ სფეროებში მონაცემთა მოძველებული ანალიზის პრობლემის გადაჭრას, რაც დიდ გუნდებს მოითხოვს. Ryght უზრუნველყოფს სწრაფ და უსაფრთხო ანალიტიკურ მონაცემებს წამლის შექმნის, კლინიკური კვლევებისა და კომერციული საქმიანობის დასაჩქარებლად. კომპანია პარტნიორობს Hugging Face-თან ტექნიკური მხარდაჭერისთვის, რათა მუდმივად ი
Zama-ს Concrete ML: კონფიდენციალურობის დაცვა მანქანურ სწავლებაში Hugging Face-ზე
თვრამეტი თვის წინ Zama-მ შექმნა Concrete ML – მანქანური სწავლების ფრეიმვორკი, რომელიც უზრუნველყოფს მონაცემთა კონფიდენციალურობას სრულად ჰომომორფული დაშიფვრის (FHE) გამოყენებით. ეს კრიპტოგრაფიული ინსტრუმენტი შესაძლებელს ხდის პირდაპირ გამოთვლებს დაშიფრულ მონაცემებზე პირადი გასაღების ცოდნის გარეშე. დღეიდან, Zama-ს წინასწარ კომპილირებული FHE-თან თავსებადი მოდელები ხელმისაწვდომია Hugging Face Endpoints-ზე, რაც მომხმარებლებს საშუალებას აძლევს, ერთი დაწკაპუნებით განათავსონ და გამოიყენონ კონფიდენციალურობ

ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.
LiveCodeBench: ხელოვნური ინტელექტის პროგრამირების აგენტების შეფასების ინოვაციური სისტემა კონტამინაციის პრევენციით
LiveCodeBench არის პლატფორმა, რომელიც აგროვებს კოდირების ამოცანებს სხვადასხვა კონკურსის პლატფორმებიდან და აღნიშნავს მათ გამოშვების თარიღებს. ეს საშუალებას იძლევა მოდელების შეფასებას დროთა განმავლობაში, რაც ხელს უშლის მონაცემთა დაბინძურებას (კონტამინაციას). სტანდარტული კოდის გენერაციის გარდა, LiveCodeBench ასევე აფასებს თვითშეკეთებას, ტესტის შედეგის პროგნოზირებას და კოდის შესრულებას, რაც ჰოლისტურ ხედვას იძლევა AI პროგრამირების აგენტების შესაძლებლობებზე. ამოცანები LeetCode-დან, AtCoder-იდან და Cod
Meta-მ Llama 3 გამოუშვა: ღია ხელმისაწვდომობის ხელოვნური ინტელექტის ახალი თაობა
Meta-მ გამოუშვა Llama 3, ღია წვდომის Llama ოჯახის შემდეგი თაობა, რომელიც ხელმისაწვდომია Hugging Face-ზე. ახალი მოდელი, რომელიც ორი ზომის (8B და 70B) ვარიანტებითაა წარმოდგენილი (როგორც საბაზისო, ისე ინსტრუქციებზე მორგებული), აგრძელებს Meta-ს ერთგულებას ღია AI-ის მიმართ. მნიშვნელოვანი სიახლეები მოიცავს გაფართოებულ 128K ლექსიკონის მქონე ტოკენაიზერს, 8K ტოკენის კონტექსტის სიგრძეს, 8B ვერსიაში Grouped-Query Attention-ის გამოყენებას და Llama Guard 2-ის გამოშვებას უსაფრთხო შინაარსის კლასიფიკაციისთვის.
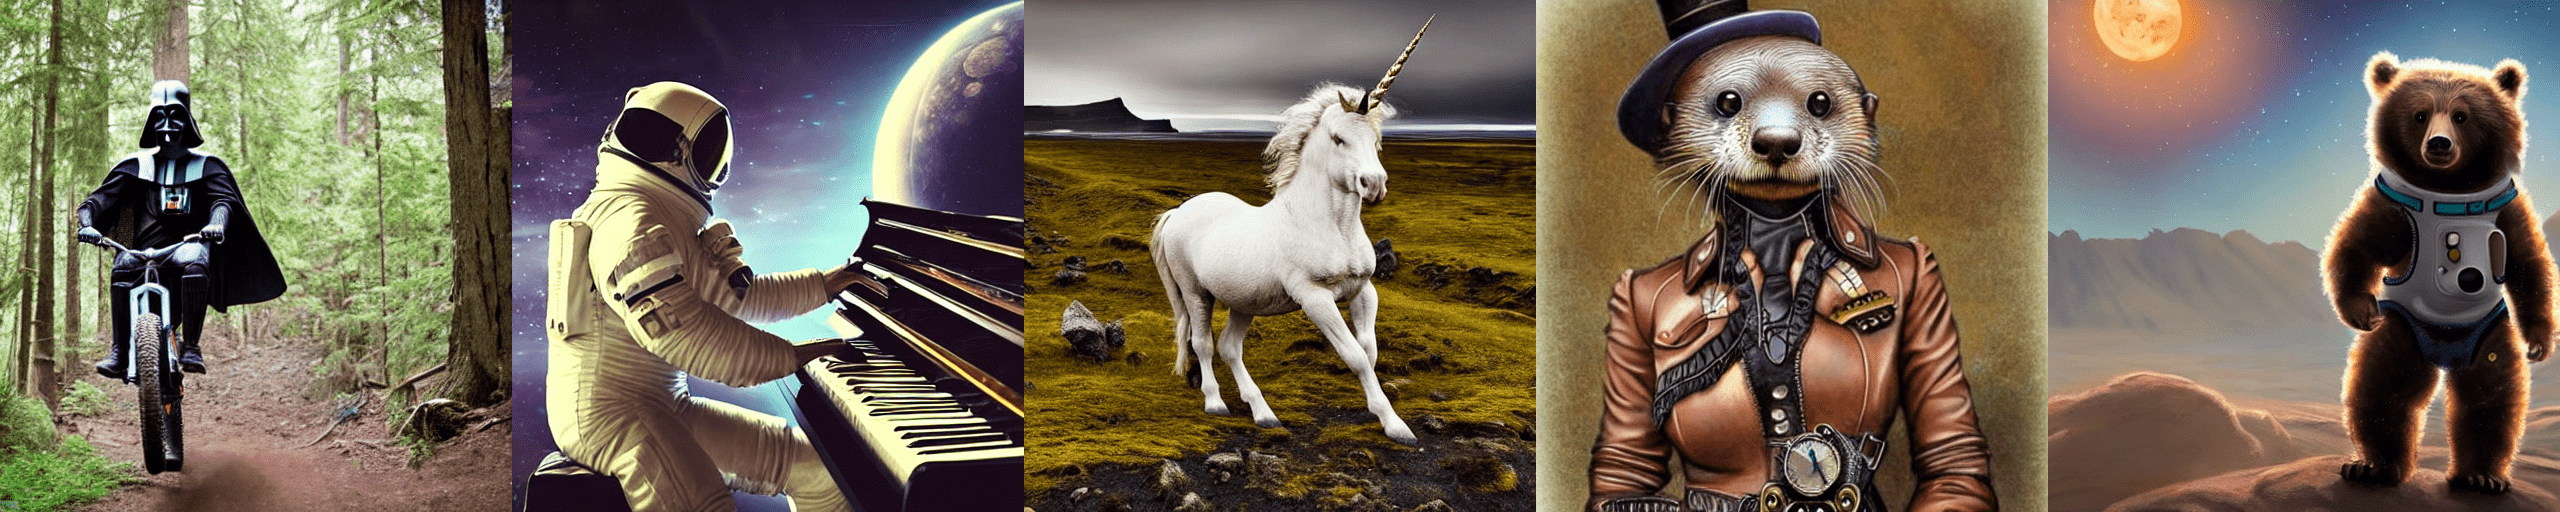
Stable Diffusion: ტექსტიდან გამოსახულების გენერირების მოდელის გამოყენების გზამკვლევი
Stable Diffusion არის მოწინავე ტექსტიდან გამოსახულების გენერირების ლატენტური დიფუზიური მოდელი, შექმნილი CompVis-ის, Stability AI-სა და LAION-ის მკვლევრებისა და ინჟინრების მიერ. ის გაწვრთნილია LAION-5B მონაცემთა ბაზის ქვესიმრავლიდან მიღებულ 512x512 ზომის სურათებზე. ეს სტატია დეტალურად განმარტავს, თუ როგორ გამოვიყენოთ Stable Diffusion 🧨 Diffusers ბიბლიოთეკასთან ერთად, როგორ მუშაობს მოდელი და როგორ შეიძლება მისი გენერირების კონვეიერის მორგება. ასევე განხილულია ლიცენზირების, ინფერენციის ნაბიჯების, g

მოდელების ეფექტური ვარჯიში: პარალელიზმის სტრატეგიების მიმოხილვა Accelerate-სა და Axolotl-ში
ეს სტატია განიხილავს მოდელების ვარჯიშის პარალელიზმის სხვადასხვა სტრატეგიას, მათ შორის მონაცემთა პარალელიზმს (DP) და სრულად დაშარდულ მონაცემთა პარალელიზმს (FSDP), აქცენტს აკეთებს მათ მუშაობის პრინციპებზე, უპირატესობებსა და გამოყენების შემთხვევებზე. განხილულია, თუ როგორ შეიძლება ამ ტექნიკების ინტეგრირება Accelerate-სა და Axolotl-ის ბიბლიოთეკებში, როგორ უნდა მოხდეს მათი კომბინირება და რა გამოწვევები არსებობს დიდ მოდელებთან მუშაობისას, განსაკუთრებით კომუნიკაციის დანახარჯების მინიმიზაციის კუთხით მრავ
Stable Diffusion-ის რევოლუციური განახლებები: გამოსახულებიდან გამოსახულების გენერაცია, ოპტიმიზაცია და საზოგადოების წვლილი
Hugging Face-ის Stable Diffusion-ის უახლესი განახლებები მოიცავს დიდი ხნის ნანატრი ფუნქციებს, როგორიცაა გამოსახულებიდან გამოსახულების გენერაცია, ტექსტუალური ინვერსია და ინფეინთინგი. ასევე, წარმოდგენილია მნიშვნელოვანი ოპტიმიზაციები VRAM-ის გამოყენებისთვის, M1/M2 ჩიპების მხარდაჭერა და ONNX-თან თავსებადობა. გამოვიდა გაუმჯობესებული დოკუმენტაცია, ხოლო საზოგადოებამ შექმნა მრავალი ინოვაციური ინსტრუმენტი, როგორიცაა Stable Diffusion Videos და Waifu Diffusion.

Hugging Face-ის AI Sheets: ხელოვნური ინტელექტის უკოდო ინსტრუმენტი მონაცემთა ნაკრებების შექმნისა და მართვისთვის
Hugging Face-მა წარმოადგინა AI Sheets – ახალი, ღია წყაროს მქონე უკოდო ინსტრუმენტი, რომელიც მომხმარებლებს საშუალებას აძლევს შექმნან, გაამდიდრონ და გარდაქმნან მონაცემთა ნაკრებები ხელოვნური ინტელექტის მოდელების გამოყენებით. ის ინტეგრირებულია Hugging Face Hub-თან და გთავაზობთ ათასობით ღია მოდელის გამოყენების შესაძლებლობას სწრაფი ექსპერიმენტებისა და მონაცემთა დამუშავებისთვის. ინსტრუმენტი გამოირჩევა მარტივი, ცხრილის მსგავსი ინტერფეისით და ხელს უწყობს ეფექტურ მუშაობას როგორც მცირე, ისე მსხვილ მონაცემთა

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს
LLM-ის მუშაობის ლიდერბორდი: სიჩქარე, ფასი და ხარისხი AI აპლიკაციებისთვის Hugging Face-ზე
Artificial Analysis-მა გამოაქვეყნა LLM-ის მუშაობის ლიდერბორდი Hugging Face-ზე, რომელიც აფასებს 100-ზე მეტი უსერვერო LLM API ენდპოინტის სიჩქარეს, ფასსა და ხარისხს. ეს ინსტრუმენტი მიზნად ისახავს AI ინჟინრებს დაეხმაროს გადაწყვეტილებების მიღებაში, თუ რომელი მოდელები და პროვაიდერები გამოიყენონ თავიანთ აპლიკაციებში, რადგან სამომხმარებლო და კომპლექსური AI სისტემებისთვის მუშაობის ეს ფაქტორები კრიტიკულია.
Hugging Face-ის ვალდებულება ეთიკური ხელოვნური ინტელექტისადმი: ღია თანამშრომლობა და ახალი საინფორმაციო ბიულეტენი
Hugging Face, რომელიც ღია წყაროს კომპანიად ჩამოყალიბდა, ტექნოლოგიების სფეროში ძირითადი ეთიკური ღირებულებების, როგორიცაა თანამშრომლობა, პასუხისმგებლობა და გამჭვირვალობა, საფუძველზეა დაფუძნებული. კომპანია აქტიურად ავითარებს ხელოვნური ინტელექტის (AI) ეთიკურ ასპექტებს, სადაც რეპროდუცირებადობა, აუდიტირებადობა და სისტემების გაგება ცენტრალურ ადგილს იკავებს. ამ ძალისხმევის ფარგლებში, Hugging Face-მა ახლახან გამოუშვა საინფორმაციო ბიულეტენი „ეთიკა და საზოგადოება“, რომელიც მიზნად ისახავს AI-ს ეთიკური საკით
ახალი ლიდერთა დაფა ებრაული ენის LLM-ებისთვის: ნიუანსების შეფასება
ებრაული ენის მორფოლოგიური სირთულის გამო, არსებულ დიდ ენობრივ მოდელებს (LLM) უჭირთ მისი ნიუანსების ზუსტად დამუშავება. ამ ხარვეზის შესავსებად, შეიქმნა ახალი ლიდერთა დაფა, რომელიც სპეციალიზებულ შეფასების ეტალონებს გვთავაზობს ებრაული ენის LLM-ებისთვის. პლატფორმა მოიცავს ოთხ ძირითად მონაცემთა ნაკრებს: კითხვა-პასუხი, განწყობის სიზუსტე, ვინოგრადის სქემის გამოწვევა და თარგმანი. ინიციატივა მიზნად ისახავს მკვლევრებისა და დეველოპერების გაერთიანებას, ღია საზოგადოების წახალისებას და ისრაელის ტექნოლოგიური საზ

TextQuests: ახალი ბენჩმარკი ხელოვნური ინტელექტის აგენტების შესაძლებლობების შესაფასებლად
ახალი ბენჩმარკი, TextQuests, იყენებს 25 კლასიკურ Infocom-ის ინტერაქციულ მხატვრულ თამაშს, რათა შეაფასოს ხელოვნური ინტელექტის აგენტების უნარი, იმუშაონ ავტონომიურად რთულ საძიებო გარემოში. იგი ავლენს LLM-ების გამოწვევებს ხანგრძლივი კონტექსტის გაგებაში, როგორიცაა ჰალუცინაციები და სივრცითი მსჯელობის სირთულეები.
როგორ გავუშვათ მასშტაბური ენობრივი მოდელები მომხმარებლის აპარატურაზე: Hugging Face-ის Accelerate
Meta AI-მ და BigScience-მა ცოტა ხნის წინ საჯაროდ ხელმისაწვდომი გახადეს ძალიან დიდი ენობრივი მოდელები, რომლებიც მომხმარებლის უმეტესი აპარატურის მეხსიერებაში (RAM ან GPU) არ ეტევა. Hugging Face-ის Accelerate ბიბლიოთეკა გვთავაზობს ინოვაციურ გადაწყვეტებს, მათ შორის PyTorch-ის „მეტა მოწყობილობის“ გამოყენებას და ავტომატურ მოწყობილობათა რუკას, რათა შესაძლებელი გახდეს ამ მოდელების ეფექტურად ჩატვირთვა და გაშვება შეზღუდული RAM-ისა და GPU მეხსიერების პირობებშიც კი. ეს მეთოდები საშუალებას იძლევა უზარმაზარი

Arm KleidiAI და SDOT: გენერაციული ხელოვნური ინტელექტი მილიარდობით მოწყობილობაზე, მათ შორის ძველ მოდელებზეც
Arm-ის KleidiAI, SDOT CPU ფუნქციის გამოყენებით, გენერაციულ ხელოვნურ ინტელექტს (GenAI) ხელმისაწვდომს ხდის მოწყობილობების ფართო სპექტრზე – უახლესი ფლაგმანური მოდელებიდან დაწყებული, ხუთ წლამდე ძველი სმარტფონებითა და Raspberry Pi 5-ით დამთავრებული. ეს მიიღწევა პოპულარულ AI ფრეიმვორკებში ჩაშენებული ოპტიმიზაციებით და ExecuTorch 0.7 ბეტაში ნაგულისხმევი ჩართვით, რაც უზრუნველყოფს დიდი ენობრივი მოდელების (LLM) ეფექტურ მუშაობას კოდის შეცვლის გარეშე და მნიშვნელოვანი წარმადობის გაუმჯობესებით.

ღია არაბული LLM ლიდერბორდი (OALL): AI-ს განვითარება არაბულენოვანი სამყაროსთვის
ღია არაბული LLM ლიდერბორდი (OALL) არის ინიციატივა, რომელიც მიზნად ისახავს არაბული დიდი ენობრივი მოდელების (LLM) შეფასებასა და გაუმჯობესებას. პროექტი ემსახურება მსოფლიოში 380 მილიონზე მეტ არაბულენოვან მომხმარებელს, სთავაზობს ყოვლისმომცველ შეფასების სისტემას მრავალფეროვანი მონაცემთა ნაკრებებისა და სპეციფიკური მეტრიკების გამოყენებით. OALL-ის მიზანია შექმნას მოდელები, რომლებიც ზუსტად იქნება მორგებული არაბული ენის, კულტურისა და მემკვიდრეობის ნიუანსებზე, სამომავლო გეგმებით, გააფართოვოს ბენჩმარკები და
Google-მა წარმოადგინა PaliGemma: ვიზუალური ენობრივი მოდელების ახალი თაობა
Google-მა წარმოადგინა PaliGemma, ვიზუალური ენობრივი მოდელების ახალი ოჯახი, რომელსაც შეუძლია გამოსახულებისა და ტექსტის კომბინირებული დამუშავება ტექსტის გენერირებისთვის. ეს ინოვაციური მოდელი SigLIP-ის გამოსახულების ენკოდერსა და Gemma-2B-ის ტექსტის დეკოდერს აერთიანებს, რაც მას მძლავრ ინსტრუმენტად აქცევს. PaliGemma ხელმისაწვდომია სხვადასხვა ტიპის, რეზოლუციისა და სიზუსტის ვარიანტებში და უზრუნველყოფს ფართო შესაძლებლობებს, მათ შორის გამოსახულების აღწერას, კითხვებზე პასუხის გაცემას, ობიექტის ამოცნობასა

Hugging Face-ი და AMD ხელოვნური ინტელექტის განვითარებას AMD Instinct MI300 GPU-ების ინტეგრაციით აძლიერებენ
Hugging Face-ი და AMD აცხადებენ თანამშრომლობის გაფართოებას უახლესი თაობის AMD Instinct MI300 GPU სერვერების Hugging Face პლატფორმაში სრულფასოვანი ინტეგრაციის მიზნით. ეს ნაბიჯი დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ და მაქსიმალური წარმადობით გამოიყენონ ხელოვნური ინტელექტის მოდელები, კოდის შეცვლის გარეშე, ადგილობრივი გარემოდან დაწყებული Azure-ის საწარმოო ვირტუალურ მანქანებამდე. ინტეგრაცია მოიცავს CI/CD-ის გაუმჯობესებას, TGI-ის (text-generation-inference) ოპტიმიზაციას Meta Llama ოჯახი
MTEB: საუკეთესო ტექსტური ემბედინგის მოდელების ყოვლისმომცველი პლატფორმა და შეფასება
MTEB არის ყოვლისმომცველი ლიდერბორდი და ბენჩმარკინგის პლატფორმა, რომელიც აფასებს ტექსტური ემბედინგის მოდელებს მრავალფეროვან ამოცანებსა და მონაცემთა ნაკრებებზე. ის ეხმარება მომხმარებლებს იპოვონ საუკეთესო მოდელი მათი საჭიროებებისთვის, გამოირჩევა მასიურობით (56 მონაცემთა ნაკრები 8 ამოცანაში), მრავალენოვნებით (112-მდე ენა) და გაფართოებადობით. სტატია განმარტავს ტექსტური ემბედინგის მნიშვნელობას, MTEB-ის მახასიათებლებს და მოდელების შერჩევის კრიტერიუმებს, სიჩქარისა და შესრულების ჩათვლით.
დღეს წარვადგენთ Dell Enterprise Hub-ს: ღია მოდელების მარტივი წვრთნა და განთავსება Dell-ის პლატფორმებზე
Dell Enterprise Hub, Hugging Face-ის ახალი შეთავაზება, ამარტივებს ღია ხელოვნური ინტელექტის მოდელების (როგორიცაა Llama 3 და Mixtral) ლოკალურ წვრთნასა და განთავსებას Dell-ის პლატფორმების გამოყენებით. ის კვირების საინჟინრო სამუშაოს წუთებამდე ამცირებს, გვთავაზობს შერჩეულ მოდელებს და უზრუნველყოფს უსაფრთხო, შესაბამის დახვეწასა და განთავსებას საწარმოს გარემოში.

Google-მა გამოუშვა EmbeddingGemma: უახლესი მულტილინგვური ჩაშენების მოდელი მოწყობილობებისთვის
Google-მა წარადგინა EmbeddingGemma, უახლესი მულტილინგვური ჩაშენების მოდელი, რომელიც ოპტიმიზებულია მოწყობილობებზე გამოსაყენებლად. 308 მილიონი პარამეტრით და 2K კონტექსტური ფანჯრით, ის მხარს უჭერს 100-ზე მეტ ენას და MTEB ბენჩმარკზე 500M-ზე ნაკლებ მოდელებს შორის ყველაზე მაღალრეიტინგულია. მოდელი შექმნილია სიჩქარისა და ეფექტურობისთვის, მნიშვნელოვნად აფართოებს მობილური RAG კონვეიერების შესაძლებლობებს და ინტეგრირებულია პოპულარულ AI ხელსაწყოებთან.

Together AI და Hugging Face LLM-ების ოპტიმიზაციას ამარტივებენ: ახალი ინტეგრაცია გამოცხადდა
Together AI და Hugging Face აცხადებენ ახალ ინტეგრაციას, რომელიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე არსებული ნებისმიერი თავსებადი დიდი ენობრივი მოდელის (LLM) დაზუსტებულ წვრთნას (ფაინ-ტუნინგი) Together AI-ის ინფრასტრუქტურის გამოყენებით. ეს ინოვაცია გუნდებს საშუალებას აძლევს, მარტივად მოარგონ მოდელები საკუთარ საჭიროებებს, შეამცირონ ხარჯები და დააჩქარონ განვითარების ციკლები, გვერდის ავლით ტრადიციულად რთულ და ძვირადღირებულ ინფრასტრუქტურას. ინტეგრაცია აგვარებს გავრცელებულ პრობლემას, როდესაც