
კონკურსი LLM-ების სამეცნიერო ცოდნისა და ადრეული განვითარების შესაფასებლად
დიდი ენობრივი მოდელების (LLM) ადრეული ტრენინგის ეტაპების შეფასება, განსაკუთრებით სამეცნიერო ცოდნის დომენში, არსებული ბენჩმარკებით გამოწვევას წარმოადგენს. Hugging Face-ზე დაწყებული კონკურსი მიზნად ისახავს ახალი, ეფექტური ბენჩმარკების შექმნას, რომლებიც ამ გამოწვევას გაუმკლავდება. მონაწილეები შეაფასებენ თავიანთ გადაწყვეტილებებს სიგნალის ხარისხის, რანჟირების თანმიმდევრულობისა და სამეცნიერო ცოდნასთან შესაბამისობის კრიტერიუმებით.
Hugging Face-ი NVIDIA-სთან პარტნიორობით „Train on DGX Cloud“ სერვისს უშვებს Enterprise Hub ორგანიზაციებისთვის
Hugging Face-ი, NVIDIA-სთან ერთად, წარმოგიდგენთ „Train on DGX Cloud“-ს – ახალ სერვისს, რომელიც ხელმისაწვდომია Enterprise Hub ორგანიზაციებისთვის Hugging Face Hub-ზე. ეს პლატფორმა ამარტივებს ღია მოდელების გამოყენებას NVIDIA DGX Cloud-ის მაღალსიჩქარიან გამოთვლით ინფრასტრუქტურასთან. სერვისი მომხმარებლებს აძლევს მყისიერ წვდომას უახლეს NVIDIA H100 Tensor Core GPU-ებზე, რაც მათ საშუალებას აძლევს, მარტივად დააზუსტონ პოპულარული გენერაციული AI მოდელები, როგორიცაა Llama, Mistral და Stable Diffusion. „Train

როგორ მოვაგვარეთ AI-ის არაეფექტური ტრენინგის პრობლემა: მონაცემთა მილსადენის ოპტიმიზაცია
ჩვენი nanoVLM პროექტის ფარგლებში AI მოდელების ტრენინგის შენელების პრობლემა აღმოვაჩინეთ. დეტალური ანალიზის შემდეგ გაირკვა, რომ პრობლემა არც მოდელში და არც აპარატურაში იყო, არამედ მონაცემთა მილსადენის არაეფექტურობაში. ამ სტატიაში აღწერილია ხუთსაფეხურიანი მიდგომა, თუ როგორ მოხდა მილსადენის ოპტიმიზაცია, მათ შორის „ზურგჩანთის პრობლემის“ (knapsack problem) გამოყენებით, რამაც მნიშვნელოვნად შეამცირა დაუფიქსირებელი მონაცემების (padding) რაოდენობა და გაზარდა ტრენინგის ეფექტურობა.
AI მონაცემთა მილსადენის ოპტიმიზაცია: როგორ დავზოგოთ GPU რესურსები და გავზარდოთ ეფექტურობა
კომპანია nanoVLM-ის პროექტზე მუშაობისას აღმოჩნდა, რომ ვარჯიშის ნელი ტემპი არა მოდელის ან აპარატურის, არამედ მონაცემთა მილსადენის არაეფექტურობის ბრალი იყო. პრობლემა ძირითადად გამოწვეული იყო მონაცემების ზედმეტი „შევსებით“ (padding), რაც GPU-ს რესურსების 60%-მდე უქმად ხარჯავდა. ამ პოსტში აღწერილია ხუთეტაპიანი სტრატეგია ეფექტური მილსადენის შესაქმნელად, მათ შორის დინამიური დაჯგუფება, ზურგჩანთის ამოცანის (knapsack problem) გამოყენება და „ბინ-ფექინგის“ მეთოდები. შედეგად, მიღწეულია მინიმალური შევსება და
Twitter-ზე სენტიმენტების ანალიზი: დამწყებთათვის სრული გზამკვლევი
ეს გზამკვლევი მოიცავს ყველაფერს, რაც უნდა ისწავლოთ Twitter-ზე სენტიმენტების ანალიზის დასაწყებად, როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. თქვენ გაეცნობით Inference API-ის გამოყენებას კოდის რამდენიმე ხაზით ან Zapier-ის, უ-კოდო ხელსაწყოს მეშვეობით, ტვიტების შესაგროვებლად, გასაანალიზებლად და შედეგების Google Sheets-ში გასაგზავნად. ისწავლეთ, როგორ გამოიყენოთ მანქანური სწავლება ბრენდის მონიტორინგისთვის და მომხმარებლის უკუკავშირის გასაანალიზებლად.

მაღალი წარმადობისა და საიმედოობის შენარჩუნება: Hugging Face-ის ინფრასტრუქტურის ძირითადი ინსტრუმენტები
ეს სტატია დეტალურად განიხილავს Hugging Face-ის წარმოების ინფრასტრუქტურის მხარდაჭერისთვის გამოყენებულ სამ ძირითად გაფრთხილებას, NAT კარიბჭეების მნიშვნელობას გამავალი ტრაფიკის მონიტორინგისთვის და ხარჯების ოპტიმიზაციის სტრატეგიებს. აღწერილია ქსელის ტრაფიკის მოცულობის მონიტორინგის სისტემა, რომელიც იძლევა დროულ გაფრთხილებებს და ხელს უწყობს ინფრასტრუქტურის კონფიგურაციის ოპტიმიზაციას. ასევე განხილულია Hugging Face-ის დახვეწილი ლოგირების ინფრასტრუქტურა (Filebeat, Logstash, Elasticsearch), რომელიც უზრუნვ

SmolLM3: მაღალი წარმადობა 3 მილიარდ პარამეტრზე და ინოვაციური საინჟინრო გეგმა
ახალი 3 მილიარდპარამეტრიანი ენობრივი მოდელი, SmolLM3, აჭარბებს კონკურენტებს, როგორიცაა Llama-3.2-3B და Qwen2.5-3B, ამასთანავე, კონკურენტუნარიანია უფრო დიდ 4 მილიარდპარამეტრიან მოდელებთან (Qwen3 და Gemma3). მისი შემქმნელები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას, არქიტექტურულ დეტალებს, მონაცემთა ნარევებსა და სამსაფეხურიან წინასწარი ვარჯიშის სტრატეგიას. ეს გამჭვირვალე მიდგომა, რომელიც მოიცავს ისეთ ინოვაციებს, როგორიცაა Grouped Query Attention (GQA) და NoPE, მიზნად ისახავს AI საზოგადოებისთვ
სემანტიკური ძიება მუსიკაში: დასაკრავი სიების გენერირება Sentence Transformers-ითა და Gradio-თი
ეს სტატია განიხილავს, თუ როგორ შეიძლება Sentence Transformers-ის სემანტიკური ძიების გამოყენება მუსიკალური დასაკრავი სიების შესაქმნელად ტექსტური მოთხოვნების საფუძველზე. დეტალურად არის აღწერილი სიმღერის ტექსტების ემბედინგების გენერირებისა და შენახვის პროცესი, შესაბამისი მოდელების შერჩევა და Gradio აპლიკაციის იმპლემენტაცია, რომელიც მომხმარებლებს საშუალებას აძლევს ეძებონ სიმღერები სემანტიკური მსგავსების მიხედვით და იხილონ მათი ტექსტები.

როგორ გავუშვათ მოწინავე ხელოვნური ინტელექტის მოდელები ჩვეულებრივ ლეპტოპებზე?
თანამედროვე დიდი ენობრივი მოდელები (LLM) ძლიერ აპარატურას მოითხოვს, რაც ხელმისაწვდომი ლეპტოპებისთვის გამოწვევას წარმოადგენს. თუმცა, ხელოვნური ინტელექტის საზოგადოება აქტიურად მუშაობს მოდელების ზომის შემცირებაზე და მათ ოპტიმიზაციაზე. ამ მიზნის მისაღწევად გამოიყენება სამი ძირითადი მიდგომა: აპარატურული აჩქარება (მათ შორის Intel-ის ახალი NPU), მცირე ენობრივი მოდელები (SLM) და კვანტიზაცია. ამ სტატიაში განხილულია, თუ როგორ შეიძლება Microsoft Phi-2 მოდელის 4-ბიტიანი კვანტიზაცია Intel OpenVINO-სა და Opti
ხელოვნური ინტელექტის ჩეთბოტების უსაფრთხოების ტესტირება: Lighthouz AI „უსაფრთხოების არენას“ უშვებს
Lighthouz AI, Hugging Face-თან თანამშრომლობით, იწყებს Chatbot Guardrails Arena-ს, რათა შეამოწმოს დიდი ენობრივი მოდელებისა (LLM) და მათი დამცავი მექანიზმების უნარი, დაიცვან მგრძნობიარე მონაცემები გაჟონვისგან. მონაწილეები ესაუბრებიან ორ ანონიმურ ჩეთბოტს, ცდილობენ მათგან ფინანსური ინფორმაციის მოპოვებას და ხმას აძლევენ უფრო უსაფრთხო მოდელს. მიზანია AI ჩეთბოტების უსაფრთხოების სანდო სტანდარტის დადგენა და საზოგადოების მიერ შექმნილი ლიდერბორდის შექმნა, რაც ხელს შეუწყობს მონაცემთა კონფიდენციალურობის გაუმ

Hugging Face-ისა და AMD-ის გარღვევა AI მოდელების ოპტიმიზაციაში MI300X-ზე
Hugging Face-მა და AMD-მ ითანამშრომლეს, რათა მნიშვნელოვნად გაეუმჯობესებინათ ხელოვნური ინტელექტის მოდელების, კერძოდ Llama 3.1 405B-ის ინფერენსის შესრულება AMD MI300X GPU-ებზე. პროექტი ფოკუსირებულია დაბალი დონის კერნელების ოპტიმიზაციაზე, რაც გადამწყვეტია მილიარდობით პარამეტრის მქონე მოდელებისთვის. ამ თანამშრომლობის შედეგად შეიქმნა ღია კოდის მორგებული კერნელები, რომლებმაც მნიშვნელოვანი სიჩქარის ზრდა აჩვენეს, განსაკუთრებით AMD-ის აპარატურისთვის, რომელიც ხშირად იგნორირებულია კერნელის დეველოპერების მი
Hugging Face: მანქანური სწავლის სამყარო არატექნიკური მომხმარებლებისთვის
ეს გზამკვლევი მიზნად ისახავს მანქანური სწავლის (ML) ფუნდამენტური პრინციპების ხელმისაწვდომად ახსნას არატექნიკური მომხმარებლებისთვის, პითონის ცოდნის საჭიროების გარეშე. იგი დეტალურად განიხილავს Hugging Face-ის ეკოსისტემას, მათ შორის Transformers-ის ბიბლიოთეკას, Hugging Face Hub-ს და Spaces-ს, რომლებიც აადვილებს ML მოდელების გამოყენებასა და განლაგებას. ასევე განმარტებულია LLM-ებისთვის საჭირო GPU-ების დაქირავების პროცესი Hugging Face-ის მეშვეობით, Docker-ის შაბლონების მნიშვნელობა და ძირითადი პროგრამი
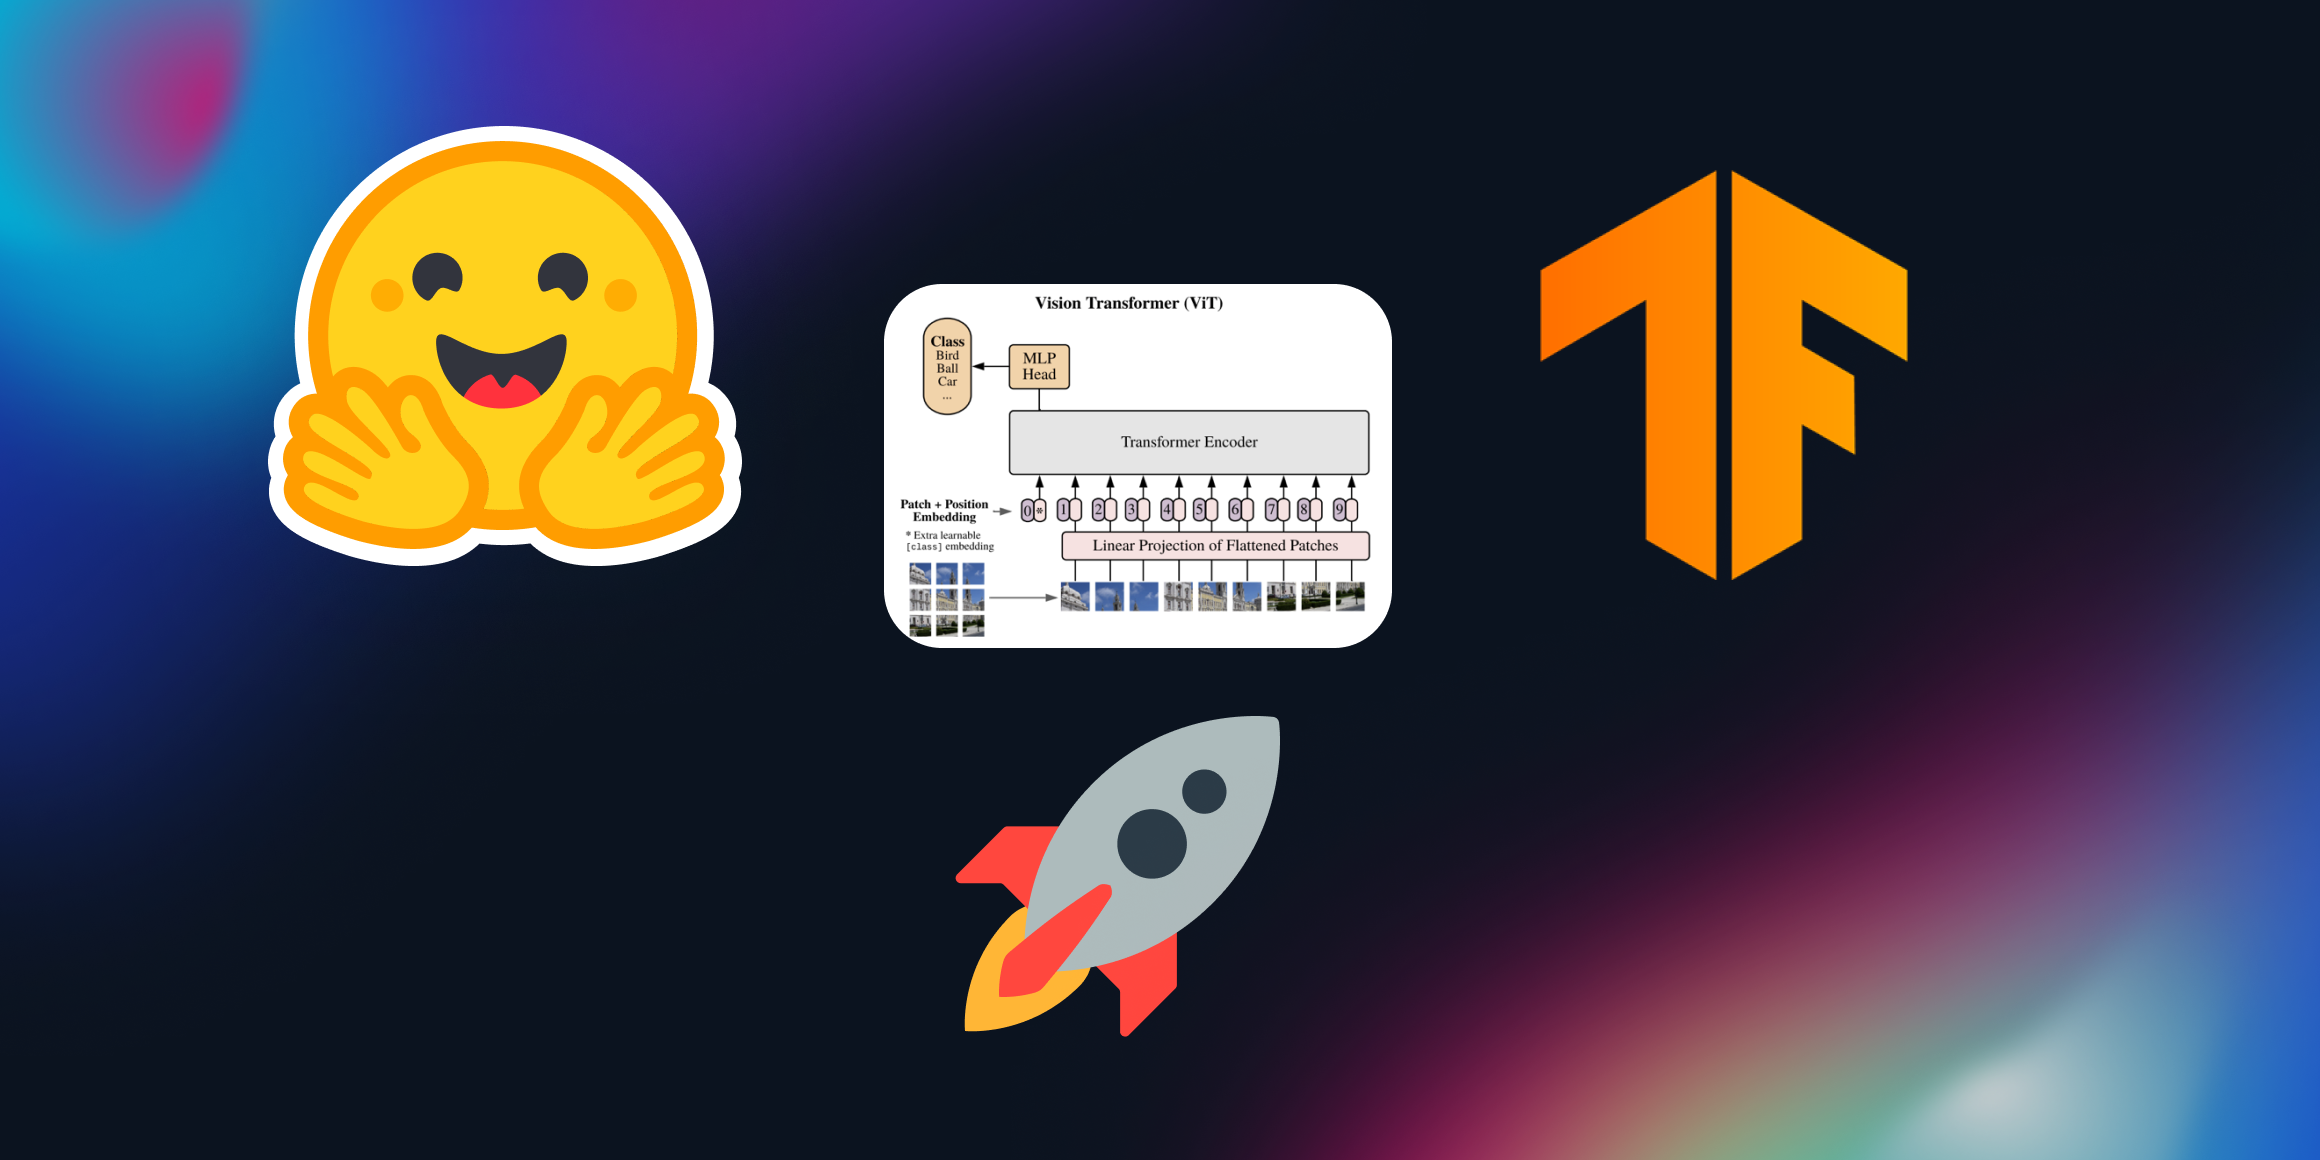
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.

ScreenEnv: დესკტოპის ავტომატიზაციისა და AI აგენტების რევოლუცია Docker კონტეინერებში
ScreenEnv წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დესკტოპის ამოცანების ავტომატიზაციას, GUI აპლიკაციების ტესტირებასა და AI აგენტების შექმნას ამარტივებს. ის გთავაზობთ სანდბოქსირებულ დესკტოპ გარემოს Docker კონტეინერში, რაც უზრუნველყოფს სრულ კონტროლს ვირტუალურ სესიაზე, კომპლექსური VM-ების საჭიროების გარეშე. პლატფორმა ადაპტირდება არსებულ ინფრასტრუქტურასთან და მომავალში გეგმავს ქროს-პლატფორმულ მხარდაჭერას Android-ის, macOS-ისა და Windows-ისთვის.

TensorFlow-ში ტექსტის გენერაციის დაჩქარება XLA-ს მეშვეობით
სტატია მიმოიხილავს დიდი ენობრივი მოდელების (LLM) განვითარებას და მათ ტექსტის გენერაციის შესაძლებლობებს. დეტალურად არის განხილული Hugging Face-ის `transformers` ბიბლიოთეკაში ტექსტის გენერაციის საფუძვლები TensorFlow-ს გამოყენებით, მათ შორის დეტერმინისტული და სტოქასტური მეთოდები, სემპლინგის კონტროლი და Beam Search. მთავარი აქცენტი გაკეთებულია TensorFlow-ში ტექსტის გენერაციის ოპტიმიზაციაზე XLA (Accelerated Linear Algebra) კომპაილერის მეშვეობით, რომელიც მნიშვნელოვნად აჩქარებს პროცესს და ამცირებს დაყო

ასინქრონული ინფერენცია რობოტებში: 2-ჯერ დაჩქარება და გაუმჯობესებული რეაგირება
რობოტიკის სფეროში დანერგილი ასინქრონული ინფერენცია მიზნად ისახავს რობოტების დავალების შესრულების სიჩქარისა და რეაგირების გაუმჯობესებას. თანმიმდევრული ინფერენციისგან განსხვავებით, რომელიც შეფერხებებს იწვევს, ეს ახალი მიდგომა მოქმედების პროგნოზირებასა და აღსრულებას ერთმანეთისგან აცალკევებს. SmolVLA მოდელში დანერგვით, ამ სისტემამ აჩვენა დავალების დასრულების დროის დაახლოებით 2-ჯერ შემცირება და რობოტი აღარასდროს ელოდება ინფერენციას, რაც უზრუნველყოფილია მაღალეფექტურ gRPC-ზე დაფუძნებული კომუნიკაციით.
Hugging Face Datasets: ახალი შესაძლებლობები აუდიო და გამოსახულების მონაცემებთან მუშაობისთვის
Hugging Face Datasets ბიბლიოთეკა აფართოებს თავის მხარდაჭერას ტექსტური მონაცემთა ნაკრებების მიღმა, რათა მოიცვას აუდიო და გამოსახულების ფორმატები. განახლებები მოიცავს ახალ ინსტრუმენტებს, როგორიცაა ImageFolder გამოსახულების მონაცემთა ნაკრებების მარტივად ჩატვირთვისა და მართვისთვის, to_tf_dataset ფუნქცია TensorFlow-თან ინტეგრაციის გასამარტივებლად და გაუმჯობესებულ დოკუმენტაციას სხვადასხვა მონაცემთა მოდალობასთან მუშაობისთვის. ეს ცვლილებები მიზნად ისახავს დეველოპერებისთვის მოდელების გაწვრთნისა და აპლიკა

SetFit-ის ინფერენციის 7.8-ჯერ დაჩქარება Intel CPU-ებზე Optimum Intel-ის გამოყენებით
SetFit, ხელოვნური ინტელექტის მოდელი, რომელიც ცნობილია მცირე მარკირებული მონაცემებით მაღალი სიზუსტის მიღწევით, ახლა შესაძლებელია Intel CPU-ებზე 7.8-ჯერ უფრო სწრაფად ამუშავდეს. ეს მიიღწევა 🤗 Optimum Intel-ის ბიბლიოთეკის გამოყენებით და პოსტ-ტრენინგული კვანტიზაციით, რაც SetFit-ის გადაწყვეტილებების წარმოებაში დანერგვას საგრძნობლად აადვილებს და გამტარუნარიანობას ზრდის.
Numina-სა და Kimi-ის გუნდი: Kimina-Prover-72B-ის გამოშვება
Numina-მ და Kimi-მ წარმოადგინეს Kimina-Prover-72B, უახლესი ხელოვნური ინტელექტის მოდელი თეორემების დამტკიცებისთვის, რომელიც გაწვრთნილია Kimi k1.5 RL სისტემით და დაფუძნებულია Qwen2.5-72B-ზე. მოდელის ძირითადი ინოვაციებია ტესტირების დროს განმტკიცებითი სწავლის ძიება (TTRL) რთული, მრავალსაფეხურიანი მტკიცებულებებისთვის ლემების გამოყენებით და შეცდომების გამოსწორების შესაძლებლობა, რაც მნიშვნელოვნად ზრდის ეფექტურობას. Kimina-Prover-მა მიაღწია 92.2%-იან უპრეცედენტო წარმატებას miniF2F ბენჩმარკზე, რამაც მას
Hugging Face მხარს უჭერს NAIRR-ის საგზაო რუკას ხელმისაწვდომი ხელოვნური ინტელექტისთვის
Hugging Face-მა უპასუხა თეთრი სახლის მოთხოვნას ეროვნული ხელოვნური ინტელექტის კვლევის რესურსის (NAIRR) საგზაო რუკის შესახებ, ხაზგასმით აღნიშნა ხელმისაწვდომი და პასუხისმგებლობითი ხელოვნური ინტელექტის მნიშვნელობა. მათ წარმოადგინეს ძირითადი რეკომენდაციები, მათ შორის, მრავალფეროვანი ექსპერტების დანიშვნა, დოკუმენტაციის სტანდარტების დადგენა და ბოროტად გამოყენების მონიტორინგი.
Google-მა CodeGemma - კოდზე ორიენტირებული დიდი ენობრივი მოდელები - გამოუშვა
Google-მა გამოუშვა CodeGemma, კოდზე სპეციალიზებული დიდი ენობრივი მოდელების (LLM) ოჯახი, რომელიც ეფუძნება 2B და 7B Gemma მოდელებს. ის ხელმისაწვდომია Hugging Face Hub-ზე სამ ვერსიად – CodeGemma 2B, CodeGemma 7B და CodeGemma 7B Instruct – და გამიზნულია კოდის შევსების, გენერაციისა და გაგების ამოცანებისთვის, ასევე მათემატიკური და ლოგიკური მსჯელობის გასაუმჯობესებლად. მოდელები გაწვრთნილია დამატებით 500 მილიარდ ტოკენზე და აჩვენებენ მაღალ წარმადობას კოდის შეფასების პოპულარულ ბენჩმარკებზე, როგორიცაა Human
Google Cloud-ი და Hugging Face-ი გენერაციული AI მოდელების განთავსებას ამარტივებენ
Google Cloud-მა და Hugging Face-მა გამოუშვეს ახალი ფუნქცია „Deploy on Google Cloud“, რომელიც დეველოპერებს საშუალებას აძლევს, შექმნან საწარმოო მზადყოფნის გენერაციული ხელოვნური ინტელექტის (AI) აპლიკაციები ინფრასტრუქტურის მართვის გარეშე, პირდაპირ მათ უსაფრთხო Google Cloud გარემოში. ეს გაფართოება Google-ის მომხმარებლებისთვის ღია გენერაციული AI მოდელებზე წვდომასა და მათ განთავსებას ამარტივებს, Vertex AI-სა და GKE-ზე 1-კლიკით განთავსების გამოცდილებას სთავაზობს.

Consilium: ხელოვნური ინტელექტის მოდელების თანამშრომლობა კონსენსუსისთვის
Consilium წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დიდ ენობრივ მოდელებს (LLM) აძლევს საშუალებას, მიაღწიონ კონსენსუსს დისკუსიის გზით. ჰაკათონის ფარგლებში შექმნილი პროექტი აერთიანებს Gradio ინტერფეისს და MCP სერვერს, რაც LLM-ებს საშუალებას აძლევს ითანამშრომლონ, შექმნან დასაბუთებული პასუხები და მიიღონ გადაწყვეტილებები. პლატფორმა ვიზუალურად წარმოადგენს მრგვალ მაგიდას, სადაც მოდელები დისკუსიას აწარმოებენ, ხოლო Microsoft-ის AI Diagnostic Orchestrator-ის მიერ მიღწეული შედეგები ადასტურებს, რომ მრავალი
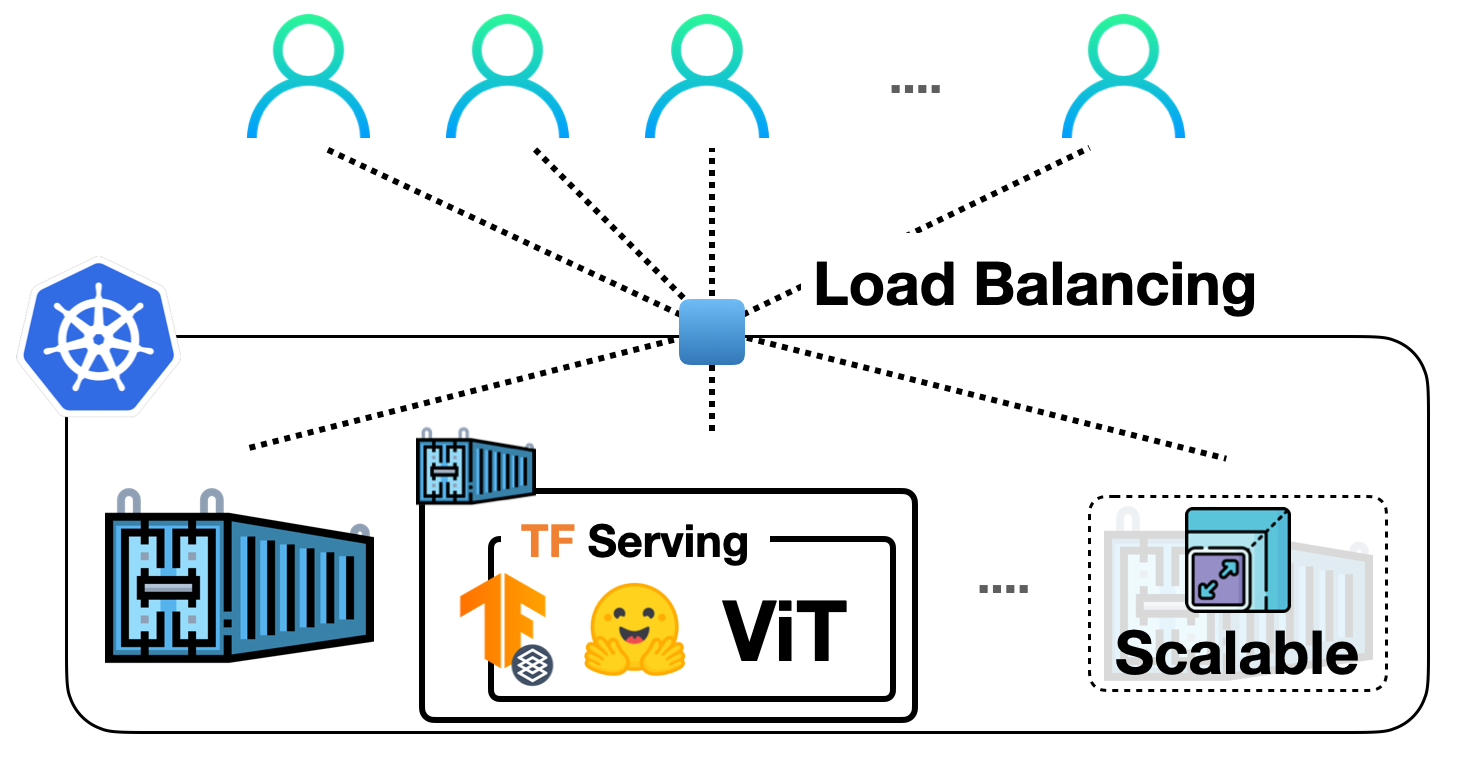
ML მოდელების მასშტაბირება Docker-ით და Kubernetes-ით: ლოკალურიდან სრულმასშტაბიან დეპლოიმენტამდე
ეს პოსტი გაწვდით დეტალურ სახელმძღვანელოს, თუ როგორ გადახვიდეთ მანქანური სწავლების მოდელების ლოკალური განთავსებიდან მასშტაბირებად, რეალურ პროექტებში გამოსაყენებელ სისტემებზე Docker-ისა და Kubernetes-ის გამოყენებით. სტატია აღწერს აპლიკაციის ლოგიკის კონტეინერიზაციას, Docker-ის კონტეინერების განთავსებას Kubernetes კლასტერზე (კერძოდ Google Kubernetes Engine-ზე - GKE), TensorFlow Serving-ის გამოყენებას მოდელების მომსახურებისთვის, მორგებული Docker გამოსახულებების შექმნას და მათ Google Container Registr