
OOM შეცდომების დავიწყება: დიდი მოდელების ეფექტური წვრთნა DeepSpeed ZeRO-ს გამოყენებით
დაიღალეთ მეხსიერებიდან ამოწურვის (OOM) შეცდომებით დიდი ხელოვნური ინტელექტის მოდელების წვრთნისას? ეს სტატია წარმოგიდგენთ DeepSpeed ZeRO (Zero Redundancy Optimizer) ტექნოლოგიას, რომელიც მონაცემთა პარალელიზმის (Data Parallelism) გამოყენებით საშუალებას გაძლევთ მაქსიმალურად გამოიყენოთ არსებული აპარატურა. ჩვენ განვიხილავთ ZeRO-ს სხვადასხვა სტადიას, ოპტიმიზატორის მდგომარეობების, გრადიენტებისა და მოდელის პარამეტრების დანაწილების ჩათვლით. სტატია აჩვენებს, თუ როგორ შეუძლია DeepSpeed ZeRO Stage-2-ს, Accele

Xeon პროცესორებზე წარმადობის მნიშვნელოვანი ზრდა ჩაშენებული მოდელების ოპტიმიზაციით Optimum Intel-ისა და fastRAG-ის გამოყენებით
ეს ბლოგი დეტალურად აღწერს, თუ როგორ მივაღწიოთ წარმადობის მნიშვნელოვან ზრდას Intel Xeon-ზე დაფუძნებულ CPU-ებზე, ოპტიმიზებული ჩაშენების (embedding) მოდელების ინტეგრირებით არსებულ RAG კონვეიერებში fastRAG-ის გამოყენებით. განხილულია Optimum Intel ბიბლიოთეკის როლი მოდელების დასაჩქარებლად, ისეთი ტექნიკების გამოყენებით, როგორიცაა დაბალბიტიანი კვანტიზაცია და Intel-ის სპეციფიკური გაფართოებების (AVX-512, VNNI, AMX) გამოყენება. სტატია ყურადღებას ამახვილებს BGE მოდელებზე და წარმოგიდგენთ ნაბიჯ-ნაბიჯ სახელმძღ

მეჩხერი ჩაშენების მოდელების დახვეწა: ჰიბრიდული ძიება და სემანტიკური გაფართოება
ეს სტატია განმარტავს, თუ როგორ უნდა დავხვეწოთ მეჩხერი ენკოდერის/ჩაშენების მოდელები, რომლებიც განსაკუთრებით ეფექტურია ჰიბრიდული ძიებისა და მოძიებისა და ხელახალი რანჟირების სცენარებში. დეტალურად განიხილება მოდელის კომპონენტები, მონაცემთა ნაკრებები, დანაკარგის ფუნქციები, ტრენინგის არგუმენტები და შემფასებლები. ასევე მოცემულია შედარება მკვრივ ჩაშენებებთან და განხილულია მოთხოვნის/დოკუმენტის გაფართოების მნიშვნელობა, რაც ამ მოდელებს საშუალებას აძლევს, გაუმკლავდნენ სემანტიკურ შეუსაბამობებს და გააუმჯობესო
Sentence Transformers-ის შესწავლა: ნულიდან პროექტამდე
ეს პოსტი წარმოგიდგენთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის (ST) გამოყენებით ახალი ბიბლიოთეკის დაუფლებისთვის ნულიდან. განვიხილავთ ST-ის ძირითად ფუნქციონალს, მათ შორის წინადადების ვექტორების (embeddings), სემანტიკური ძიებისა და კოსინუსური მსგავსების კონცეფციებს. ხაზგასმულია, თუ რატომ არის ST ღირებული ინსტრუმენტი ხელმისაწვდომობის, სწავლის ეფექტურობისა და მრეწველობაში გამოყენების თვალსაზრისით. სტატია ასევე გვთავაზობს გამოცდილ სტრატეგიას პირველი დამოუკიდებელი პროექტის განსახორციელებლად და
წარდგენა Quanto-სი: PyTorch-ის კვანტიზაციის ახალი ბეკენდი ხელოვნური ინტელექტის მოდელების ეფექტურობისთვის
Hugging Face წარმოგიდგენთ „quanto“-ს, PyTorch-ის კვანტიზაციის ახალ ბეკენდს Optimum-ისთვის, რომელიც შექმნილია ღრმა სწავლების მოდელების კვანტიზაციის გასამარტივებლად და სტანდარტიზებისთვის. Quanto მიზნად ისახავს მსხვილი ენობრივი მოდელების (LLM) უფრო ეფექტურს გახადოს სამომხმარებლო მოწყობილობებისთვის მეხსიერების შემცირებით და სპეციალიზებული აპარატურის ოპტიმიზაციების ჩართვით, გთავაზობთ მრავალმხრივ და მოწყობილობისგან დამოუკიდებელ გადაწყვეტას.
ღრმა გაძლიერებითი სწავლება: პოლიტიკაზე დაფუძნებული მეთოდები და Reinforce
სტატია მიმოიხილავს პოლიტიკაზე დაფუძნებულ მეთოდებს ღრმა გაძლიერებით სწავლებაში, უპირისპირებს რა მათ ღირებულებაზე დაფუძნებულ მიდგომებს. განმარტებულია, რომ პოლიტიკაზე დაფუძნებული მეთოდები უშუალოდ ოპტიმიზაციას უკეთებენ პოლიტიკას შუალედური ღირებულების ფუნქციის გარეშე, კონკრეტულად კი ალგორითმ Reinforce-ის მაგალითზე. ხაზგასმულია ძირითადი უპირატესობები, როგორიცაა ინტეგრაციის სიმარტივე, სტოქასტური პოლიტიკის სწავლის უნარი და ისეთი პრობლემების გადაჭრა, როგორიცაა აღქმითი ალიასინგი, ასევე უწყვეტი მოქმედებები

GaLore: გარღვევა ხელოვნური ინტელექტის მოდელების ვარჯიშში სამომხმარებლო GPU-ებზე
GaLore-ის ინოვაციური შესაძლებლობა, ავარჯიშოს 7 მილიარდ პარამეტრამდე ხელოვნური ინტელექტის მოდელები, როგორიცაა Llama არქიტექტურაზე დაფუძნებული მოდელები, სამომხმარებლო GPU-ებზე (მაგალითად, NVIDIA RTX 4090), წარმოადგენს მნიშვნელოვან გარღვევას. ეს მიიღწევა ოპტიმიზატორის მდგომარეობებისა და გრადიენტებისთვის საჭირო მეხსიერების მოთხოვნების მკვეთრი შემცირებით, დაბალი რანგის პროექციისა და 8-ბიტიანი სიზუსტის ოპტიმიზატორების კომბინაციით, რაც დიდ მოდელებს უფრო ხელმისაწვდომს ხდის ფართო მომხმარებლისთვის და ზღვა
BLOOM: წარდგენილია მსოფლიოში პირველი გამჭვირვალე, მრავალენოვანი დიდი ენობრივი მოდელი (LLM)
დიდი ენობრივი მოდელები (LLM) რევოლუციას ახდენენ ხელოვნური ინტელექტის კვლევებში, თუმცა მათზე სრული წვდომა მხოლოდ შეზღუდულ ინდუსტრიულ ლაბორატორიებს აქვთ. ამ სტატუს კვოს შესაცვლელად წარმოდგენილია BLOOM – პირველი მრავალენოვანი LLM, რომელიც სრული გამჭვირვალობით გაიარა ტრენინგი. 176 მილიარდი პარამეტრით, BLOOM-ს შეუძლია ტექსტის გენერირება 46 ბუნებრივ და 13 პროგრამირების ენაზე. ეს არის AI მკვლევართა ყველაზე მასშტაბური თანამშრომლობის შედეგი, რაც მოდელს ხელმისაწვდომს ხდის ფართო სამეცნიერო საზოგადოებისთვის

SmolLM3: ოპტიმალური ეფექტურობის 3B მოდელი სრული საინჟინრო პროექტით
SmolLM3-ის 3 მილიარდი პარამეტრის მოდელი აღემატება Llama-3.2-3B და Qwen2.5-3B მოდელებს, ამავდროულად ინარჩუნებს კონკურენტუნარიანობას უფრო დიდ 4B ალტერნატივებთან (Qwen3 და Gemma3). მისი უნიკალურობა მდგომარეობს იმაში, რომ დეველოპერები სრულად აქვეყნებენ მოდელის შექმნის მეთოდოლოგიას – არქიტექტურის დეტალებს, მონაცემთა შერევის მეთოდებსა და სამეტაპიან წინასწარ ვარჯიშის მიდგომას, რაც ჩვეულებრივ თვეების უკუინჟინერიას მოითხოვდა. არქიტექტურული ინოვაციები მოიცავს Grouped Query Attention (GQA), NoPE პოზიციური
როგორ შევქმნათ მუსიკალური ფლეილისტი ტექსტური მოთხოვნით: Sentence Transformers და Gradio
ეს სტატია განმარტავს, თუ როგორ შეიძლება Sentence Transformers ბიბლიოთეკის სემანტიკური ძიების ფუნქციონალის გამოყენება სიმღერების ფლეილისტების შესაქმნელად ტექსტური მოთხოვნის საფუძველზე. აღწერილია წინადადების ემბედინგების გენერირება, მოდელის შერჩევა (მაგ. MS MARCO), გრძელი ტექსტების ლექსებად დაყოფა და ემბედინგების გამოყენება ძიებისთვის. პროექტი განხორციელებულია Gradio აპლიკაციის სახით, რომელიც ჰოსტირებულია Hugging Face Spaces-ზე, რაც მომხმარებლებს საშუალებას აძლევს ინტერაქტიულად მოძებნონ სიმღერები

MCP პროტოკოლი: Hugging Face Spaces როგორც LLM-ის შესაძლებლობების „აპლიკაციების მაღაზია“
მოდელის კონტექსტის პროტოკოლი (MCP) არის ღია სტანდარტი, რომელიც დეველოპერებს საშუალებას აძლევს, შექმნან უსაფრთხო, ორმხრივი კავშირები დიდ ენობრივ მოდელებსა (LLM) და ინსტრუმენტების კომპლექტს შორის. ამ ინტეგრაციის წყალობით, Hugging Face Spaces, რომელიც Gradio-ს მეშვეობით აერთიანებს ათასობით AI აპლიკაციას, იქცევა LLM-ებისთვის „აპლიკაციების მაღაზიად“, სადაც მათ შეუძლიათ შეიძინონ ახალი შესაძლებლობები, როგორიცაა გამოსახულების რედაქტირება ან ვიდეო ტრანსკრიფცია, რაც LLM-ებს საშუალებას აძლევს, გაცილდნენ მა
როგორ გავხადოთ ხელოვნური ინტელექტის მოდელები უფრო სანდო: დინამიური მოწინააღმდეგე მონაცემთა შეგროვება MNIST-ის მაგალითზე
სტატიკური ბენჩმარკები ხელოვნური ინტელექტის მოდელების შეფასებისას მრავალ პრობლემას ქმნის. სტატია განიხილავს დინამიურ მოწინააღმდეგე მონაცემთა შეგროვების (DADC) მეთოდს, რომელიც ამცირებს ამ ნაკლოვანებებს და ხელს უწყობს სანდო მოდელების შექმნას. MNIST-ის მაგალითზე ნაჩვენებია, თუ როგორ შეუძლიათ ადამიანებს მოდელების „მოტყუება“ და მათი გაწვრთნა უფრო გამძლე სისტემების მისაღებად.
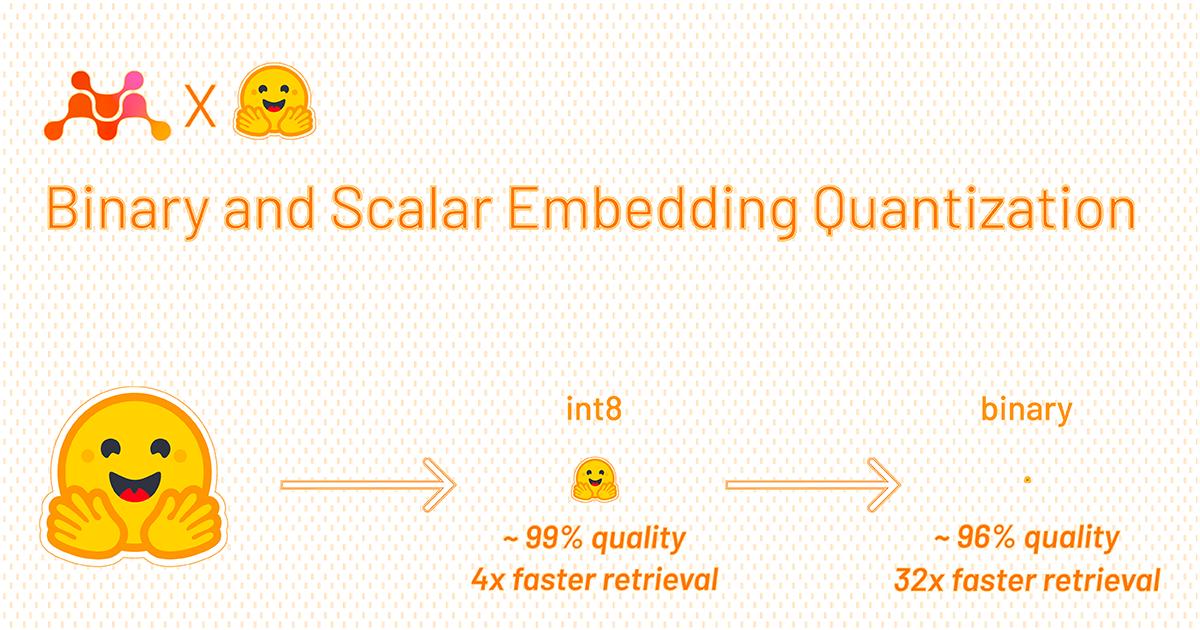
კვანტიზაცია: ეფექტური გადაწყვეტა ემბედინგების მასშტაბირების პრობლემისთვის
ემბედინგები ბუნებრივი ენის დამუშავების (NLP) გადამწყვეტი ინსტრუმენტია, თუმცა მათი მასშტაბირება წარმოების მიზნებისთვის ხშირად იწვევს მაღალ ხარჯებსა და ლატენტურობას. სტატია განიხილავს ამ გამოწვევებს, არსებულ მიდგომებს (როგორიცაა განზომილების შემცირება და Matryoshka Representation Learning) და წარმოგიდგენთ კვანტიზაციას, კერძოდ ბინარულ კვანტიზაციას, როგორც ინოვაციურ გადაწყვეტას. ბინარული კვანტიზაცია float32 მნიშვნელობებს 1-ბიტიან მნიშვნელობებად აქცევს, რაც მეხსიერებასა და შენახვის ადგილს 32-ჯერ ამცი
AI-ის რევოლუცია მონაცემებთან ურთიერთობაში: DuckDB-NSQL-7B და ტექსტიდან SQL-ზე გადასვლა
ხელოვნური ინტელექტის (AI) და დიდი ენობრივი მოდელების (LLM) განვითარება რევოლუციას ახდენს მონაცემთა ანალიზში. ტრადიციულად, SQL ქუერების შექმნა მოითხოვდა სპეციალიზებულ ცოდნას, რაც ხელმისაწვდომობის ხარვეზს ქმნიდა. MotherDuck-მა და Numbers Station-მა წარმოადგინეს DuckDB-NSQL-7B, LLM, რომელიც სპეციალურად DuckDB SQL-ისთვისაა შექმნილი. ეს მოდელი მომხმარებლებს საშუალებას აძლევს, ბუნებრივი ენით ჩამოაყალიბონ მონაცემთა მოთხოვნები, რომლებსაც მოდელი ავტომატურად თარგმნის SQL ბრძანებებში. სტატიაში დეტალურად არ

ეტინი: უახლესი ენკოდერ-დეკოდერ მოდელები, რომლებიც Llama 3.2 1B-ს და SmolLM2-ს აღემატებიან
რა მოხდებოდა, ModernBERT-ის რეცეპტი მხოლოდ დეკოდერის მოდელზე რომ გამოგვეყენებინა? აღმოჩნდა, რომ შეიქმნებოდა უახლესი დეკოდერული ენის მოდელი, რომელიც Llama 3.2 1B-სა და SmolLM2-ს ჯობნის. ჩვენ წარმოგიდგენთ Ettin-ს, უახლესი, დაწყვილებული მხოლოდ-ენკოდერისა და მხოლოდ-დეკოდერის მოდელების პირველ სერიას (17M-1B პარამეტრი), რომლებიც გაწვრთნილია იდენტური მონაცემებით (2T ტოკენი), არქიტექტურითა და წვრთნის რეცეპტებით. Ettin შესაძლებელს ხდის არქიტექტურებს შორის სამართლიან შედარებებს და უზრუნველყოფს უმაღლეს შეს
ღრმა გაძლიერებითი სწავლება: პროქსიმალური პოლიტიკის ოპტიმიზაცია (PPO)
ეს სტატია ღრმა გაძლიერებითი სწავლების კურსის ნაწილია და დეტალურად განიხილავს პროქსიმალური პოლიტიკის ოპტიმიზაციას (PPO). PPO არის არქიტექტურა, რომელიც აუმჯობესებს აგენტის ვარჯიშის სტაბილურობას პოლიტიკის გადაჭარბებული განახლებების თავიდან აცილებით. ჩვენ შევისწავლით, თუ როგორ იყენებს PPO მიმდინარე და ძველი პოლიტიკის თანაფარდობის კლიპინგს სტაბილური განახლებების უზრუნველსაყოფად. თეორიის შემდეგ, სტატია წარმოგიდგენთ PPO არქიტექტურის ნულიდან დაწერას PyTorch-ის გამოყენებით, მაგალითად CartPole-v1-სა და Lu

FutureBench: ხელოვნური ინტელექტის შეფასების ახალი სტანდარტი მომავლის პროგნოზირებაში
არსებული AI ბენჩმარკები ძირითადად წარსულის ინფორმაციის ცოდნაზეა ორიენტირებული. FutureBench-ის ახალი მიდგომა ხელოვნური ინტელექტის შეფასებას მომავლის მოვლენების პროგნოზირებაზე ამახვილებს ყურადღებას. ეს კომპლექსური ამოცანა მოითხოვს დახვეწილ მსჯელობასა და სინთეზს, რაც რეალურ ღირებულებას ქმნის. ის გამორიცხავს მონაცემთა დაბინძურების რისკს და უზრუნველყოფს შედეგების ობიექტურ გადამოწმებას. FutureBench იყენებს რეალური სამყაროს მონაცემებსა და ახალ ამბებს საპროგნოზო ამოცანების შესაქმნელად, რაც AI აგენტებს ს

Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.
Hugging Face-ის მიდგომა: Transformers-ის ათვისება TensorFlow-ში Keras-ისა და ტრანსფერული სწავლების მეშვეობით
სტატია განიხილავს Hugging Face-ის ფილოსოფიას TensorFlow-ის ინჟინრებისთვის, რომლებიც იყენებენ Transformers-ის ბიბლიოთეკას. ის აკრიტიკებს Keras-ის მაღალდონიანი API-ის გვერდის ავლის გავრცელებულ პრაქტიკას და ხაზს უსვამს მის მნიშვნელობას. სტატია განმარტავს, თუ როგორ შეიძლება მძლავრი, წინასწარ გაწვრთნილი მოდელების გამოყენება ტრანსფერული სწავლების გზით, რაც ამცირებს მონაცემების საჭიროებას და ზრდის სიზუსტეს. ასევე, აღწერილია Hugging Face-ის მოდელების ინტეგრაცია ნაცნობ Keras-ის მეთოდებთან, როგორიცაა `fit
Idefics2: Hugging Face-ის ახალი, 10-ჯერ მცირე ზომის მულტიმოდალური AI მოდელი მნიშვნელოვანი გაუმჯობესებებით
Idefics2, Hugging Face-ის ახალი მულტიმოდალური AI მოდელი, მისი წინამორბედისგან განსხვავებით 10-ჯერ მცირე ზომისაა და მნიშვნელოვნად გაუმჯობესებულ შესაძლებლობებს გვთავაზობს. ის გაწვრთნილია მრავალფეროვან მონაცემთა ნაკრებებზე, მათ შორის ახლად გამოშვებულ „The Cauldron“-ზე, რომელიც მრავალმხრივი საუბრებისთვისაა განკუთვნილი. მოდელი, რომელიც აგებულია Mistral-7B-v0.1-სა და siglip-so400m-patch14-384-ზე, უკვე ხელმისაწვდომია Hugging Face Hub-ზე Apache-2.0 ლიცენზიით.
Hugging Face-მა ახალი ბიბლიოთეკა Skops წარადგინა: scikit-learn მოდელების ჰოსტინგი და თანამშრომლობა გაუმჯობესდა
Hugging Face-მა წარმოადგინა Skops, ახალი ბიბლიოთეკა, რომელიც შექმნილია scikit-learn მოდელების Hugging Face Hub-ზე განთავსების პროცესის გასამარტივებლად. Skops უზრუნველყოფს მოდელების უსაფრთხო ჰოსტინგს, დოკუმენტაციას მოდელის ბარათების მეშვეობით და გაუმჯობესებულ თანამშრომლობას, რითაც ღია კოდის მანქანური სწავლების პროექტებისთვის რეპროდუცირებადობა და ახსნადობა უფრო ხელმისაწვდომი ხდება.

Flux.1-Dev-ის ოპტიმიზაცია LoRAs-ით: ინფერენციის სიჩქარისა და მეხსიერების გაუმჯობესება
ამ პოსტში განხილულია Flux.1-Dev ტექსტი-გამოსახულებაზე გენერაციის მოდელის ინფერენციის სიჩქარის ოპტიმიზაცია LoRA ადაპტერების გამოყენებისას. LoRAs-ის ფართო გამოყენებისა და მრავალფეროვნების გათვალისწინებით, რთულია მათი ცხელად ცვლა (hotswap) მოდელის გადაკომპილაციის გარეშე, რაც სიჩქარის დაკარგვას იწვევს. სტატია გვთავაზობს ოპტიმიზაციის რეცეპტს, რომელიც მოიცავს `hotswap=True` ფუნქციის გამოყენებას, `torch.compile`-ს, FP8 კვანტიზაციას, CPU-ზე გადატვირთვას (CPU offloading) და T5 ტექსტური ენკოდერის კვანტიზა
ენის დიდი მოდელების ოპტიმიზაცია: Hugging Face-ის LLM.int8() ინტეგრაცია
ენის დიდი მოდელები (LLM) მუდმივად იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა, BigScience-თან თანამშრომლობით, წარმოადგინა LLM.int8() ინტეგრაცია, რომელიც საშუალებას აძლევს ამ მასშტაბურ მოდელებს იმუშაონ ნაკლებ GPU-ზე, მეხსიერების მოხმარების 2-ჯერ შემცირებით, პროგნოზირების სიზუსტის შენარჩუნებით. სტატია დეტალურად განიხილავს ამ ტექნოლოგიას და სხვადასხვა მცოცავწერტილიანი მონაცემთა ტიპებს, რომლებიც მოდელის ზომასა და მუშაობაზე ახდენენ გავლენას.
LLM.int8(): როგორ გავხადოთ გიგანტური ენის მოდელები უფრო ხელმისაწვდომი
თანამედროვე ენის მოდელები სულ უფრო იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა და BigScience-მა წარმოადგინეს LLM.int8() ინტეგრაცია, რომელიც მოდელების პროგნოზირების ხარისხის შენარჩუნებით ამცირებს მათ მეხსიერების მოხმარებას 2-ჯერ. სტატია დეტალურად განმარტავს ამ კვანტიზაციის ტექნოლოგიას, მონაცემთა სხვადასხვა ტიპის სიზუსტესა და პარტნიორობის სამომავლო მიზნებს.