
TRL და vLLM-ის კოლოკაცია: ხელოვნური ინტელექტის მოდელების წვრთნის რევოლუცია GPU-ების ოპტიმიზაციით
ტრადიციულად, დიდი ენობრივი მოდელების (LLM) GRPO ალგორითმით წვრთნა, vLLM-ის სერვერის რეჟიმში გამოყენებისას, გრაფიკული პროცესორების (GPU) არაეფექტურ გამოყენებას იწვევდა. TRL-ის v0.18.0 ვერსიიდან, vLLM-თან ერთობლივი მუშაობის (კოლოკაციის) მხარდაჭერა საშუალებას იძლევა, წვრთნა და ინფერენცია ერთსა და იმავე GPU-ებზე განხორციელდეს. ეს მიდგომა მნიშვნელოვნად ამცირებს უქმ დროს, აუმჯობესებს გამტარუნარიანობას და ამარტივებს განლაგებას, რაც LLM-ების წვრთნას უფრო სწრაფს, ეკონომიურს და მასშტაბირებადს ხდის.
TRL და vLLM: GPU-ის ეფექტურობის ახალი ერა კოლოკაციის წყალობით
TRL-ის ბიბლიოთეკამ მნიშვნელოვანი სიახლე დანერგა, რაც LLM-ების (დიდი ენობრივი მოდელების) წვრთნის პროცესს vLLM-თან GRPO ალგორითმის გამოყენებით უფრო ეფექტურს ხდის. ადრე vLLM სერვერის რეჟიმში მუშაობდა, რაც GPU-ის რესურსების არაეფექტურ გამოყენებასა და უმოქმედო დროს იწვევდა. ახალი „კოლოკაციის“ რეჟიმი წვრთნისა და ინფერენციის ერთსა და იმავე GPU-ებზე, ერთსა და იმავე პროცესთა ჯგუფში გაშვების საშუალებას იძლევა, რაც მნიშვნელოვნად ზრდის შესრულებას, ამცირებს აპარატურულ დანახარჯებს და ამარტივებს დეპლოირებას.

SmolVLA: ახალი კომპაქტური, ღია კოდის VLA მოდელი რობოტიკისთვის, რომელიც ხელმისაწვდომს ხდის AI კვლევებს
დღეს წარმოდგენილია SmolVLA – კომპაქტური (450M), ღია კოდის Vision-Language-Action (VLA) მოდელი რობოტიკისთვის, რომელიც მომხმარებლისთვის განკუთვნილ აპარატურაზე მუშაობს. მიუხედავად იმისა, რომ ხელოვნური ინტელექტის სფეროში ტრანსფორმერებმა მნიშვნელოვან პროგრესს მიაღწიეს, რობოტიკაში განვითარება შედარებით ნელი ტემპით მიმდინარეობდა, რაც განპირობებულია მაღალი ხარისხის მონაცემების ნაკლებობით და დახურული, ძვირადღირებული მოდელების დომინირებით. SmolVLA მიზნად ისახავს ამ ხარვეზის აღმოფხვრას ღია კოდის, ეფექტური
ღრმა გაძლიერებითი სწავლის კურსი: ღირებულებაზე დაფუძნებული მეთოდები და Q-სწავლება
ეს სტატია ღრმა გაძლიერებითი სწავლის (Deep Reinforcement Learning) კურსის ნაწილია, რომელიც დამწყებიდან ექსპერტამდე დონისთვის არის განკუთვნილი. ის დეტალურად განიხილავს ღირებულებაზე დაფუძნებულ მეთოდებსა და Q-სწავლებას, განმარტავს, თუ როგორ იღებენ RL აგენტები ჭკვიან გადაწყვეტილებებს გარემოსთან ცდისა და შეცდომის გზით ურთიერთქმედებით და ჯილდოების მაქსიმიზაციით. სტატია ასევე ეხება მდგომარეობისა და მოქმედების ღირებულების ფუნქციებს შორის განსხვავებას, პოლიტიკისა და ღირებულების ფუნქციის წვრთნის ნიუანსებს,
LoRA ადაპტერების შერწყმის ახალი მეთოდები AI მოდელებში
ეს პოსტი Hugging Face-ის PEFT ბიბლიოთეკაში LoRA ადაპტერების შერწყმის ინოვაციურ მეთოდებს წარმოგიდგენთ. ის დეტალურად განიხილავს, თუ როგორ შეიძლება ერთი და იგივე საბაზისო მოდელიდან მიღებული სხვადასხვა ადაპტერების გაერთიანება, რათა მიღებულ იქნეს ოპტიმალური შედეგები, მეხსიერების შეზღუდვის მიუხედავად. აღწერილია კონკატენაციის, შეწონილი ჯამის, ამოცანის არითმეტიკისა და TIES მეთოდები, კოდის მაგალითებითა და სამომავლო გეგმებით.
მოდელების შერწყმა: LoRA ადაპტერების გაერთიანების ახალი მიდგომები PEFT-ში
ამ პოსტში წარმოდგენილია 🤗 PEFT-ის ფარგლებში შემუშავებული LoRA ადაპტერების შერწყმის ახალი, ოპტიმიზებული მეთოდები. განხილულია სტანდარტული მოდელების გაერთიანების მიდგომები, მეხსიერების ინტენსივობის გამოწვევები და შემოთავაზებულია სხვადასხვა ტექნიკა, მათ შორის კონკატენაცია, მატრიცების შეწონილი ჯამი და დავალების არითმეტიკა (Task Arithmetic). სტატია მოიცავს კოდის მაგალითებს, შთამბეჭდავ შედეგებსა და სამომავლო გეგმებს.

KV ქეშირება nanoVLM-ში: 38%-იანი აჩქარება გენერაციაში
ეს ბლოგ-პოსტი აღწერს KV ქეშირების ტექნიკას, რომელიც nanoVLM საცავში ნულიდან დავნერგეთ და რომელმაც ენობრივი მოდელების გენერაციაში 38%-იანი აჩქარება მოგვცა. სტატია განმარტავს ავტორეგრესიულ მოდელებში გამოთვლითი სიჭარბის პრობლემას და იმას, თუ როგორ აგვარებს მას KV ქეშირება Q, K, V მნიშვნელობების შენახვით. მოცემულია თეორიული საფუძვლები, nanoVLM-ში პრაქტიკული იმპლემენტაცია და ზოგადი გაკვეთილები, რომლებიც ყველა ავტორეგრესიული ენობრივი მოდელის გენერაციას ეხება. ეს ოპტიმიზაცია აუცილებელია LLM-ების ეფექტუ
Q-სწავლა: ნულიდან RL აგენტის შექმნის გზამკვლევი
აღმოაჩინეთ Q-სწავლის ალგორითმი, ღრმა გაძლიერებითი სწავლის კლასის ფუნდამენტური ნაწილი. ეს სტატია განმარტავს Q-ფუნქციის, Q-ცხრილისა და ეფსილონ-ხარბი სტრატეგიის მუშაობის პრინციპებს, გასწავლით თუ როგორ შექმნათ თქვენი პირველი გაძლიერებითი სწავლის აგენტი ნულიდან და განაახლოთ მისი ქცევის მოდელი გარემოსთან ურთიერთქმედებისას.
Google-მა Gemma, უახლესი ღია LLM-ების ოჯახი გამოუშვა
Google-მა დღეს გამოუშვა Gemma, ხელოვნური ინტელექტის (AI) უახლესი ღია ენის მოდელების (LLM) ოჯახი, რაც აძლიერებს კომპანიის ერთგულებას ღია კოდის AI მიმართ. Gemma ხელმისაწვდომია ორი ზომის (7B და 2B პარამეტრი) და ორი ვარიანტის (ძირითადი და ინსტრუქციებზე მორგებული) სახით. ის შექმნილია ეფექტური გამოყენებისთვის სხვადასხვა მოწყობილობაზე, მათ შორის სამომხმარებლო GPU-ებზე, CPU-ებზე და ჩაშენებულ სისტემებზე. Hugging Face-თან თანამშრომლობით უზრუნველყოფილია სრული ინტეგრაცია და ყველა ვარიანტი ხელმისაწვდომია Hug
მატრიოშკა Embeddings-ის მოდელები: მოქნილობა და ეფექტურობა ხელოვნურ ინტელექტში
ეს სტატია განიხილავს მატრიოშკა Embeddings-ის მოდელებს, რომლებიც გვთავაზობენ მოქნილობასა და ეფექტურობას ბუნებრივი ენის დამუშავებასა და ხელოვნურ ინტელექტში. განმარტებულია მათი მუშაობის პრინციპი, რომელიც რუსული მატრიოშკის თოჯინების მსგავსად, საშუალებას იძლევა, Embeddings-ის ზომა შემცირდეს ინფორმაციის მნიშვნელოვანი დაკარგვის გარეშე. სტატია ასევე მოიცავს პრაქტიკულ რჩევებს მათი გამოყენებისა და ტრენინგის მეთოდებზე, მათ შორის Sentence Transformers-ის ფარგლებში, ხაზს უსვამს მათ უპირატესობებს ტრადიციულ Em
Hugging Face Hub-ზე ახალი კოლაბორაციული ფუნქციები: Pull Requests და Discussions
Hugging Face Hub სიხარულით აცხადებს Pull Requests-ისა და Discussions-ის გამოშვებას, რომლებიც დღეიდან ხელმისაწვდომია ყველა ტიპის რეპოზიტორისთვის („Community“ ჩანართში). ეს ფუნქციები ხელს შეუწყობს თანამშრომლობას საზოგადოების წევრებს შორის, გუნდებში და მის ფარგლებს გარეთ, რაც უდიდესი განახლებაა Hub-ისთვის და შეესაბამება ეთიკური მანქანური სწავლების პრინციპებს.
Haize Labs-ი Hugging Face-ის მხარდაჭერით LLM-ების „წითელი გუნდის“ წინააღმდეგობის ახალ ბენჩმარკს წარადგენს
ხელოვნური ინტელექტის (AI) სფეროში, დიდი ენობრივი მოდელების (LLM) უსაფრთხოებასა და არასასურველ ქცევებთან დაკავშირებით მზარდი შეშფოთებაა. ამ გამოწვევის საპასუხოდ, Haize Labs-მა, Hugging Face-ის გუნდის მხარდაჭერით, შექმნა „Red Teaming Resistance Benchmark“ – ახალი საორიენტაციო სისტემა. ის მიზნად ისახავს უახლესი LLM მოდელების მდგრადობის შემოწმებას ადამიანის მიერ შემუშავებული, დახვეწილი „წითელი გუნდის“ (red teaming) შეტევების გამოყენებით, რათა გამოავლინოს მათი სისუსტეები და მოწყვლადობები. ბენჩმარკი ფ
Haize Labs-მა და Hugging Face-მა დიდი ენობრივი მოდელების უსაფრთხოების ახალი ეტალონი, „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ წარადგინეს
დიდი ენობრივი მოდელების (დემ) კვლევის სწრაფი ტემპის ფონზე, Haize Labs-მა, Hugging Face-ის გულუხვი მხარდაჭერით, გამოაქვეყნა „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ (Red Teaming Resistance Benchmark). ეს ახალი ეტალონი მიზნად ისახავს მოწინავე დემ-ების მოწყვლადობების საფუძვლიან შემოწმებას ადამიანის მიერ შექმნილი, ბუნებრივი ენის მსგავსი მავნე მოთხოვნების (prompts) გამოყენებით, განსხვავებით ხელოვნური, ავტომატიზებული შეტევებისგან. ბენჩმარკი აფასებს მოდელების მდგრადობას არასასურველი ქცევების მიმართ, რო
Graphcore და Hugging Face 10 ტრანსფორმერული მოდელის ხელმისაწვდომობას აფართოებენ AI ამოცანებისთვის
სტატია დეტალურად აღწერს, თუ როგორ გააფართოვეს Graphcore-მა და Hugging Face-მა, მათი პარტნიორობის მეშვეობით, 10 ტრანსფორმერულ მოდელზე წვდომა დეველოპერებისთვის, რომლებიც მოიცავს ბუნებრივი ენის დამუშავებას (NLP), მეტყველებასა და კომპიუტერულ ხედვას. ხაზგასმულია ძირითადი მოდელები, როგორიცაა BERT, ViT, GPT-2, RoBERTa, DeBERTa, BART, LXMERT, T5, HuBERT და Wav2Vec2, მათი უნიკალური ფუნქციონალური შესაძლებლობებისა და გამოყენების სფეროების ახსნით, რაც ამარტივებს ხელოვნური ინტელექტის განვითარებას IPU-ებზე.
Hugging Face: Gemma მოდელების PEFT-ით ოპტიმიზაცია
ამ პოსტში განხილულია, თუ როგორ შეიძლება Gemma მოდელების პარამეტრულად ეფექტური წვრილმანი მორგება (PEFT) Hugging Face Transformers-ისა და PEFT ბიბლიოთეკების გამოყენებით GPU-ებსა და Cloud TPU-ებზე. ეს ტექნიკა განსაკუთრებით გამოსადეგია მეხსიერებისა და გამოთვლითი რესურსების დაზოგვისთვის, რაც საშუალებას აძლევს მომხმარებლებს, მათ შორის მათ, ვინც Colab-სა და Kaggle-ზე მუშაობს, ოპტიმიზაცია გაუკეთონ მოდელებს საკუთარ მონაცემთა ნაკრებებზე დაბალი დანახარჯით. სტატია დეტალურად განიხილავს LoRA-სა და QLoRA-ს გამ
ღრმა Q-სწავლება: როგორ ვავარჯიშოთ აგენტები Atari-ს თამაშებში
ეს სტატია ღრმა გაძლიერებული სწავლების კურსის ნაწილია. განვიხილავთ, თუ როგორ გადადის ტრადიციული Q-სწავლება, რომელსაც შეზღუდვები აქვს დიდი მდგომარეობათა სივრცეების შემთხვევაში, ღრმა Q-სწავლებაში. ეს უკანასკნელი იყენებს ნერვულ ქსელებს Q-მნიშვნელობების აპროქსიმაციისთვის, რაც საშუალებას გვაძლევს მოვამზადოთ აგენტები რთული გარემოებისთვის, როგორიცაა Atari-ს თამაშები. სტატია დეტალურად აღწერს Deep Q-Network-ის არქიტექტურას, მონაცემთა წინასწარ დამუშავებას და ჩარჩოების დაწყობის მნიშვნელობას დროითი შეზღუდვებ

ხელოვნური ინტელექტის მიერ გენერირებული კონტენტის წყლის ნიშნები და მისი ავთენტურობის დაცვა
ამ ბლოგპოსტში განვიხილავთ ხელოვნური ინტელექტის (AI) მიერ გენერირებული კონტენტის წყლის ნიშნების დამატების მეთოდებს, მათ უპირატესობებსა და ნაკლოვანებებს, ასევე Hugging Face Hub-ზე არსებულ ინსტრუმენტებს. სტატია ასევე აანალიზებს კონტენტის ავთენტურობის დაცვის სხვა ტექნიკებს, როგორიცაა გამოსახულების ცვლილება და „მოწამვლა“, და მიმოიხილავს ღია და დახურული სისტემების გამოწვევებს სხვადასხვა მოდიფიკაციისთვის.
დენოიზინგ დიფუზიური ალბათური მოდელები (DDPM): კონცეფციიდან იმპლემენტაციამდე PyTorch-ში
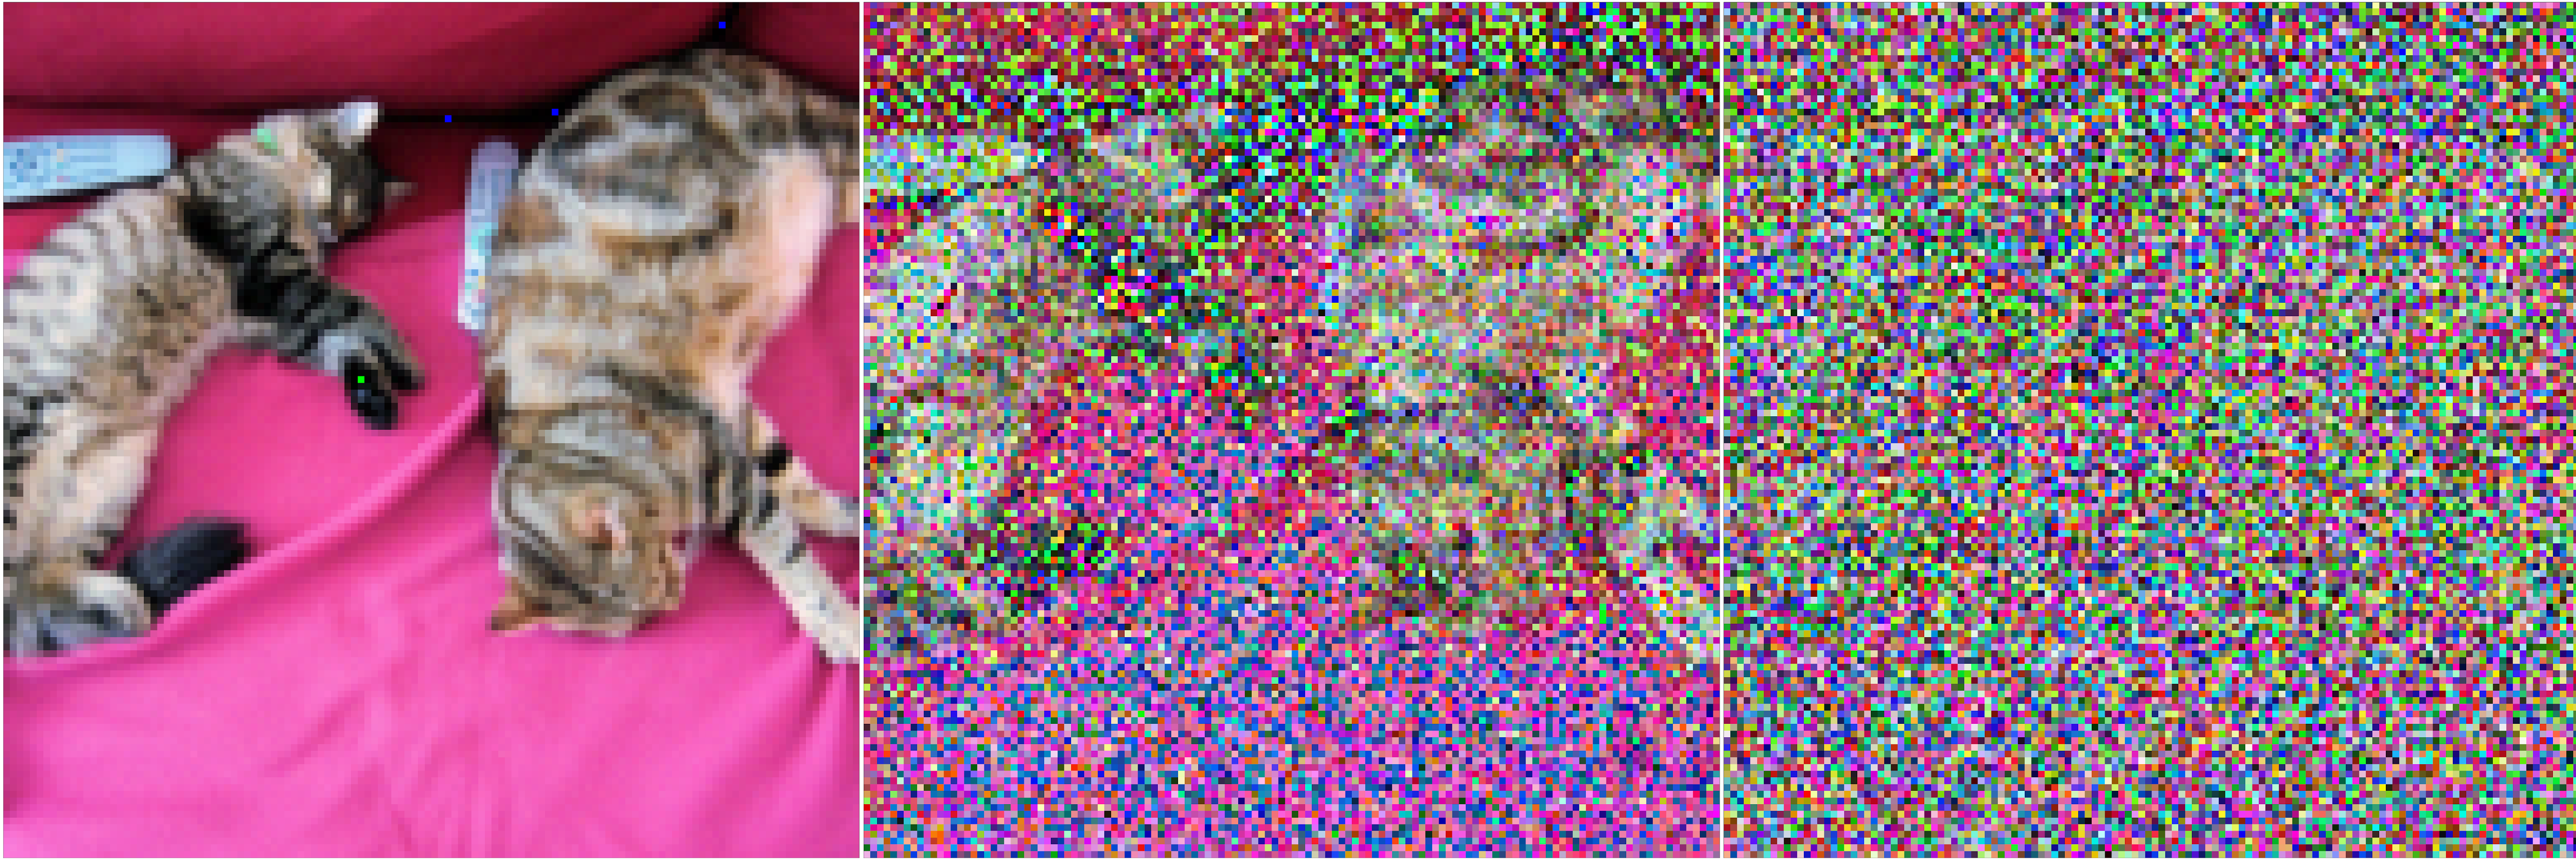
ეს სტატია განიხილავს Ho et al.-ის (2020) ორიგინალური ნაშრომის მიხედვით დენოიზინგ დიფუზიურ ალბათურ მოდელებს (DDPM) და მათ ნაბიჯ-ნაბიჯ იმპლემენტაციას PyTorch-ში. იგი აშუქებს დიფუზიური მოდელების ისტორიულ კონტექსტს, მათ მათემატიკურ საფუძვლებს და ხსნის როგორც პირდაპირ, ასევე შებრუნებულ პროცესებს, რომლებიც საშუალებას აძლევს ნერვულ ქსელს გარდაქმნას ხმაურიანი მონაცემები რეალურ ნიმუშებად.
TTS Arena: მეტყველების სინთეზის მოდელების შეფასების დემოკრატიზაცია
მეტყველების სინთეზის სფეროში დიდი ხანია არ არსებობდა მოდელების ხარისხის ზუსტი გაზომვის მეთოდი. არსებული ობიექტური და სუბიექტური მეთოდები არაეფექტურია მსგავსი ხარისხის მოდელების შესადარებლად. ამ გამოწვევის საპასუხოდ, შეიქმნა TTS Arena, სადაც საზოგადოებას შეუძლია შეაფასოს სინთეზირებული აუდიო და დაეხმაროს მოდელების რანჟირების დემოკრატიზაციას. პლატფორმა იყენებს ადამიანის შეფასებას, მსგავსად Chatbot Arena-ისა, მოდელების ობიექტური შედარებისთვის.

vLLM-ის ოპტიმიზაცია: პრეფილისა და დეკოდირების გამოწვევების დაძლევა
ეს სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაციის გამოწვევებს vLLM-ში, განსაკუთრებით "პრეფილის" ფაზაში, სადაც გრძელ პრომპტებს შეუძლიათ შეაფერხონ მომდევნო მოთხოვნები. იგი აღწერს გაუმჯობესებულ სტრატეგიას, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას, ხოლო გრძელი მოთხოვნებისთვის თანმიმდევრულ დამუშავებას ინარჩუნებს. ასევე წარმოდგენილია "დეზაგრეგირებული პრეფილი" – უფრო რადიკალური გადაწყვეტა ტოკენის გენერაციის შენელების აღმოსაფხვრელად, თუმცა რესურსების უფრო

დიფუზიური მოდელების ეფექტური წვრილი დარეგულირება QLoRA-ით: 10 GB VRAM-ზე ნაკლები მოხმარება
წინა პოსტში კვანტიზაციის ტექნიკების განხილვის შემდეგ, ეს პოსტი ყურადღებას ამახვილებს დიფუზიური მოდელების, კერძოდ FLUX.1-dev-ის, ეფექტურ წვრილ დარეგულირებაზე (fine-tuning) QLoRA მეთოდის გამოყენებით. მიზანია, მივაღწიოთ 10 GB-ზე ნაკლებ VRAM მოხმარებას ერთ GPU-ზე, რაც ხელმისაწვდომს გახდის ამ პროცესს სამომხმარებლო აპარატურაზე. განიხილება ისეთი ტექნიკები, როგორიცაა 8-ბიტიანი AdamW ოპტიმიზატორი, გრადიენტის შემოწმება (gradient checkpointing) და ლატენტების ქეშირება (cache latents), რათა FLUX.1-dev-მა ალფ
Hugging Face Optimum: ტრანსფორმერების მოდელების ოპტიმიზაცია და ONNX-ში ექსპორტი წარმოებისთვის
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Transformers მოდელების ექსპორტირება ONNX ფორმატში Hugging Face Optimum ბიბლიოთეკის გამოყენებით, რათა მივაღწიოთ მაქსიმალურ ეფექტურობას წარმოების გარემოში. სტატია განმარტავს ONNX-ის, როგორც ღია სტანდარტის მნიშვნელობას, წარმოგიდგენთ Optimum-ის ფართო შესაძლებლობებს მოდელის ოპტიმიზაციისთვის და იკვლევს კონვერტაციის სხვადასხვა მეთოდს, მარტივი API-დან მოწინავე ფუნქციონალამდე.
ConTextual: ახალი მონაცემთა ნაკრები LMM-ების შესაფასებლად კონტექსტზე მგრძნობიარე, ტექსტ-მდიდარი ვიზუალური მსჯელობის ამოცანებში
კალიფორნიის უნივერსიტეტის (ლოს-ანჯელესი) მკვლევრებმა შექმნეს ConTextual – მონაცემთა ნაკრები, რომელიც განკუთვნილია მსხვილი მულტიმოდალური მოდელების (LMMs) შესაფასებლად კონტექსტზე მგრძნობიარე, ტექსტ-მდიდარი ვიზუალური მსჯელობის ამოცანებში. არსებული შეფასებები ხშირად უგულებელყოფს ამ რთულ სცენარებს, რის გამოც ConTextual გვთავაზობს 506 გამოწვევას ტექსტსა და ვიზუალურ მინიშნებებზე ერთობლივი მსჯელობისთვის, რათა დადგინდეს მოდელების რეალური შესაძლებლობები. გამოქვეყნებულია ლიდერბორდიც, რაც ხელს შეუწყობს მოდე

Gemma 3n: მულტიმოდალური AI მოდელი საბოლოოდ ღია კოდის ბიბლიოთეკებში
Google-ის უახლესი მულტიმოდალური AI მოდელი, Gemma 3n, საბოლოოდ ხელმისაწვდომია ყველაზე პოპულარულ ღია კოდის ბიბლიოთეკებში, მათ შორის transformers & timm, MLX, llama.cpp და სხვებში. ეს გამოშვება მოიცავს ორ ზომას (E2B და E4B), რომლებიც გამოირჩევიან მაღალი ეფექტურობით VRAM-ის გამოყენების მხრივ და უზრუნველყოფენ შესანიშნავ ხარისხს. Gemma 3n არა მხოლოდ ენობრივ დეკოდერს, არამედ აუდიო და ვიზუალურ ენკოდერებსაც მოიცავს, რაც მას სრულყოფილ მულტიმოდალურ ინსტრუმენტად აქცევს დეველოპერებისთვის. სტატია დეტალურად აღ