
Qwen-3 მოდელის ჩატის გაუმჯობესებული შაბლონი: სიღრმისეული ანალიზი
Qwen-3 მოდელი წარმოადგენს მნიშვნელოვან გაუმჯობესებებს ჩატის შაბლონში, Qwen-2.5-თან და QwQ-თან შედარებით. მისი სიახლეები მოიცავს აზროვნების ფუნქციის (reasoning) ჩართვა-გამორთვის შესაძლებლობას, კონტექსტის მართვის გაუმჯობესებულ მექანიზმს ('rolling checkpoint'), ინსტრუმენტებთან უკეთეს ინტერაქციას და ნაგულისხმევი სისტემის პრომპტის არარსებობას. ეს ცვლილებები ზრდის მოდელის მოქნილობას და საიმედოობას ხელოვნური ინტელექტის აპლიკაციებში.

Gradio-ს რევოლუციური განახლება: MCP სერვერები LLM-ებისთვის
Gradio, პოპულარული Python ბიბლიოთეკა, რომელიც გამოიყენება მანქანური სწავლების მოდელებისთვის ინტერფეისების შესაქმნელად, ახლა დეველოპერებს საშუალებას აძლევს, გაუშვან Gradio აპლიკაციები Model Context Protocol (MCP) სერვერებად დიდი ენობრივი მოდელებისთვის (LLMs). ეს ინოვაცია Gradio აპებს აქცევს მძლავრ ხელსაწყოებად, რომელთა გამოყენება LLM-ებს შეუძლიათ სხვადასხვა ამოცანებისთვის – გამოსახულების გენერირებიდან დაწყებული, კონკრეტული გამოთვლებით დამთავრებული. სტატია აღწერს MCP სერვერის აგებას რამდენიმე ხაზი
LLM-ის გასწორების ალგორითმების ემპირიული შეფასება: DPO, IPO და KTO
ეს პოსტი წარმოადგენს დიდი ენობრივი მოდელების (LLM) გასწორების სამი პერსპექტიული ალგორითმის — Direct Preference Optimization (DPO), Identity Preference Optimisation (IPO) და Kahneman-Tversky Optimisation (KTO) — ემპირიულ შეფასებას. მასში აღწერილია IPO-ს იმპლემენტაციის მნიშვნელოვანი კორექტირება TRL-ში, რის შემდეგაც IPO DPO-ს თანაბრად ეფექტური აღმოჩნდა და KTO-ს აჯობა შეწყვილებული უპირატესობის პარამეტრებში. შეფასება მოიცავს სხვადასხვა მოდელებსა და ჰიპერპარამეტრებს, რათა დადგინდეს საუკეთესო მიდგომები

ხედვა-ენობრივი მოდელების ევოლუცია: სიახლეები, ტენდენციები და მომავალი
ხედვა-ენობრივი მოდელები (VLMs) დღესდღეობით ერთ-ერთი ყველაზე განხილვადი თემაა. 2024 წლის აპრილის ბლოგ პოსტში ვრცლად ვისაუბრეთ VLMs-ზე, მათ შორის LLaVA-ზე, პირველ წარმატებულ ღია წყაროს ხედვა-ენობრივ მოდელზე. მას შემდეგ მრავალი რამ შეიცვალა: მოდელები უფრო მცირე, მაგრამ ძლიერი გახდა, გაჩნდა ახალი არქიტექტურები და შესაძლებლობები (არგუმენტაცია, მოქმედება, გრძელი ვიდეოების გაგება). პარალელურად, განვითარდა ახალი პარადიგმები, როგორიცაა მულტიმოდალური ინფორმაციის მოძიებით გაძლიერებული გენერაცია (RAG) და მუ
PatchTSMixer: IBM Research-ისა და Hugging Face-ის რევოლუციური მოდელი დროითი სერიების მოდელირებისთვის
IBM Research-მა Hugging Face-თან ერთად წარმოადგინა PatchTSMixer, ინოვაციური მოდელი, რომელიც Transformers ბიბლიოთეკაშია ინტეგრირებული. ეს მოდელი შექმნილია მრავალვარიანტული დროითი სერიების ეფექტური მოდელირებისთვის, მსუბუქი შერევის გამოყენებით პაჩებს, არხებსა და დამალულ მახასიათებლებს შორის. PatchTSMixer მნიშვნელოვნად აღემატება არსებულ MLP და Transformer მოდელებს პროგნოზირებაში, აჩვენებს 8-60%-იან გაუმჯობესებას და ამცირებს მეხსიერების მოხმარებასა და შესრულების დროს. იგი მხარს უჭერს ტრანსფერულ სწავლ

ფალკონ-ეჯის სერია: ახალი სიტყვა ენობრივ მოდელებში ბიტნეტის არქიტექტურით
ახალი Falcon-Edge სერია წარმოადგენს მძლავრ ენობრივ მოდელებს, რომლებიც BitNet არქიტექტურაზეა დაფუძნებული. ეს მოდელები ინოვაციური წინასწარი ვარჯიშის პარადიგმის წყალობით ერთდროულად აწარმოებენ არაკვანტიზებულ და კვანტიზებულ ვარიანტებს. ისინი გამოირჩევიან ეფექტურობით, „მატრიცული გამრავლების გარეშე“ დიზაინით და ხელმისაწვდომია 1 მილიარდი და 3 მილიარდი პარამეტრის ზომებში, რაც მომხმარებლებს საშუალებას აძლევს მარტივად მოარგონ ისინი საკუთარ საჭიროებებს.
Falcon-Edge: BitNet არქიტექტურაზე დაფუძნებული მძლავრი ენის მოდელების ახალი სერია
Falcon-Edge წარმოგიდგენთ მძლავრ, უნივერსალურ და კონფიგურირებად ენის მოდელებს, რომლებიც დაფუძნებულია BitNet არქიტექტურაზე და ხელმისაწვდომია სამმაგ ფორმატში. ეს სერია ახორციელებს ახალ წინასწარ წვრთნის პარადიგმას, რომელიც ერთდროულად აწვდის როგორც არაკვანტიზებულ, ასევე კვანტიზებულ მოდელის ვარიანტებს, მათ შორის bfloat16 ფორმატის, მშობლიურ BitNet მოდელს და წინასწარ კვანტიზებულ BitNet ვარიანტს მარტივი დაზუსტებისთვის. მოდელები ხელმისაწვდომია 1 მილიარდი და 3 მილიარდი პარამეტრის ზომებში, როგორც საბაზისო,
მომხმარებლის საჭიროებების გაგება Auto ML-ით: HuggingFace AutoTrain-ისა და Kili-ის ინტეგრაცია
სტატია განიხილავს, თუ როგორ შეიძლება ავტომატური მანქანური სწავლის (Auto ML) გამოყენება, კერძოდ HuggingFace AutoTrain-ისა და Kili პლატფორმის მეშვეობით, მომხმარებელთა საჭიროებების ეფექტურად გასაგებად. წარმოდგენილია ტექსტის კლასიფიკაციისა და სენტიმენტური ანალიზის აქტიური სწავლის პაიპლაინის აგება, Medium-ის მომხმარებლის მიმოხილვების მაგალითზე Google Play Store-იდან. ეს მეთოდი ამცირებს ხარჯებს და აჩქარებს მონაცემთა ეტიკეტირებისა და მოდელის ვარჯიშის პროცესს.
DecodingTrust: LLM-ების სანდოობის შეფასების პლატფორმა და ახალი უსაფრთხოების ლიდერბორდი
2023 წელს Secure Learning Lab-მა წარმოადგინა DecodingTrust, პირველი ყოვლისმომცველი პლატფორმა დიდი ენობრივი მოდელების (LLM) სანდოობის შესაფასებლად. პლატფორმა მოიცავს რვა პერსპექტივას, მათ შორის ტოქსიკურობას, სტერეოტიპულ მიკერძოებას, კონფიდენციალურობასა და ეთიკას, და იყენებს ინოვაციურ „წითელი გუნდის“ (red-teaming) მეთოდოლოგიებს. ცოტა ხნის წინ, გამოქვეყნდა ახალი LLM უსაფრთხოების ლიდერბორდი, რომელიც LLM-ების უსაფრთხოების შეფასებაზეა ორიენტირებული.

დიდი ML მოდელების სწავლება: FullyShardedDataParallel (FSDP) შესაძლებლობები
მანქანური სწავლების (ML) მოდელების მუდმივად მზარდი მასშტაბები აპარატურულ შეზღუდვებს წარმოქმნის. ეს სტატია იკვლევს, თუ როგორ უმკლავდება განაწილებული სწავლება, კერძოდ PyTorch-ის FullyShardedDataParallel (FSDP) ფუნქცია, ამ გამოწვევას. ჩვენ ვადარებთ FSDP-ის წარმადობას DDP-სთან GPT-2 მოდელების გამოყენებით, ვაჩვენებთ FSDP-ის უნარს, მოახდინოს უფრო დიდი პაკეტის ზომების დამუშავება და კიდევ უფრო დიდი მოდელების სწავლება, რითაც ხელმისაწვდომს ხდის მძლავრ ML ტექნოლოგიებს.
ღრმა განმტკიცებითი სწავლება: ხელოვნური ინტელექტის მომავალი (სრული კურსის პირველი ნაწილი)
ეს სტატია ღრმა განმტკიცებითი სწავლების კურსის შესავალი ნაწილია, რომელიც ხელოვნური ინტელექტის ერთ-ერთ ყველაზე მომხიბვლელ სფეროს ეხება. აქ განმარტებულია, თუ როგორ სწავლობს აგენტი გარემოში ქცევას მოქმედებების შესრულებითა და შედეგების დანახვით. განიხილება დარგის მნიშვნელოვანი მიღწევები და მოწოდებულია დეტალური ინფორმაცია უფასო კურსის შესახებ, სადაც შეისწავლით თეორიასა და პრაქტიკას ცნობილი ბიბლიოთეკების გამოყენებით.

კვანტიზაციის ბეკენდები Hugging Face Diffusers-ში: მეხსიერების ოპტიმიზაცია და ხელმისაწვდომობა
ეს სტატია იკვლევს კვანტიზაციის სხვადასხვა ბეკენდს (მაგ., bitsandbytes, GGUF, torchao, Quanto, FP8) Hugging Face Diffusers-ში, რომლებიც დიდ ხელოვნური ინტელექტის მოდელებს უფრო ხელმისაწვდომს ხდის მეხსიერების მოხმარების მნიშვნელოვანი შემცირებით. ის წარმოადგენს აღქმის ტესტს, სადაც მომხმარებლებს შეუძლიათ შეადარონ ორიგინალური და კვანტიზებული მოდელების გამომუშავება განსხვავებების იდენტიფიცირებისთვის, რომლებიც ხშირად უმნიშვნელოა, განსაკუთრებით 8-ბიტიანი კვანტიზაციის დროს. სტატია ასევე დეტალურად აღწერს მე
Fastai-სა და Hugging Face Hub-ის ინტეგრაცია: ღრმა სწავლის მოდელების გაზიარება ერთი კლიკით
Hugging Face-ი სიამაყით აცხადებს fastai-სთან ინტეგრაციას, რაც fastai-ს პრაქტიკოსებს საშუალებას აძლევს, ერთი ხაზის პითონის კოდით ატვირთონ და გააზიარონ ღრმა სწავლის მოდელები Hugging Face Hub-ზე. ეს ნაბიჯი მიზნად ისახავს მანქანური სწავლის დემოკრატიზაციას, წინასწარ გაწვრთნილი მოდელების ჩათვლით, და ხელს უწყობს ღია კოდის საზოგადოების ზრდასა და თანამშრომლობას.
ახალი LLM ლიდერბორდი რეალურ ბიზნეს სცენარებში ენის მოდელების შეფასებისთვის
ეს ლიდერბორდი მიზნად ისახავს ენის დიდი მოდელების (LLM) მუშაობის შეფასებას რეალური ბიზნეს ამოცანების კონტექსტში. ის მხარს უჭერს 6 მრავალფეროვან დავალებას, როგორიცაა FinanceBench და იურიდიული კონფიდენციალურობა, და ზომავს მოდელების ეფექტურობას ისეთი მეტრიკებით, როგორიცაა სიზუსტე, ჩართულობა და ტოქსიკურობა. ლიდერბორდი შემუშავდა იმისათვის, რომ დაეხმაროს მომხმარებლებს პრაქტიკული გამოყენებისთვის საუკეთესო მოდელის არჩევაში და აქტიურად ცდილობს თავიდან აიცილოს ტესტ-კომპლექტის დაბინძურება ზოგიერთი მონაცემთა
Hugging Face-მა C სერიის დაფინანსებით 100 მილიონი დოლარი მოიზიდა: ხელოვნური ინტელექტის მომავლისკენ
Hugging Face-მა, ხელოვნური ინტელექტის წამყვანმა პლატფორმამ, 100 მილიონი დოლარის დაფინანსება მოიზიდა C სერიის ფარგლებში, Lux Capital-ის ხელმძღვანელობით, Sequoia-სა და Coatue-ის მნიშვნელოვანი მონაწილეობით. კომპანია, რომელიც 2018 წლიდან მასშტაბურ ზრდას განიცდის, განაგრძობს მანქანური სწავლების დემოკრატიზაციას ღია წყაროს, გამჭვირვალობისა და თანამშრომლობის პრინციპებზე დაყრდნობით, რათა ხელი შეუწყოს პასუხისმგებლიან ხელოვნურ ინტელექტს და გაუმკლავდეს სფეროს გამოწვევებს.
PatchTST: ინოვაციური მოდელი დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით
ICLR 2023-ზე წარდგენილი PatchTST მოდელი რევოლუციურ მიდგომას გვთავაზობს დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით. მოდელი ეფუძნება ინდივიდუალური დროითი რიგების „პაჩებად“ დაყოფას, რაც არაერთ სარგებელს იძლევა. სტატიაში აღწერილია PatchTST-ის ვარჯიში Electricity მონაცემთა ნაკრებზე და მისი ტრანსფერული სწავლის შესაძლებლობები ETTh1 მონაცემთა ნაკრებზე, სადაც ნაჩვენებია მნიშვნელოვანი გაუმჯობესება ნულოვანი სწავლის (zero-shot), წრფივი გამოძიების (linear probing) და სრული ფაინ
დიდი ენობრივი მოდელების (LLMs) მაღალეფექტური განთავსება: TGI და AWS Inferentia2 Amazon SageMaker-ში
ტექსტის გენერირების ინფერენცია (TGI) წარმოადგენს სპეციალურად შექმნილ გადაწყვეტას დიდი ენობრივი მოდელების (LLMs) მასშტაბური განთავსებისა და სერვისისთვის. TGI უზრუნველყოფს მაღალეფექტურ ტექსტის გენერაციას Tensor Parallelism-ისა და უწყვეტი დაჯგუფების გამოყენებით Llama-ს, Mistral-ის და სხვა პოპულარული ღია LLM-ებისთვის. AWS Inferentia2-თან ინტეგრაცია Amazon SageMaker-ში TGI-ს აქცევს მძლავრ ალტერნატივად GPU-ებისთვის LLM აპლიკაციების შესაქმნელად. ეს ინტეგრაცია ამარტივებს მოდელების განთავსებას და შენარჩუ

„პატარა აგენტები“ პითონში: ახალი ეპოქა LLM-ების და ინსტრუმენტების ურთიერთქმედებაში
ეს ბლოგპოსტი წარმოგიდგენთ „პატარა აგენტების“ (Tiny Agents) პითონზე პორტირებას, სადაც `huggingface_hub` კლიენტის SDK გაფართოვდა, რათა იმოქმედოს როგორც MCP კლიენტი. მთავარი სიახლეა MCP (მოდელის კონტექსტის პროტოკოლი), ღია სტანდარტი, რომელიც აერთიანებს დიდი ენობრივი მოდელების (LLM) გარე ინსტრუმენტებთან და API-ებთან ურთიერთქმედებას, რითაც აღარ საჭიროებს ყოველი ინსტრუმენტისთვის მორგებულ ინტეგრაციებს. სტატია განმარტავს, თუ როგორ უნდა დაიწყოთ მუშაობა პითონის აგენტებთან, რომლებიც დაკავშირებულია MCP სერვე

LLM-ების ოპტიმიზაცია: TRL-ის ახალი მიდგომა GRPO სწავლების მეხსიერების შესამცირებლად
დიდი ენობრივი მოდელების (LLM) დახვეწა განმტკიცებითი სწავლის (RL) გამოყენებით გადამწყვეტია რთული ქცევების მისაღწევად. ტრადიციულად ამისთვის გამოიყენება PPO ალგორითმი RLHF-თან ერთად, რაც, თუმცა, რესურსმომხმარებელია და მრავალი მოდელის მეხსიერებაში ჩატვირთვას მოითხოვს. DeepSeek-ის R1 მოდელთან ერთად პოპულარობას იძენს ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO), რომელიც იყენებს შემოწმებად ჯილდოს ფუნქციებს გარე ჯილდოს მოდელის გარეშე, რაც მნიშვნელოვან გაუმჯობესებას იძლევა. მიუხედავად ამისა, RL სწავლე
SegMoE მოდელების გამოშვება: როგორ გავაერთიანოთ დიფუზიური მოდელები მარტივად
SegMoE წარმოადგენს ახალ მიდგომას დიფუზიური მოდელების შექმნაში, რომელიც სტეიბლ დიფუჟენის არქიტექტურას ეფუძნება და Mixtral 8x7b-ის მსგავსად, რამდენიმე მოდელს ერთში აერთიანებს. ის Feed-Forward შრეებს ცვლის იშვიათი MoE შრით, რომელიც ექსპერტთა როუტერულ ქსელს იყენებს. SegMoE პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა, რაც აუმჯობესებს პრომპტების გაგებას. მოდელი მხარს უჭერს Hugging Face-ისა და CivitAI-ის პლატფორმებს. თუმცა, მას აქვს შეზღუდვები, როგორიცაა ნელი სიჩქარე და VRAM-ის მაღალი მ

ხელოვნური ინტელექტის აგენტების ევოლუცია: სტრუქტურული კოდის გენერაციის უპირატესობა
კვლევა იკვლევს ხელოვნური ინტელექტის აგენტების არქიტექტურის ევოლუციას, ადარებს ტრადიციულ JSON აგენტებს, CodeAgent-ებს და ახალ სტრუქტურულ CodeAgent-ებს. ეს უკანასკნელი აერთიანებს კოდის მოქნილობასა და სტრუქტურული გამომავალი მონაცემების სანდოობას, რაც მნიშვნელოვნად ამცირებს ანალიზის (parsing) შეცდომებს და აუმჯობესებს აგენტების მუშაობას. ნაჩვენებია, რომ სტრუქტურული გენერაცია აიძულებს აგენტებს, უფრო მკაფიოდ გამოხატონ თავიანთი მსჯელობა, თუმცა აღინიშნება, რომ ამ მიდგომის სრული პოტენციალი ვლინდება მაღალი
AI აგენტების ევოლუცია: სტრუქტურირებული კოდის მოქმედებების უპირატესობა
ხელოვნური ინტელექტის აგენტების მოქმედებების გამოხატვის მეთოდები ევოლუციას განიცდის, ტრადიციული JSON აგენტებიდან კოდის აგენტებამდე. უახლესი კვლევა ხაზს უსვამს სტრუქტურირებული CodeAgent-ების უპირატესობას, რომლებიც აერთიანებენ კოდის მოქნილობასა და სტრუქტურირებული გენერაციის საიმედოობას. ეს ინოვაციური მიდგომა მნიშვნელოვნად ამცირებს პარსინგის შეცდომებს, აუმჯობესებს აგენტების მუშაობას 2-7 პროცენტული პუნქტით ძლიერ მოდელებში და აიძულებს მათ მოქმედებამდე არტიკულირონ თავიანთი მსჯელობა. თუმცა, აღინიშნა, რო
Hugging Face-ის ფელოუშიპის პროგრამა: ღია წყაროს კონტრიბუტორების მხარდაჭერა და გავლენის გაზრდა
Hugging Face-ის ფელოუშიპის პროგრამა მიზნად ისახავს ღია წყაროს მანქანური სწავლების კონტრიბუტორების გაძლიერებას. პროგრამა სთავაზობს რესურსებს, აღიარებას და დამხმარე საზოგადოებას, რათა მონაწილეებმა გაზარდონ თავიანთი გავლენა და განახორციელონ ის პროექტები, რაზეც ყოველთვის ოცნებობდნენ. ფელოუშიპი მხარს უჭერს მრავალფეროვნებას და მიესალმება ნებისმიერი წარმომავლობის მქონე პირებს, ხაზს უსვამს ინდივიდუალურ წვლილს სფეროს დემოკრატიზაციაში.
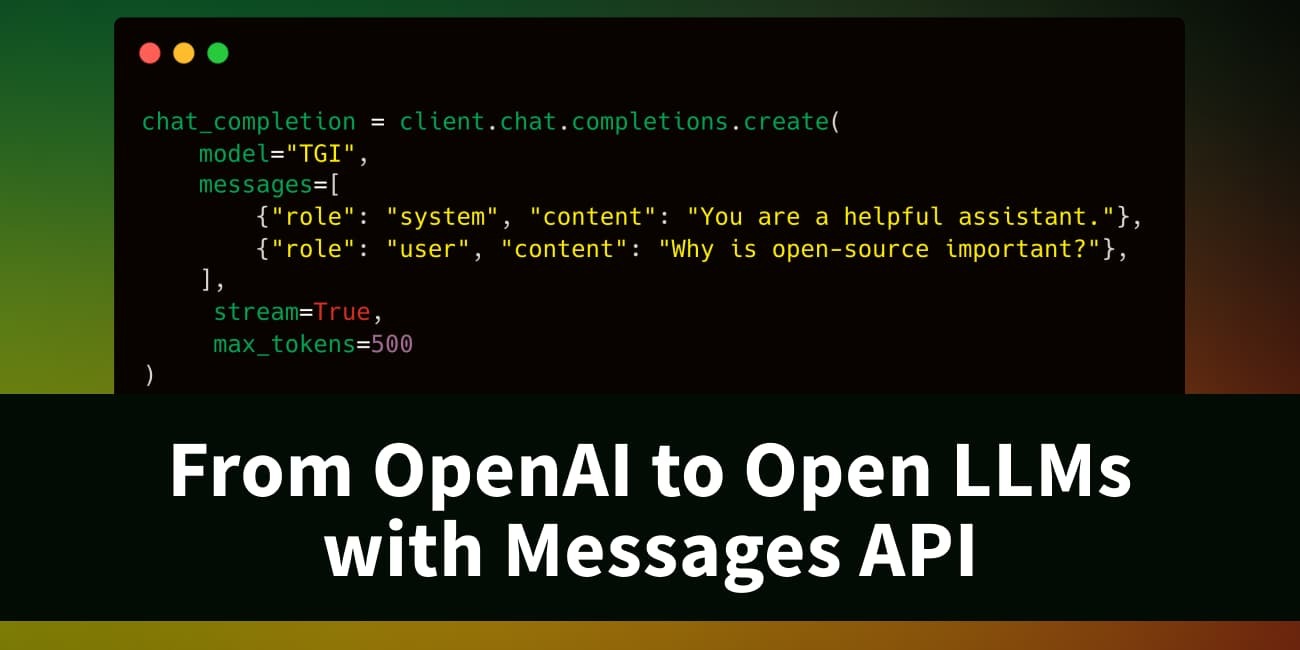
TGI-ის Messages API: უწყვეტი გადასვლა ღია LLM-ებზე OpenAI-ის თავსებადობით
TGI (Text Generation Inference) 1.4.0 ვერსიიდან მოყოლებული, გთავაზობთ Messages API-ს, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-თან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდი ენის მოდელებზე (LLM-ებზე), არსებული კლიენტის ბიბლიოთეკების ან მესამე მხარის ხელსაწყოების (როგორიცაა LangChain და LlamaIndex) გამოყენებით. სტატია დეტალურად აღწერს მოდელების Hugging Face Inference Endpoints-ზე განთავსების, ტექნიკური კონფიგურაც