Prodigy-HF: Hugging Face მოდელების გაწვრთნა და ანოტირებული მონაცემთა ნაკრებების გაზიარება
Explosion-მა გამოუშვა Prodigy-HF, ახალი პლაგინი, რომელიც Prodigy-ის ანოტაციის ხელსაწყოს Hugging Face-ის ეკოსისტემასთან აინტეგრირებს. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს, გაწვრთნან Hugging Face მოდელები საკუთარ ანოტირებულ მონაცემებზე (მაგ. დასახელებული ერთეულების ამოცნობისთვის და ტექსტის კლასიფიკაციისთვის) და გამოაქვეყნონ ეს მონაცემთა ნაკრებები Hugging Face Hub-ზე, რაც ხელს უწყობს მოქნილობას, თანამშრომლობას და დროის დაზოგვას ხელოვნური ინტელექტის პროექტებში.
Hugging Face Infinity: ტრანსფორმერული მოდელების ოპტიმალური განთავსება Intel Xeon CPU-ებზე
Hugging Face Infinity არის კონტეინერიზებული გადაწყვეტა, რომელიც საშუალებას აძლევს კომპანიებს ეფექტურად განათავსონ ტრანსფორმერული მოდელები წარმოებაში დაბალი ლატენტურობითა და მაღალი გამტარუნარიანობით. ეს ბლოგ პოსტი წარმოადგენს დეტალურ წარმადობის შედეგებს Infinity-ის უახლესი თაობის Intel Xeon CPU-ებზე გაშვებისას (კერძოდ, Ice Lake-ზე დაფუძნებული EC2 C6i ინსტანსებზე), რაც უზრუნველყოფს ოპტიმალურ ღირებულებას, ეფექტურობასა და ლატენტურობას თქვენი Transformer-ის განთავსებისთვის.
Llama 2-ის ეფექტური განთავსება AWS Inferentia2-ზე Hugging Face Optimum Neuron-ის მეშვეობით
Hugging Face-ის ბლოგზე ადრე წარდგენილი AWS Inferentia2-ის გაფართოების შედეგად, ახლა შესაძლებელია დიდი ენობრივი მოდელების (LLM) განთავსება ტექსტის გენერაციისთვის AWS Inferentia2 ინსტანციებზე Optimum Neuron-ის გამოყენებით. სტატია დეტალურად აღწერს Llama 2-ის განთავსების პროცესს, გთავაზობთ რეკომენდაციებს Hugging Face Neuron Deep Learning AMI-ზე ან Amazon SageMaker-ზე განთავსების შესახებ და განმარტავს მოდელების კომპილაციასა და ექსპორტს. ასევე, მოცემულია Inferentia2-ზე ტექსტის გენერაციის ეფექტურობის ა

Meta-ს Llama 4-ის მოდელები გამოვიდა: წინ გადადგმული ნაბიჯი მულტიმოდალურ ხელოვნურ ინტელექტში MoE არქიტექტურითა და გაფართოებული კონტექსტით
Meta-ს მიერ შემუშავებული Llama 4-ის მოდელები, Maverick და Scout, დღეს გამოვიდა, რაც ხელოვნური ინტელექტის სფეროში მნიშვნელოვან წინსვლას წარმოადგენს. ეს მძლავრი, მშობლიურად მულტიმოდალური მოდელები იყენებენ ახალ ავტორეგრესიულ „ექსპერტთა ნაზავის“ (MoE) არქიტექტურას, რაც მათ საშუალებას აძლევს დაამუშაონ როგორც ტექსტური, ისე გამოსახულების შეტანა. Hugging Face-ის ეკოსისტემასთან სრულყოფილი ინტეგრაციის უზრუნველყოფით, Llama 4-ის მოდელები გაწვრთნილია 200 ენაზე (40 ტრილიონამდე ტოკენზე) და გამოირჩევა კონტექსტი
Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაცია: მოდელების განთავსება, ჩატვირთვა და გაზიარება
ეს სტატია წარმოგიდგენთ Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაციას, რაც მომხმარებლებს საშუალებას აძლევს მარტივად განათავსონ, ჩატვირთონ და გააზიარონ ღრმა განმტკიცებითი სწავლის მოდელები. მოცემულია სახელმძღვანელო, თუ როგორ გამოიყენოთ ეს ახალი ფუნქციონალი, მათ შორის საჭირო ბიბლიოთეკების ინსტალაცია, საზოგადოების მოდელების პოვნა, გაწვრთნილი აგენტების ატვირთვა და საზოგადოებასთან ურთიერთობა ეკოსისტემის სამომავლო გაფართოებისთვის.

არაბული AI მოდელების შეფასების პლატფორმისა და AraGen ეტალონის მნიშვნელოვანი განახლებები
მიმდინარე ძალისხმევის ფარგლებში, წარმოდგენილია მნიშვნელოვანი განახლებები არაბული AI მოდელების შეფასების პლატფორმაზე. ამოქმედდა Arabic-Leaderboards, რომელიც არაბული ენის მოდელების შეფასებისთვის ერთიან სივრცეს წარმოადგენს. დეკემბერში დაინერგა AraGen ეტალონი დინამიური შეფასების მეთოდოლოგიით, სადაც მონაცემთა ნაკრები სამი თვის განმავლობაში კონფიდენციალური რჩება სამართლიანი შეფასებისთვის. გაფართოვდა AraGen მონაცემთა ნაკრები და დაიხვეწა შემფასებელი სისტემის მოთხოვნები. მიუხედავად იმისა, რომ ახალმა განა

Visual Salamandra: მულტიმოდალური AI მოდელი ევროპული ენობრივი მრავალფეროვნების მხარდასაჭერად
Visual Salamandra, ახალი მულტიმოდალური ხელოვნური ინტელექტის მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან, ხედვისა და ენის დამუშავების უფსკრულს ავსებს. მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანიდან, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტიდან. ლაბორატორიის მიერ შექმნილი ეს ინოვაცია ხაზს უსვამს მრავალენოვან ინკლუზიურობას, განსაკუთრებული აქცენტით ევროპულ ენებზე, რაც ხელს უწყობს მულტიმოდალური AI კვლევის რესურსების ნა
სენტიმენტების ანალიზი ყველასთვის: როგორ გამოვიყენოთ ხელოვნური ინტელექტის თანამედროვე ხელსაწყოები
წარსულში სენტიმენტების ანალიზი მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, მაგრამ ხელოვნური ინტელექტის საზოგადოების მიერ შექმნილმა ინოვაციურმა ხელსაწყოებმა ის ყველასთვის მარტივად ხელმისაწვდომი გახადა. ეს სახელმძღვანელო გვიჩვენებს, თუ როგორ შეიძლება Python-ისა და Hugging Face Hub-ის გამოყენებით ტექსტის ემოციური პოლარობის იდენტიფიცირება, მონაცემების მასშტაბური დამუშავება და მოდელების ოპტიმიზაცია კონკრეტული ამოცანებისთვის, გამოცდილების გარეშეც კი.

Optimum-NVIDIA: LLM-ის ინფერენსის რევოლუციური აჩქარება NVIDIA პლატფორმაზე
Hugging Face-ის Optimum-NVIDIA ბიბლიოთეკა მნიშვნელოვნად აჩქარებს დიდი ენობრივი მოდელების (LLM) ინფერენსს NVIDIA პლატფორმაზე, კოდის მხოლოდ ერთი ხაზის შეცვლით 28-ჯერ უფრო სწრაფ მუშაობას და 1,200 ტოკენს/წამში სიჩქარეს უზრუნველყოფს. ის პირველი Hugging Face ბიბლიოთეკაა, რომელიც სარგებლობს ახალი float8 (FP8) ფორმატით, რაც კიდევ უფრო აუმჯობესებს გამტარუნარიანობას და ამცირებს პირველი ტოკენის ლატენტურობას, რაც საშუალებას იძლევა, უფრო დიდი მოდელები ერთ GPU-ზე გაეშვას სიზუსტის დაკარგვის გარეშე. აღნიშნული ტ

ხელოვნური ინტელექტი: გამოსახულებების ტოკენიზაცია და ViT მოდელების წვრთნა
ეს სტატია განმარტავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია წინადადებების მსგავსად, რაც მათ საშუალებას აძლევს, დამუშავდეს ტრანსფორმერული მოდელებით. დეტალურად არის აღწერილი 🤗 datasets-ის გამოყენებით მონაცემთა მომზადება, ViTImageProcessor-ის ინტეგრირება და წინასწარ გაწვრთნილი ViT მოდელების დაზუსტება. მიმოხილულია ტრენინგის კონფიგურაციის, შეფასების მეტრიკების განსაზღვრისა და ეფექტური წვრთნის კონვეიერის აგების პროცესები, რაც მნიშვნელოვან წინსვლას წარმოადგენს გამოსახულების კლასიფიკაციის ამოცანებშ

Hugging Face AMD Instinct GPU-ების სრულყოფილ მხარდაჭერას აცხადებს ხელოვნური ინტელექტის მოდელებისთვის
AMD-ის უახლესი Instinct MI300 სერიის ამაჩქარებლების მოახლოებულ გამოშვებასთან ერთად, Hugging Face აძლიერებს AMD GPU-ების მხარდაჭერას, რაც მომხმარებლებს საშუალებას აძლევს, გაუშვან Transformers-ის ყველა მოდელი და ამოცანა კოდის ყოველგვარი ცვლილების გარეშე. თანამშრომლობა მოიცავს ინტეგრირებულ ტესტირებას, გარემოსდაცვითი კვალის მინიმიზაციას და მნიშვნელოვან წარმადობის გაუმჯობესებას, განსაკუთრებით დიდი ენობრივი მოდელებისთვის და ტექსტის გენერირების ინფერენციისთვის (TGI), სადაც AMD Instinct MI250 GPU აჭარბე
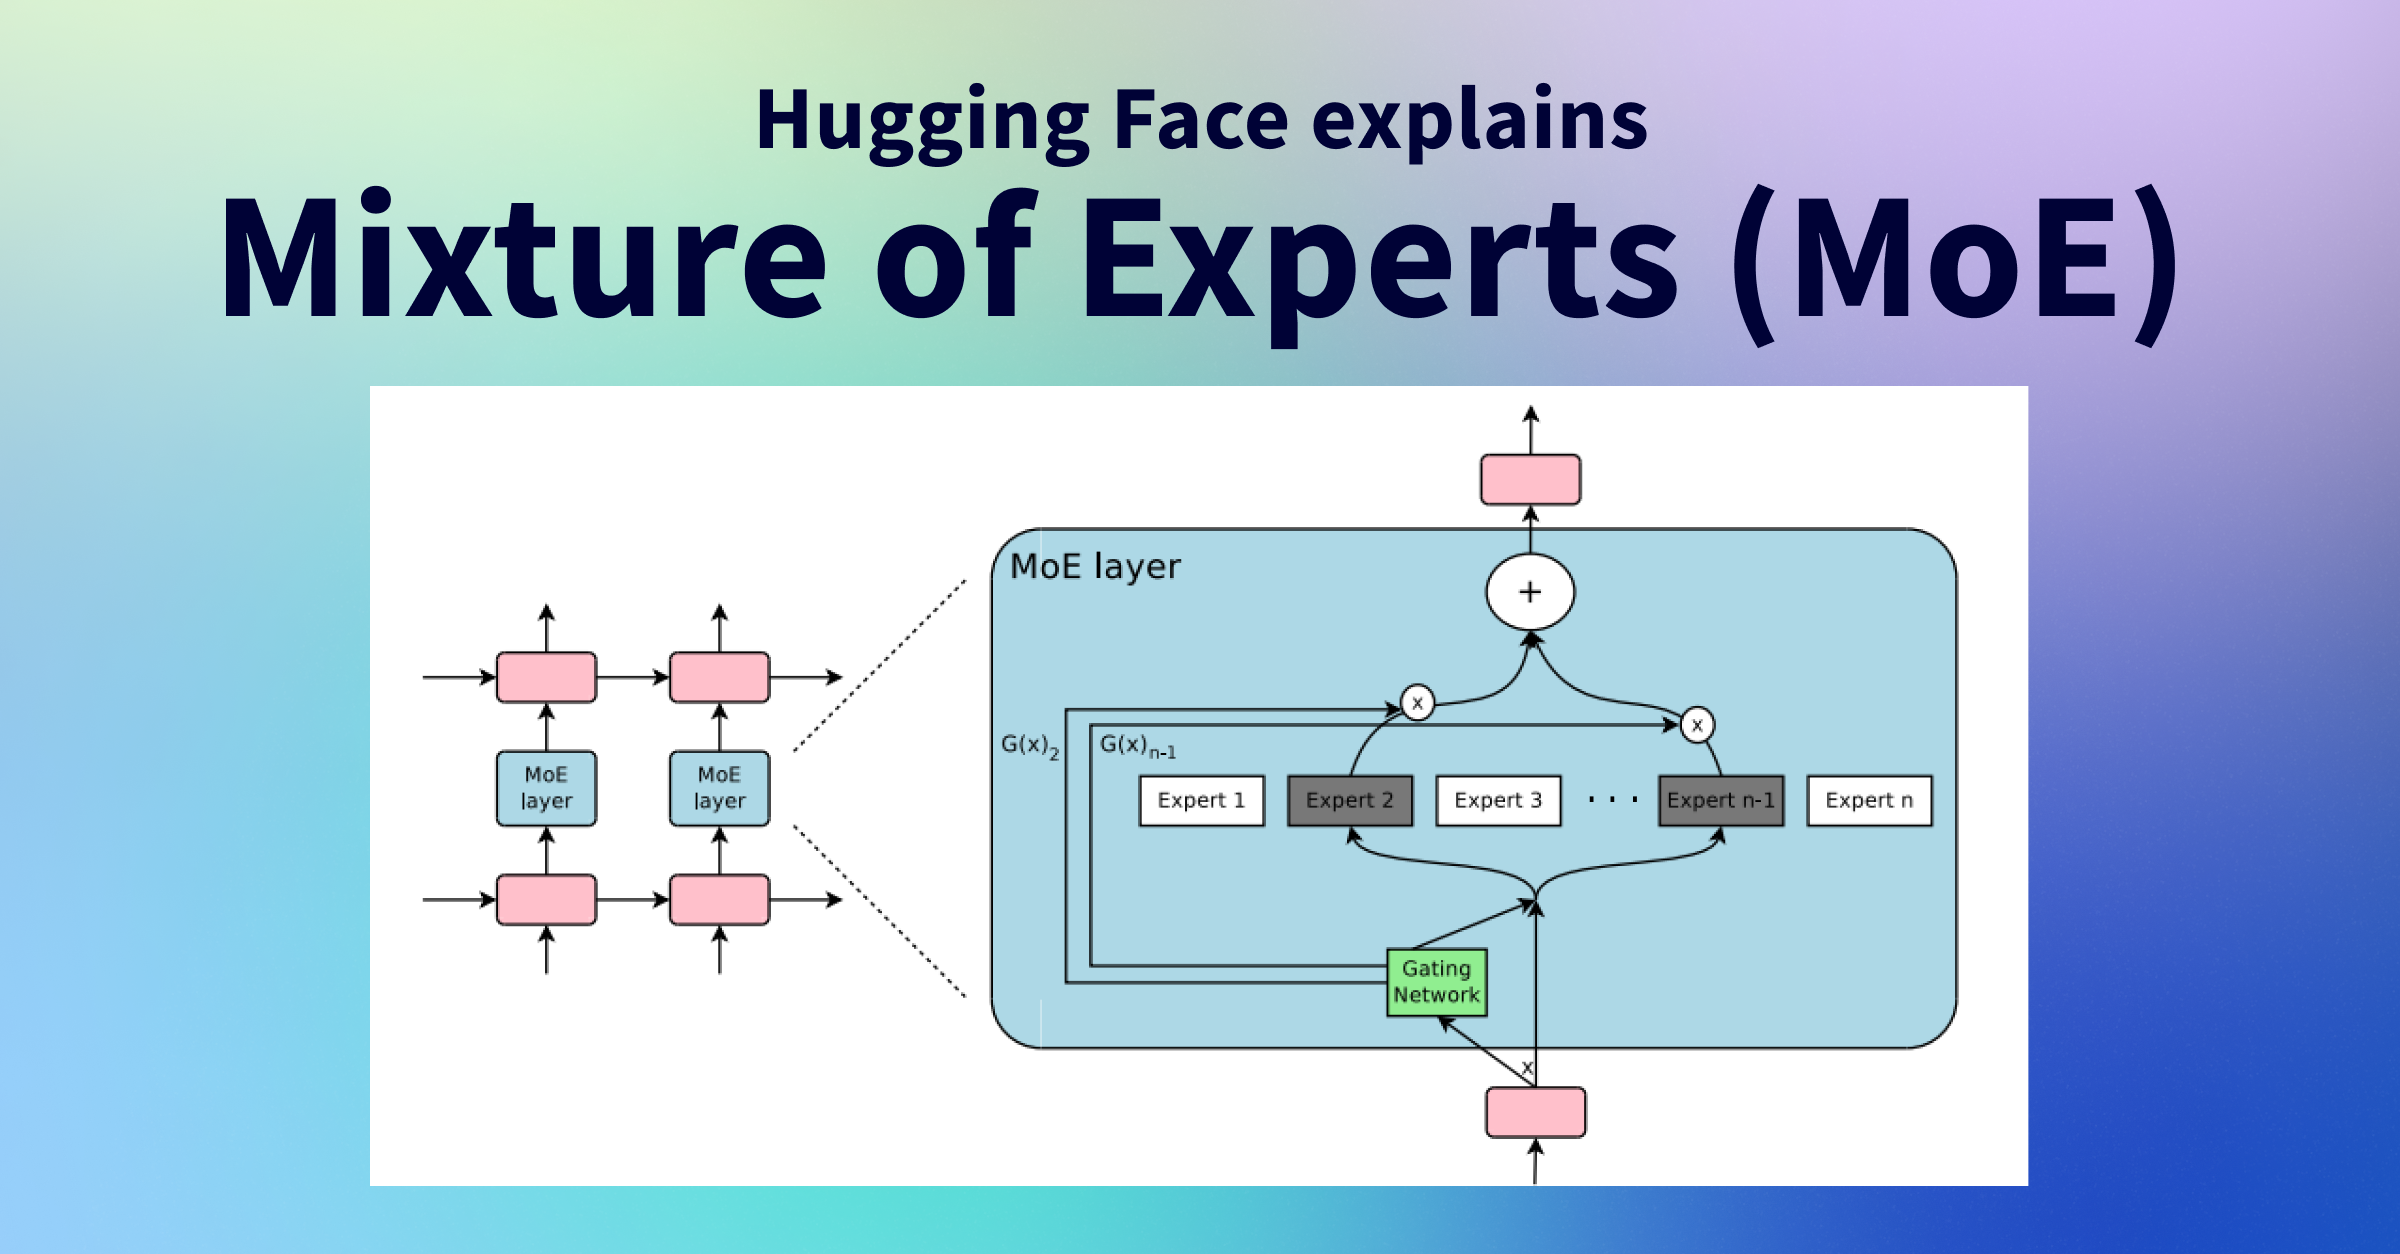
ექსპერტთა ნაზავი (MoEs): სიღრმისეული მიმოხილვა და იშვიათი მოდელების როლი
ექსპერტთა ნაზავი (MoEs) წარმოადგენს მნიშვნელოვან მიღწევას ხელოვნურ ინტელექტში, რომელიც საშუალებას აძლევს მოდელებს, მიაღწიონ უკეთეს ხარისხს გაცილებით ნაკლები გამოთვლითი რესურსებით. MoEs-ის მეშვეობით შესაძლებელია მოდელის ან მონაცემთა ნაკრების ზომის მნიშვნელოვნად გაზრდა მკვრივ მოდელებთან შედარებით, ერთი და იგივე ბიუჯეტის პირობებში, რაც უზრუნველყოფს უფრო სწრაფ წინასწარ წვრთნას. სტატია განმარტავს MoE-ის კონცეფციას ტრანსფორმერული მოდელების კონტექსტში, განიხილავს მის შემადგენელ ნაწილებს (კარიბჭის ქსელი

Gradio: ყოვლისმომცველი ჩარჩო AI/ML აპლიკაციების შესაქმნელად – მეტი, ვიდრე უბრალო UI ბიბლიოთეკა
Gradio, რომელიც ხშირად აღიქმება მხოლოდ UI ბიბლიოთეკად, სინამდვილეში არის ყოვლისმომცველი ჩარჩო მანქანური სწავლების მოდელებთან ურთიერთობისთვის UI-ებისა და API-ების მეშვეობით, რომელიც უზრუნველყოფს მაღალ შესრულებას, უსაფრთხოებასა და რეაგირებას. სტატია დეტალურად განიხილავს Gradio-ს უნიკალურ მახასიათებლებს, როგორებიცაა API Recorder, სერვერული რენდერინგი (SSR), დახვეწილი რიგების სისტემა, სტრიმინგი, მრავალგვერდიანი აპლიკაციების მხარდაჭერა, Groovy ტრანსპილაცია, თემების სისტემა, დინამიური რენდერინგი, Grad

BERT-ისა და ტრანსფორმერების დაჩქარება AWS Inferentia-ს მეშვეობით: სრულფასოვანი გზამკვლევი
ტრანსფორმერებზე დაფუძნებული მოდელები ხელოვნურ ინტელექტში სულ უფრო ფართოდ გამოიყენება, თუმცა მათი ზომა და სირთულე დიდმასშტაბიანი ამოცანებისთვის გამოწვევას წარმოადგენს. AWS ამ პრობლემას Inferentia ჩიპით აგვარებს, რომელიც სპეციალურად ოპტიმიზირებულია ინფერენციისთვის, უზრუნველყოფს ხარჯების 80%-მდე შემცირებას და 2.3-ჯერ მეტ გამტარუნარიანობას. ეს სტატია განმარტავს, თუ როგორ შეიძლება Hugging Face Transformers-ის, Amazon SageMaker-ისა და AWS Inferentia-ს კომბინაციით BERT-ის ინფერენციის დაჩქარება ტექსტის

დიდი ენობრივი მოდელების ოპტიმიზაცია: ინფერენციის ფაზების გამოწვევები
კომპანია TNG-ი დიდი ენობრივი მოდელების (LLM) თვით-ჰოსტინგის გამოცდილებას გვიზიარებს, სადაც 24 H100 GPU-ს კლასტერი საათში 5000-ზე მეტ ინფერენციას ამუშავებს. სტატიაში დეტალურად არის განხილული ტოკენების გენერაციის ავტორეგრესიული ბუნება, KV ქეშის როლი და განსხვავება 'პრეფილის' (პირველი ტოკენის გენერაცია) და 'დეკოდირების' (შემდგომი ტოკენების გენერაცია) ფაზებს შორის. განმარტებულია, თუ როგორ მოქმედებს ეს ფაზები შეყოვნებაზე (latency) და გამტარუნარიანობაზე (throughput), და როგორ გამოიყენება GPU რესურსები
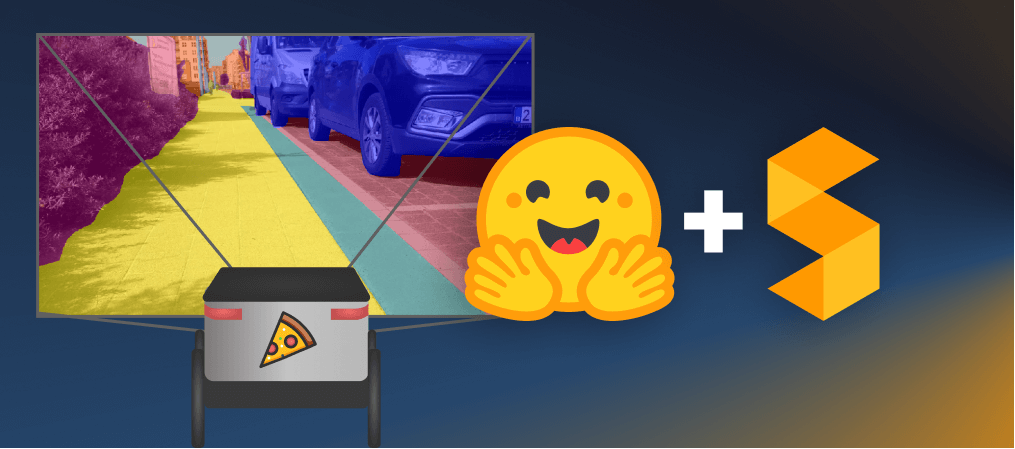
სემანტიკური სეგმენტაცია SegFormer-ით: ავტონომიური სისტემების გაუმჯობესება
სემანტიკური სეგმენტაცია გამოსახულების თითოეული პიქსელის კლასიფიკაციის ამოცანაა, რაც გამოსახულების ანალიზის უფრო ზუსტი მეთოდია. მას ფართო გამოყენება აქვს ისეთ სფეროებში, როგორიცაა სამედიცინო გამოსახულება და ავტონომიური მართვა. სტატია განიხილავს SegFormer მოდელს, რომელიც იყენებს ტრანსფორმერებს სემანტიკური სეგმენტაციისთვის და წარმოადგენს უახლეს მიღწევებს ამ სფეროში. ნაჩვენებია, თუ როგორ იქმნება და მუშავდება სპეციალიზებული მონაცემთა ნაკრები პიცის მიმწოდებელი რობოტისთვის, რაც უზრუნველყოფს მის ეფექტურ
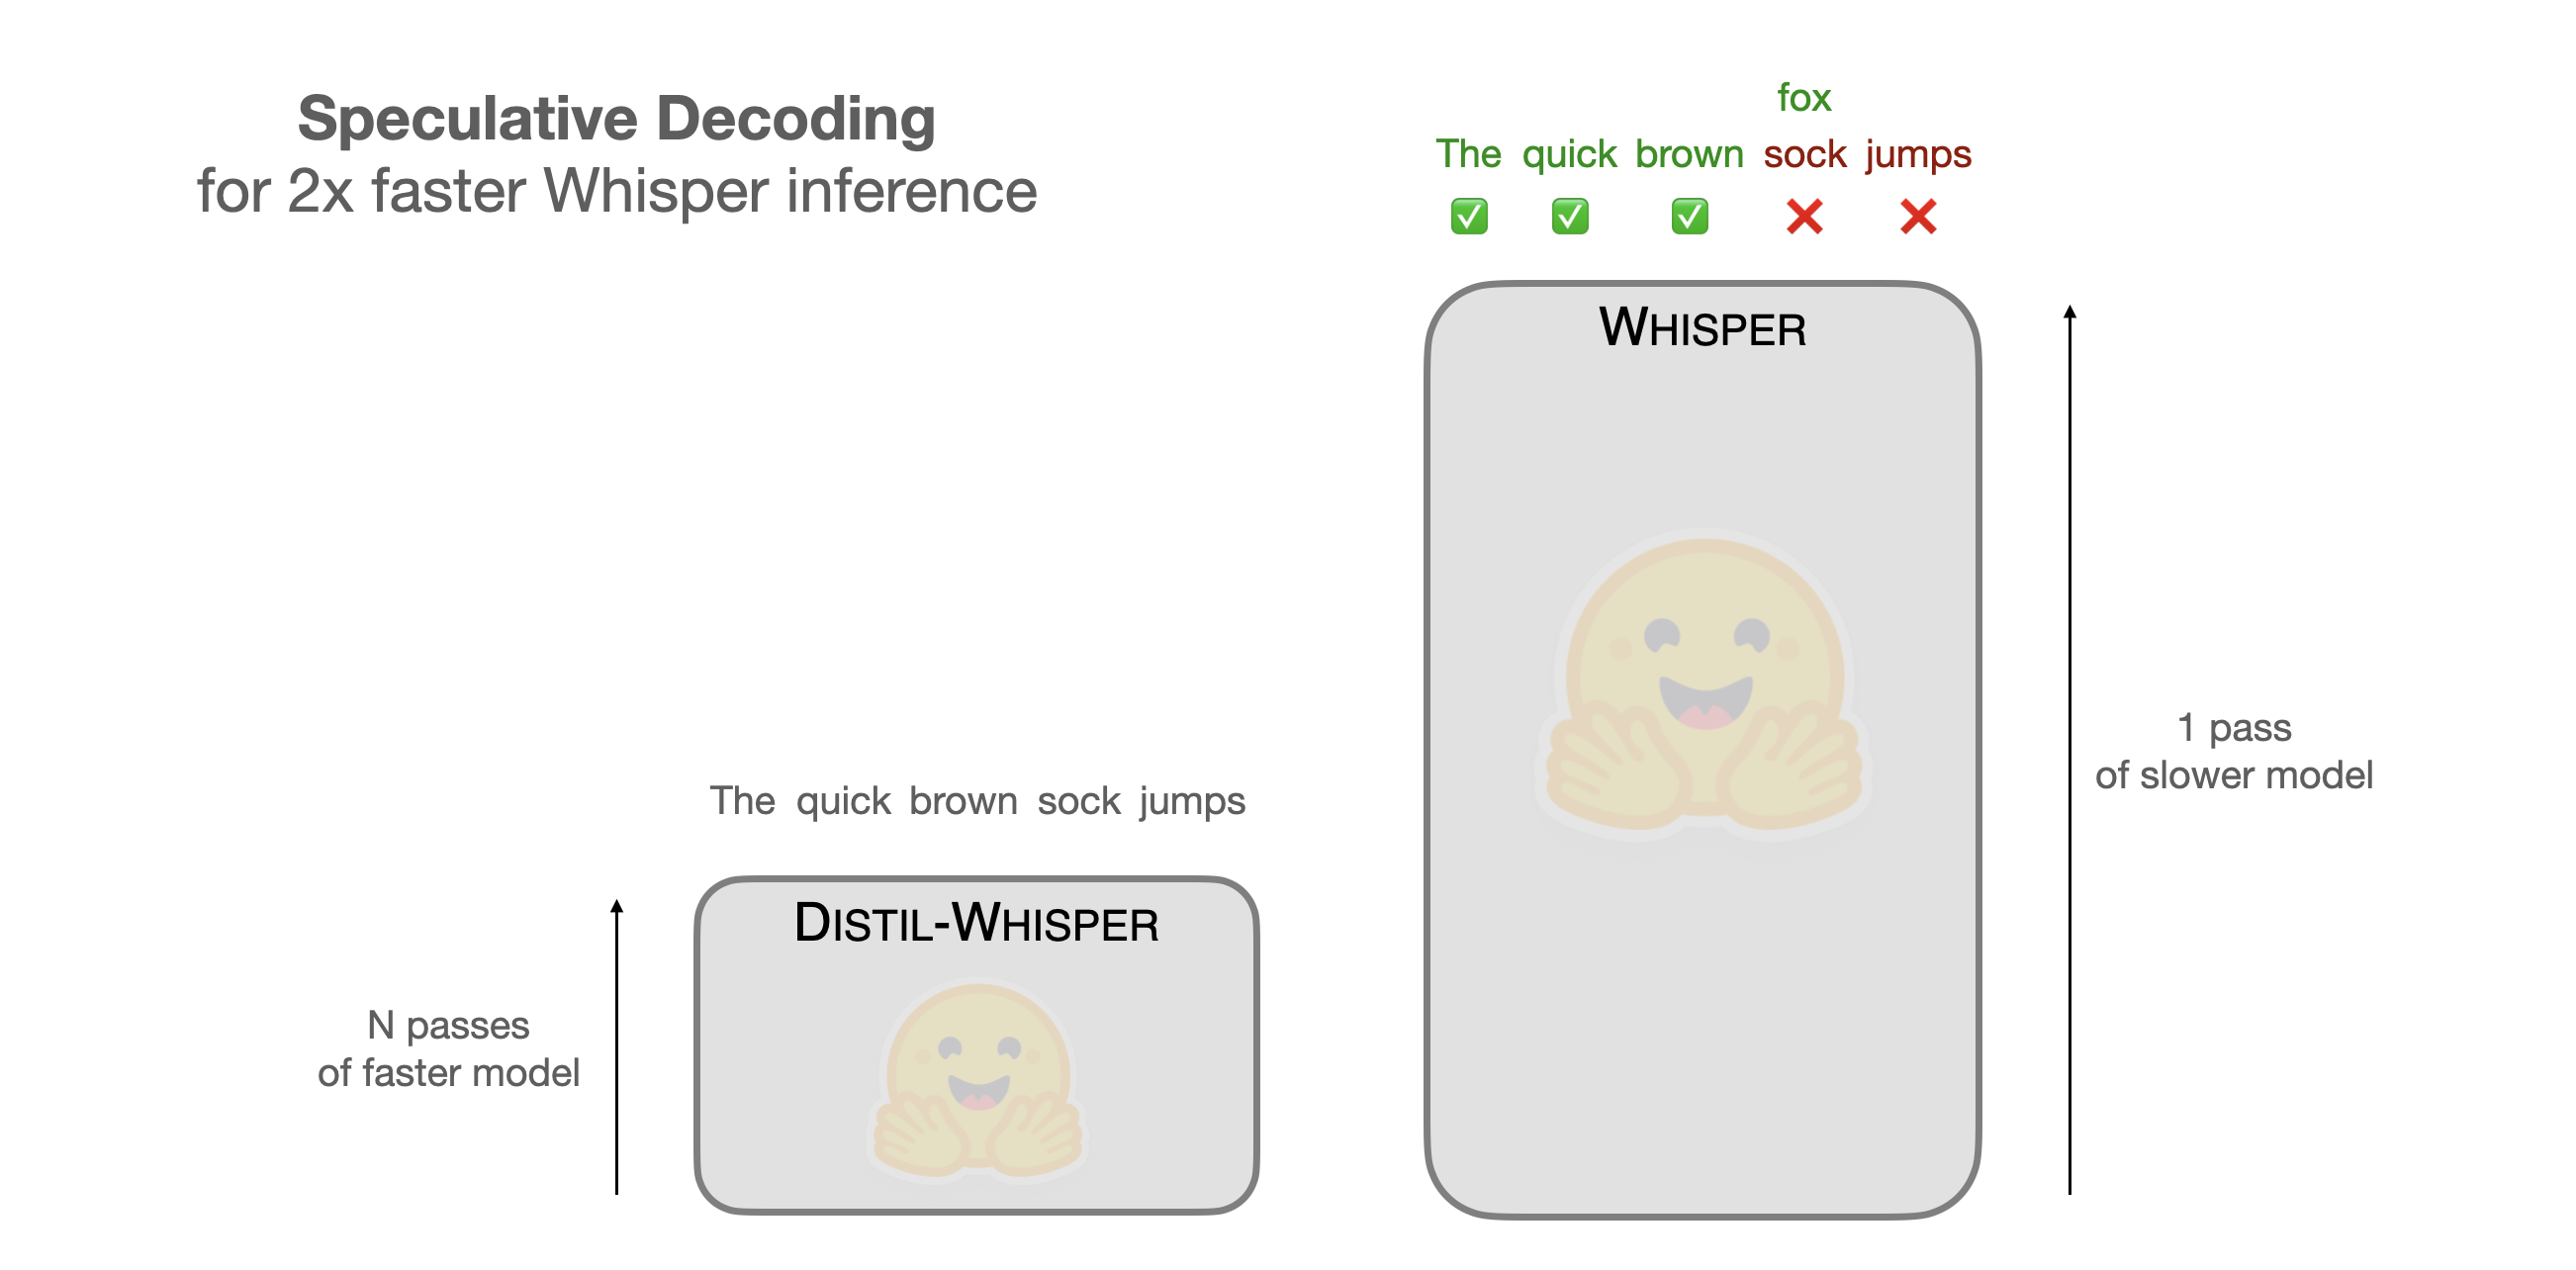
Whisper-ის სიჩქარის გაორმაგება: Speculative Decoding-ის ინოვაციური მეთოდი
მიუხედავად Whisper-ის ტრანსკრიფციის გამორჩეული სიზუსტისა, მისი დამუშავების (ინფერენციის) დრო საკმაოდ ნელია. ეს სტატია წარმოადგენს Speculative Decoding-ის მეთოდს, რომელიც Whisper-ის ინფერენციის დროს 2-ჯერ ამცირებს, სიზუსტის შენარჩუნებით. ეს ინოვაციური მიდგომა უზრუნველყოფს ზუსტად იგივე შედეგებს, რაც მოდელის სტანდარტული გამოყენებისას მიიღება, რაც მას არსებული Whisper-ის სისტემებისთვის იდეალურ ალტერნატივად აქცევს.
SDXL Dreambooth LoRA ტრენინგის რევოლუცია: Pivotal Tuning-ისა და Prodigy ოპტიმიზატორის კომბინაციით
ამ სტატიაში წარმოდგენილია Dreambooth LoRA-ების SDXL-ისთვის ოპტიმიზაციის ახალი მეთოდი, რომელიც აერთიანებს Replicate-ის SDXL Cog ტრენერში გამოყენებულ Pivotal Tuning ტექნიკას Kohya ტრენერის Prodigy ოპტიმიზატორთან. ეს მიდგომა, სხვა მრავალ ოპტიმიზაციასთან ერთად, უზრუნველყოფს საუკეთესო შედეგებს ახალი კონცეფციების აღბეჭდვაში მცირე რაოდენობის გამოსახულებების გამოყენებით, SDXL-ის ესთეტიკური ხარისხისა და გამოსახულების სიზუსტის შენარჩუნებით, ამასთანავე მოითხოვს შედარებით ნაკლებ გამოთვლით რესურსებს. გაეცანი

MCP (Model Context Protocol): ახალი სტანდარტი AI აგენტებისა და LLM-ების ინტეგრაციისთვის
ბოლო კვირების განმავლობაში, MCP-ის (Model Context Protocol) სიღრმისეული შესწავლის შედეგად, ნათელი გახდა მისი მნიშვნელობა ხელოვნური ინტელექტის განვითარებაში. ეს არის მარტივი, მაგრამ ძლიერი სტანდარტული API, რომელიც დიდ ენობრივ მოდელებს (LLM) საშუალებას აძლევს, ეფექტურად გამოიყენონ სხვადასხვა ხელსაწყოები. სტატია დეტალურად აღწერს MCP კლიენტის განხორციელებას Typescript-ში და ხაზს უსვამს, თუ როგორ ამარტივებს ის Agentic AI-ს შექმნას. იგი განიხილავს LLM-ების „ფუნქციის გამოძახების“ შესაძლებლობებს და აჩვე
წარმოგიდგენთ aMUSEd-ს: ეფექტურ არადიფუზიურ ტექსტიდან გამოსახულების გენერაციის მოდელს
გაეცანით aMUSEd-ს, Google-ის MUSE-ის ღია რეპროდუქციას. ეს არის სწრაფი, არადიფუზიური ტექსტიდან გამოსახულების გენერაციის მოდელი, რომელიც ეფუძნება ნიღბიანი გამოსახულების მოდელირების (MIM) მეთოდოლოგიას. მიუხედავად იმისა, რომ მისი ხარისხი არ არის უმაღლესი დონის, ის გვთავაზობს სტილის გადაცემის, გამოსახულების inpainting-ის შესაძლებლობებს და ხელს უწყობს MIM ფრეიმვორკების კვლევას. მოდელი გამოშვებულია ნებადართული ლიცენზიით, მარტივია მის დასაკონფიგურირებლად და მუშაობს დაბალი GPU VRAM მოთხოვნებით.

AutoRound: Intel-ის ინოვაციური მეთოდი ხელოვნური ინტელექტის მოდელების ოპტიმიზაციისთვის
AutoRound, Intel-ის მიერ შემუშავებული პოსტ-საწვრთნელი კვანტიზაციის (PTQ) მეთოდი, მნიშვნელოვნად აუმჯობესებს ხელოვნური ინტელექტის მოდელების ეფექტურობას მინიმალური სიზუსტის დაკარგვით. ის იყენებს ხელმოწერილ გრადიენტულ დაშვებას წონის დამრგვალებისა და ამოჭრის დიაპაზონების ოპტიმიზაციისთვის, რაც უზრუნველყოფს ზუსტ დაბალბიტიან კვანტიზაციას (INT2-INT8) და აღწევს 2.1-ჯერ მეტ ფარდობით სიზუსტეს INT2-ზე პოპულარულ ბაზისებთან შედარებით. მეთოდი სწრაფია, მსუბუქი და თავსებადია მრავალ LLM/VLM არქიტექტურასთან, რაც მა
Hugging Face-ის ბიბლიოთეკა Decision Transformer-ს აერთიანებს: ახალი ეტაპი ღრმა გაძლიერებულ სწავლაში
Hugging Face-მა სიხარულით განაცხადა, რომ Decision Transformer, ოფლაინ გაძლიერებული სწავლის (Offline Reinforcement Learning) მეთოდი, ინტეგრირებულია მათ 🤗 ტრანსფორმერების ბიბლიოთეკაში და Hugging Face ჰაბში. ეს ნაბიჯი ღრმა გაძლიერებული სწავლის (Deep RL) სფეროში ხელმისაწვდომობის გაუმჯობესების გეგმის ნაწილია. სტატია განმარტავს RL-ის საფუძვლებს, განასხვავებს ონლაინ და ოფლაინ გაძლიერებულ სწავლებას და დეტალურად აღწერს Decision Transformer-ის მოდელს, რომელიც წარმოადგენს პარადიგმის ცვლილებას, რადგან ტრადი
Hugging Face-ი Decision Transformer-ს აინტეგრირებს: ახალი მიდგომა გაძლიერებით სწავლებაში
Hugging Face-მა Decision Transformer, ოფლაინ გაძლიერებითი სწავლის (Offline Reinforcement Learning) მეთოდი, თავის 🤗 transformers ბიბლიოთეკასა და Hugging Face Hub-ში ინტეგრირება მოახდინა. ეს ინტეგრაცია მნიშვნელოვან ნაბიჯს წარმოადგენს Deep Reinforcement Learning-ის (Deep RL) სფეროში ხელმისაწვდომობის გასაუმჯობესებლად. Decision Transformer წარმოადგენს პარადიგმის ცვლას, სადაც ტრადიციული RL მეთოდების ნაცვლად გამოიყენება მიმდევრობის მოდელირების ალგორითმი სასურველი შედეგის მისაღწევად მომავალი მოქმედებები
Unsloth: დააჩქარეთ LLM მოდელების დახვეწა Hugging Face-ის ეკოსისტემაში
Unsloth არის მსუბუქი ბიბლიოთეკა, რომელიც შექმნილია დიდი ენობრივი მოდელების (LLM) დახვეწის პროცესის დასაჩქარებლად. ის სრულად თავსებადია Hugging Face-ის ეკოსისტემასთან და აქტიურად ვითარდება Unsloth-ის გუნდისა და ღია წყაროს საზოგადოების მიერ. ბიბლიოთეკა მხარს უჭერს NVIDIA GPU-ებს, Llama-სა და Mistral-ის არქიტექტურებს, რაც უზრუნველყოფს მნიშვნელოვნად უფრო სწრაფ დახვეწას და მეხსიერების ნაკლებ გამოყენებას სტანდარტულ QLoRA-სთან შედარებით, სიზუსტის დაკარგვის გარეშე.