Würstchen: ინოვაციური დიფუზიური მოდელი რეკორდული კომპრესიით, რომელიც რევოლუციას ახდენს გამოსახულების გენერაციაში
Würstchen წარმოადგენს დიფუზიურ მოდელს, რომელიც გამოსახულების გენერაციას ახორციელებს უკიდურესად შეკუმშულ ლატენტურ სივრცეში, აღწევს რა 42x სივრცულ კომპრესიას – მიღწევა, რომელიც აქამდე შეუძლებლად ითვლებოდა. ეს საშუალებას აძლევს მას შექმნას მაღალი ხარისხის გამოსახულებები გაცილებით სწრაფად და ნაკლები რესურსებით, ვიდრე არსებული წამყვანი მოდელები, როგორიცაა Stable Diffusion XL, რაც მნიშვნელოვნად ამცირებს როგორც მოდელის ვარჯიშის, ისე ინფერენციის (შედეგების მიღების) ხარჯებს.

VAE დეკოდირების დელეგირება დისტანციურ ენდპოინტზე: მეხსიერების ეფექტურობა მაღალი რეზოლუციის სურათებისა და ვიდეოების სინთეზისთვის
მაღალი რეზოლუციის სურათებისა და ვიდეოების გენერირებისთვის, VAE დეკოდერები ხშირად დიდ მეხსიერებას მოიხმარენ, რაც ართულებს მათ გაშვებას სამომხმარებლო GPU-ებზე. არსებული გადაწყვეტილებები, როგორიცაა offloading ან tiling, იწვევს შეფერხებებს ან ხარისხის გაუარესებას. ამ პრობლემის გადასაჭრელად, Diffusers-მა შეიმუშავა ექსპერიმენტული ფუნქცია VAE დეკოდირების დისტანციურ ენდპოინტზე დელეგირებისთვის. ეს მიდგომა ზოგავს მეხსიერებას, აუმჯობესებს პარალელურ დამუშავებას, ღია კოდის პრინციპებზეა დაფუძნებული და Hugging
LLM-ების ეფექტური განლაგება: გამოთვლითი და მეხსიერების გამოწვევების გადაჭრა
დიდი ენობრივი მოდელები (LLM-ები) სწრაფად იკიდებენ ფეხს ცოდნაზე დაფუძნებულ ინდუსტრიებში, თუმცა მათი რეალურ სამყაროში განლაგება გამოწვევებითაა სავსე, განსაკუთრებით გამოთვლითი რესურსებისა და მეხსიერების კუთხით, ვრცელი შეტანის თანმიმდევრობებთან მუშაობისას. ეს პოსტი მიმოიხილავს ყველაზე ეფექტურ ტექნიკებს LLM-ების ოპტიმიზებული განლაგებისთვის, მათ შორის დაბალ სიზუსტეს (8-ბიტიანი და 4-ბიტიანი), Flash Attention-ს მეხსიერების ეფექტური გამოყენებისთვის და არქიტექტურულ ინოვაციებს, როგორიცაა Alibi, Rotary embe

Cohere For AI-მ Aya Vision წარადგინა: ახალი მულტილინგვური და მულტიმოდალური AI მოდელი
Cohere For AI-მ გამოუშვა Aya Vision, მულტილინგვური და მულტიმოდალური მოდელების უახლესი ოჯახი, რომელიც 23 ენაზე ენისა და ვიზუალური ინფორმაციის გაგებისთვის მძლავრი საფუძველია. ის ეფუძნება Aya Expanse-ის წარმატებას და აფართოებს მას მოწინავე ტექნიკების გამოყენებით. Aya Vision-ს შეუძლია შეასრულოს ისეთი ამოცანები, როგორიცაა გამოსახულების აღწერა, ვიზუალური შეკითხვებზე პასუხის გაცემა და ტექსტის გენერაცია. მოდელი მნიშვნელოვნად აღემატება თავისი ზომის ბევრ სხვა მოდელს და ხელმისაწვდომია ღია წონით კვლევისთვის
Hugging Face PRO მომხმარებლებისთვის ინფერენსის API ხელმისაწვდომი ხდება
Hugging Face-მა PRO მომხმარებლებისთვის ახალი ინფერენსის API გამოუშვა, რომელიც ექსკლუზიურ წვდომას აძლევს მათ კურირებულ, ულტრა-სწრაფ მოდელებზე, გაუმჯობესებული მოთხოვნათა ლიმიტებით. სიახლე ამარტივებს მოწინავე AI მოდელებთან ექსპერიმენტებს, პროტოტიპირებას და ინტეგრაციას დეველოპმენტის გარემოებებში, ინფრასტრუქტურის განლაგების საჭიროების გარეშე. სერვისი მოიცავს ტექსტის, კოდისა და გამოსახულების გენერაციის შესაძლებლობებს.
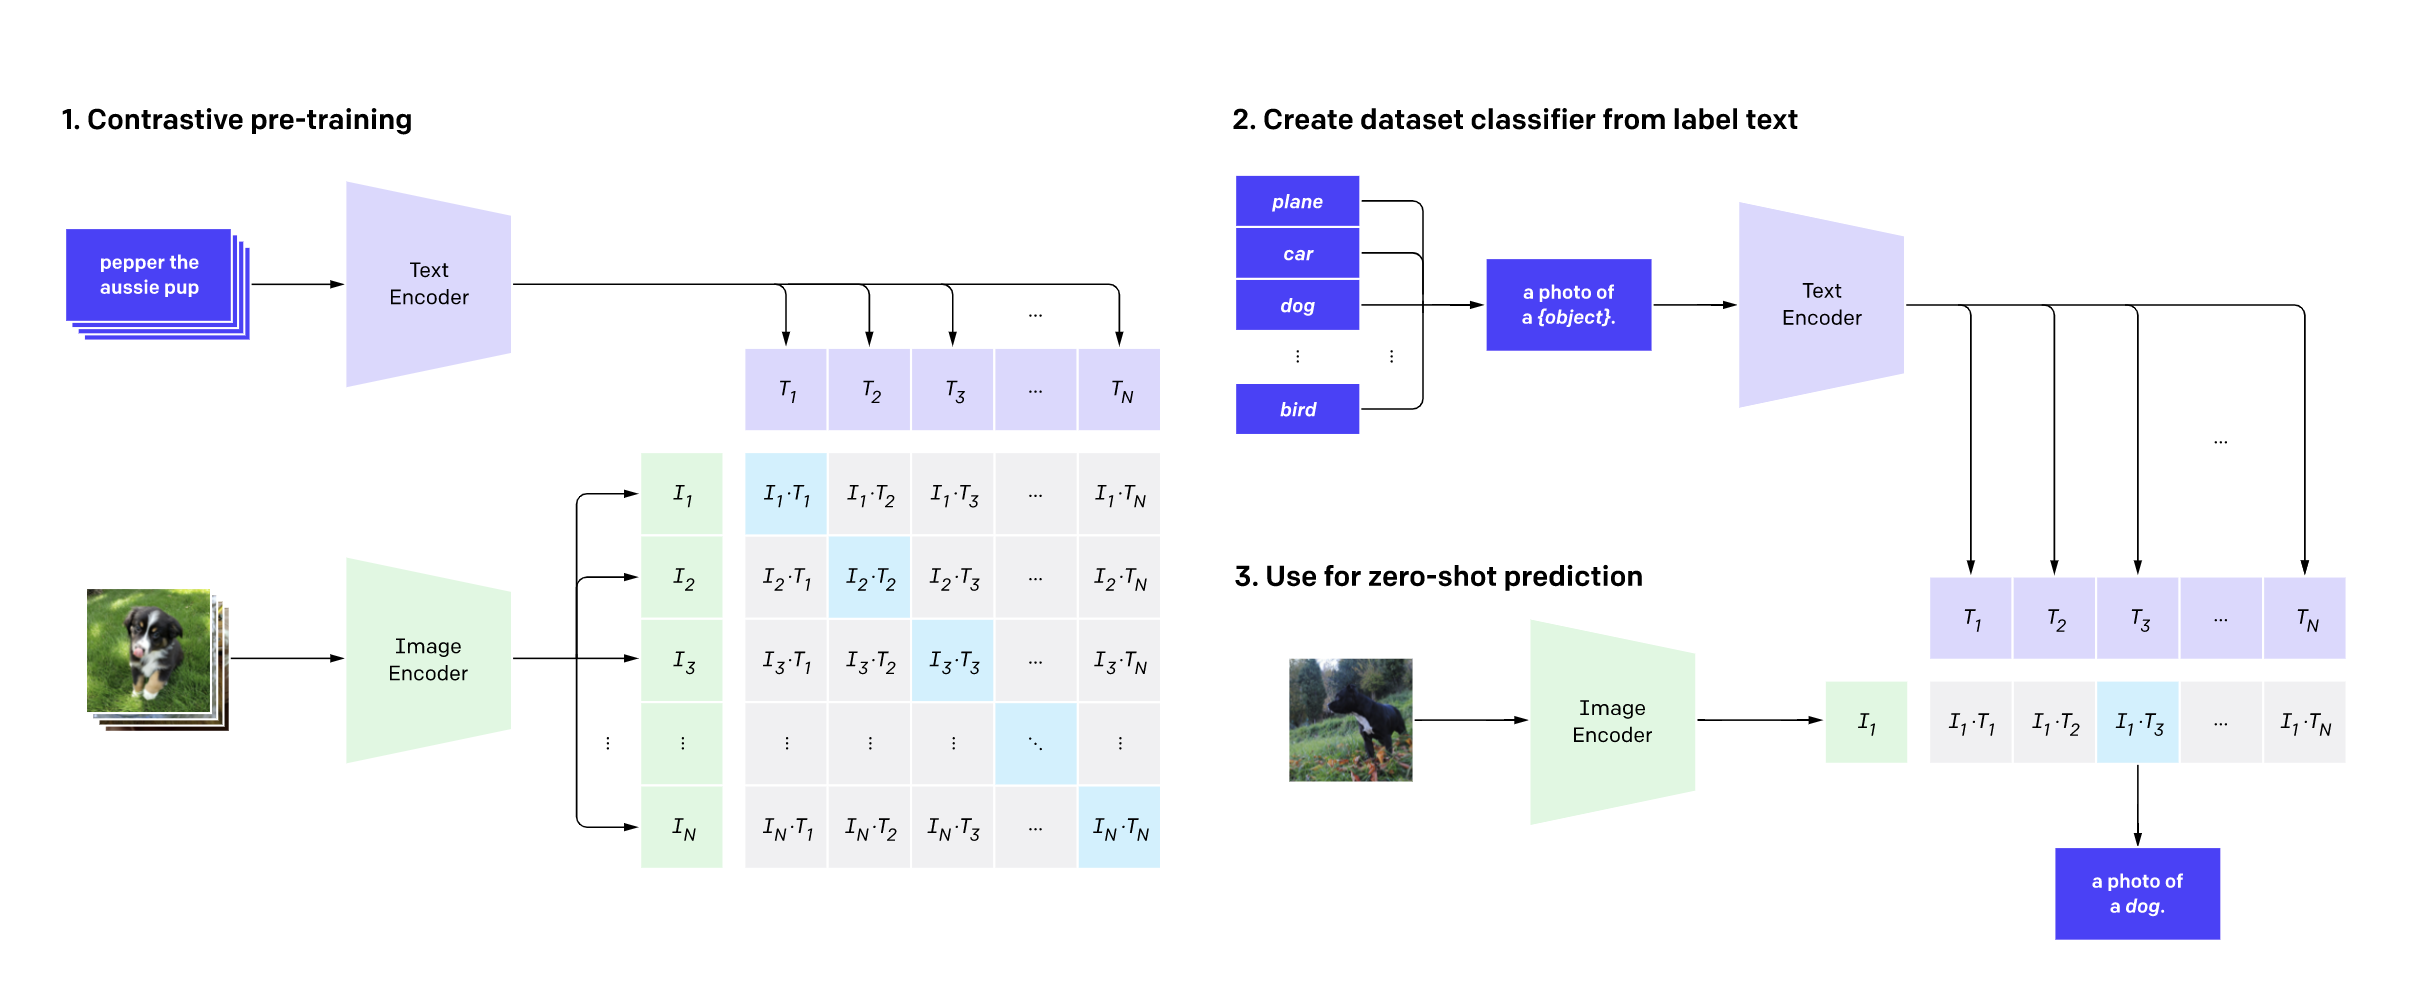
CLIP მოდელის დახვეწა სატელიტური გამოსახულებებისთვის: Hugging Face-ის საზოგადოებრივი კვირეულის პროექტი
მიმდინარე წლის ივლისში Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული, სადაც მონაწილეებმა გამოიყენეს Tensor Processing Units (TPU) Flax-ისა და JAX-ის საშუალებით, რათა გაეწვრთნათ Hugging Face ტრანსფორმერების მოდელები ბუნებრივი ენის დამუშავებისა და კომპიუტერული ხედვის სფეროებში. ჩვენმა გუნდმა OpenAI-ის CLIP ქსელი დახვეწა RSICD, UCM და სიდნეის მონაცემთა ნაკრებებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. პროექტის მიზანი იყო სატელიტური გამოსახულებების დიდი კოლექციების ტექსტური მ
გაძლიერებითი სწავლის (RL) გამოყენება დიფუზიური მოდელების გასაუმჯობესებლად: DDPO-ს როლი ხელოვნური ინტელექტის მიერ შექმნილი გამოსახულებების ადამიანურ პრეფერენციებთან შესაბამისობაში
სტატია განიხილავს, თუ როგორ ხდება დიფუზიური მოდელების (მაგ. DALL-E 2, Stable Diffusion) ოპტიმიზაცია გაძლიერებითი სწავლის (RL) გამოყენებით, რათა მათ მიერ გენერირებული გამოსახულებები უკეთესად შეესაბამებოდეს ადამიანის პრეფერენციებსა და ესთეტიკას. ის მიმოიხილავს "შესაბამისობის პრობლემას" ხელოვნურ ინტელექტში და წარმოაჩენს Denoising Diffusion Policy Optimization (DDPO) მეთოდს, როგორც ეფექტურ გადაწყვეტას. DDPO, რომელიც იყენებს პოლიტიკის გრადიენტულ მეთოდებს (PPO) და დენოიზინგის პროცესს მარკოვის გადაწყვე
ჩატის მოდელების ეფექტურობის გასაღები: ფორმატის მნიშვნელობა და Jinja შაბლონები
ეს სტატია განმარტავს, თუ რამდენად კრიტიკულია ჩატის ფორმატის შეხამება იმ ფორმატთან, რომელზეც ხელოვნური ინტელექტის მოდელები იყო გაწვრთნილი. არასწორი ფორმატის გამოყენება იწვევს მუშაობის სერიოზულ, ჩუმ გაუარესებას. Hugging Face-ის ტოკენიზატორების ახალი `chat_template` ატრიბუტი, რომელიც Jinja შაბლონებს იყენებს, მიზნად ისახავს ამ პრობლემის გადაჭრას საუბრების სწორად ფორმატირებით, რითაც უზრუნველყოფს მოდელის ოპტიმალურ მუშაობას და ხელს უშლის „განაწილების ცვლილებას“.
Wav2Vec2 და XLS-R: გარღვევა მეტყველების ავტომატური ამოცნობის ტექნოლოგიაში
2020 წელს გამოშვებული Wav2Vec2 მოდელიდან დაწყებული, Facebook AI-ის მრავალენოვანი XLSR ვერსიის გავლით, 2021 წლის ნოემბერში წარმოდგენილი XLS-R წარმოადგენს მნიშვნელოვან მიღწევას მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. XLS-R, რომელიც გაწვრთნილია 128 ენაზე ნახევარ მილიონ საათამდე აუდიო მონაცემზე, უზრუნველყოფს კონტექსტუალიზებულ მეტყველების წარმოდგენებს და აჩვენებს შთამბეჭდავ გაუმჯობესებას მეტყველების ამოცნობის, თარგმანისა და ენის იდენტიფიკაციის ამოცანებში. სტატია დეტალურად განმარტავს ამ მოდელე

ONNX Runtime Hugging Face-ის მოდელების მუშაობას აუმჯობესებს
ONNX Runtime არის კროს-პლატფორმული ინსტრუმენტი, რომელიც აჩქარებს მანქანური სწავლების მოდელებს, განსაკუთრებით ONNX-ის მხარდაჭერით. Hugging Face-ზე, ღია კოდის პლატფორმაზე, 130 000-ზე მეტი ასეთი მოდელია, მათ შორის დიდი ენობრივი (LLM) და ღრუბლოვანი მოდელები, რომლებსაც შეუძლიათ მნიშვნელოვნად გააუმჯობესონ მუშაობა ONNX Runtime-ის მეშვეობით. მაგალითად, whisper-tiny მოდელის დაჩქარება PyTorch-თან შედარებით 74.30%-მდე ეფექტურობას იძლევა. ONNX Runtime მჭიდროდ თანამშრომლობს Hugging Face-თან 90-ზე მეტი არქიტე
SDXL-ის ოპტიმიზაცია: როგორ დავაჩქაროთ ინფერენცია და შევამციროთ მეხსიერების მოხმარება
SDXL მოდელი, მიუხედავად მისი გაუმჯობესებული შესაძლებლობებისა, მნიშვნელოვნად დიდია, რაც დიდ მოთხოვნებს აყენებს GPU მეხსიერებასა და გამოთვლით დროს. ეს სტატია იკვლევს ოპტიმიზაციის ტექნიკებს, როგორიცაა დაბალი სიზუსტის (fp16) წონების გამოყენება, PyTorch 2.0-ის SDPA და torch.compile ფუნქციები, ასევე CPU-ზე გადმოტვირთვა, რათა გაიზარდოს ინფერენციის სიჩქარე და შემცირდეს მეხსიერების მოხმარება, რაც SDXL-ს უფრო პრაქტიკულს ხდის ფართო სპექტრის მომხმარებლებისთვის.
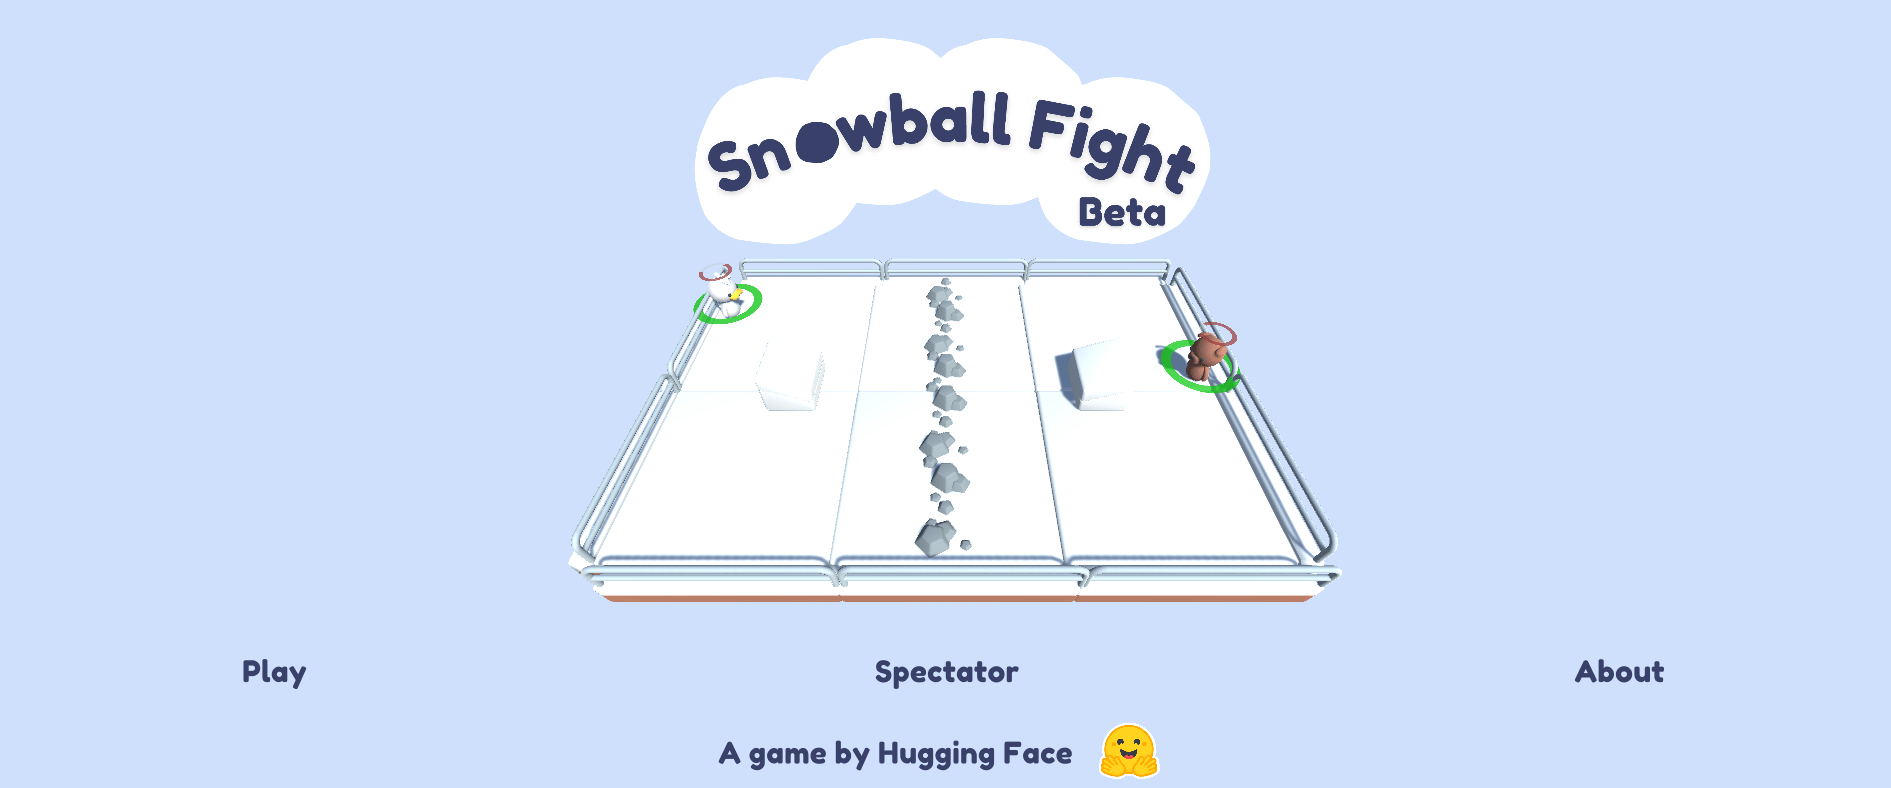
Hugging Face-ი აფართოებს Deep Reinforcement Learning-ის ეკოსისტემას Unity ML-Agents-ით: ახალი თამაში და საზოგადოება
Hugging Face-ი, Unity ML-Agents-ის გამოყენებით, ღრმა გაძლიერებითი სწავლების მკვლევრებისა და ენთუზიასტებისთვის ეკოსისტემას აფართოებს. ამ ინიციატივის ფარგლებში წარმოდგენილია თამაში „Snowball Fight“ და ახალი Discord სერვერი საზოგადოების ჩართულობისთვის.
OpenAI-ის RLHF შედეგების რეპროდუცირება: ტექნიკური დეტალების სიღრმისეული ანალიზი
მოცემული ნაშრომი მიზნად ისახავს OpenAI-ის (OAI) სტილისტური ამოცანების (როგორიცაა სენტიმენტი და აღწერილობითობა) RLHF (Reinforcement Learning from Human Feedback) შედეგების რეპროდუცირებას. ჩვენი კოდების ბაზა OAI-ის კოდების ბაზის თითქმის იდენტურ სწავლის მრუდებს აჩვენებს. სტატია დეტალურად განიხილავს იმპლემენტაციის ტექნიკურ ნიუანსებს, მათ შორის, როგორ გენერირდება ჯილდოები/მნიშვნელობები და პასუხები, შევსების (padding) მექანიზმებს, ლოგიტების გამოთვლას და პასუხების გენერაციის დროს შერჩევის პროცესს. ასევ

Reranker მოდელების მორგება: ძალა, რომელიც აჭარბებს დიდ მოდელებს
Reranker მოდელების მორგება (finetuning) გადამწყვეტია მათი პოტენციალის მაქსიმალურად გამოსაყენებლად. ეს პროცესი მოიცავს მონაცემთა ბაზებს, დანაკარგის ფუნქციებს, ტრენინგის არგუმენტებსა და შემფასებლებს. სტატია ხაზს უსვამს, რომ დომენზე სპეციალურად მორგებულ პატარა reranker მოდელსაც კი შეუძლია მნიშვნელოვნად აჯობოს ბევრად უფრო დიდ, ზოგადი დანიშნულების მოდელებს. embedding მოდელებისგან განსხვავებით, reranker მოდელები (ჯვარედინი ენკოდერები) ტექსტების წყვილებს ერთად ამუშავებენ, რაც მათ შესაბამისობის შეფასები
კოდის გენერაციის მოდელის წვრთნის დეტალები: Python-ის მაგალითზე
სტატია დეტალურად აღწერს პითონის კოდის გენერაციის მოდელის შექმნისა და წვრთნის კომპლექსურ პროცესს. ის მოიცავს მონაცემთა მოპოვებას GitHub-იდან, 180 GB-იანი მონაცემთა ნაკრების გაწმენდას დუბლიკატებისაგან Codex-ის ევრისტიკის გამოყენებით (რაც 50 GB-იან გაწმენდილ ნაკრებს იძლევა). შემდეგ აღწერილია სპეციალიზებული ტოკენაიზერის წვრთნა, GPT-2 Large-ზე დაფუძნებული მოდელის ინიციალიზაცია სპეციალური კორექტირებით, და ეფექტიანი სავარჯიშო ციკლის დაყენება 🤗 Accelerate ბიბლიოთეკის გამოყენებით განაწილებული (multi-GPU)

Embedding მოდელების ოპტიმალური განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და ხარჯთეფექტურობა
ამ სტატიაში განხილულია, თუ როგორ განვათავსოთ ღია კოდის Embedding მოდელები Hugging Face Inference Endpoints-ზე Text Embedding Inference (TEI) გადაწყვეტის გამოყენებით. ხაზგასმულია Embedding მოდელების უპირატესობა დიდი ენობრივი მოდელების (LLM-ების) მიმართ ზომისა და ინფერენსის სიჩქარის კუთხით. სტატია დეტალურად აღწერს Inference Endpoints-ის მახასიათებლებს, როგორიცაა ავტომატური მასშტაბირება და ნულამდე მასშტაბირება, და წარმოადგენს TEI-ს, როგორც მაღალი წარმადობისა და ხარჯთეფექტურობის გარანტს. ნაჩვენებია,
ღია კოდის ემბედინგის მოდელების განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და დაბალი ხარჯები
Hugging Face Inference Endpoints-ზე ღია კოდის ემბედინგის მოდელების განთავსების შესახებ სტატია აღწერს, თუ როგორ უზრუნველყოფს Text Embedding Inference (TEI) ამ მოდელების სწრაფ და ხარჯთეფექტურ გამოყენებას. ემბედინგის მოდელები, LLM-ებთან შედარებით, მცირე ზომისაა და სწრაფ ინფერენსს გვთავაზობს, რაც გადამწყვეტია ოპტიმალური მომხმარებლის გამოცდილებისა და ხარჯების შესამცირებლად. TEI-ის საშუალებით შესაძლებელია 450+ მოთხოვნა/წამში წარმადობის მიღწევა და 64-ჯერ უფრო დაბალი ხარჯები, ვიდრე OpenAI Embeddings-ის
Perceiver: ტრანსფორმერის არქიტექტურის შეზღუდვების დაძლევა ხელოვნურ ინტელექტში
ეს სტატია განიხილავს Transformer-ის მოდელის რევოლუციურ ზეგავლენას ხელოვნური ინტელექტის (AI) სფეროზე, თუმცა ხაზს უსვამს მის მნიშვნელოვან შეზღუდვას: თვითყურადღების მექანიზმის გამო, ის ცუდად მასშტაბირდება მაღალი განზომილების მონაცემებთან. სტატია წარმოგიდგენთ Perceiver-ის არქიტექტურას, როგორც ამ პრობლემის გადაჭრის საშუალებას. Perceiver იყენებს ლატენტურ ცვლადებსა და ჯვარედინ ყურადღებას, რაც უზრუნველყოფს ხაზოვან დამოკიდებულებას შეყვანის ზომაზე და საშუალებას აძლევს მას ეფექტურად იმუშაოს მრავალფეროვან მ
Renumics Spotlight: ინტერაქტიული ვიზუალიზაცია და მონაცემთა ინსპექცია Hugging Face-ის მონაცემთა ნაკრებებისთვის
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს Hugging Face-ის მონაცემთა ნაკრებებში კრიტიკული კლასტერების იდენტიფიცირებისთვის. ის იყენებს მოდელის შედეგებს (პროგნოზები, ემბედინგები) მონაცემთა სეგმენტებისა და მოდელის შეცდომების ღრმა გაგებისთვის, რაც აადვილებს მონაცემთა ინსპექციას და ხდის მას მასშტაბირებადს. ხელსაწყო პირდაპირ ინტეგრირდება `datasets` ბიბლიოთეკასთან და მხარს უჭერს სხვადასხვა ტიპის მონაცემებსა და ML ამოცანებს, მათ შორის NLP, აუდიო და კომპიუტერული ხედვა.
Renumics Spotlight: გაამარტივეთ მონაცემთა ინსპექტირება Hugging Face ეკოსისტემაში
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს, რომლებიც ეხმარება მომხმარებლებს კრიტიკული კლასტერების იდენტიფიცირებაში Hugging Face მონაცემთა ნაკრებებში. ინსტრუმენტი უპრობლემოდ ინტეგრირდება Hugging Face-ის ეკოსისტემასთან, საშუალებას გაძლევთ გამოიყენოთ მოდელის შედეგები, როგორიცაა პროგნოზები და ემბედინგები, რათა ღრმად შეისწავლოთ მონაცემთა სეგმენტები და მოდელის ხარვეზები. Spotlight მნიშვნელოვნად ზრდის მონაცემთა ინსპექტირების მასშტაბურობას, ამარტივებს სამუშაო პროცესებს და ამცირებს დროის ხარ

LLM ინფერენციის სამართლიანი დაგეგმვა: გამოწვევები და გადაწყვეტები
სტატია მიმოიხილავს LLM ინფერენციის ძრავებში (მაგ. vLLM, HuggingFace TGI) სამართლიანი დაგეგმვის გამოწვევებს, სადაც GPU-ზე ჯგუფური დამუშავება ეფექტურია, თუმცა ერთი მომხმარებელი ხშირად მონოპოლიზებს ბექენდის რიგს. TNG-ის მიერ შემოთავაზებული გადაწყვეტა მოიცავს ცალკე API სერვერს ("LLM-სერვერს"), რომელიც მართავს მოთხოვნებს ინფერენციის ძრავამდე. ეს სერვერი იყენებს თითოეული მომხმარებლისთვის ცალკეულ რიგებს და "მრგვალი მაგიდის" (round-robin) პრინციპით დაგეგმვას სამართლიანობისთვის. ის ასევე ითვალისწინებს მო
GPT-J-ის ეფექტური დეპლოირება Amazon SageMaker-ისა და Hugging Face-ის გამოყენებით
სტატია განიხილავს EleutherAI-ის GPT-J მოდელის წარმოებაში ინტეგრაციის გამოწვევებს, განსაკუთრებით მეხსიერების მოხმარებისა და ჩატვირთვის ხანგრძლივი დროის თვალსაზრისით. ის წარმოადგენს გადაწყვეტას Amazon SageMaker-ისა და Hugging Face Inference Toolkit-ის გამოყენებით, PyTorch-ის მოდელების შენახვის ოპტიმიზებული მეთოდის მეშვეობით, რაც მნიშვნელოვნად ამცირებს ჩატვირთვის დროს (1 წუთი და 23 წამიდან 7.7 წამამდე) და GPT-J-ს საწარმოო სცენარებისთვის თავსებადს ხდის.
NLP მოდელების შედარებითი ანალიზი: RoBERTa, Mistral-7b და Llama-2-7b LoRA-ს გამოყენებით კატასტროფის ტვიტების კლასიფიკაციისთვის
ბუნებრივი ენის დამუშავების (NLP) სწრაფად განვითარებად სამყაროში, ენობრივი მოდელების შედარება გადამწყვეტია მათი ოპტიმალური გამოყენებისთვის კონკრეტულ ამოცანებში. ეს პოსტი ეძღვნება სამი მოდელის – RoBERTa, Mistral-7b და Llama-2-7b – შედარებას კატასტროფების შესახებ ტვიტების კლასიფიკაციის პრობლემაში. კვლევაში გამოყენებულია PEFT (Parameter-Efficient Fine-Tuning) ტექნიკის LoRA (Low-Rank Adaptation) მეთოდი, რომელიც მნიშვნელოვნად ამცირებს პარამეტრების რაოდენობას მოდელის წვრილად მორგებისას. განხილულია თითო
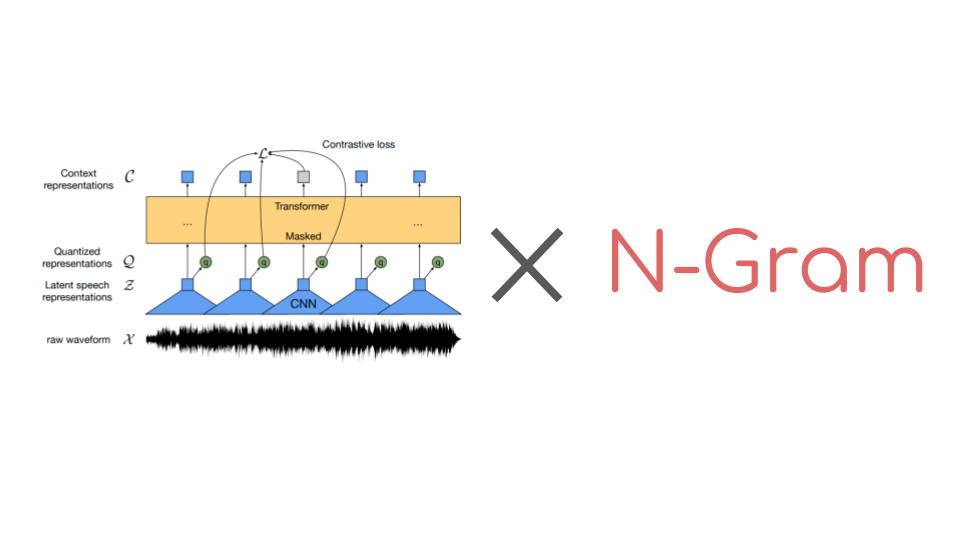
Wav2Vec2: ენობრივი მოდელების ინტეგრაცია ზუსტი მეტყველების ამოცნობისთვის
ეს სტატია განმარტავს, თუ როგორ უნდა დავაზუსტოთ Wav2Vec2 მოდელები მეტყველების ამოცნობისთვის და მნიშვნელოვნად გავაუმჯობესოთ ტრანსკრიფციის სიზუსტე ენობრივი მოდელის (LM) ინტეგრაციით. აღწერილია Connectionist Temporal Classification (CTC) ალგორითმის გამოყენება და დეტალურადაა განხილული pyctcdecode ბიბლიოთეკისა და 🤗 Transformers-ის საშუალებით n-გრამული ენობრივი მოდელის შექმნისა და Wav2Vec2 ჩეკპოინტთან შერწყმის ნაბიჯ-ნაბიჯ პროცესი, განსაკუთრებით ხაზგასმულია გაუმჯობესება მოკლე სასწავლო მონაცემთა ნაკრებებზ