
NVIDIA Cosmos Reasoning 2B მოდელის განთავსება Jetson მოწყობილობებზე vLLM-ის გამოყენებით
ხელოვნური ინტელექტის მოდელების სწრაფმა ევოლუციამ, რაც ზრდის მათ სიზუსტესა და ეფექტურობას, ისინი იდეალურს ხდის პერიფერიული მოწყობილობებისთვის. NVIDIA Jetson-ის ოჯახი, მაღალპროდუქტიული AGX Thor-დან და AGX Orin-დან დაწყებული კომპაქტური Orin Nano Super-ით დამთავრებული, შექმნილია ფიზიკური ხელოვნური ინტელექტისა და რობოტიკისთვის განკუთვნილი აპლიკაციების დასაჩქარებლად, რაც უზრუნველყოფს ოპტიმიზებულ შესრულებას ღია კოდის წამყვანი მოდელებისთვის. ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ უნდა განათავსოთ N

როგორ შეინახოთ თქვენი მონაცემები Linux-ის დისტრიბუციების შეცვლისას
ეს სტატია განიხილავს Linux-ის სხვა დისტრიბუციაზე გადასვლის პროცესს ისე, რომ მომხმარებლის პირადი მონაცემები (სახლის დირექტორია) არ დაიკარგოს. მოცემულია სამი ძირითადი მეთოდი: /home დირექტორიის ცალკეულ დანაყოფზე განთავსება ინსტალაციის დროს, სარეზერვო ასლების შექმნა და სიმბოლური ბმულების გამოყენება მონაცემების შესანარჩუნებლად. სახელმძღვანელო დეტალურად აღწერს თითოეულ მიდგომას, მაგალითად Ubuntu-ს გამოყენებით.
Hugging Face-ის ღია მოდელები ახლა უკვე ხელმისაწვდომია Amazon Bedrock Marketplace-ზე
Hugging Face-ის პოპულარული ღია მოდელები ახლა უკვე ხელმისაწვდომია Amazon Bedrock-ზე, ახალი Bedrock Marketplace-ის ფარგლებში. AWS-ის მომხმარებლებს შეუძლიათ 83 ღია მოდელის განთავსება გენერაციული ხელოვნური ინტელექტის (Generative AI) აპლიკაციების შესაქმნელად. ეს ინტეგრაცია აერთიანებს SageMaker Jumpstart-ის გამოყენების სიმარტივეს Amazon Bedrock-ის სრულად მართულ ინფრასტრუქტურასთან, რაც უზრუნველყოფს მაღალი დონის API-ებთან თავსებადობას.
LLM-ების განთავსება Hugging Face Inference Endpoints-ზე: სრული გზამკვლევი
ამ ბლოგპოსტში განხილულია, თუ როგორ უნდა განათავსოთ ღია კოდის დიდი ენობრივი მოდელები (LLM) Hugging Face Inference Endpoints-ის გამოყენებით, მართული SaaS გადაწყვეტის, რომელიც ამარტივებს მოდელების განთავსებას. სტატია მოიცავს პასუხების სტრიმინგის მეთოდებსა და ენდპოინტების წარმადობის ტესტირებას. Hugging Face Inference Endpoints უზრუნველყოფს AI აპლიკაციების სწრაფ და უსაფრთხო შექმნას ინფრასტრუქტურის მართვის გარეშე, ავტომატური მასშტაბირების, ნულამდე შემცირებისა და გაუმჯობესებული უსაფრთხოების ფუნქციებით.
Hugging Face-ის TGI წარმოგიდგენთ ახალ Backends არქიტექტურას: გამარტივებული LLM-ების განთავსება და გაუმჯობესებული წარმადობა
Hugging Face-მა წარმოადგინა TGI Backends, ახალი არქიტექტურა Text-Generation-Inference (TGI)-ისთვის, რომელიც მიზნად ისახავს LLM-ების განთავსების პროცესის გამარტივებას და ოპტიმალური წარმადობის უზრუნველყოფას. ეს სიახლე აერთიანებს სხვადასხვა ინფერენსინგის გადაწყვეტებს ერთიან ფრონტენდ ფენაში, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შეცვალონ ბეკენდები მათი მოდელირების, აპარატურის და წარმადობის მოთხოვნების შესაბამისად.
100-ჯერ გაზრდილი წარმადობა: დიდი AI მოდელების ოპტიმიზაცია Hugging Face-ის ინფრასტრუქტურაზე
მიუხედავად იმისა, რომ დიდი ენობრივი მოდელების ექსპერიმენტირება მარტივია, მათი მაქსიმალური წარმადობით პროდუქციაში განთავსება რთული საინჟინრო გამოწვევაა. Hugging Face გთავაზობთ გადაწყვეტას თავისი Accelerated Inference API-ის მეშვეობით, რომელიც უზრუნველყოფს 100-ჯერ გაზრდილ სიჩქარეს და მასშტაბირებადობას. სტატია დეტალურად აღწერს ოპტიმიზაციის სხვადასხვა დონეს – ბიბლიოთეკების გამოყენებიდან აპარატურის სპეციფიკურ მოდიფიკაციამდე – და ხაზს უსვამს Hugging Face-ის ექსპერტიზასა და პარტნიორობებს ტექნიკის წამყვ
მოდელების განთავსება ინფერენსის ენდპოინტებზე ქასთომ ჰენდლერების გამოყენებით: MusicGen-ის მაგალითი
ეს სტატია განმარტავს, თუ როგორ ხდება მოდელების, მათ შორის `transformers`-ის კონვეიერით პირდაპირ არმხარდაჭერილი ან არატრანსფორმერული მოდელების განთავსება Inference Endpoints-ის გამოყენებით. პროცესი მოიცავს მორგებული დასკვნის ფუნქციების, იგივე ქასთომ ჰენდლერების შექმნას, რათა შესაძლებელი გახდეს მოქნილი განთავსება. MusicGen-ის მაგალითზე დეტალურად არის აღწერილი `handler.py` და `requirements.txt` ფაილების შექმნა და ენდპოინტის კონფიგურაცია.

DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ
BERT-ის ახალი სიჩქარე: ხელოვნური ინტელექტის მოდელების განთავსება TensorFlow Serving-ით
ტრანსფორმერების v4.2.0 ვერსიაში BERT-ის მოდელის გამოთვლითი წარმადობა მნიშვნელოვნად გაუმჯობესდა, რაც 10%-ით უფრო სწრაფია Google-ის ოფიციალურ იმპლემენტაციაზე და ორჯერ აღემატება v4.1.1-ის ვერსიას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ამ გაუმჯობესებული წარმადობის გამოყენება საწარმოო გარემოში TensorFlow Serving-ის მეშვეობით BERT მოდელების განთავსებით. ის მოიცავს ნაბიჯ-ნაბიჯ ინსტრუქციებს SavedModel-ის შექმნის, Docker-ის გამოყენებით კონტეინერების გაშვების და REST/gRPC API-ების მეშვეობით მოდელთან
მარტივად შექმენით ინტერაქტიული ML დემოები Gradio-თი Hugging Face Spaces-ზე
ეს სტატია განმარტავს, თუ როგორ უნდა შექმნათ და უმასპინძლოთ ინტერაქტიულ მანქანური სწავლების მოდელების დემოებს Hugging Face Spaces-ზე Gradio-ს გამოყენებით. ის დეტალურად აღწერს პროცესს ინტერფეისების განსაზღვრიდან რთული მოდელების პაიპლაინების განთავსებამდე, ხაზს უსვამს Hugging Face-ის Inference API-სთან ინტეგრაციასა და Gradio Series-ის მოქნილობას.

Embedding მოდელების ოპტიმალური განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და ხარჯთეფექტურობა
ამ სტატიაში განხილულია, თუ როგორ განვათავსოთ ღია კოდის Embedding მოდელები Hugging Face Inference Endpoints-ზე Text Embedding Inference (TEI) გადაწყვეტის გამოყენებით. ხაზგასმულია Embedding მოდელების უპირატესობა დიდი ენობრივი მოდელების (LLM-ების) მიმართ ზომისა და ინფერენსის სიჩქარის კუთხით. სტატია დეტალურად აღწერს Inference Endpoints-ის მახასიათებლებს, როგორიცაა ავტომატური მასშტაბირება და ნულამდე მასშტაბირება, და წარმოადგენს TEI-ს, როგორც მაღალი წარმადობისა და ხარჯთეფექტურობის გარანტს. ნაჩვენებია,
ღია კოდის ემბედინგის მოდელების განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და დაბალი ხარჯები
Hugging Face Inference Endpoints-ზე ღია კოდის ემბედინგის მოდელების განთავსების შესახებ სტატია აღწერს, თუ როგორ უზრუნველყოფს Text Embedding Inference (TEI) ამ მოდელების სწრაფ და ხარჯთეფექტურ გამოყენებას. ემბედინგის მოდელები, LLM-ებთან შედარებით, მცირე ზომისაა და სწრაფ ინფერენსს გვთავაზობს, რაც გადამწყვეტია ოპტიმალური მომხმარებლის გამოცდილებისა და ხარჯების შესამცირებლად. TEI-ის საშუალებით შესაძლებელია 450+ მოთხოვნა/წამში წარმადობის მიღწევა და 64-ჯერ უფრო დაბალი ხარჯები, ვიდრე OpenAI Embeddings-ის
Hugging Face Infinity: ტრანსფორმერული მოდელების ოპტიმალური განთავსება Intel Xeon CPU-ებზე
Hugging Face Infinity არის კონტეინერიზებული გადაწყვეტა, რომელიც საშუალებას აძლევს კომპანიებს ეფექტურად განათავსონ ტრანსფორმერული მოდელები წარმოებაში დაბალი ლატენტურობითა და მაღალი გამტარუნარიანობით. ეს ბლოგ პოსტი წარმოადგენს დეტალურ წარმადობის შედეგებს Infinity-ის უახლესი თაობის Intel Xeon CPU-ებზე გაშვებისას (კერძოდ, Ice Lake-ზე დაფუძნებული EC2 C6i ინსტანსებზე), რაც უზრუნველყოფს ოპტიმალურ ღირებულებას, ეფექტურობასა და ლატენტურობას თქვენი Transformer-ის განთავსებისთვის.
Llama 2-ის ეფექტური განთავსება AWS Inferentia2-ზე Hugging Face Optimum Neuron-ის მეშვეობით
Hugging Face-ის ბლოგზე ადრე წარდგენილი AWS Inferentia2-ის გაფართოების შედეგად, ახლა შესაძლებელია დიდი ენობრივი მოდელების (LLM) განთავსება ტექსტის გენერაციისთვის AWS Inferentia2 ინსტანციებზე Optimum Neuron-ის გამოყენებით. სტატია დეტალურად აღწერს Llama 2-ის განთავსების პროცესს, გთავაზობთ რეკომენდაციებს Hugging Face Neuron Deep Learning AMI-ზე ან Amazon SageMaker-ზე განთავსების შესახებ და განმარტავს მოდელების კომპილაციასა და ექსპორტს. ასევე, მოცემულია Inferentia2-ზე ტექსტის გენერაციის ეფექტურობის ა
Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაცია: მოდელების განთავსება, ჩატვირთვა და გაზიარება
ეს სტატია წარმოგიდგენთ Stable-Baselines3-ისა და Hugging Face Hub-ის ინტეგრაციას, რაც მომხმარებლებს საშუალებას აძლევს მარტივად განათავსონ, ჩატვირთონ და გააზიარონ ღრმა განმტკიცებითი სწავლის მოდელები. მოცემულია სახელმძღვანელო, თუ როგორ გამოიყენოთ ეს ახალი ფუნქციონალი, მათ შორის საჭირო ბიბლიოთეკების ინსტალაცია, საზოგადოების მოდელების პოვნა, გაწვრთნილი აგენტების ატვირთვა და საზოგადოებასთან ურთიერთობა ეკოსისტემის სამომავლო გაფართოებისთვის.
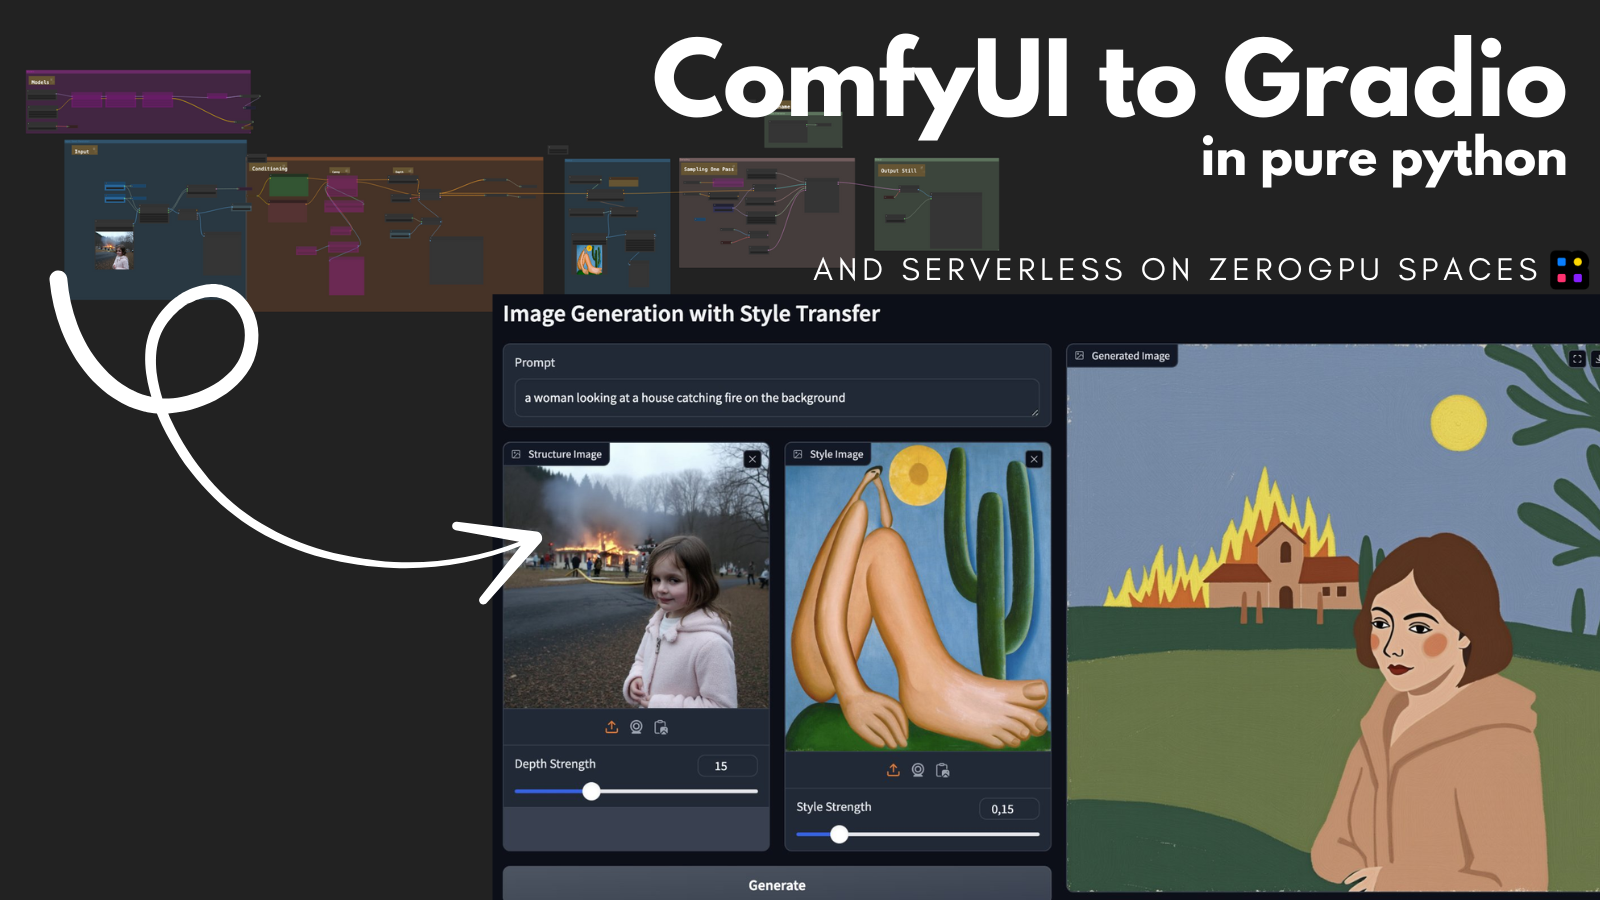
ComfyUI-ის სამუშაო პროცესის Gradio აპლიკაციად გარდაქმნა და Hugging Face Spaces-ზე უფასო განთავსება: სრული გზამკვლევი
ეს გაკვეთილი დეტალურად აღწერს, თუ როგორ უნდა გარდაქმნათ რთული ComfyUI სამუშაო პროცესი მარტივ Gradio აპლიკაციად და განათავსოთ იგი Hugging Face Spaces ZeroGPU სერვერულ სტრუქტურაზე უფასოდ. პროცესი მოიცავს ComfyUI-to-Python-Extension-ის გამოყენებით სამუშაო პროცესის Python სკრიპტად ექსპორტს, Gradio ინტერფეისის შექმნას ექსპორტირებული სკრიპტისთვის და მოდელების Hugging Face-ის ვერსიებთან დაკავშირებას ეფექტური განთავსებისთვის. გაკვეთილი ეფუძნება Nathan Shipley-ის Flux[dev] Redux + Flux[dev] Depth ComfyUI

Hugging Face-ის ინფერენსის საბოლოო წერტილები: Whisper მოდელების საოცარი ოპტიმიზაცია საზოგადოებისთვის
Hugging Face ხსნის თავის ინფერენსის საბოლოო წერტილებს (Inference Endpoints) საზოგადოებისთვის, რაც ხელს უწყობს ღია კოდის წვლილს და AI მოდელების ოპტიმიზებულ განთავსებას. ახალი Whisper-ის საბოლოო წერტილი, vLLM პროექტის გამოყენებით, აჩვენებს თითქმის 8-ჯერ გაუმჯობესებას RTFx-ში, ტრანსკრიფციის ხარისხის დაკარგვის გარეშე. პლატფორმა ასევე გთავაზობთ მოწინავე ოპტიმიზაციებს NVIDIA GPU-ებზე და საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ საკუთარი ASR კონვეიერები.
დიდი ენობრივი მოდელების (LLMs) მაღალეფექტური განთავსება: TGI და AWS Inferentia2 Amazon SageMaker-ში
ტექსტის გენერირების ინფერენცია (TGI) წარმოადგენს სპეციალურად შექმნილ გადაწყვეტას დიდი ენობრივი მოდელების (LLMs) მასშტაბური განთავსებისა და სერვისისთვის. TGI უზრუნველყოფს მაღალეფექტურ ტექსტის გენერაციას Tensor Parallelism-ისა და უწყვეტი დაჯგუფების გამოყენებით Llama-ს, Mistral-ის და სხვა პოპულარული ღია LLM-ებისთვის. AWS Inferentia2-თან ინტეგრაცია Amazon SageMaker-ში TGI-ს აქცევს მძლავრ ალტერნატივად GPU-ებისთვის LLM აპლიკაციების შესაქმნელად. ეს ინტეგრაცია ამარტივებს მოდელების განთავსებას და შენარჩუ

Dell Enterprise Hub: ხელოვნური ინტელექტის გადაწყვეტილებების სრული ეკოსისტემა საწარმოებისთვის
Dell Enterprise Hub აფართოებს ხელოვნური ინტელექტის გადაწყვეტილებების სპექტრს, სთავაზობს ოპტიმიზებულ მოდელებს (Meta Llama 4, Google Gemma 3) და მზა აპლიკაციებს Dell-ის AI სერვერებისა და AI კომპიუტერებისთვის. პლატფორმა უზრუნველყოფს სწრაფ, ადგილობრივ განთავსებას Docker-ის, Kubernetes-ის და ახალი Dell Pro AI Studio-ს მეშვეობით, ასევე წარმოგიდგენთ `dell-ai` ღია კოდის ბიბლიოთეკას, რაც საწარმოებს საშუალებას აძლევს, ეფექტურად ინტეგრირდნენ გენერაციულ ხელოვნურ ინტელექტთან.
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.
Cloudflare Workers AI და Hugging Face-ის ინტეგრაცია: ხელმისაწვდომი გენერაციული AI დეველოპერებისთვის
Cloudflare Workers AI-ზე განთავსება დეველოპერებს საშუალებას აძლევს შექმნან მძლავრი გენერაციული AI აპლიკაციები GPU ინფრასტრუქტურისა და სერვერების მართვის გარეშე, ძალიან დაბალი საოპერაციო ხარჯებით. ეს ინტეგრაცია, რომელიც აფართოებს Cloudflare-ისა და Hugging Face-ის სტრატეგიულ პარტნიორობას, გვთავაზობს სერვერების გარეშე (serverless) წვდომას პოპულარულ Hugging Face მოდელებზე, მოთხოვნის მიხედვით გადახდის (pay-per-request) მოდელით, რითაც წყდება GPU-ს სიმცირისა და ფიქსირებული ხარჯების პრობლემა.
Google Cloud-ი და Hugging Face-ი გენერაციული AI მოდელების განთავსებას ამარტივებენ
Google Cloud-მა და Hugging Face-მა გამოუშვეს ახალი ფუნქცია „Deploy on Google Cloud“, რომელიც დეველოპერებს საშუალებას აძლევს, შექმნან საწარმოო მზადყოფნის გენერაციული ხელოვნური ინტელექტის (AI) აპლიკაციები ინფრასტრუქტურის მართვის გარეშე, პირდაპირ მათ უსაფრთხო Google Cloud გარემოში. ეს გაფართოება Google-ის მომხმარებლებისთვის ღია გენერაციული AI მოდელებზე წვდომასა და მათ განთავსებას ამარტივებს, Vertex AI-სა და GKE-ზე 1-კლიკით განთავსების გამოცდილებას სთავაზობს.
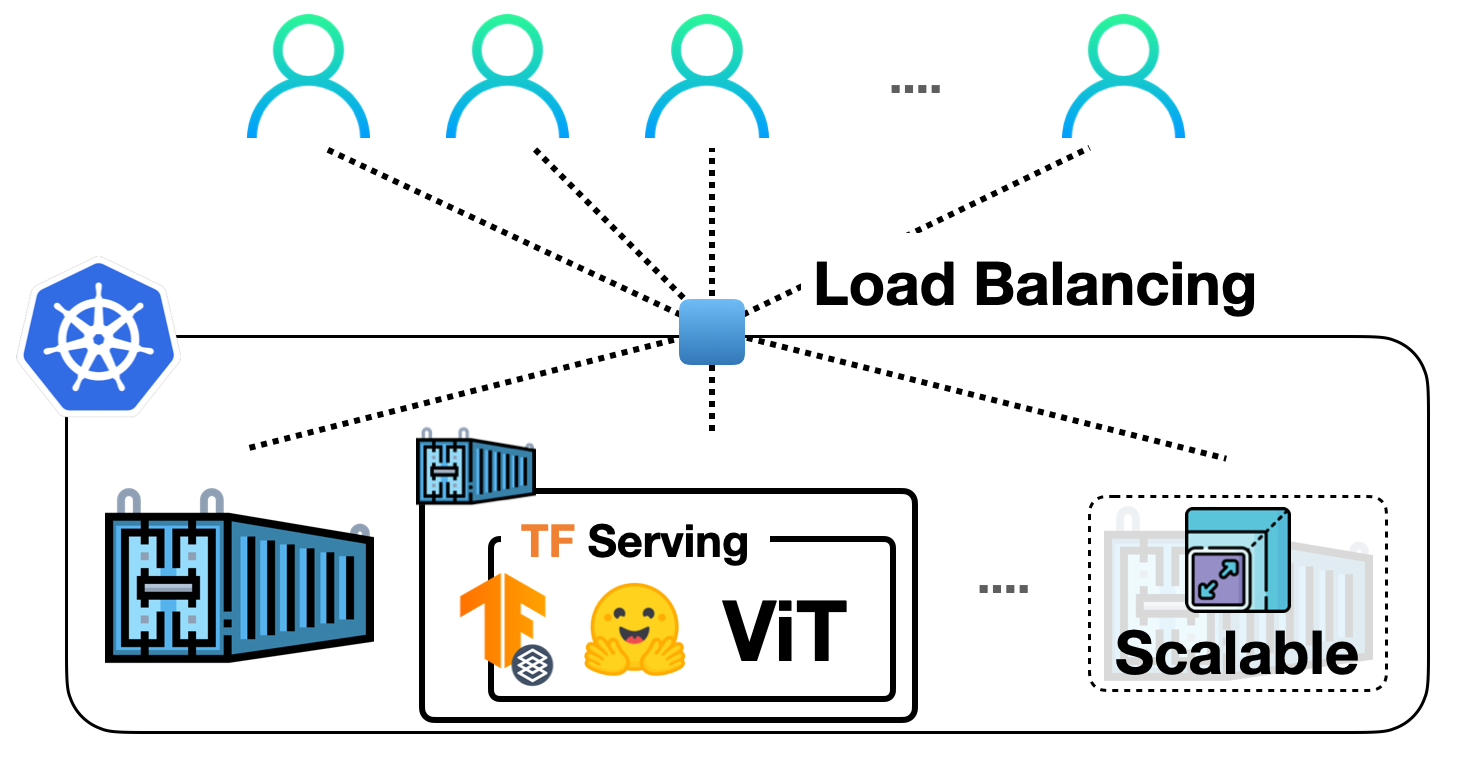
ML მოდელების მასშტაბირება Docker-ით და Kubernetes-ით: ლოკალურიდან სრულმასშტაბიან დეპლოიმენტამდე
ეს პოსტი გაწვდით დეტალურ სახელმძღვანელოს, თუ როგორ გადახვიდეთ მანქანური სწავლების მოდელების ლოკალური განთავსებიდან მასშტაბირებად, რეალურ პროექტებში გამოსაყენებელ სისტემებზე Docker-ისა და Kubernetes-ის გამოყენებით. სტატია აღწერს აპლიკაციის ლოგიკის კონტეინერიზაციას, Docker-ის კონტეინერების განთავსებას Kubernetes კლასტერზე (კერძოდ Google Kubernetes Engine-ზე - GKE), TensorFlow Serving-ის გამოყენებას მოდელების მომსახურებისთვის, მორგებული Docker გამოსახულებების შექმნას და მათ Google Container Registr

NVIDIA NIM ამარტივებს ხელოვნური ინტელექტის მოდელების, მათ შორის LLM-ების განთავსებას
NVIDIA NIM ინფერენციის მიკროსერვისები მომხმარებლებსა და პარტნიორებს საშუალებას აძლევს, გამარტივებული მიდგომით, სწრაფად და საიმედოდ განათავსონ ხელოვნური ინტელექტის უახლესი მოდელები, განსაკუთრებით დიდი ენობრივი მოდელები (LLM). ის მხარს უჭერს 100 000-ზე მეტ LLM-ს Hugging Face-ზე, მუშაობს ერთ Docker კონტეინერში და უზრუნველყოფს ავტომატურ ოპტიმიზაციას კონფიგურაციის გარეშე. ეს სისტემა მიზნად ისახავს AI ინოვაციების დაჩქარებას NVIDIA-ს აჩქარებულ ინფრასტრუქტურაზე, რაც დეველოპერებსა და საწარმოებს ეხმარება