
Hugging Face-ის ინფრასტრუქტურის განახლება მონაცემთა გადაცემის გამოწვევების დასაძლევად
სტატია აღწერს Hugging Face-ის ინფრასტრუქტურის მასშტაბურ განახლებას, რომელიც მიზნად ისახავს მონაცემთა ატვირთვისა და ჩამოტვირთვის არსებული შეზღუდვების დაძლევას. ამჟამინდელი სისტემა, რომელიც AWS S3-სა და CloudFront-ს ეყრდნობა, ვეღარ აკმაყოფილებს მზარდი ზომის ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების მოთხოვნებს. ახალი არქიტექტურა წარმოადგენს კონტენტზე მისამართირებულ საცავს (Content-Addressed Store - CAS), რომელიც ფაილებს ბაიტის დონეზე ამუშავებს, რაც საშუალებას იძლევა ოპტიმიზაციის, გადა
Hugging Face-ი ფაილების გადაცემის არქიტექტურას ანახლებს: ახალი მიდგომა დიდი მოცულობის მონაცემებისთვის
Hugging Face აცხადებს ინფრასტრუქტურის მნიშვნელოვან განახლებას, რათა ოპტიმიზაცია გაუკეთოს მოდელებისა და მონაცემთა ნაკრებების დიდი ზომის ფაილების ატვირთვასა და ჩამოტვირთვას. არსებული CDN-ის (AWS CloudFront) 50GB ლიმიტის გამოწვევის ფონზე, კომპანია ნერგავს კონტენტზე მიბმულ საცავს (CAS), როგორც ახალ არქიტექტურულ ელემენტს. ეს ახალი სისტემა იყენებს "სულელი წაკითხვების" და "ჭკვიანი ჩაწერების" პერსონალიზებულ პროტოკოლს, რომელიც აანალიზებს ფაილებს ბაიტის დონეზე, რათა გააუმჯობესოს გადაცემის სიჩქარე, უზრუნვე
SQL მოთხოვნების მხარდაჭერა DuckDB-ით ჰაბზე არსებული მონაცემთა ნაკრებებისთვის
ჰაბზე დაემატა ახალი ფუნქცია, რომელიც მომხმარებლებს საშუალებას აძლევს, გაუშვან SQL მოთხოვნები DuckDB-ის გამოყენებით ნებისმიერ მონაცემთა ნაკრებზე. ეს ინტეგრაცია აუმჯობესებს დიდ მონაცემთა ნაკრებებთან მუშაობის ეფექტურობას Parquet ფაილების ფორმატის და დისტანციური წვდომის შესაძლებლობების მეშვეობით, რაც ხელს უწყობს ღია წვდომას და ანალიზს, განსაკუთრებით დიდი ენობრივი მოდელების (LLM) ეპოქაში.
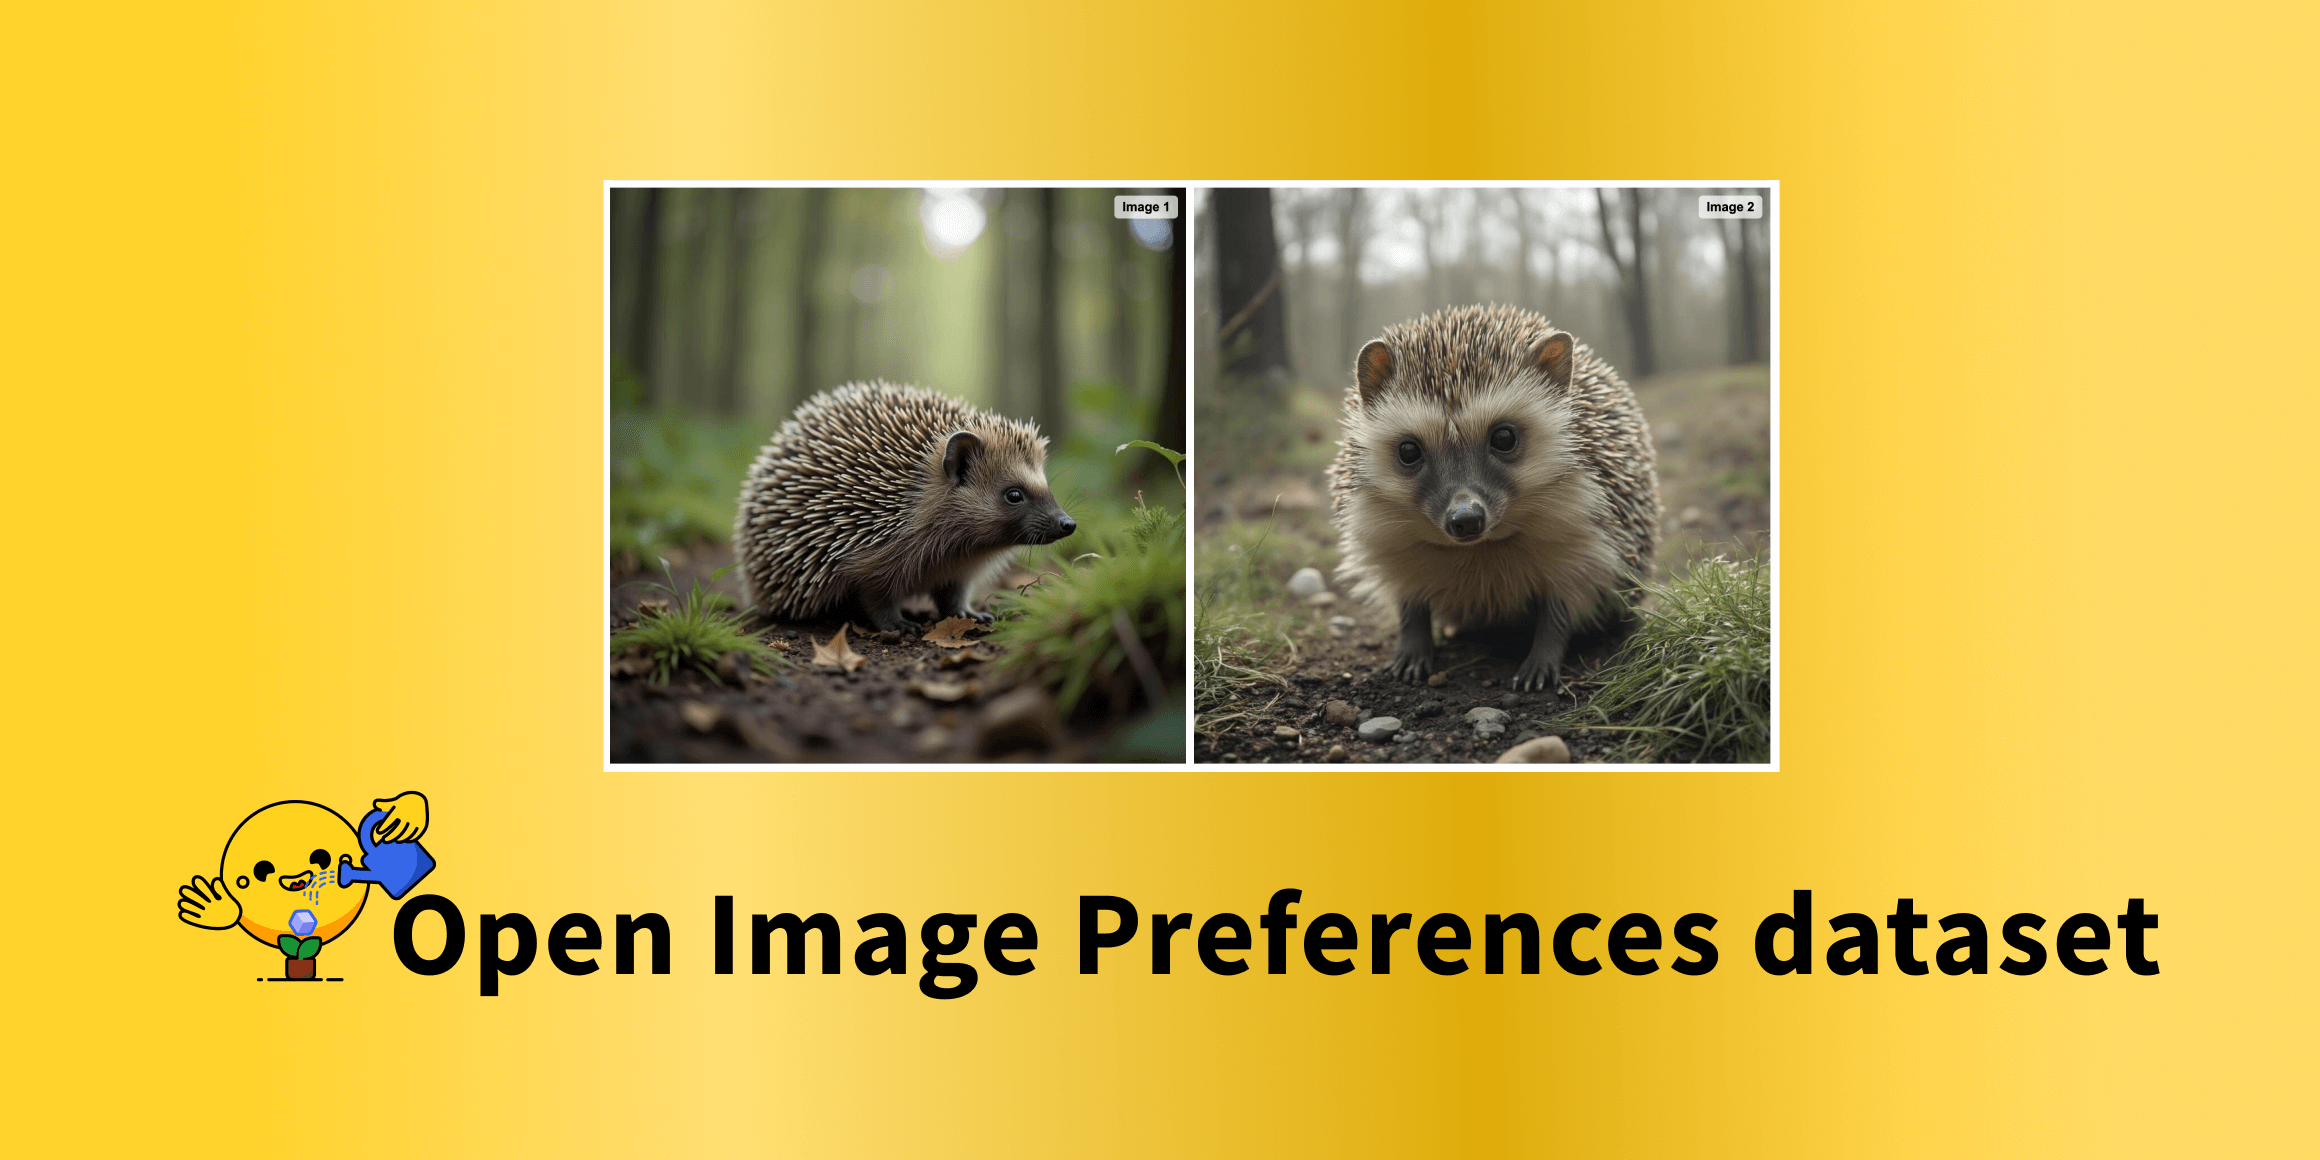
„მონაცემები ერთად უკეთესია“: Hugging Face და ღია კოდის AI საზოგადოება რევოლუციას ახდენენ გამოსახულების გენერაციაში
სტატია აღწერს Hugging Face-ისა და ღია კოდის AI საზოგადოების ერთობლივ პროექტს, სახელწოდებით „მონაცემები ერთად უკეთესია“, რომელიც მიზნად ისახავს ღია კოდის ეფექტური მონაცემთა ნაკრებების შექმნას. მნიშვნელოვანი მიღწევაა `open-image-preferences-v1`, უნიკალური გამოსახულების უპირატესობის მონაცემთა ნაკრები, რომელიც გამოირჩევა მრავალფეროვანი პრომპტებითა და ღია განვითარებით. მონაცემთა ნაკრები დეტალურად შეიქმნა სინთეზური მონაცემების გენერაციის, ტოქსიკურობის მოწინავე ფილტრაციისა და Flux-ისა და Stable Diffusi

სინთეზური მონაცემების გენერაცია: ხელოვნური ინტელექტის შესაძლებლობების გაფართოება
სტატია მიმოიხილავს სინთეზური მონაცემების მნიშვნელობასა და გენერაციის პროცესს. სინთეზური მონაცემები არის ხელოვნურად შექმნილი ინფორმაცია, რომელიც რეალურ სამყაროს მონაცემებს მიბაძავს და ხელს უწყობს მონაცემთა შეზღუდვების დაძლევას, ნაკრებების გაფართოებით ან გაუმჯობესებით. აღწერილია სინთეზური მონაცემების გენერატორის გამოყენება Hugging Face-ის უფასო API-სა და Argilla-ს ინტეგრაციის მეშვეობით, ტექსტის კლასიფიკაციისა და ჩატის მონაცემთა ნაკრებების შესაქმნელად. მოცემულია დეტალური სამსაფეხურიანი პროცესი მონა
DeepSeek-R1-ის გარღვევა მსჯელობის მოდელებში და Open-R1 პროექტი: საიდუმლოების გამჟღავნებისკენ
DeepSeek-R1-ის ახალი მოდელი, რომელიც OpenAI-ის o1-ს უტოლდება ან აღემატება, დეტალური ტექნიკური ანგარიშით გამოვიდა, რამაც ხელოვნური ინტელექტის საზოგადოებაში დიდი აჟიოტაჟი გამოიწვია. მოდელი ეფუძნება ინოვაციურ მიდგომას, მათ შორის გაძლიერებულ სწავლებას ადამიანის ზედამხედველობის გარეშე. თუმცა, DeepSeek-მა არ გაასაჯაროვა თავისი მონაცემთა ნაკრებები და კოდი, რამაც Open-R1 პროექტი გააჩინა, რომელიც მიზნად ისახავს DeepSeek-R1-ის „რეცეპტის“ რეკონსტრუქციას, გამჭვირვალობის გაზრდას და ღია წყაროს მსჯელობის მოდელ
Hugging Face Hub-ის მონაცემთა ნაკრებების მეტამონაცემების გაუმჯობესება მანქანური სწავლების საშუალებით
Hugging Face Hub, როგორც მანქანური სწავლების რესურსების ცენტრალური საცავი, აუმჯობესებს მონაცემთა ნაკრებების მეტამონაცემებს ხელოვნური ინტელექტის გამოყენებით. ახალი ინიციატივის ფარგლებში, მანქანური სწავლების ალგორითმები ამოიცნობენ ენას იმ მონაცემთა ნაკრებებში, რომლებსაც არ აქვთ ენის მეტამონაცემები, ხოლო ავტომატიზებული „ბიბლიოთეკარი-ბოტები“ ამ ინფორმაციას მეტამონაცემებში დაამატებენ. ეს პროექტი მიზნად ისახავს რესურსების მოძიების გაადვილებას და Hub-ზე წარმოდგენილი ენობრივი მიკერძოებების უკეთ გაგებას.

Hugging Face აერთიანებს სერვერულ ინფერენსზე წვდომას ახალი პარტნიორობითა და ფუნქციებით
Hugging Face-მა, საკუთარი სერვერული Inference API-ის ხანგრძლივი მასპინძლობის შემდეგ, გადაწყვიტა ფოკუსირება თანამშრომლობაზე, დიდი მონაცემთა ნაკრებებისა და მოდელების შენახვაზე, ვერსიონირებასა და გავრცელებაზე. ამის პარალელურად, კომპანია მომხმარებლებს სთავაზობს მარტივ და ერთიან წვდომას სერვერულ ინფერენსზე წამყვანი პროვაიდერების მეშვეობით. ეს ნაბიჯი აძლიერებს AI მოდელების ხელმისაწვდომობას, გვთავაზობს მოქნილ ფასებს პირდაპირი და მარშრუტიზებული მოთხოვნებისთვის, და უზრუნველყოფს დამატებით ბენეფიტებს PRO მ

Open R1 პროექტი: OpenR1-Math-220k მონაცემთა ნაკრების წარდგენა მათემატიკური მსჯელობისთვის
Open R1 პროექტი, რომლის მიზანია DeepSeek R1-ის დაკარგული კომპონენტების – კერძოდ, საწვრთნელი პაიპლაინისა და სინთეზური მონაცემების – რეკონსტრუქცია, უკვე ორი კვირაა მიმდინარეობს. ამ პოსტში წარმოდგენილია OpenR1-Math-220k: ჩვენი პირველი ფართომასშტაბიანი მონაცემთა ნაკრები მათემატიკური მსჯელობისთვის. განხილულია საზოგადოების ძალისხმევა მცირე, მაღალი ხარისხის მონაცემთა ნაკრებების შესაქმნელად და მსჯელობის მოდელებიდან „აზროვნების ჯაჭვის“ (chain-of-thought) სიგრძის კონტროლის მეთოდები. სტატია დეტალურად აღწერ

ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნა: ახალი ინსტრუმენტები საზოგადოებისთვის
ამ სტატიაში განვიხილავთ ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნისთვის შემუშავებულ ახალ ინსტრუმენტებს, რომლებიც მიზნად ისახავს ამ პროცესის გამარტივებას, სურათების გენერაციის მსგავსად. წარმოდგენილია ღია კოდის სკრიპტები მცირე მასშტაბისთვის და video2dataset დიდი მასშტაბისთვის. დეტალურად აღიწერება მონაცემთა დამუშავების 3-ეტაპიანი კონვეიერი, ფილტრაციის სტრატეგიები (მათ შორის pwatermark-ისა და ესთეტიკური ქულების გამოყენებით) და მათი გავლენა ვიდეო გენერაციის მოდელების ხარისხზე. მიზანია, საზოგადოებას
Hugging Face Hub: მონაცემთა გადაცემის და შენახვის ოპტიმიზაცია დედუპლიკაციის ახალი მიდგომებით
Hugging Face Hub-ზე ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების სწრაფი ზრდა მოითხოვს ეფექტურ მონაცემთა მართვას. სტატია აღწერს, თუ როგორ უმკლავდება Xet გუნდი გამოწვევებს, რომლებიც დაკავშირებულია დედუპლიკაციასთან, ტრადიციული მიდგომების შეზღუდვებთან და მასშტაბირებადობასთან. ნაცვლად იმისა, რომ ფოკუსირება მხოლოდ მცირე ბლოკების დედუპლიკაციაზე მოხდეს, რაც ინფრასტრუქტურას გადატვირთავს, Xet გუნდმა შეიმუშავა ინოვაციური, ბლოკებზე დაფუძნებული მიდგომა Rust-ში დაწერილი xet-core და hf_xet ინტეგრაცი
Streamlit Hugging Face Spaces-ში: ML მოდელებისა და მონაცემთა ვიზუალიზაცია
ეს სტატია განმარტავს, თუ როგორ გამოიყენოთ Streamlit Hugging Face Spaces-თან ერთად მანქანური სწავლების მოდელების დემოების შესაქმნელად და მონაცემთა ნაკრებების ვიზუალიზაციისთვის. ის მოიცავს მოდელების ჰოსტინგს, ინტერფეისის აგებას, მონაცემთა სტრიმინგსა და ვიზუალიზაციის კომპონენტების გამოყენებას, მაგალითად, „Write with Transformer“-ის რეპლიკაციით.
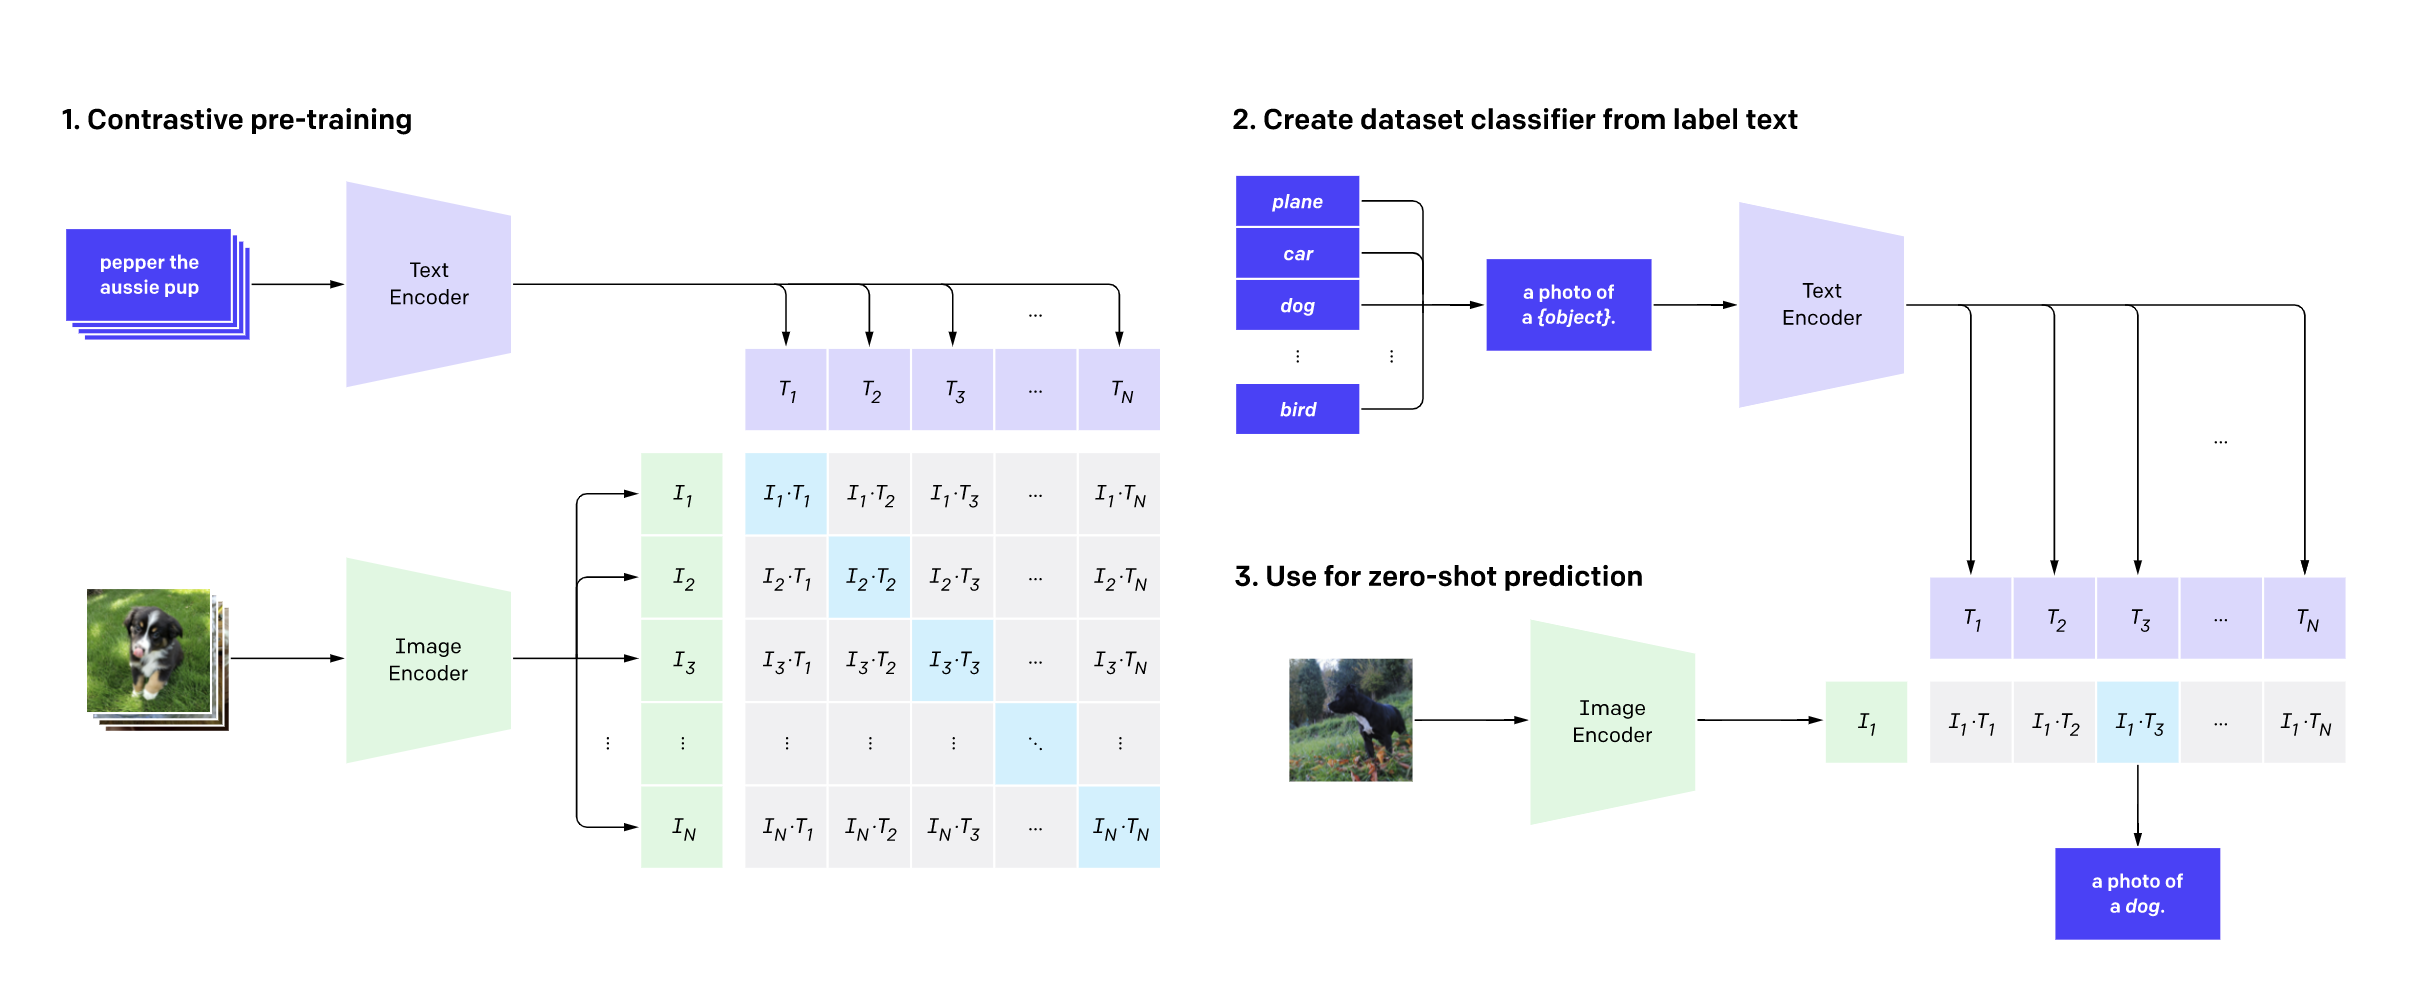
CLIP მოდელის დახვეწა სატელიტური გამოსახულებებისთვის: Hugging Face-ის საზოგადოებრივი კვირეულის პროექტი
მიმდინარე წლის ივლისში Hugging Face-მა მოაწყო Flax/JAX საზოგადოებრივი კვირეული, სადაც მონაწილეებმა გამოიყენეს Tensor Processing Units (TPU) Flax-ისა და JAX-ის საშუალებით, რათა გაეწვრთნათ Hugging Face ტრანსფორმერების მოდელები ბუნებრივი ენის დამუშავებისა და კომპიუტერული ხედვის სფეროებში. ჩვენმა გუნდმა OpenAI-ის CLIP ქსელი დახვეწა RSICD, UCM და სიდნეის მონაცემთა ნაკრებებიდან მიღებული სატელიტური გამოსახულებებითა და აღწერებით. პროექტის მიზანი იყო სატელიტური გამოსახულებების დიდი კოლექციების ტექსტური მ

Hugging Face-ის Xet გუნდი: დიდი ნაბიჯი AI მოდელებისა და მონაცემთა საცავების მიგრაციაში
Hugging Face-ის Xet გუნდმა წარმატებით განახორციელა მოდელებისა და მონაცემთა ნაკრებების პირველი საცავების მიგრაცია LFS-დან Xet საცავში. ეს ნაბიჯი, რომელიც Hugging Face-ის Hub-ის ხედვის ნაწილია, მიზნად ისახავს ხელოვნური ინტელექტის დეველოპერებისთვის მასიურ მოდელებსა და მონაცემთა ნაკრებებზე მუშაობის გამარტივებას, უფრო ეფექტურ თანამშრომლობასა და განმეორებითი იტერაციების განხორციელებას. მიგრაციამ Hub-ის ჩამოტვირთვის ტრაფიკის დაახლოებით 6% Xet ინფრასტრუქტურაზე გადაიტანა, რაც ამტკიცებს ახალი სისტემის ეფე
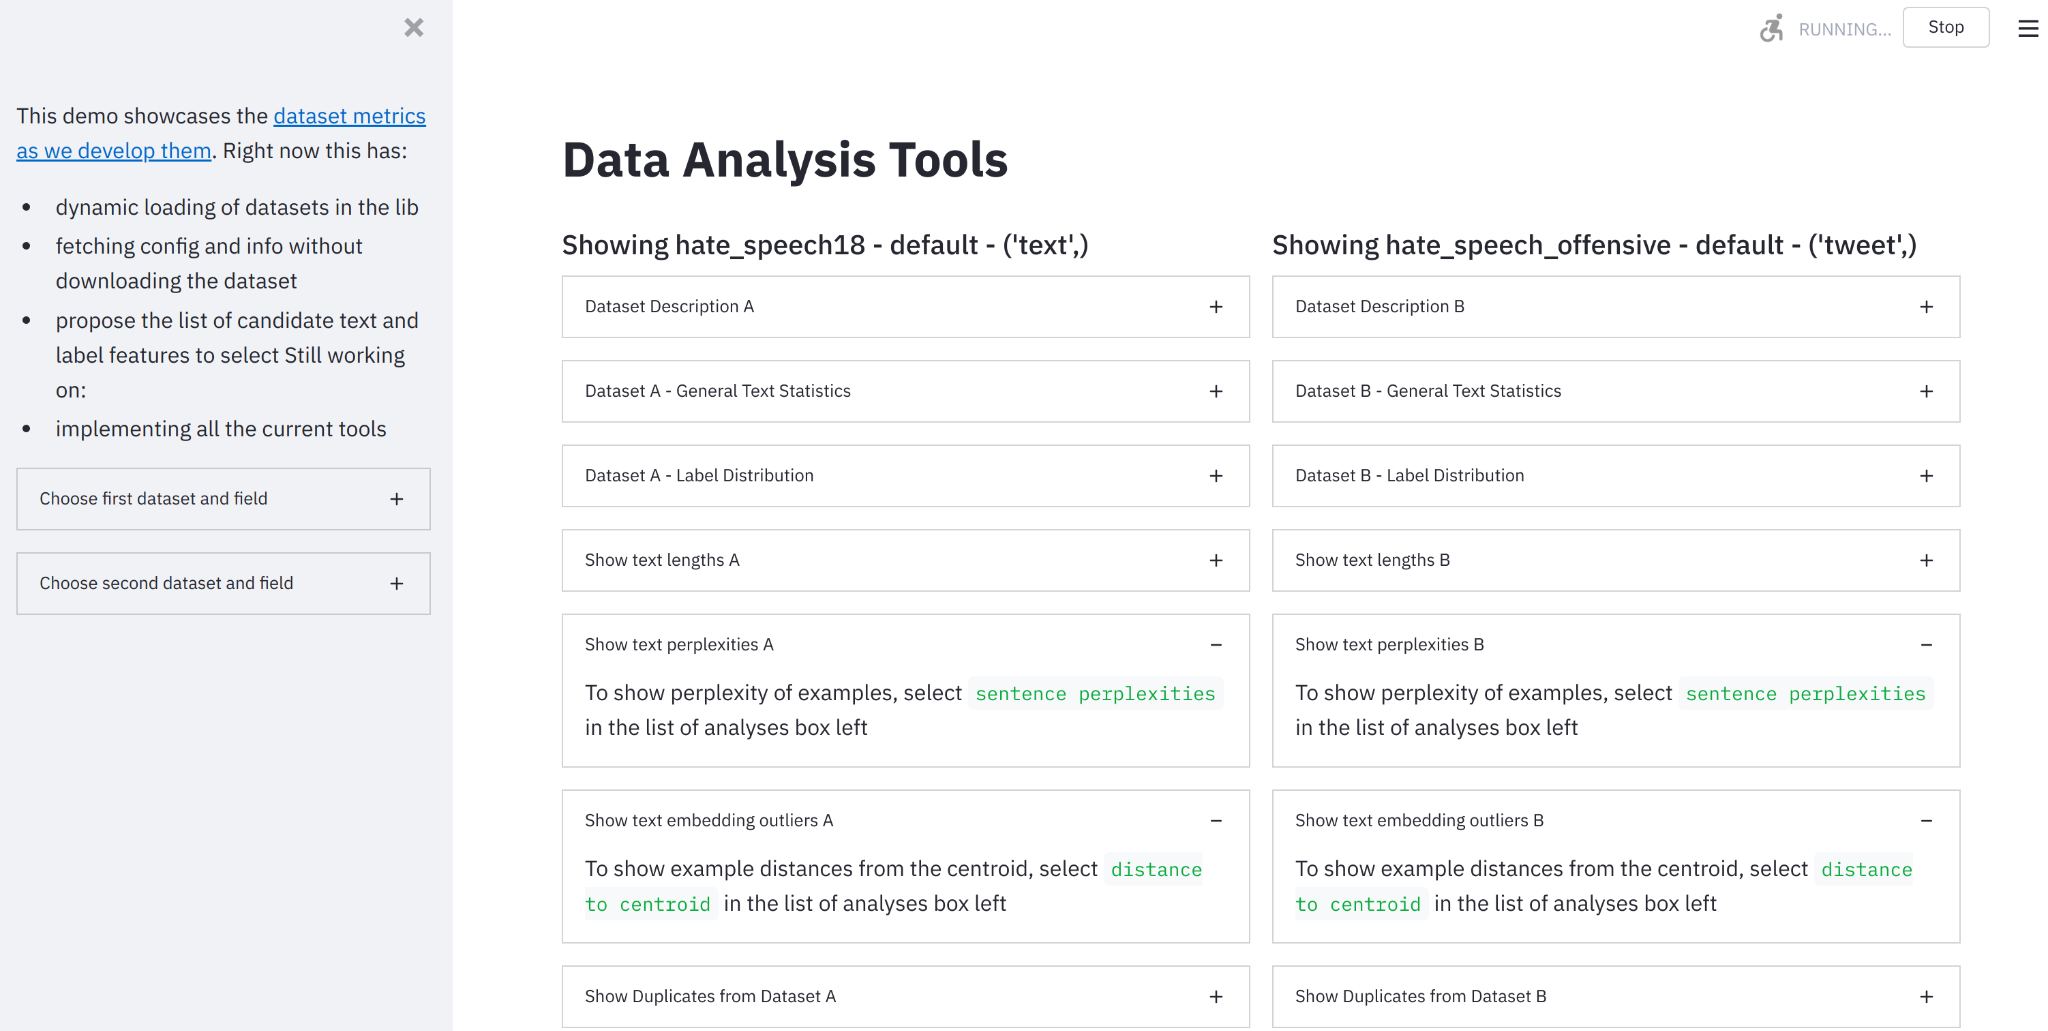
Hugging Face წარმოგიდგენთ მონაცემთა გაზომვის ხელსაწყოს AI მონაცემთა პასუხისმგებლიანი განვითარებისთვის
Hugging Face-ის გუნდმა გამოუშვა ღია კოდის Python ბიბლიოთეკა და უკოდო ინტერფეისი, სახელწოდებით „მონაცემთა გაზომვის ხელსაწყო“ (Data Measurements Tool - DMT). ეს ინსტრუმენტი მიზნად ისახავს მანქანური სწავლების მონაცემთა ნაკრებების გაგებას, შექმნას, კურირებასა და შედარებას. DMT პასუხობს ხელოვნური ინტელექტის განვითარებაში მონაცემთა გააზრებული ანალიზის ხარვეზს, განსაკუთრებით „დიდი მონაცემების“ გამოყენებისას არსებულ მიკერძოებებსა და ხარვეზებს. ის მომხმარებლებს საშუალებას აძლევს ავტომატურად გამოთვალონ მნ
Renumics Spotlight: ინტერაქტიული ვიზუალიზაცია და მონაცემთა ინსპექცია Hugging Face-ის მონაცემთა ნაკრებებისთვის
Renumics Spotlight გთავაზობთ ინტერაქტიულ ვიზუალიზაციებს Hugging Face-ის მონაცემთა ნაკრებებში კრიტიკული კლასტერების იდენტიფიცირებისთვის. ის იყენებს მოდელის შედეგებს (პროგნოზები, ემბედინგები) მონაცემთა სეგმენტებისა და მოდელის შეცდომების ღრმა გაგებისთვის, რაც აადვილებს მონაცემთა ინსპექციას და ხდის მას მასშტაბირებადს. ხელსაწყო პირდაპირ ინტეგრირდება `datasets` ბიბლიოთეკასთან და მხარს უჭერს სხვადასხვა ტიპის მონაცემებსა და ML ამოცანებს, მათ შორის NLP, აუდიო და კომპიუტერული ხედვა.
ახალი რეგიონების ფუნქცია: სად შეინახოთ თქვენი მონაცემები და რატომ არის ეს მნიშვნელოვანი
ეს ბლოგ პოსტი განიხილავს ახალ ფუნქციას, რომელიც მომხმარებლებს საშუალებას აძლევს აირჩიონ თავიანთი მონაცემების (მოდელები და მონაცემთა ნაკრებები) შენახვის რეგიონი. ეს უზრუნველყოფს მონაცემთა რეზიდენტურის მოთხოვნებთან შესაბამისობას (მაგ. GDPR) და მნიშვნელოვნად აუმჯობესებს ატვირთვისა და ჩამოტვირთვის სიჩქარეს. სტატიაში ასევე აღწერილია, თუ როგორ უნდა დავაყენოთ ეს ფუნქცია.
Prodigy-HF: Hugging Face მოდელების გაწვრთნა და ანოტირებული მონაცემთა ნაკრებების გაზიარება
Explosion-მა გამოუშვა Prodigy-HF, ახალი პლაგინი, რომელიც Prodigy-ის ანოტაციის ხელსაწყოს Hugging Face-ის ეკოსისტემასთან აინტეგრირებს. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს, გაწვრთნან Hugging Face მოდელები საკუთარ ანოტირებულ მონაცემებზე (მაგ. დასახელებული ერთეულების ამოცნობისთვის და ტექსტის კლასიფიკაციისთვის) და გამოაქვეყნონ ეს მონაცემთა ნაკრებები Hugging Face Hub-ზე, რაც ხელს უწყობს მოქნილობას, თანამშრომლობას და დროის დაზოგვას ხელოვნური ინტელექტის პროექტებში.
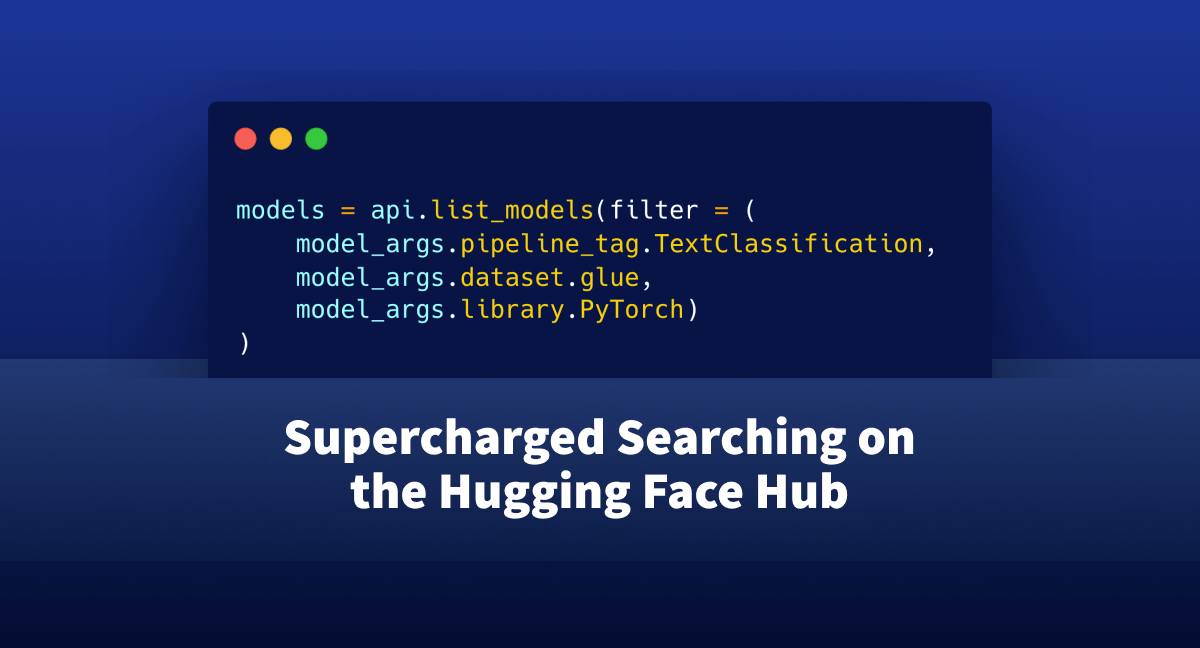
Hugging Face Hub-ის ძიების გამარტივება: პროგრამული ინტერფეისის ახალი შესაძლებლობები
სტატიაში წარმოდგენილია `huggingface_hub` ბიბლიოთეკის ახალი ფუნქციები, `ModelSearchArguments` და `ModelFilter`, რომლებიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე AI მოდელებისა და მონაცემთა ნაკრებების ძიებას პირდაპირ Python-ის ან Jupyter-ის გარემოდან. ეს სიახლე დეველოპერებს საშუალებას აძლევს, არ დატოვონ IDE და ეფექტურად მართონ რთული მოთხოვნები, რაც მნიშვნელოვნად აუმჯობესებს სამუშაო პროცესს.

რობოტიკის განზოგადების გამოწვევა: მონაცემების მნიშვნელობა და LeRobot-ის წვლილი
ვიზუალურ-ენობრივ-მოქმედებითი (VLA) მოდელების მიღწევებმა რობოტებს საშუალება მისცა შეასრულონ რთული ამოცანები, თუმცა ჭეშმარიტი განზოგადება ახალ გარემოში კვლავ უდიდეს გამოწვევად რჩება. ეს სტატია ხაზს უსვამს, რომ განზოგადება ძირითადად მონაცემების ფენომენია და არა მხოლოდ მოდელის თვისება. განხილულია არსებული, ხშირად აკადემიური, მონაცემთა ნაკრებების შეზღუდვები და ხაზგასმულია მრავალფეროვანი, რეალური სამყაროს მონაცემების საჭიროება. LeRobot აქტიურად მუშაობს მონაცემთა შეგროვების დემოკრატიზაციაზე, რათა ხელი
მომხმარებელთა მხარდაჭერის ავტომატიზაცია NLP-ის გამოყენებით: უკმაყოფილო კლიენტების იდენტიფიკაცია
წინამდებარე სტატია განმარტავს, თუ როგორ შეიძლება ბუნებრივი ენის დამუშავების (NLP) მოდელების გამოყენება მომხმარებელთა მხარდაჭერის პროცესების ნაწილობრივი ავტომატიზაციისთვის. განხილულია ჰიპოთეტური შემთხვევა, სადაც NLP გამოიყენება განსაკუთრებით უკმაყოფილო მომხმარებლების შეტყობინებების იდენტიფიცირებისა და პრიორიტეტულობისთვის, რაც ზრდის პასუხის ეფექტურობასა და კლიენტების კმაყოფილებას. მოცემულია ნაბიჯები გამოყენების შემთხვევის განსაზღვიდან მონაცემთა ნაკრებებისა და მოდელების შერჩევამდე Hugging Face-ის პ
Hugging Face Hub-ი აფართოებს fastai-ის შესაძლებლობებს: ღრმა სწავლის მოდელების გაზიარება ერთი ხაზით
Hugging Face-ი, რომლის მიზანია მანქანური სწავლების დემოკრატიზაცია, სიამაყით აცხადებს fastai-თან ახალ ინტეგრაციას. ეს ინტეგრაცია fastai-ის მომხმარებლებს საშუალებას აძლევს, მარტივად გააზიარონ და ატვირთონ ღრმა სწავლის მოდელები Hugging Face Hub-ზე Python-ის ერთი ხაზის გამოყენებით. სტატიაში ხაზგასმულია fastai-ის წვლილი ღრმა სწავლების ხელმისაწვდომობაში და აღწერილია Hub-ის, როგორც მოდელების, მონაცემთა ნაკრებებისა და ML დემოების ცენტრალური პლატფორმის, უპირატესობები. ინტეგრაცია მოიცავს ვერსიის კონტროლს G
ხელოვნური ინტელექტის მორგება ღია მოდელებზე: კონსტიტუციური AI და ახალი ინსტრუმენტი llm-swarm
სტატია წარმოგიდგენთ კონსტიტუციურ ხელოვნურ ინტელექტს (CAI), როგორც დიდი ენობრივი მოდელების (LLMs) მომართვის ინოვაციურ ტექნიკას მომხმარებლის მიერ განსაზღვრული პრინციპების გამოყენებით, რაც მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. იგი გვთავაზობს CAI-ის ღია მოდელებით განხორციელების სრულყოფილ გზამკვლევს, მათ შორის ახალ ინსტრუმენტ llm-swarm-ს მასშტაბური სინთეზური მონაცემების გენერირებისთვის. განხილულია CAI მონაცემთა ნაკრებების შექმნისა და მოდელების, მაგალითად Mistral-7B-
ინტერვიუ საშა ლუჩიონთან: AI-ს ეთიკური გამოყენება და მისი გარემოზე ზემოქმედება
წარმოგიდგენთ ინტერვიუს საშა ლუჩიონთან, Hugging Face-ის მკვლევარ მეცნიერთან, რომელიც მუშაობს მანქანური სწავლის მოდელებისა და მონაცემთა ნაკრებების ეთიკურ და საზოგადოებრივ გავლენებზე. საშა ასევე Big Science Workshop-ის ნახშირბადის კვალის სამუშაო ჯგუფის თანათავმჯდომარე და Climate Change AI (CCAI) ორგანიზაციის დამფუძნებელი წევრია. ამ ეპიზოდში ის საუბრობს იმაზე, თუ როგორ ზომავს ელექტრონული ფოსტის ნახშირბადის კვალს, როგორ დაეხმარა ადგილობრივ საქველმოქმედო სამზარეულოს ML-ის გამოყენებაში და როგორ ანიჭებს