Hugging Face Hub: მანქანური სწავლების შესაძლებლობები GLAM სექტორისთვის
Hugging Face მიზნად ისახავს უმაღლესი ხარისხის მანქანური სწავლების საყოველთაო ხელმისაწვდომობას. ამის მისაღწევად კომპანია აწვდის ღია კოდის ბიბლიოთეკებს, უფასო კურსებს და Hugging Face Hub-ს – ცენტრალურ საცავს 190,000-ზე მეტი მოდელით, 33,000 მონაცემთა ნაკრებით და 100,000-ზე მეტი აპლიკაციით. ეს სტატია განკუთვნილია GLAM სექტორში (გალერეები, ბიბლიოთეკები, არქივები, მუზეუმები) მომუშავე პირებისთვის, რათა გაიგონ, როგორ გამოიყენონ და როგორ შეიტანონ წვლილი Hub-ში. მაგალითად, NER მოდელის გამოყენება ციფრული დ
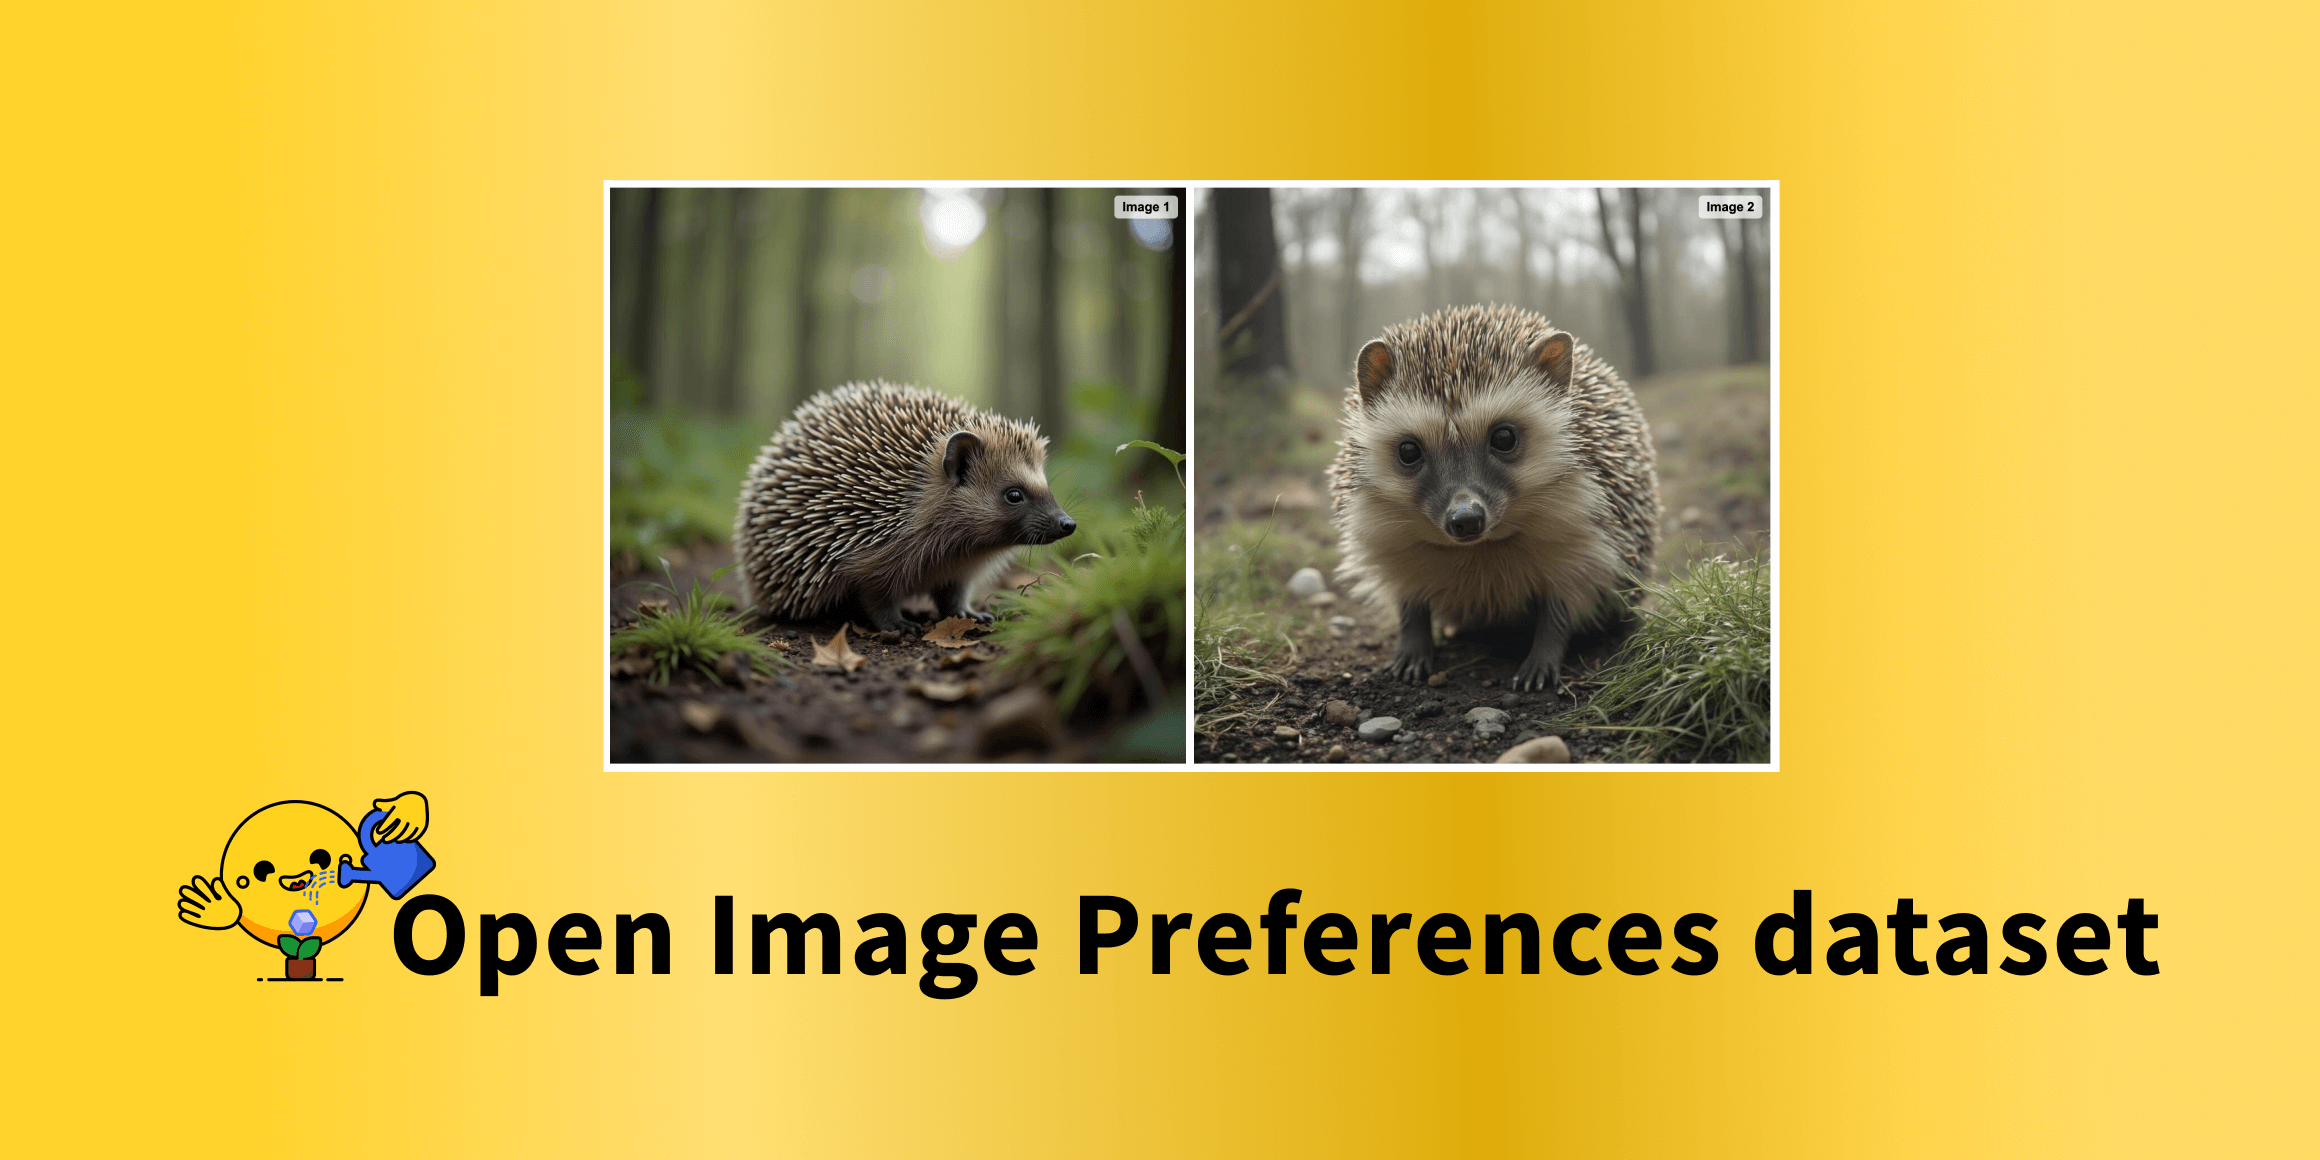
„მონაცემები ერთად უკეთესია“: Hugging Face და ღია კოდის AI საზოგადოება რევოლუციას ახდენენ გამოსახულების გენერაციაში
სტატია აღწერს Hugging Face-ისა და ღია კოდის AI საზოგადოების ერთობლივ პროექტს, სახელწოდებით „მონაცემები ერთად უკეთესია“, რომელიც მიზნად ისახავს ღია კოდის ეფექტური მონაცემთა ნაკრებების შექმნას. მნიშვნელოვანი მიღწევაა `open-image-preferences-v1`, უნიკალური გამოსახულების უპირატესობის მონაცემთა ნაკრები, რომელიც გამოირჩევა მრავალფეროვანი პრომპტებითა და ღია განვითარებით. მონაცემთა ნაკრები დეტალურად შეიქმნა სინთეზური მონაცემების გენერაციის, ტოქსიკურობის მოწინავე ფილტრაციისა და Flux-ისა და Stable Diffusi

LeMaterial-ის გაშვება: ღია კოდის კოლაბორაციული პროექტი მასალების კვლევისთვის Entalpic-ისა და Hugging Face-ისგან
Entalpic-ისა და Hugging Face-ის მიერ ინიცირებული ღია კოდის კოლაბორაციული პროექტი LeMaterial ამოქმედდა, რომლის მიზანია მასალების კვლევის გამარტივება და დაჩქარება. პროექტი ხელს შეუწყობს მანქანური სწავლების მოდელების გაწვრთნას, ახალი მასალების იდენტიფიცირებას და ქიმიური სივრცეების შესწავლას. პირველ ეტაპზე გამოვიდა LeMat-Bulk მონაცემთა ნაკრები, რომელიც აერთიანებს, ასუფთავებს და სტანდარტიზაციას უკეთებს წამყვან მონაცემთა ბაზებს (Materials Project, Alexandria, OQMD), ქმნის 6.7 მილიონი ჩანაწერისა და 7 მ

Big Bench Audio: ახალი მონაცემთა ნაკრები აუდიო ენის მოდელების მსჯელობის შესაძლებლობების შესაფასებლად
კომპანია Artificial Analysis-მა გამოუშვა Big Bench Audio, ახალი მონაცემთა ნაკრები, რომელიც შექმნილია აუდიო ენის მოდელების მსჯელობის შესაძლებლობების შესაფასებლად. ეს ინოვაციური ნაკრები Big Bench Hard-ის კითხვებს აუდიო ფორმატში ადაპტირებს. პირველადი შედეგები, რომლებიც GPT-4o-სა და Gemini 1.5-ის სერიის მოდელებზე ჩატარდა, ავლენს მნიშვნელოვან „მეტყველების მსჯელობის ხარვეზს“: GPT-4o-ის სიზუსტე ტექსტურ ვერსიაში 92%-ს აღწევს, ხოლო მეტყველება-მეტყველებაზე შესრულებისას ის 66%-მდე ეცემა. ანალიზი მოიცავს მრ

Open R1 პროექტი წარმოგიდგენთ OpenR1-Math-220k: მათემატიკური მსჯელობის ახალ, მასშტაბურ მონაცემთა ნაკრებს
Open R1 პროექტი, რომლის მიზანია DeepSeek R1-ის ტრენინგის პროცესებისა და სინთეზური მონაცემების აღდგენა, სიამოვნებით აცხადებს OpenR1-Math-220k-ის შექმნას – მათემატიკური მსჯელობისთვის განკუთვნილი პირველი ფართომასშტაბიანი მონაცემთა ნაკრები. ეს პოსტი დეტალურად აღწერს მის შექმნის პროცესს, მათ შორის 512 H100 გრაფიკული პროცესორის გამოყენებას გენერაციისთვის და ხარისხის უზრუნველსაყოფად წესებზე დაფუძნებული (Math Verify) და დიდი ენობრივი მოდელებზე დაფუძნებული (Llama-3.3-70B-Instruct) ვალიდაციის მეთოდების კო
Open R1 პროექტი: OpenR1-Math-220k მონაცემთა ნაკრების წარდგენა მათემატიკური მსჯელობისთვის
Open R1 პროექტი, რომლის მიზანია DeepSeek R1-ის დაკარგული კომპონენტების – კერძოდ, საწვრთნელი პაიპლაინისა და სინთეზური მონაცემების – რეკონსტრუქცია, უკვე ორი კვირაა მიმდინარეობს. ამ პოსტში წარმოდგენილია OpenR1-Math-220k: ჩვენი პირველი ფართომასშტაბიანი მონაცემთა ნაკრები მათემატიკური მსჯელობისთვის. განხილულია საზოგადოების ძალისხმევა მცირე, მაღალი ხარისხის მონაცემთა ნაკრებების შესაქმნელად და მსჯელობის მოდელებიდან „აზროვნების ჯაჭვის“ (chain-of-thought) სიგრძის კონტროლის მეთოდები. სტატია დეტალურად აღწერ

Hugging Face და IISc/ARTPARK ინდოეთის ლინგვისტური მრავალფეროვნების მხარდასაჭერად Vaani მონაცემთა ნაკრებს აფართოებენ
Hugging Face-ისა და IISc/ARTPARK-ის პარტნიორობა მიზნად ისახავს Vaani მონაცემთა ნაკრების ხელმისაწვდომობისა და გამოყენებადობის გაუმჯობესებას, რაც ხელს შეუწყობს AI სისტემების განვითარებას ინდოეთის მრავალფეროვანი ენების უკეთ გასაგებად. Project Vaani, რომელიც 2022 წელს IISc/ARTPARK-მა და Google-მა დაიწყეს, არის პიონერული ინიციატივა ღია კოდის მრავალმოდალური მონაცემთა ნაკრების შესაქმნელად, რომელიც ინდოეთის ლინგვისტურ მრავალფეროვნებას ასახავს. ამ მონაცემთა ნაკრებს უკვე მოიცავს 54 ენას და მოიცავს სპონტან
შექმენით თქვენი საკუთარი ღია კოდის ChatGPT კოდის დაწერის გარეშე Hugging Face-ის ხელსაწყოებით
ეს გაკვეთილი გვიჩვენებს, თუ როგორ შეიძლება შეიქმნას და განთავსდეს ღია კოდის ChatGPT-ის მსგავსი აპლიკაცია Meta-ს LLaMA 2 მოდელის გამოყენებით, რომელიც დახვეწილია ღია კოდის ინსტრუქციების მონაცემთა ნაკრებით, ყოველგვარი კოდის დაწერის გარეშე. სტატია ხაზს უსვამს Hugging Face-ის ინსტრუმენტების (Spaces, AutoTrain, ChatUI) როლს, რათა მანქანური სწავლება ხელმისაწვდომი გახდეს არატექნიკური მომხმარებლებისთვის, რაც გზას უხსნის ხელოვნური ინტელექტის დემოკრატიზებულ მომავალს.

NVIDIA-ს რევოლუციური AI სიახლეები: Cosmos Transfer, Physical AI Dataset და Isaac GR00T N1
NVIDIA-მ წარადგინა ხელოვნური ინტელექტის (AI) სამი მნიშვნელოვანი სიახლე: Cosmos Transfer, რომელიც ზრდის ვირტუალური სამყაროს სცენების გენერირების სიზუსტეს; Physical AI Dataset, ღია კოდის მონაცემთა ნაკრები რობოტიკის ვარჯიშისთვის; და Isaac GR00T N1, მსოფლიოში პირველი ღია ფუნდამენტური მოდელი ჰუმანოიდური რობოტების მსჯელობისა და უნარებისთვის. ეს ინოვაციები მიზნად ისახავს ვირტუალური სამყაროების, რობოტიკისა და ავტონომიური სისტემების განვითარებას.
კოდის გენერაციის მოდელის წვრთნის დეტალები: Python-ის მაგალითზე
სტატია დეტალურად აღწერს პითონის კოდის გენერაციის მოდელის შექმნისა და წვრთნის კომპლექსურ პროცესს. ის მოიცავს მონაცემთა მოპოვებას GitHub-იდან, 180 GB-იანი მონაცემთა ნაკრების გაწმენდას დუბლიკატებისაგან Codex-ის ევრისტიკის გამოყენებით (რაც 50 GB-იან გაწმენდილ ნაკრებს იძლევა). შემდეგ აღწერილია სპეციალიზებული ტოკენაიზერის წვრთნა, GPT-2 Large-ზე დაფუძნებული მოდელის ინიციალიზაცია სპეციალური კორექტირებით, და ეფექტიანი სავარჯიშო ციკლის დაყენება 🤗 Accelerate ბიბლიოთეკის გამოყენებით განაწილებული (multi-GPU)

არაბული AI მოდელების შეფასების პლატფორმისა და AraGen ეტალონის მნიშვნელოვანი განახლებები
მიმდინარე ძალისხმევის ფარგლებში, წარმოდგენილია მნიშვნელოვანი განახლებები არაბული AI მოდელების შეფასების პლატფორმაზე. ამოქმედდა Arabic-Leaderboards, რომელიც არაბული ენის მოდელების შეფასებისთვის ერთიან სივრცეს წარმოადგენს. დეკემბერში დაინერგა AraGen ეტალონი დინამიური შეფასების მეთოდოლოგიით, სადაც მონაცემთა ნაკრები სამი თვის განმავლობაში კონფიდენციალური რჩება სამართლიანი შეფასებისთვის. გაფართოვდა AraGen მონაცემთა ნაკრები და დაიხვეწა შემფასებელი სისტემის მოთხოვნები. მიუხედავად იმისა, რომ ახალმა განა
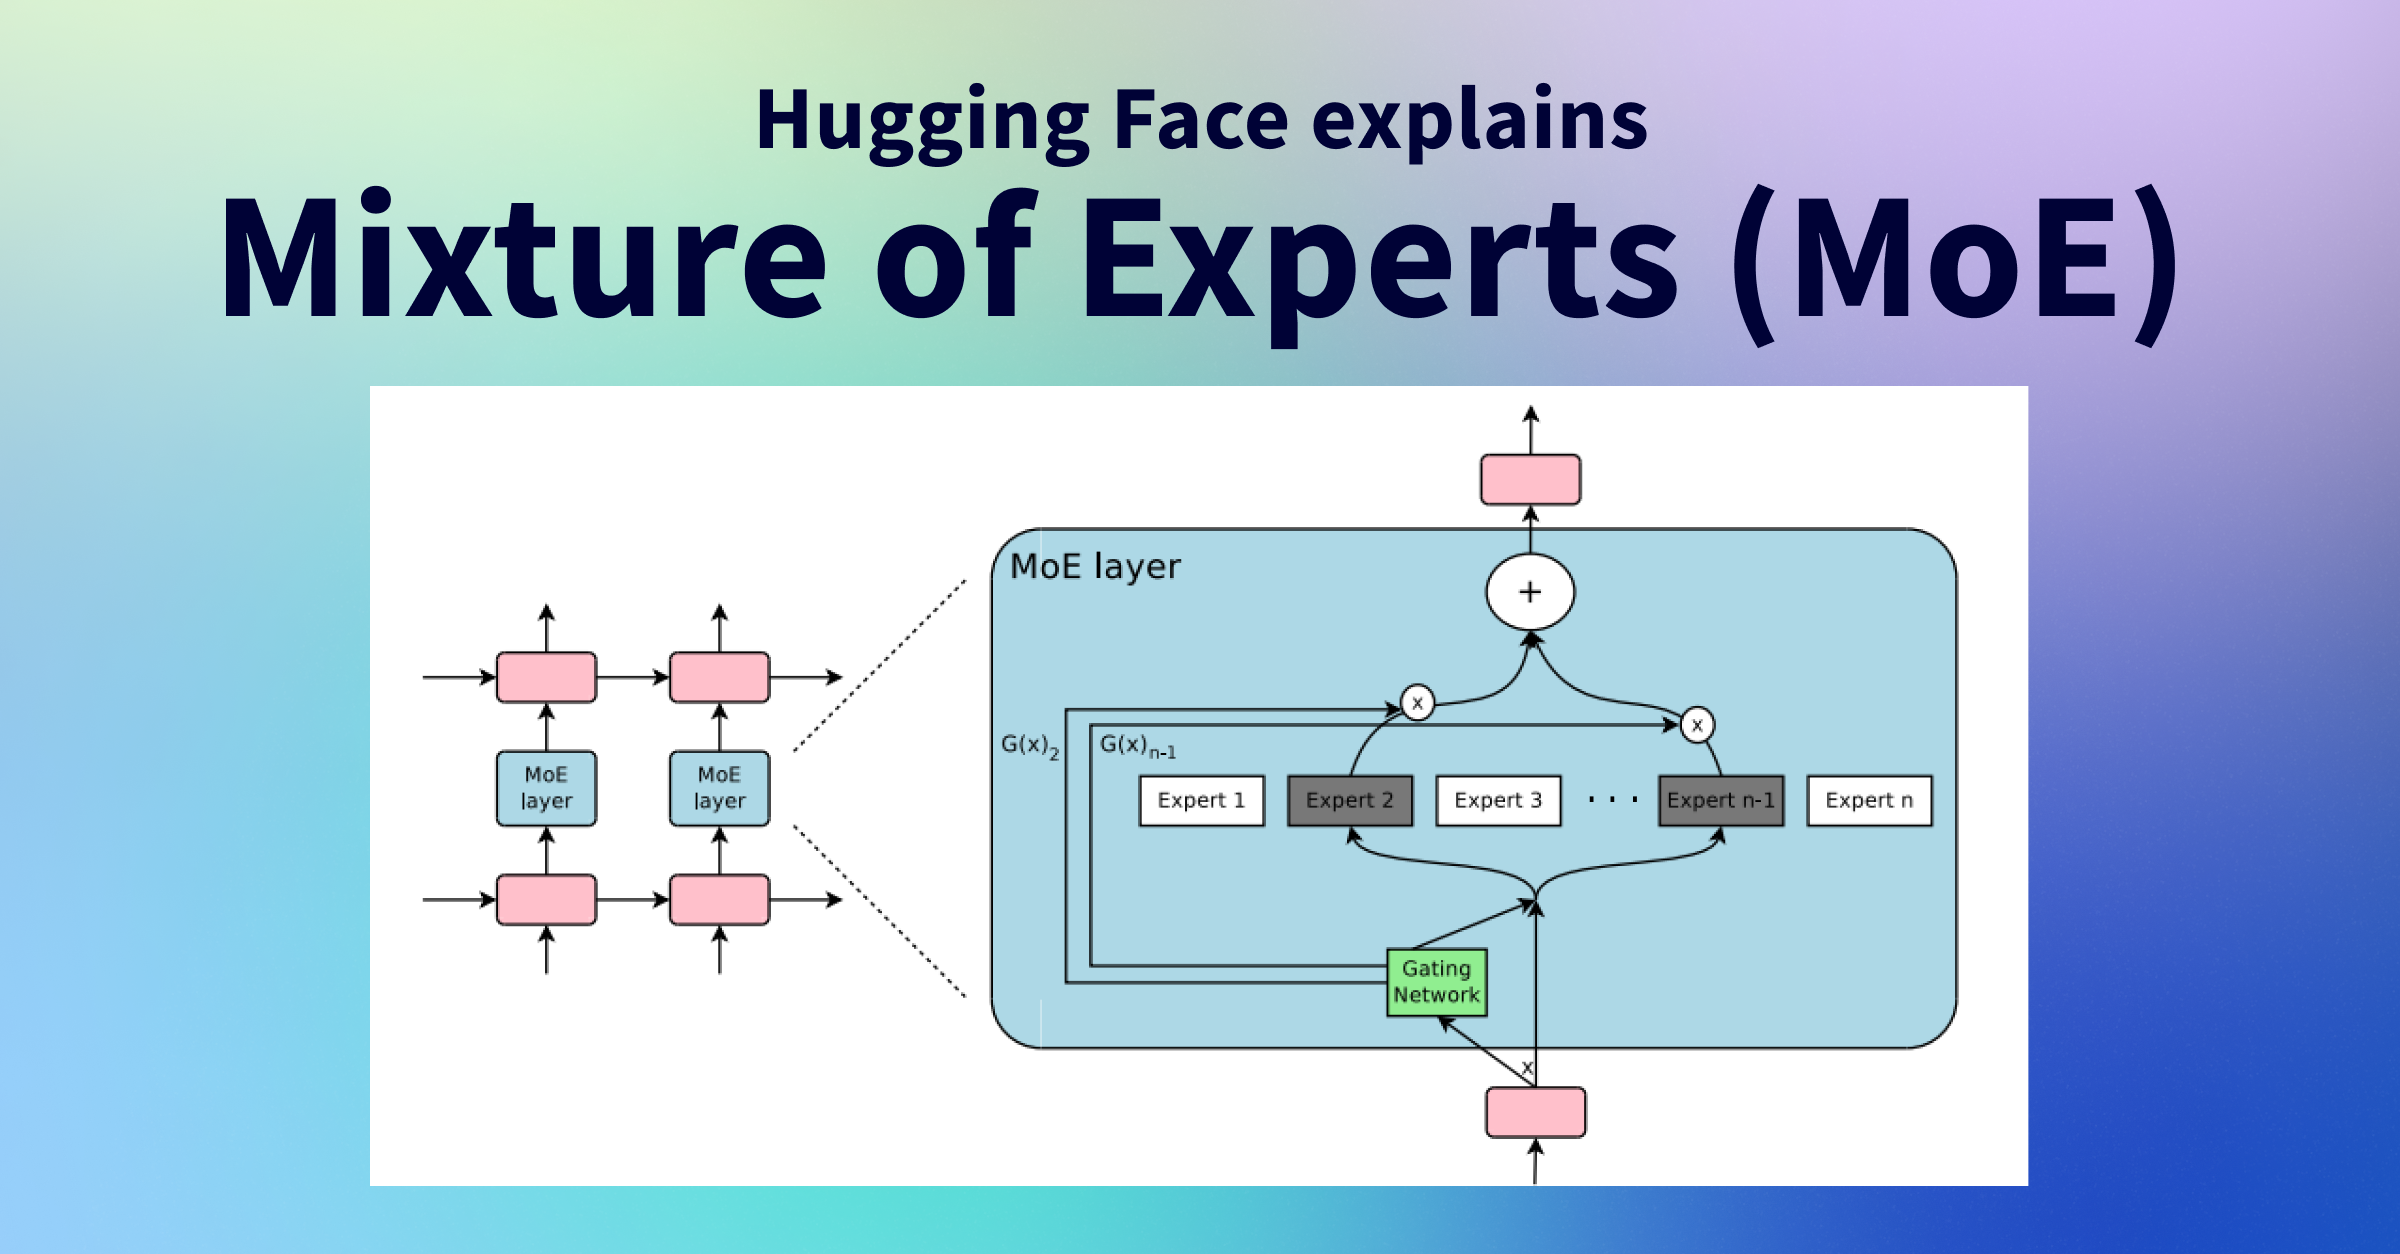
ექსპერტთა ნაზავი (MoEs): სიღრმისეული მიმოხილვა და იშვიათი მოდელების როლი
ექსპერტთა ნაზავი (MoEs) წარმოადგენს მნიშვნელოვან მიღწევას ხელოვნურ ინტელექტში, რომელიც საშუალებას აძლევს მოდელებს, მიაღწიონ უკეთეს ხარისხს გაცილებით ნაკლები გამოთვლითი რესურსებით. MoEs-ის მეშვეობით შესაძლებელია მოდელის ან მონაცემთა ნაკრების ზომის მნიშვნელოვნად გაზრდა მკვრივ მოდელებთან შედარებით, ერთი და იგივე ბიუჯეტის პირობებში, რაც უზრუნველყოფს უფრო სწრაფ წინასწარ წვრთნას. სტატია განმარტავს MoE-ის კონცეფციას ტრანსფორმერული მოდელების კონტექსტში, განიხილავს მის შემადგენელ ნაწილებს (კარიბჭის ქსელი
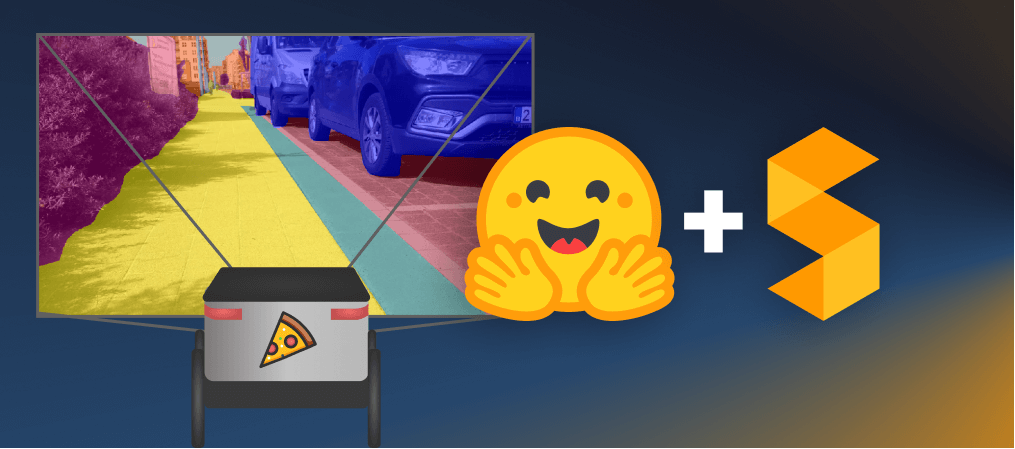
სემანტიკური სეგმენტაცია SegFormer-ით: ავტონომიური სისტემების გაუმჯობესება
სემანტიკური სეგმენტაცია გამოსახულების თითოეული პიქსელის კლასიფიკაციის ამოცანაა, რაც გამოსახულების ანალიზის უფრო ზუსტი მეთოდია. მას ფართო გამოყენება აქვს ისეთ სფეროებში, როგორიცაა სამედიცინო გამოსახულება და ავტონომიური მართვა. სტატია განიხილავს SegFormer მოდელს, რომელიც იყენებს ტრანსფორმერებს სემანტიკური სეგმენტაციისთვის და წარმოადგენს უახლეს მიღწევებს ამ სფეროში. ნაჩვენებია, თუ როგორ იქმნება და მუშავდება სპეციალიზებული მონაცემთა ნაკრები პიცის მიმწოდებელი რობოტისთვის, რაც უზრუნველყოფს მის ეფექტურ
ConTextual: ახალი მონაცემთა ნაკრები LMM-ების შესაფასებლად კონტექსტზე მგრძნობიარე, ტექსტ-მდიდარი ვიზუალური მსჯელობის ამოცანებში
კალიფორნიის უნივერსიტეტის (ლოს-ანჯელესი) მკვლევრებმა შექმნეს ConTextual – მონაცემთა ნაკრები, რომელიც განკუთვნილია მსხვილი მულტიმოდალური მოდელების (LMMs) შესაფასებლად კონტექსტზე მგრძნობიარე, ტექსტ-მდიდარი ვიზუალური მსჯელობის ამოცანებში. არსებული შეფასებები ხშირად უგულებელყოფს ამ რთულ სცენარებს, რის გამოც ConTextual გვთავაზობს 506 გამოწვევას ტექსტსა და ვიზუალურ მინიშნებებზე ერთობლივი მსჯელობისთვის, რათა დადგინდეს მოდელების რეალური შესაძლებლობები. გამოქვეყნებულია ლიდერბორდიც, რაც ხელს შეუწყობს მოდე
კოსმოპედია: უპრეცედენტო სინთეზური მონაცემები დიდი ენობრივი მოდელებისთვის
სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) წვრთნისთვის ძვირადღირებული ადამიანური ანოტაციებიდან სინთეზურ მონაცემთა ნაკრებებზე გადასვლას. მიუხედავად იმისა, რომ Microsoft-ის Phi მოდელებმა სინთეზური მონაცემების გამოყენებით შესანიშნავი შედეგები აჩვენეს, მათი შექმნის დეტალები გაუმჟღავნებელი დარჩა. ამ ხარვეზის აღმოსაფხვრელად, წარმოდგენილია კოსმოპედია – უმსხვილესი ღია სინთეზური მონაცემთა ნაკრები (30 მილიონზე მეტი ფაილი, 25 მილიარდი „ტოკენი“), რომელიც გენერირებულია Mixtral-8x7B-Instruct-v0.1-ის მიერ

Sentence Transformers: სრული გზამკვლევი მოდელების ტრენინგისა და ოპტიმიზაციისთვის
ეს სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Sentence Transformers-ის მოდელების ვარჯიშისა და ოპტიმიზაციის შესახებ. განხილულია მოდელის არქიტექტურა, ემბედინგების შექმნა და მონაცემთა მომზადების გადამწყვეტი როლი, მათ შორის სხვადასხვა მონაცემთა ნაკრების ფორმატები, როგორებიცაა მსგავსება, პოზიტიური წყვილები, კლასიფიკაცია და ტრიპლეტები. ასევე აღწერილია მონაცემების მოდელისთვის გასაგებ ფორმატში კონვერტირების პროცესი.

ხელოვნური ინტელექტი უჯრედის მოდელირებაში: გენის გაჩუმების ეფექტის პროგნოზირება CRISPR-ით
„ვირტუალური უჯრედის გამოწვევა“ მიზნად ისახავს ისეთი ხელოვნური ინტელექტის მოდელის შექმნას, რომელიც შეძლებს CRISPR-ის გამოყენებით გენის გაჩუმების შედეგად უჯრედზე მიღებული ეფექტების პროგნოზირებას, ფიზიკური, ძვირადღღირებული ექსპერიმენტების საჭიროების გარეშე. გამოწვევისთვის Arc-მა შეაგროვა 300 ათასი ერთუჯრედოვანი რნმ სეკვენირების პროფილის მონაცემთა ნაკრები. ამ პროცესში მნიშვნელოვანი სირთულეებია უჯრედის მდგომარეობის გაზომვის შეუძლებლობა ცვლილებამდე და მის შემდეგ, რაც მოითხოვს საკონტროლო უჯრედების გამო
AI-ის როლი გენის გაჩუმების პროგნოზირებაში: ვირტუალური უჯრედის გამოწვევა
თანამედროვე კვლევები მიზნად ისახავს ხელოვნური ინტელექტის (AI) მოდელის შექმნას, რომელიც CRISPR-ის გამოყენებით გენის გაჩუმების უჯრედზე ზემოქმედებას იწინასწარმეტყველებს. „ვირტუალური უჯრედის გამოწვევა“ ცდილობს გადალახოს ფიზიკური ექსპერიმენტების სირთულეები და მაღალი ღირებულება, რაც საშუალებას მისცემს ათასობით წამლის კანდიდატის ტესტირებას ვირტუალურ გარემოში. Arc-ის მიერ შეგროვებული 300 ათასი ერთუჯრედოვანი რნმ-ის სექვენირების პროფილის მონაცემთა ნაკრები გამოიყენება ნერვული ქსელების სავარჯიშოდ. სტატია ას

ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.
JAT: ხელოვნური ინტელექტის ახალი ეტაპი – უნივერსალური აგენტი
პროექტი „ჯეკი ყველა ხელობაში“ (JAT) მიზნად ისახავს გენერალისტი AI აგენტის შექმნას, Gato-ს ნამუშევრის რეპროდუცირებითა და გაუმჯობესებით. JAT იყენებს მულტიმოდალურ ტრანსფორმერულ მოდელებს თანმიმდევრული მონაცემების დასამუშავებლად. პროექტის შედეგად შეიქმნა ექსპერტული აგენტების მონაცემთა ნაკრები და თავად JAT მოდელი, რომელმაც სხვადასხვა ამოცანაზე ექსპერტული შესრულების 65.8% საშუალო შედეგი აჩვენა, რაც მის მრავალმხრივობას ადასტურებს.
JAT: ხელოვნური ინტელექტის ახალი მიღწევა ზოგადი დანიშნულების აგენტების შექმნაში
პროექტი Jack of All Trades (JAT) წარმოადგენს მნიშვნელოვან ნაბიჯს ზოგადი დანიშნულების ხელოვნური ინტელექტის აგენტების შემუშავებაში. Gato-ს ნაშრომზე დაფუძნებული JAT იყენებს მულტიმოდალურ ტრანსფორმერულ მოდელებს, რომლებსაც შეუძლიათ შეასრულონ ხედვის, ენისა და გადაწყვეტილების მიღების ამოცანები. პროექტის ფარგლებში შეიქმნა JAT მონაცემთა ნაკრები, რომელიც მოიცავს ექსპერტი აგენტების მიერ შეგროვებულ ასობით ათას ტრაექტორიას სხვადასხვა გარემოდან. JAT-ის არქიტექტურა, თავისი უნიკალური ჩაშენების მექანიზმით, შექმნი
Hub-ზე მოდელებისა და მონაცემთა ნაკრებისთვის DOI-ის გენერირება ახლა უკვე შესაძლებელია!
მომხმარებლებს Hub-ზე უკვე შეუძლიათ მოდელებისა და მონაცემთა ნაკრებისთვის ციფრული ობიექტის იდენტიფიკატორების (DOI) გენერირება უშუალოდ თავიანთი რეპოზიტორიუმის პარამეტრებიდან. ეს სიახლე აადვილებს ნამუშევრების ციტირებას, უზრუნველყოფს მათ მუდმივ ხელმისაწვდომობას და ხელს უწყობს სამეცნიერო საზოგადოებაში გავრცელებას. ფუნქცია განხორციელდა DataCite-თან პარტნიორობით და ითვალისწინებს DOI-ის განახლების შესაძლებლობას ახალი ვერსიებისთვის.

NVIDIA-მ 6 მილიონიანი მულტილინგვური მსჯელობის მონაცემთა ნაკრები და Nemotron Nano 2 9B გამოუშვა
NVIDIA განაგრძობს ღია ეკოსისტემის მხარდაჭერას 6 მილიონიანი მულტილინგვური მსჯელობის მონაცემთა ნაკრების გამოშვებით, რომელიც ხუთ ენაზეა ნათარგმნი. ამასთან ერთად, წარდგენილია Nemotron Nano 2 9B მოდელი, რომელიც ხელოვნური ინტელექტის შესაძლებლობებს გაუმჯობესებული არქიტექტურითა და კონფიგურირებადი შესრულებით ზღვრულ მოწყობილობებზე აფართოებს. ეს ნაბიჯი ხაზს უსვამს კომპანიის ერთგულებას მოდელების განვითარებაში ღიაობისა და გამჭვირვალობის მიმართ.

SAIR: მონაცემთა ნაკრები, რომელიც რევოლუციას ახდენს ხელოვნური ინტელექტით წამლების დიზაინში
SAIR არის ღია კოდის მონაცემთა ნაკრები, რომელიც უფასოდ არის ხელმისაწვდომი CC BY 4.0 ლიცენზიით, რაც მას მყისიერად გამოსაყენებელს ხდის კომერციული და არაკომერციული კვლევა-განვითარების მიმართულებებისთვის. იგი წარმოადგენს სტრატეგიულ აქტივს, რომელიც ავსებს მონაცემთა დიდი ხნის არსებულ ხარვეზს ხელოვნური ინტელექტის (AI) მეშვეობით წამლების დიზაინში. SAIR აძლიერებს ფარმაცევტულ, ბიოტექნოლოგიურ და ტექ-ბიო ლიდერებს კვლევა-განვითარების დასაჩქარებლად, სამიზნე ჰორიზონტების გასაფართოებლად და AI მოდელების გასაძლიერ