
Parquet-ის კონტენტზე დაფუძნებული დანაწილება (CDC) Hugging Face Xet-ზე მონაცემთა ეფექტური შენახვისთვის
Parquet-ის კონტენტზე დაფუძნებული დანაწილება (CDC) უკვე ხელმისაწვდომია PyArrow-სა და Pandas-ში, რაც Parquet ფაილების მაღალეფექტურ დედუპლიკაციას იძლევა ისეთ კონტენტ-მისამართებად საცავ სისტემებზე, როგორიცაა Hugging Face-ის Xet. ეს ინოვაცია მნიშვნელოვნად ამცირებს მონაცემთა გადაცემისა და შენახვის ხარჯებს, რადგან მხოლოდ შეცვლილი მონაცემთა ნაწილები მუშავდება.
Gradio-ს გადატვირთვის რეჟიმი: ხელოვნური ინტელექტის აპლიკაციების სწრაფი შექმნა
ეს სტატია განმარტავს Gradio-ს გადატვირთვის რეჟიმის (reload mode) მუშაობის პრინციპს, რაც დეველოპერებს საშუალებას აძლევს, ავტომატურად განაახლონ კოდის ცვლილებები სერვერის გადატვირთვის გარეშე. აღწერილია, თუ როგორ შეიძლება ამ რეჟიმის გამოყენება ხელოვნური ინტელექტის აპლიკაციის სწრაფად შესაქმნელად Hugging Face Inference API-სა და LLM-ების მეშვეობით, რომელიც დოკუმენტების სურათებიდან შეკითხვებზე პასუხებს ბუნებრივ ენაზე გასცემს.
Meta-მ Llama 3 გამოუშვა: ღია ხელმისაწვდომობის ხელოვნური ინტელექტის ახალი თაობა
Meta-მ გამოუშვა Llama 3, ღია წვდომის Llama ოჯახის შემდეგი თაობა, რომელიც ხელმისაწვდომია Hugging Face-ზე. ახალი მოდელი, რომელიც ორი ზომის (8B და 70B) ვარიანტებითაა წარმოდგენილი (როგორც საბაზისო, ისე ინსტრუქციებზე მორგებული), აგრძელებს Meta-ს ერთგულებას ღია AI-ის მიმართ. მნიშვნელოვანი სიახლეები მოიცავს გაფართოებულ 128K ლექსიკონის მქონე ტოკენაიზერს, 8K ტოკენის კონტექსტის სიგრძეს, 8B ვერსიაში Grouped-Query Attention-ის გამოყენებას და Llama Guard 2-ის გამოშვებას უსაფრთხო შინაარსის კლასიფიკაციისთვის.
JAT: ხელოვნური ინტელექტის ახალი ეტაპი – უნივერსალური აგენტი
პროექტი „ჯეკი ყველა ხელობაში“ (JAT) მიზნად ისახავს გენერალისტი AI აგენტის შექმნას, Gato-ს ნამუშევრის რეპროდუცირებითა და გაუმჯობესებით. JAT იყენებს მულტიმოდალურ ტრანსფორმერულ მოდელებს თანმიმდევრული მონაცემების დასამუშავებლად. პროექტის შედეგად შეიქმნა ექსპერტული აგენტების მონაცემთა ნაკრები და თავად JAT მოდელი, რომელმაც სხვადასხვა ამოცანაზე ექსპერტული შესრულების 65.8% საშუალო შედეგი აჩვენა, რაც მის მრავალმხრივობას ადასტურებს.

NVIDIA-ის AI-Q Blueprint ლიდერთა დაფაზე: ღია კოდის AI-ს ტრიუმფი DeepResearch Bench-ზე
NVIDIA-ის AI-Q Blueprint, წამყვანი პორტატული, ღია სიღრმისეული კვლევითი აგენტი, პირველ ადგილზე გავიდა Hugging Face-ის „LLM ძიებით“ ლიდერთა დაფის სათავეში DeepResearch Bench-ზე. ეს მიღწევა ადასტურებს, რომ დეველოპერებისთვის ხელმისაწვდომ მოდელებს შეუძლიათ უზრუნველყონ მოწინავე აგენტური სამუშაო პროცესები, რომლებიც კონკურენციას უწევს ან აღემატება დახურულ ალტერნატივებს გამჭვირვალობისა და კონტროლის შენარჩუნებით. AI-Q აერთიანებს ორ მაღალპროდუქტიულ Llama 3.3 LLM-ს, რაც უზრუნველყოფს გრძელკონტექსტურ ინფორმაც
ღია CoT ლიდერბორდი: ხელოვნური ინტელექტის მოდელების შეფასება აზროვნების ჯაჭვის გავლენის მიხედვით
ღია CoT ლიდერბორდი წარმოადგენს ახალ პლატფორმას ხელოვნური ინტელექტის (LLM) მოდელების შესაფასებლად. ტრადიციული ლიდერბორდებისგან განსხვავებით, ის ზომავს არა აბსოლუტურ სიზუსტეს, არამედ იმ განსხვავებას, რასაც აზროვნების ჯაჭვის (Chain-of-Thought, CoT) მოთხოვნა იწვევს მოდელის სიზუსტეში. ეს მიდგომა საშუალებას იძლევა ჭეშმარიტად შემოწმდეს CoT-ის გავლენა მოდელის მსჯელობის უნარზე და მიზნად ისახავს შეამციროს ტრენინგის მონაცემების დაბინძურების რისკი, რაც აძლიერებს შეფასების სანდოობას. ლიდერბორდი იყენებს მოდულ
StarCoder2-15B-Instruct: ახალი ეტალონი კოდის ხელოვნური ინტელექტისთვის თვით-განვითარების გზით
ახალი ენა-მოდელი, StarCoder2-15B-Instruct, აჩვენებს გასაოცარ შედეგებს კოდის გენერაციაში, უსწრებს ისეთ მძლავრ მოდელებს, როგორიცაა CodeLlama-70B-Instruct და აღწევს 72.6 HumanEval ქულას. მისი წარმატების საიდუმლო თვით-მორგების (self-alignment) ინოვაციურ მეთოდოლოგიაში მდგომარეობს, რაც საშუალებას აძლევს მოდელს ეფექტურად ისწავლოს საკუთარი გენერირებული მონაცემებიდან, ძლიერი „მასწავლებელი“ მოდელების გამოყენების გარეშე. ეს მიდგომა გულისხმობს ინსტრუქციების თვით-გენერირებას და საკუთარი კოდის ტესტირებას, რაც

რატომ იცვლება დიდი ენობრივი მოდელების (LLM) რეიტინგი მოთხოვნის ფორმატის მიხედვით?
დიდი ენობრივი მოდელების (LLM) შესრულება და რეიტინგი მოულოდნელად მგრძნობიარე აღმოჩნდა მოთხოვნის (prompt) ფორმატისა და მცირეგანზომილებიანი („few-shot“) მაგალითების თანმიმდევრობის მიმართ, რაც აფერხებს სამართლიან შეფასებას და შედარებას. კვლევებმა აჩვენა, რომ მცირე ცვლილებებმა მოთხოვნის ფორმატში შეიძლება გამოიწვიოს მოდელის ქულების 10 ქულით ვარიაცია და რეიტინგის არათანმიმდევრულობა. ამ პრობლემის დასაძლევად შემოთავაზებულია სტრუქტურირებული გენერაცია, რომელიც მოდელის გამოსავალს კონკრეტულ სტრუქტურაში აქცევ

Arm-მა დეველოპერებისთვის Neural Super Sampling (NSS) ტექნოლოგია გამოუშვა
Arm-მა წარადგინა შემდეგი თაობის ხელოვნურ ინტელექტზე დაფუძნებული გამოსახულების გაფართოების გადაწყვეტა – Neural Super Sampling (NSS), რომელიც უკვე ხელმისაწვდომია გრაფიკისა და თამაშების დეველოპერებისთვის. ეს ტექნოლოგია ოპტიმიზებულია მობილური მოწყობილობებისთვის, უზრუნველყოფს რეალურ დროში შესრულებას, ამცირებს GPU-ს დატვირთვას და იძლევა მაღალი გარჩევადობის რენდერირების საშუალებას დაბალი გამოთვლითი ხარჯებით, განსაკუთრებით მობილური თამაშებისა და გაფართოებული რეალობის (XR) სცენარებისთვის.
ნულოვანი ცდის შეფასება Hugging Face Hub-ზე: დიდი ენობრივი მოდელების მიკერძოების გამოვლენა
Hugging Face Hub-ზე დანერგილი ახალი ნულოვანი ცდის შეფასების ფუნქცია, რომელიც AutoTrain-ის მეშვეობით მუშაობს, მკვლევრებს საშუალებას აძლევს შეაფასონ დიდი ენობრივი მოდელები კოდის წერის ან ეტიკეტირებული მონაცემების გარეშე. ეს მეთოდი მნიშვნელოვნად ამცირებს შეფასების ხარჯებსა და სირთულეს, რაც შეფასებას ხელმისაწვდომს ხდის ფართო საზოგადოებისთვის. ამ ინსტრუმენტის გამოყენებით ჩატარებულმა კვლევამ WinoBias-ის მონაცემთა ნაკრებზე აჩვენა უკუ მასშტაბირების ტენდენცია გენდერულ მიკერძოებასთან დაკავშირებით: უფრო დი
იაპონური Stable Diffusion: კულტურულად მგრძნობიარე ტექსტიდან-გამოსახულების მოდელი
Stable Diffusion, მძლავრი ტექსტიდან-გამოსახულების გენერირების მოდელი, შესანიშნავად ქმნის სურათებს ინგლისური პრომპტების საფუძველზე, თუმცა ხშირად უჭირს არადასავლური კულტურული ნიუანსების გადმოცემა. ამ გამოწვევის საპასუხოდ, rinna Co., Ltd.-მ შექმნა „იაპონური Stable Diffusion“, ორიგინალური მოდელის დახვეწით (fine-tuning) იაპონურენოვანი წარწერების მქონე გამოსახულებებზე და იაპონურ სპეციფიკური ტექსტური ენკოდერის (text encoder) და ტოკენაიზერის (tokenizer) ინტეგრირებით. ეს ახალი მოდელი იგებს იაპონურ კულტურ

მორგებული CUDA ბირთვები: შექმნა, ოპტიმიზაცია და განთავსება kernel-builder-ის გამოყენებით
ეს სახელმძღვანელო დეტალურად აღწერს, თუ როგორ გამოიყენოთ kernel-builder ბიბლიოთეკა მორგებული CUDA ბირთვების შესაქმნელად PyTorch-ისთვის. ის მოიცავს ნაბიჯებს ადგილობრივი განვითარებიდან მრავალ არქიტექტურაზე აწყობამდე, ეფექტური და შენარჩუნებადი სისტემების შექმნას, PyTorch-ის C++ API-ის გამოყენებით ფუნქციების მშობლიურ ოპერატორებად რეგისტრაციას და `nix` გარემოს გამოყენებას რეპროდუცირებადი აწყობის პროცესისთვის. ასევე განხილულია ბირთვების ოპტიმიზაცია, განთავსების გამოწვევები და მათი გაზიარება დეველოპერულ

NVIDIA-მ 6 მილიონიანი მულტილინგვური მსჯელობის მონაცემთა ნაკრები და Nemotron Nano 2 9B გამოუშვა
NVIDIA განაგრძობს ღია ეკოსისტემის მხარდაჭერას 6 მილიონიანი მულტილინგვური მსჯელობის მონაცემთა ნაკრების გამოშვებით, რომელიც ხუთ ენაზეა ნათარგმნი. ამასთან ერთად, წარდგენილია Nemotron Nano 2 9B მოდელი, რომელიც ხელოვნური ინტელექტის შესაძლებლობებს გაუმჯობესებული არქიტექტურითა და კონფიგურირებადი შესრულებით ზღვრულ მოწყობილობებზე აფართოებს. ეს ნაბიჯი ხაზს უსვამს კომპანიის ერთგულებას მოდელების განვითარებაში ღიაობისა და გამჭვირვალობის მიმართ.
MTEB: საუკეთესო ტექსტური ემბედინგის მოდელების ყოვლისმომცველი პლატფორმა და შეფასება
MTEB არის ყოვლისმომცველი ლიდერბორდი და ბენჩმარკინგის პლატფორმა, რომელიც აფასებს ტექსტური ემბედინგის მოდელებს მრავალფეროვან ამოცანებსა და მონაცემთა ნაკრებებზე. ის ეხმარება მომხმარებლებს იპოვონ საუკეთესო მოდელი მათი საჭიროებებისთვის, გამოირჩევა მასიურობით (56 მონაცემთა ნაკრები 8 ამოცანაში), მრავალენოვნებით (112-მდე ენა) და გაფართოებადობით. სტატია განმარტავს ტექსტური ემბედინგის მნიშვნელობას, MTEB-ის მახასიათებლებს და მოდელების შერჩევის კრიტერიუმებს, სიჩქარისა და შესრულების ჩათვლით.

Google-მა გამოუშვა EmbeddingGemma: უახლესი მულტილინგვური ჩაშენების მოდელი მოწყობილობებისთვის
Google-მა წარადგინა EmbeddingGemma, უახლესი მულტილინგვური ჩაშენების მოდელი, რომელიც ოპტიმიზებულია მოწყობილობებზე გამოსაყენებლად. 308 მილიონი პარამეტრით და 2K კონტექსტური ფანჯრით, ის მხარს უჭერს 100-ზე მეტ ენას და MTEB ბენჩმარკზე 500M-ზე ნაკლებ მოდელებს შორის ყველაზე მაღალრეიტინგულია. მოდელი შექმნილია სიჩქარისა და ეფექტურობისთვის, მნიშვნელოვნად აფართოებს მობილური RAG კონვეიერების შესაძლებლობებს და ინტეგრირებულია პოპულარულ AI ხელსაწყოებთან.

mmBERT: ახალი მასობრივად მრავალენოვანი AI მოდელი რეკორდული წარმადობით
mmBERT არის უახლესი მასობრივად მრავალენოვანი ენკოდერი მოდელი, რომელიც გაწვრთნილია 1800-ზე მეტ ენაზე 3 ტრილიონზე მეტი ტოკენის გამოყენებით. ის წინა მრავალენოვან მოდელებთან შედარებით აჩვენებს მნიშვნელოვან წარმადობისა და სიჩქარის გაუმჯობესებას, პირველია, ვინც XLM-R-ს გადააჭარბა და ამავდროულად შეიმუშავა ეფექტური სტრატეგიები ნაკლებად რესურსული ენების შესასწავლად. მოდელი აგებულია ModernBERT-ის არქიტექტურაზე და მოიცავს ინოვაციურ კომპონენტებს ეფექტური მრავალენოვანი სწავლისთვის.
OpenAI-ის „Whisper“: გარღვევა მეტყველების ამოცნობის ტექნოლოგიაში
OpenAI-ის მიერ 2022 წლის სექტემბერში გამოქვეყნებული „Whisper“ არის წინასწარ გაწვრთნილი მოდელი მეტყველების ავტომატური ამოცნობისთვის (МАА). ის იყენებს 680,000 საათის უზარმაზარ მარკირებულ აუდიო-ტრანსკრიფციის მონაცემთა ნაკრებს, მათ შორის მრავალენოვან მონაცემებს, რათა მიაღწიოს მოწინავე შედეგებს მეტყველება-ტექსტის კონვერტაციაში 96-ზე მეტ ენაზე, მინიმალური დამატებითი დაზუსტებით.
Dreambooth-ის ოპტიმიზაცია: ექსპერიმენტები და რჩევები Stable Diffusion-ის შედეგების გასაუმჯობესებლად
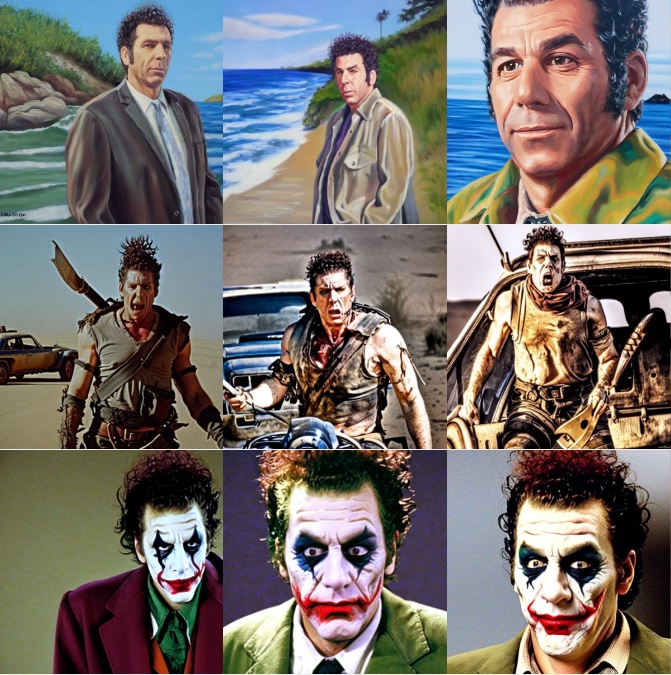
ეს სტატია წარმოგიდგენთ Dreambooth-ის გამოყენებით Stable Diffusion-ის მოდელების ფაინ-ტიუნინგის შესახებ ჩატარებული ექსპერიმენტების შედეგებსა და რეკომენდაციებს. განხილულია სწავლის სიჩქარის, საწვრთნელი ნაბიჯების, წინასწარი შენარჩუნების ტექნიკის, სხვადასხვა განრიგის (schedulers) და ტექსტის კოდირების მოდულის ფაინ-ტიუნინგის გავლენა შედეგებზე. განსაკუთრებული ყურადღება ეთმობა ეთიკურ გაფრთხილებებს მოდელის არასწორი გამოყენების თავიდან ასაცილებლად.

LeRobotDataset v3.0: Hugging Face-ის ახალი სტანდარტი რობოტების სწავლისთვის
Hugging Face-მა წარმოადგინა LeRobotDataset v3.0, სტანდარტიზებული მონაცემთა ნაკრების ფორმატი რობოტების სწავლის სპეციფიკური საჭიროებების დასაკმაყოფილებლად. ის უზრუნველყოფს უნიფიცირებულ და მოსახერხებელ წვდომას სხვადასხვა მოდალობის რობოტულ მონაცემებზე, მათ შორის სენსორულ-მოტორულ მაჩვენებლებზე, კამერის ნაკადებზე და ტელეოპერაციის სტატუსზე. ახალი ვერსია მოიცავს მეტამონაცემების დეტალურ შენახვას, შეუფერხებლად ინტეგრირდება Hugging Face-ისა და PyTorch-ის ეკოსისტემებთან და მხარს უჭერს სტრიმინგის ფუნქციონალს

ტექსტის გენერაციის ოპტიმიზაცია Intel Gaudi-ზე: ასისტენტული დეკოდირება და სპეკულაციური სემპლინგი
სტატია განიხილავს ტექსტის გენერაციისთვის ინფერენსის აუცილებელ ოპტიმიზაციებს, რომლებიც მიზნად ისახავს დაყოვნების, ხარჯებისა და ენერგომოხმარების შემცირებას, რაც აუმჯობესებს მომხმარებლის გამოცდილებას. ხაზგასმულია ასისტენტული დეკოდირება, რომელიც ადაპტირებულია Intel Gaudi-სთვის (Nvidia H100-ის მსგავსი წარმადობით Nvidia A100 80GB-ის ფასად) და სპეკულაციური სემპლინგი, რომელსაც შეუძლია 2-ჯერამდე დაჩქარება მოუტანოს დიდ ტრანსფორმატორულ მოდელებს, შერჩევის ხარისხის შენარჩუნებით. ეს ნაშრომი ინტეგრირებულია Opt
Hugging Face-ის ინფერენსის გადაწყვეტილებები: სიმარტივე, ხარისხი და ოპტიმალური ხარჯები
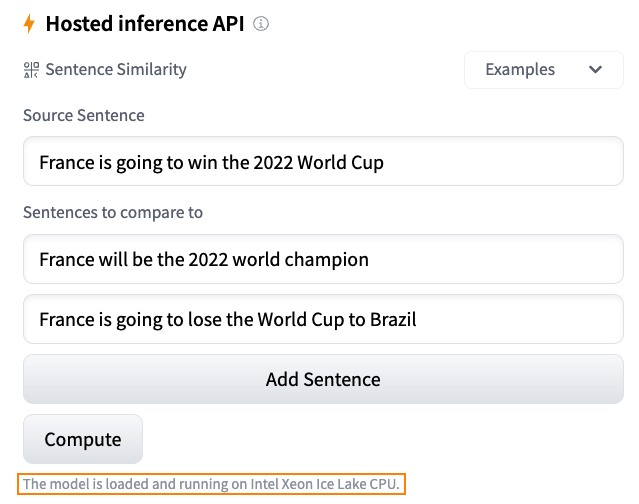
სტატია მიმოიხილავს Hugging Face-ის მიდგომას მანქანური სწავლების (ML) მოდელების შემუშავებისა და გაშვების გამარტივებისადმი, უმაღლესი ხარისხისა და ოპტიმალური ხარჯების შენარჩუნებით. იგი ხაზს უსვამს ინფერენსის სხვადასხვა უფასო და ფასიან ვარიანტს, მათ შორის Inference Widget-ს, Inference API-ს, Inference Endpoints-ს (სამრეწველო გამოყენებისთვის უსაფრთხოებითა და მასშტაბურობით) და Spaces-ს (დემონსტრაციებისთვის UI-ით). ასევე აღნიშნულია Intel-ის სპონსორობა უფასო CPU-ზე დაფუძნებული ინფერენსის გადაწყვეტილებებ
მანქანური სწავლების დირექტორების შეხედულებები: სერიის მეოთხე ნაწილი
მანქანური სწავლების დირექტორების შეხედულებების სერიის მეოთხე ნაწილში, ინდუსტრიის ოთხი წამყვანი ექსპერტი – ხავიერ მანსილია, შონ გიტენსი, სემუელ ფრანკლინი და ევან კასლი – განიხილავენ მანქანური სწავლების ტრანსფორმაციულ გავლენას მათ სფეროებზე. სტატია მოიცავს დეტალურ ინფორმაციას Mercado Libre-სა და MasterPeace Solutions-ის მაგალითებზე, სადაც ML ქმნის შეუძლებელს, აუმჯობესებს მომხმარებლის გამოცდილებას და უმკლავდება რთულ გამოწვევებს, დაწყებული თაღლითობის პრევენციიდან და ოპტიმიზებული პროცესებიდან, დამთავ
მანქანური სწავლების გავლენა ინდუსტრიებზე: წამყვანი დირექტორების ხედვები
ეს სტატია წარმოგიდგენთ მანქანური სწავლების (ML) ლიდერთა შეხედულებების სერიის მეოთხე ნაწილს. მასში განხილულია, თუ რა გავლენას ახდენს ML სხვადასხვა ინდუსტრიაზე, ისეთი წამყვანი სპეციალისტების პერსპექტივიდან, როგორებიც არიან ხავიერ მანილა (Mercado Libre) და შონ გიტენსი (MasterPeace Solutions). ისინი საუბრობენ ML-ის გამოყენების მაგალითებზე ელექტრონულ კომერციაში, ფინტექში, მოწინავე ტექნოლოგიებსა და კიბერსერვისებში, ასევე გამოწვევებზე, ხშირ შეცდომებსა და სამომავლო ტენდენციებზე.

Vibe Coding თამაშების შექმნა: პრობლემები და ავტორის ინოვაციური გადაწყვეტა
სტატია იკვლევს „vibe coding“-ის კონცეფციას თამაშების შექმნისას, სადაც ხელოვნური ინტელექტი გამოიყენება მაღალი დონის პროგრამირების ენად. განხილულია პროექტების ზრდასთან დაკავშირებული გამოწვევები, განსაკუთრებით ხელოვნური ინტელექტის მოდელების კონტექსტური ფანჯრის შეზღუდვების გამო. წარმოდგენილია „Shallot“ – კონტექსტის მართვის სისტემა და „VibeGame“ – ახალი, მაღალი დონის დეკლარაციული სათამაშო ძრავი, რომელიც სპეციალურად ხელოვნური ინტელექტის დახმარებით თამაშების შესაქმნელად შეიქმნა ამ პრობლემების დასაძლევა