
KV ქეშირება nanoVLM-ში: 38%-იანი აჩქარება გენერაციაში
ეს ბლოგ-პოსტი აღწერს KV ქეშირების ტექნიკას, რომელიც nanoVLM საცავში ნულიდან დავნერგეთ და რომელმაც ენობრივი მოდელების გენერაციაში 38%-იანი აჩქარება მოგვცა. სტატია განმარტავს ავტორეგრესიულ მოდელებში გამოთვლითი სიჭარბის პრობლემას და იმას, თუ როგორ აგვარებს მას KV ქეშირება Q, K, V მნიშვნელობების შენახვით. მოცემულია თეორიული საფუძვლები, nanoVLM-ში პრაქტიკული იმპლემენტაცია და ზოგადი გაკვეთილები, რომლებიც ყველა ავტორეგრესიული ენობრივი მოდელის გენერაციას ეხება. ეს ოპტიმიზაცია აუცილებელია LLM-ების ეფექტუ
TAPEX: რევოლუციური მიდგომა ცხრილის წინასწარი ვარჯიშისთვის ნერვული SQL შემსრულებლის მეშვეობით
ნაშრომში „TAPEX: ცხრილის წინასწარი ვარჯიში ნერვული SQL შემსრულებლის სწავლით“ წარმოდგენილია ინოვაციური მეთოდი, რომელიც იყენებს სინთეზურ მონაცემებს და ნერვულ SQL შემსრულებელს ცხრილების წინასწარი ვარჯიშისთვის. ეს მიდგომა უზრუნველყოფს პროგრამების მრავალფეროვნებასა და მასშტაბს, რაც გაუვალია ბუნებრივი ენის მოდელებისთვის. TAPEX-მა აჩვენა რეკორდული შედეგები სხვადასხვა ამოცანებზე, მათ შორის ცხრილის კითხვებზე პასუხის გაცემასა და ფაქტების გადამოწმებაზე, რითაც მნიშვნელოვნად აჯობა წინა მეთოდებს და მიაღწია 50

NVIDIA Isaac GR00T N1.5: ინტელექტუალური რობოტების შექმნის ახალი ეტაპი
NVIDIA-მ გამოაცხადა Isaac GR00T N1.5-ის გამოშვება, რომელიც წარმოადგენს მსოფლიოში პირველი ღია ფუნდამენტური მოდელის, Isaac GR00T N1-ის, უმნიშვნელოვანეს განახლებას განზოგადებული ჰუმანოიდური რობოტების მსჯელობისა და უნარებისთვის. ეს პლატფორმა შექმნილია ინტელექტუალური, ადაპტირებადი რობოტების შექმნის დასაჩქარებლად, მრავალმხრივი შეყვანის (ენა, გამოსახულებები) დამუშავებით და მრავალფეროვან გარემოში მანიპულაციური ამოცანების შესასრულებლად. GR00T N1.5 ახლა ხელმისაწვდომია დეველოპერებისთვის, რაც მათ საშუალებას
მანქანური სწავლება ფინანსურ სექტორში: გამოწვევები, ნდობა და ინოვაციების როლი
სტატია განიხილავს მანქანური სწავლების (ML) დირექტორების უნიკალურ გამოწვევებს ფინანსურ სექტორში, მათ შორის მოძველებული სისტემების მართვას, მოდელების ინტერპრეტაციას და მომხმარებელთა ნდობის შენარჩუნებას მკაცრი რეგულაციების პირობებში. ხაზგასმულია, თუ როგორ გამოიწვია ML-მა დისკუსიები ფინანსურ გადაწყვეტილებებში ნდობის შესახებ და გახდა გარდამტეხი ძალა, რამაც ახალი ბიზნეს შესაძლებლობები შექმნა. წამყვანი ფინანსური ინსტიტუტების ექსპერტები იზიარებენ თავიანთ შეხედულებებს ამ გამოწვევებზე, განსაკუთრებით მოძვე
მანქანური სწავლება ფინანსებში: გამოწვევები, ნდობა და ექსპერტების შეხედულებები
ფინანსური სექტორის მანქანური სწავლების დირექტორები უნიკალური გამოწვევების წინაშე დგანან, მათ შორის მოძველებული სისტემების მართვა, ინტერპრეტირებადი მოდელების დანერგვა და მომხმარებლის ნდობის შენარჩუნება მკაცრი რეგულაციების პირობებში. ეს სტატია წარმოადგენს წამყვანი ექსპერტების შეხედულებებს U.S. Bank-დან, კანადის სამეფო ბანკიდან, Moody's Analytics-დან და Bloomberg AI-დან. ისინი განიხილავენ მანქანური სწავლების ტრანსფორმაციულ ძალას, ფინანსურ გადაწყვეტილებებში ნდობის შესახებ მიმდინარე დისკუსიას და იმ ს
წარმოგიდგენთ StarCoder2-ს: ინოვაცია პროგრამირების ენობრივ მოდელებში
StarCoder2 არის ღია კოდის დიდი ენობრივი მოდელების (LLM) ოჯახი, შექმნილი კოდის გენერაციისა და ანალიზისთვის. ის ხელმისაწვდომია სამი ზომის ვარიანტში – 3B, 7B და 15B პარამეტრით. ფლაგმანი StarCoder2-15B მოდელი გაწვრთნილია 4 ტრილიონზე მეტ ტოკენსა და 600-ზე მეტ პროგრამირების ენაზე The Stack v2 მონაცემთა ბაზიდან, რაც მას თავის ზომის კლასში საუკეთესოდ აქცევს და კონკურენციას უწევს 33B+ ზომის მოდელებს. პროექტი არის BigCode-ის თანამშრომლობის ნაწილი, რომელიც მიზნად ისახავს კოდისთვის განკუთვნილი LLM-ების პასუ
ემბედინგები: ხელოვნური ინტელექტის მრავალფუნქციური ინსტრუმენტი სემანტიკური ძიებისთვის
ეს სტატია განმარტავს „ემბედინგების“ კონცეფციას – ინფორმაციის (ტექსტი, სურათი, აუდიო) რიცხვით წარმოდგენას, რომელიც მის სემანტიკურ მნიშვნელობას იჭერს. განხილულია ემბედინგების ძირითადი გამოყენება ხელოვნური ინტელექტის აპლიკაციებში, როგორიცაა საძიებო სისტემები, რეკომენდაციის სისტემები და ჩატბოტები, რაც შესაძლებელს ხდის სემანტიკური მსგავსების შეფასებას. სტატია დეტალურად აღწერს, თუ როგორ შეიძლება ემბედინგების გენერირება ღია კოდის ინსტრუმენტების, მაგალითად, Sentence Transformers ბიბლიოთეკისა და Hugging
ConTextual: ახალი მონაცემთა ნაკრები LMM-ების შესაფასებლად კონტექსტზე მგრძნობიარე, ტექსტ-მდიდარი ვიზუალური მსჯელობის ამოცანებში
კალიფორნიის უნივერსიტეტის (ლოს-ანჯელესი) მკვლევრებმა შექმნეს ConTextual – მონაცემთა ნაკრები, რომელიც განკუთვნილია მსხვილი მულტიმოდალური მოდელების (LMMs) შესაფასებლად კონტექსტზე მგრძნობიარე, ტექსტ-მდიდარი ვიზუალური მსჯელობის ამოცანებში. არსებული შეფასებები ხშირად უგულებელყოფს ამ რთულ სცენარებს, რის გამოც ConTextual გვთავაზობს 506 გამოწვევას ტექსტსა და ვიზუალურ მინიშნებებზე ერთობლივი მსჯელობისთვის, რათა დადგინდეს მოდელების რეალური შესაძლებლობები. გამოქვეყნებულია ლიდერბორდიც, რაც ხელს შეუწყობს მოდე
UCLA-ს მკვლევრებმა LMM-ების შესაფასებლად კონტექსტზე მგრძნობიარე ვიზუალური ამოცანების ახალი მონაცემთა ბაზა – ConTextual შექმნეს
კალიფორნიის უნივერსიტეტის ლოს-ანჯელესის (UCLA) მკვლევრებმა წარმოადგინეს ConTextual – ინოვაციური მონაცემთა ბაზა, რომელიც მიზნად ისახავს დიდი მულტიმოდალური მოდელების (LMMs) კონტექსტზე მგრძნობიარე, ტექსტით მდიდარი ვიზუალური მსჯელობის შესაძლებლობების შეფასებას. ეს მონაცემთა ბაზა 506 რთულ ინსტრუქციას მოიცავს 8 რეალური სამყაროს სცენარში, რათა შეავსოს არსებული შეფასების მეთოდების ხარვეზები, რომლებიც ხშირად უგულებელყოფენ კონტექსტის გაგებას. პროექტის ფარგლებში ასევე შეიქმნა ლიდერბორდი, სადაც საზოგადოებას

მეჩხერი ჩაშენების მოდელების დახვეწა: ჰიბრიდული ძიება და სემანტიკური გაფართოება
ეს სტატია განმარტავს, თუ როგორ უნდა დავხვეწოთ მეჩხერი ენკოდერის/ჩაშენების მოდელები, რომლებიც განსაკუთრებით ეფექტურია ჰიბრიდული ძიებისა და მოძიებისა და ხელახალი რანჟირების სცენარებში. დეტალურად განიხილება მოდელის კომპონენტები, მონაცემთა ნაკრებები, დანაკარგის ფუნქციები, ტრენინგის არგუმენტები და შემფასებლები. ასევე მოცემულია შედარება მკვრივ ჩაშენებებთან და განხილულია მოთხოვნის/დოკუმენტის გაფართოების მნიშვნელობა, რაც ამ მოდელებს საშუალებას აძლევს, გაუმკლავდნენ სემანტიკურ შეუსაბამობებს და გააუმჯობესო
წარდგენა Quanto-სი: PyTorch-ის კვანტიზაციის ახალი ბეკენდი ხელოვნური ინტელექტის მოდელების ეფექტურობისთვის
Hugging Face წარმოგიდგენთ „quanto“-ს, PyTorch-ის კვანტიზაციის ახალ ბეკენდს Optimum-ისთვის, რომელიც შექმნილია ღრმა სწავლების მოდელების კვანტიზაციის გასამარტივებლად და სტანდარტიზებისთვის. Quanto მიზნად ისახავს მსხვილი ენობრივი მოდელების (LLM) უფრო ეფექტურს გახადოს სამომხმარებლო მოწყობილობებისთვის მეხსიერების შემცირებით და სპეციალიზებული აპარატურის ოპტიმიზაციების ჩართვით, გთავაზობთ მრავალმხრივ და მოწყობილობისგან დამოუკიდებელ გადაწყვეტას.

მაღალი წარმადობისა და საიმედოობის შენარჩუნება: Hugging Face-ის ინფრასტრუქტურის ძირითადი ინსტრუმენტები
ეს სტატია დეტალურად განიხილავს Hugging Face-ის წარმოების ინფრასტრუქტურის მხარდაჭერისთვის გამოყენებულ სამ ძირითად გაფრთხილებას, NAT კარიბჭეების მნიშვნელობას გამავალი ტრაფიკის მონიტორინგისთვის და ხარჯების ოპტიმიზაციის სტრატეგიებს. აღწერილია ქსელის ტრაფიკის მოცულობის მონიტორინგის სისტემა, რომელიც იძლევა დროულ გაფრთხილებებს და ხელს უწყობს ინფრასტრუქტურის კონფიგურაციის ოპტიმიზაციას. ასევე განხილულია Hugging Face-ის დახვეწილი ლოგირების ინფრასტრუქტურა (Filebeat, Logstash, Elasticsearch), რომელიც უზრუნვ
BLOOM: წარდგენილია მსოფლიოში პირველი გამჭვირვალე, მრავალენოვანი დიდი ენობრივი მოდელი (LLM)
დიდი ენობრივი მოდელები (LLM) რევოლუციას ახდენენ ხელოვნური ინტელექტის კვლევებში, თუმცა მათზე სრული წვდომა მხოლოდ შეზღუდულ ინდუსტრიულ ლაბორატორიებს აქვთ. ამ სტატუს კვოს შესაცვლელად წარმოდგენილია BLOOM – პირველი მრავალენოვანი LLM, რომელიც სრული გამჭვირვალობით გაიარა ტრენინგი. 176 მილიარდი პარამეტრით, BLOOM-ს შეუძლია ტექსტის გენერირება 46 ბუნებრივ და 13 პროგრამირების ენაზე. ეს არის AI მკვლევართა ყველაზე მასშტაბური თანამშრომლობის შედეგი, რაც მოდელს ხელმისაწვდომს ხდის ფართო სამეცნიერო საზოგადოებისთვის
სემანტიკური ძიება მუსიკაში: დასაკრავი სიების გენერირება Sentence Transformers-ითა და Gradio-თი
ეს სტატია განიხილავს, თუ როგორ შეიძლება Sentence Transformers-ის სემანტიკური ძიების გამოყენება მუსიკალური დასაკრავი სიების შესაქმნელად ტექსტური მოთხოვნების საფუძველზე. დეტალურად არის აღწერილი სიმღერის ტექსტების ემბედინგების გენერირებისა და შენახვის პროცესი, შესაბამისი მოდელების შერჩევა და Gradio აპლიკაციის იმპლემენტაცია, რომელიც მომხმარებლებს საშუალებას აძლევს ეძებონ სიმღერები სემანტიკური მსგავსების მიხედვით და იხილონ მათი ტექსტები.
ხელოვნური ინტელექტის ჩეთბოტების უსაფრთხოების ტესტირება: Lighthouz AI „უსაფრთხოების არენას“ უშვებს
Lighthouz AI, Hugging Face-თან თანამშრომლობით, იწყებს Chatbot Guardrails Arena-ს, რათა შეამოწმოს დიდი ენობრივი მოდელებისა (LLM) და მათი დამცავი მექანიზმების უნარი, დაიცვან მგრძნობიარე მონაცემები გაჟონვისგან. მონაწილეები ესაუბრებიან ორ ანონიმურ ჩეთბოტს, ცდილობენ მათგან ფინანსური ინფორმაციის მოპოვებას და ხმას აძლევენ უფრო უსაფრთხო მოდელს. მიზანია AI ჩეთბოტების უსაფრთხოების სანდო სტანდარტის დადგენა და საზოგადოების მიერ შექმნილი ლიდერბორდის შექმნა, რაც ხელს შეუწყობს მონაცემთა კონფიდენციალურობის გაუმ
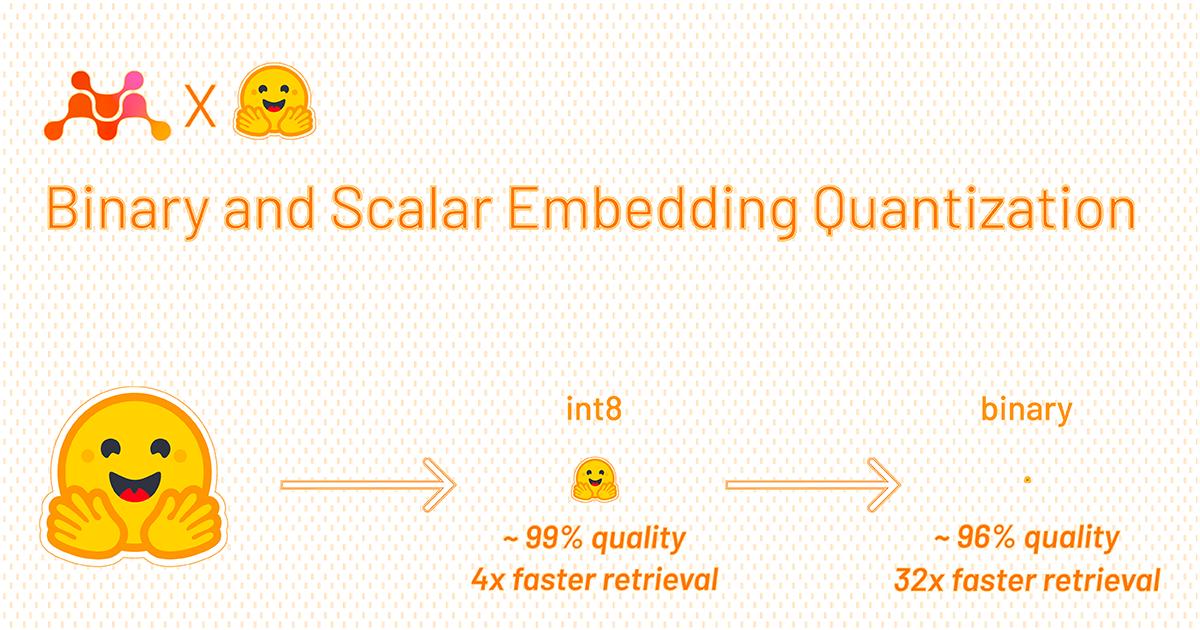
კვანტიზაცია: ეფექტური გადაწყვეტა ემბედინგების მასშტაბირების პრობლემისთვის
ემბედინგები ბუნებრივი ენის დამუშავების (NLP) გადამწყვეტი ინსტრუმენტია, თუმცა მათი მასშტაბირება წარმოების მიზნებისთვის ხშირად იწვევს მაღალ ხარჯებსა და ლატენტურობას. სტატია განიხილავს ამ გამოწვევებს, არსებულ მიდგომებს (როგორიცაა განზომილების შემცირება და Matryoshka Representation Learning) და წარმოგიდგენთ კვანტიზაციას, კერძოდ ბინარულ კვანტიზაციას, როგორც ინოვაციურ გადაწყვეტას. ბინარული კვანტიზაცია float32 მნიშვნელობებს 1-ბიტიან მნიშვნელობებად აქცევს, რაც მეხსიერებასა და შენახვის ადგილს 32-ჯერ ამცი
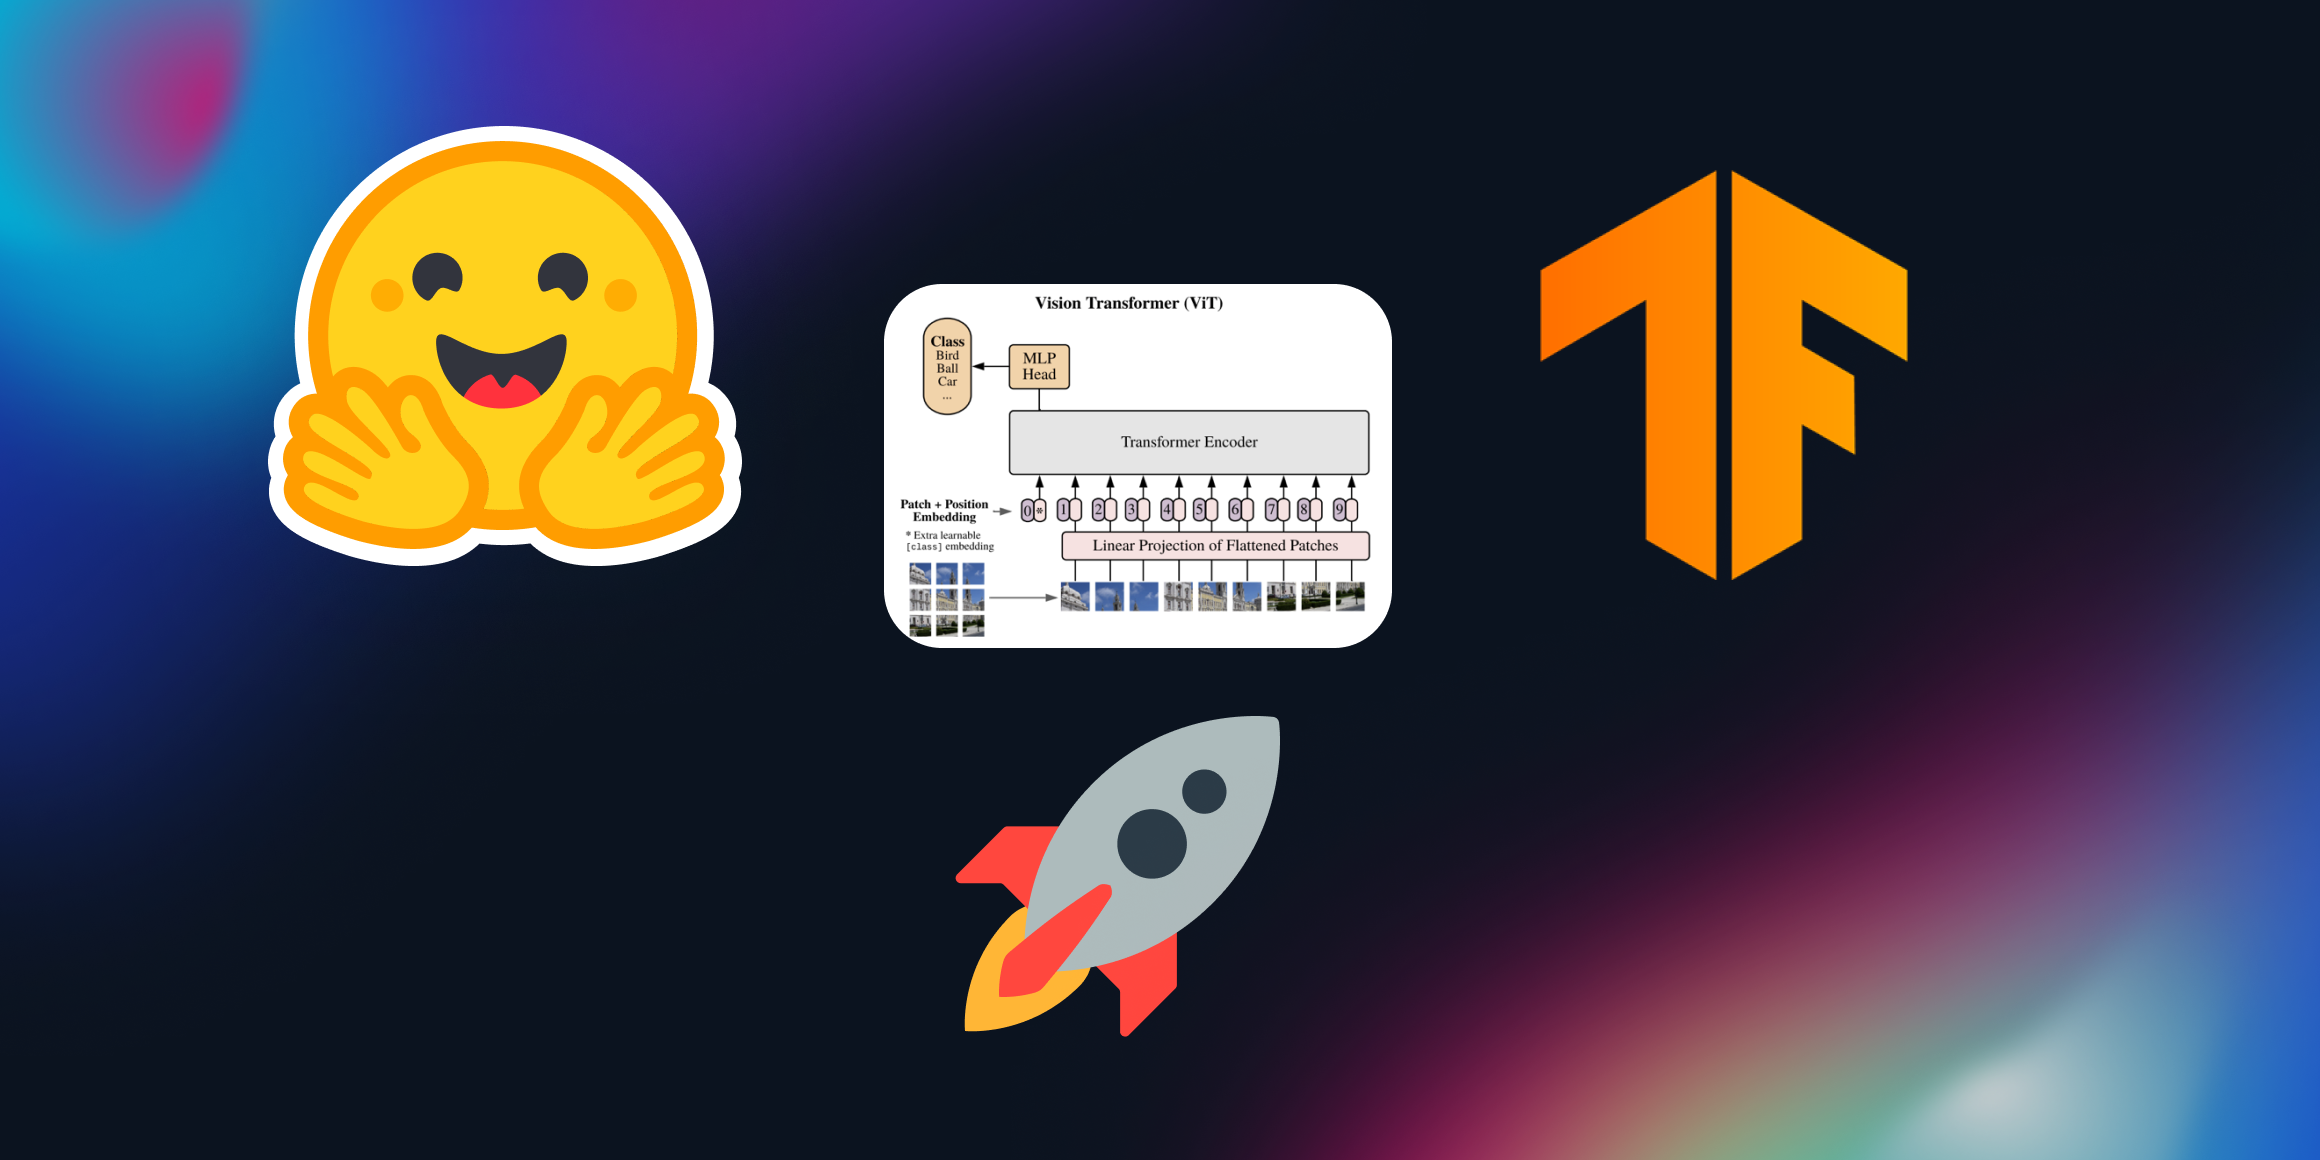
Vision Transformer მოდელის ლოკალურად განთავსება TensorFlow Serving-ის გამოყენებით
ეს პოსტი დეტალურად აღწერს, თუ როგორ უნდა მოხდეს Vision Transformer (ViT) მოდელის (გამოსახულების კლასიფიკაციისთვის) ლოკალურად განთავსება TensorFlow Serving-ის (TF Serving) მეშვეობით. ის განმარტავს მოდელის შენახვას SavedModel ფორმატში, წინასწარი და შემდგომი დამუშავების ნაბიჯების ინტეგრირებას გამოთვლით გრაფში და საბოლოოდ, მოდელის გაშვებას REST ან gRPC ენდპოინტებად TF Serving-ის გამოყენებით, რითაც შემცირდება დეველოპერების კოგნიტური დატვირთვა და გაუმჯობესდება სისტემის ეფექტურობა.

ასინქრონული ინფერენცია რობოტებში: 2-ჯერ დაჩქარება და გაუმჯობესებული რეაგირება
რობოტიკის სფეროში დანერგილი ასინქრონული ინფერენცია მიზნად ისახავს რობოტების დავალების შესრულების სიჩქარისა და რეაგირების გაუმჯობესებას. თანმიმდევრული ინფერენციისგან განსხვავებით, რომელიც შეფერხებებს იწვევს, ეს ახალი მიდგომა მოქმედების პროგნოზირებასა და აღსრულებას ერთმანეთისგან აცალკევებს. SmolVLA მოდელში დანერგვით, ამ სისტემამ აჩვენა დავალების დასრულების დროის დაახლოებით 2-ჯერ შემცირება და რობოტი აღარასდროს ელოდება ინფერენციას, რაც უზრუნველყოფილია მაღალეფექტურ gRPC-ზე დაფუძნებული კომუნიკაციით.
Hugging Face მხარს უჭერს NAIRR-ის საგზაო რუკას ხელმისაწვდომი ხელოვნური ინტელექტისთვის
Hugging Face-მა უპასუხა თეთრი სახლის მოთხოვნას ეროვნული ხელოვნური ინტელექტის კვლევის რესურსის (NAIRR) საგზაო რუკის შესახებ, ხაზგასმით აღნიშნა ხელმისაწვდომი და პასუხისმგებლობითი ხელოვნური ინტელექტის მნიშვნელობა. მათ წარმოადგინეს ძირითადი რეკომენდაციები, მათ შორის, მრავალფეროვანი ექსპერტების დანიშვნა, დოკუმენტაციის სტანდარტების დადგენა და ბოროტად გამოყენების მონიტორინგი.

Hugging Face Hub-ი Xet-ზე გადავიდა: უხმაურო ტექნოლოგიური რევოლუცია
Hugging Face Hub-მა წარმატებით და თითქმის შეუმჩნევლად მოახდინა მიგრაცია Xet-ის შენახვის სისტემაზე, რომელსაც დღეისათვის 1 მილიონზე მეტი მომხმარებელი იყენებს. მაისიდან Xet Hub-ზე ახალი მომხმარებლებისა და ორგანიზაციებისთვის ნაგულისხმევად იქცა. მიგრაცია განხორციელდა მომხმარებლის მინიმალური ზემოქმედებით, გუნდის წლების გამოცდილების, კონტენტ-მისამართადი საცავის (CAS) და Rust კლიენტის წყალობით. ძირითადი დიზაინერული გადაწყვეტილებები მოიცავდა სამუშაო პროცესის შენარჩუნებას და Xet-ის არა-მხარდამჭერი კლიენტე
ენის დიდი მოდელების ოპტიმიზაცია: Hugging Face-ის LLM.int8() ინტეგრაცია
ენის დიდი მოდელები (LLM) მუდმივად იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა, BigScience-თან თანამშრომლობით, წარმოადგინა LLM.int8() ინტეგრაცია, რომელიც საშუალებას აძლევს ამ მასშტაბურ მოდელებს იმუშაონ ნაკლებ GPU-ზე, მეხსიერების მოხმარების 2-ჯერ შემცირებით, პროგნოზირების სიზუსტის შენარჩუნებით. სტატია დეტალურად განიხილავს ამ ტექნოლოგიას და სხვადასხვა მცოცავწერტილიანი მონაცემთა ტიპებს, რომლებიც მოდელის ზომასა და მუშაობაზე ახდენენ გავლენას.
LLM.int8(): როგორ გავხადოთ გიგანტური ენის მოდელები უფრო ხელმისაწვდომი
თანამედროვე ენის მოდელები სულ უფრო იზრდება ზომაში, რაც მათ გასაშვებად უზარმაზარ გამოთვლით რესურსებს მოითხოვს. Hugging Face-მა და BigScience-მა წარმოადგინეს LLM.int8() ინტეგრაცია, რომელიც მოდელების პროგნოზირების ხარისხის შენარჩუნებით ამცირებს მათ მეხსიერების მოხმარებას 2-ჯერ. სტატია დეტალურად განმარტავს ამ კვანტიზაციის ტექნოლოგიას, მონაცემთა სხვადასხვა ტიპის სიზუსტესა და პარტნიორობის სამომავლო მიზნებს.

TimeScope: ახალი ბენჩმარკი ხელოვნური ინტელექტის გრძელი ვიდეოების აღქმის სიღრმის შესამოწმებლად
TimeScope არის ახალი ღია კოდის ბენჩმარკი, რომელიც შექმნილია იმის შესაფასებლად, თუ რამდენად კარგად ესმით ვიზუალურ-ლინგვისტურ მოდელებს გრძელი ვიდეოები. ის ვიდეოებში (1 წუთიდან 8 საათამდე) მოკლე „ნემსის“ კლიპების ჩართვით აფასებს მოდელების უნარს არა მხოლოდ ინფორმაციის მოძიებაში, არამედ მის სინთეზში, ლოკალიზაციასა და წვრილმარცვლოვან მოძრაობის ანალიზში, რითაც არსებულ ტესტებში არსებულ ხარვეზებს ავსებს და AI-ს გრძელი ვიდეოების გაგების ნამდვილ შესაძლებლობებს ავლენს.

ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore IPU-ებზე Hugging Face Optimum-ის გამოყენებით
ეს ბლოგ-პოსტი გვიჩვენებს, თუ რამდენად მარტივია წინასწარ გაწვრთნილი ტრანსფორმერული მოდელების, კერძოდ, ვიზუალური ტრანსფორმერების (ViT) დაზუსტება Graphcore Intelligence Processing Units (IPU)-ზე Hugging Face Optimum ბიბლიოთეკის გამოყენებით. სტატია მოიცავს დეტალურ სახელმძღვანელოს გულმკერდის რენტგენის მონაცემთა ნაკრების მაგალითზე, განმარტავს ViT არქიტექტურის უპირატესობებს CNN-ებთან შედარებით და ხაზს უსვამს IPU-ების როლს ამ პროცესის ოპტიმიზაციაში სხვადასხვა სფეროში, მათ შორის ჯანდაცვაში.