Hugging Face-ი Gradio-ს იძენს: მანქანური სწავლის ხელმისაწვდომობის ახალი ეტაპი
მანქანური სწავლის სტარტაპ Gradio-ს Hugging Face-ის მიერ შეძენა მნიშვნელოვანი ნაბიჯია ხელოვნური ინტელექტის დემოკრატიზაციისკენ. ეს შერწყმა საშუალებას მისცემს დეველოპერებს, მონაცემთა მეცნიერებს და არატექნიკურ მომხმარებლებს, უფრო მარტივად შექმნან, გააზიარონ, გამოიყენონ და შეაფასონ მანქანური სწავლის მოდელები. გაერთიანებული ძალებით, Hugging Face და Gradio ისახავენ მიზნად, რომ ხელოვნური ინტელექტი ხელმისაწვდომი გახადონ ყველასთვის, ვისაც ინტერნეტთან წვდომა აქვს, რაც კიდევ უფრო გააფართოვებს ინოვაციების შე
ახალი რეგიონების ფუნქცია: სად შეინახოთ თქვენი მონაცემები და რატომ არის ეს მნიშვნელოვანი
ეს ბლოგ პოსტი განიხილავს ახალ ფუნქციას, რომელიც მომხმარებლებს საშუალებას აძლევს აირჩიონ თავიანთი მონაცემების (მოდელები და მონაცემთა ნაკრებები) შენახვის რეგიონი. ეს უზრუნველყოფს მონაცემთა რეზიდენტურის მოთხოვნებთან შესაბამისობას (მაგ. GDPR) და მნიშვნელოვნად აუმჯობესებს ატვირთვისა და ჩამოტვირთვის სიჩქარეს. სტატიაში ასევე აღწერილია, თუ როგორ უნდა დავაყენოთ ეს ფუნქცია.
GPT-J-ის ეფექტური დეპლოირება Amazon SageMaker-ისა და Hugging Face-ის გამოყენებით
სტატია განიხილავს EleutherAI-ის GPT-J მოდელის წარმოებაში ინტეგრაციის გამოწვევებს, განსაკუთრებით მეხსიერების მოხმარებისა და ჩატვირთვის ხანგრძლივი დროის თვალსაზრისით. ის წარმოადგენს გადაწყვეტას Amazon SageMaker-ისა და Hugging Face Inference Toolkit-ის გამოყენებით, PyTorch-ის მოდელების შენახვის ოპტიმიზებული მეთოდის მეშვეობით, რაც მნიშვნელოვნად ამცირებს ჩატვირთვის დროს (1 წუთი და 23 წამიდან 7.7 წამამდე) და GPT-J-ს საწარმოო სცენარებისთვის თავსებადს ხდის.

Meta-ს Llama 4-ის მოდელები გამოვიდა: წინ გადადგმული ნაბიჯი მულტიმოდალურ ხელოვნურ ინტელექტში MoE არქიტექტურითა და გაფართოებული კონტექსტით
Meta-ს მიერ შემუშავებული Llama 4-ის მოდელები, Maverick და Scout, დღეს გამოვიდა, რაც ხელოვნური ინტელექტის სფეროში მნიშვნელოვან წინსვლას წარმოადგენს. ეს მძლავრი, მშობლიურად მულტიმოდალური მოდელები იყენებენ ახალ ავტორეგრესიულ „ექსპერტთა ნაზავის“ (MoE) არქიტექტურას, რაც მათ საშუალებას აძლევს დაამუშაონ როგორც ტექსტური, ისე გამოსახულების შეტანა. Hugging Face-ის ეკოსისტემასთან სრულყოფილი ინტეგრაციის უზრუნველყოფით, Llama 4-ის მოდელები გაწვრთნილია 200 ენაზე (40 ტრილიონამდე ტოკენზე) და გამოირჩევა კონტექსტი

LLM შეფასების კრიტიკული ხარვეზები DROP ბენჩმარკში: ნორმალიზაციისა და „გაჩერების ტოკენების“ პრობლემა
Open LLM Leaderboard-ზე DROP ბენჩმარკის დამატების შემდეგ, მოდელების f1-ქულებმა მოულოდნელად დაბალი შედეგები აჩვენა. გამოკვლევამ გამოავლინა ორი ძირითადი პრობლემა: არასწორი ნორმალიზაცია, რომელიც უგულებელყოფდა რიცხვით პასუხებს არასტანდარტული სიცარიელის სიმბოლოების გამო, და წერტილის (.) „გაჩერების ტოკენად“ გამოყენება. ამ ხარვეზების აღმოფხვრა, მათ შორის \n სიმბოლოზე დაყოფა, მნიშვნელოვნად აუმჯობესებს ქულების კორელაციას საერთო შესრულებასთან. თუმცა, სრული ხელახალი შეფასება ძვირი და შრომატევადია, რაც მიუთ

Cloudflare-ისა და FastRTC-ის პარტნიორობა: AI-ზე დაფუძნებული რეალურ დროში კომუნიკაციის გამარტივება
Cloudflare-ისა და Hugging Face-ის FastRTC-ის პარტნიორობა AI დეველოპერებს საშუალებას აძლევს, მინიმალური კოდით შექმნან დაბალლატენტური, ხელოვნურ ინტელექტზე დაფუძნებული აუდიო და ვიდეო ნაკადები. ეს ინტეგრაცია აბსტრაგირებს WebRTC-ის სირთულეებს და იყენებს Cloudflare-ის გლობალურ TURN ქსელს საიმედო კავშირების უზრუნველსაყოფად, რაც დეველოპერებს საშუალებას აძლევს ფოკუსირება მოახდინონ აპლიკაციის ძირითად ლოგიკაზე ინფრასტრუქტურის შენარჩუნების გარეშე. პარტნიორობა ასევე გთავაზობთ 10 GB უფასო მონაცემს ყოველთვიურა
BERT: ხელოვნური ინტელექტის ინოვაცია, რომელმაც ენის დამუშავება შეცვალა
BERT, Google AI-ის მიერ 2018 წელს შექმნილი მანქანური სწავლების მოდელი, რევოლუციური ინოვაციაა ბუნებრივი ენის დამუშავების (NLP) სფეროში. იგი წარმოადგენს მრავალფუნქციურ გადაწყვეტას 11-ზე მეტი ენობრივი ამოცანისთვის, მათ შორის სენტიმენტების ანალიზისა და დასახელებული ერთეულების ამოცნობისთვის. სტატია განმარტავს, თუ როგორ ეხმარება BERT კომპიუტერებს ადამიანის ენის გაგებაში, რა ტექნიკებს (როგორიცაა ნიღბიანი ენის მოდელი და შემდეგი წინადადების პროგნოზირება) იყენებს ამისთვის და რა გავლენა მოახდინა მან Google
SetFitABSA: ინოვაციური მიდგომა ასპექტზე დაფუძნებული სენტიმენტის ანალიზისთვის
SetFitABSA, Intel Labs-ისა და Hugging Face-ის მიერ წარმოდგენილი ფრეიმვორკი, წარმოადგენს ეფექტურ ტექნიკას ტექსტში კონკრეტული ასპექტების მიმართ სენტიმენტის აღმოსაჩენად. ის განკუთვნილია დომენის სპეციფიკური ABSA (ასპექტზე დაფუძნებული სენტიმენტის ანალიზი) მოდელების მცირე მონაცემებით (few-shot) წვრთნისთვის და კონკურენტუნარიანია, უმჯობესდება კიდეც გენერაციულ მოდელებს, როგორიცაა Llama2 და T5. მისი ძირითადი უპირატესობებია პრომპტების არარსებობა და სწრაფი წვრთნის შესაძლებლობა მცირე რაოდენობის ეტიკეტირებული
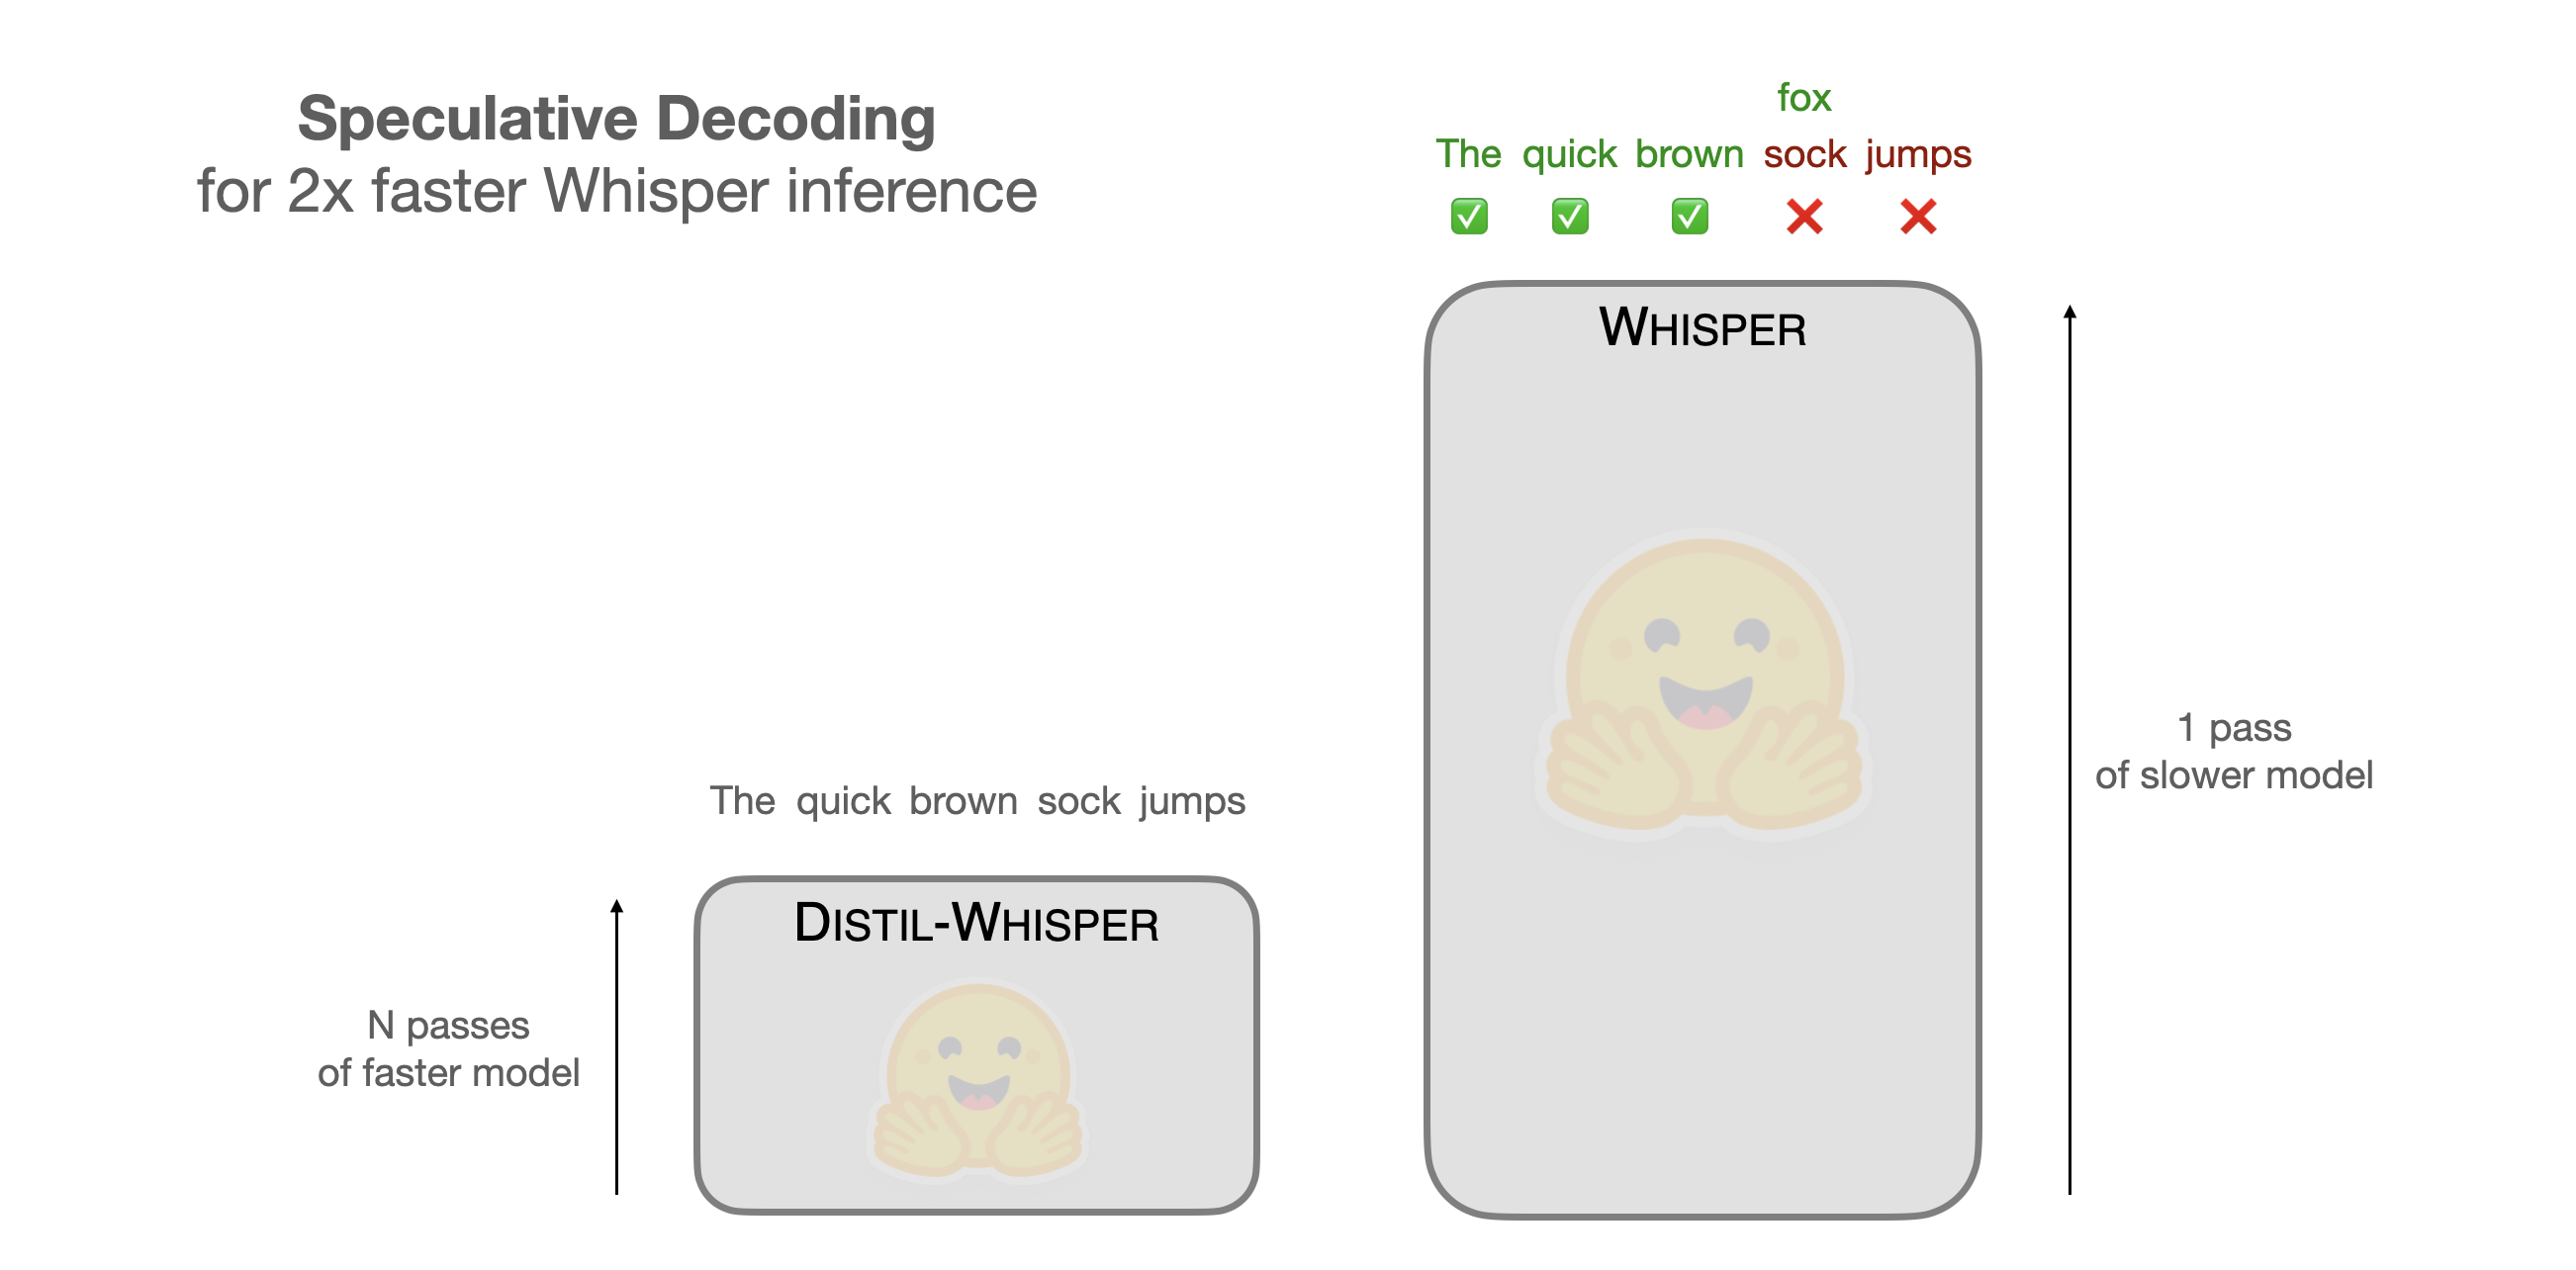
Whisper-ის სიჩქარის გაორმაგება: Speculative Decoding-ის ინოვაციური მეთოდი
მიუხედავად Whisper-ის ტრანსკრიფციის გამორჩეული სიზუსტისა, მისი დამუშავების (ინფერენციის) დრო საკმაოდ ნელია. ეს სტატია წარმოადგენს Speculative Decoding-ის მეთოდს, რომელიც Whisper-ის ინფერენციის დროს 2-ჯერ ამცირებს, სიზუსტის შენარჩუნებით. ეს ინოვაციური მიდგომა უზრუნველყოფს ზუსტად იგივე შედეგებს, რაც მოდელის სტანდარტული გამოყენებისას მიიღება, რაც მას არსებული Whisper-ის სისტემებისთვის იდეალურ ალტერნატივად აქცევს.
Hugging Face იწვევს კანდიდატებს ხელოვნური ინტელექტის რეზიდენტურაზე: აქცენტით დივერსიასა და სოციალურ ზეგავლენაზე
Hugging Face აცხადებს მიღებას მანქანური სწავლების რეზიდენტურის პროგრამაზე, რომელიც მიზნად ისახავს ხელოვნური ინტელექტის დემოკრატიზაციას და პასუხისმგებლობით განვითარებას. პროგრამა ღიაა ყველა ფონის კანდიდატისთვის, განსაკუთრებული აქცენტით მათზე, ვისი პირადი გამოცდილებაც ასახავს საზოგადოების მარგინალიზებული ჯგუფების საჭიროებებს. აპლიკანტებს მოეთხოვებათ კვლევის გამოცდილება, პროგრამირების უნარები და სოციალურად პოზიტიური ზეგავლენის მოხდენის ინტერესი AI-ის საშუალებით. Hugging Face მხარს უჭერს მრავალფეროვ
SDXL Dreambooth LoRA ტრენინგის რევოლუცია: Pivotal Tuning-ისა და Prodigy ოპტიმიზატორის კომბინაციით
ამ სტატიაში წარმოდგენილია Dreambooth LoRA-ების SDXL-ისთვის ოპტიმიზაციის ახალი მეთოდი, რომელიც აერთიანებს Replicate-ის SDXL Cog ტრენერში გამოყენებულ Pivotal Tuning ტექნიკას Kohya ტრენერის Prodigy ოპტიმიზატორთან. ეს მიდგომა, სხვა მრავალ ოპტიმიზაციასთან ერთად, უზრუნველყოფს საუკეთესო შედეგებს ახალი კონცეფციების აღბეჭდვაში მცირე რაოდენობის გამოსახულებების გამოყენებით, SDXL-ის ესთეტიკური ხარისხისა და გამოსახულების სიზუსტის შენარჩუნებით, ამასთანავე მოითხოვს შედარებით ნაკლებ გამოთვლით რესურსებს. გაეცანი

Llama Guard 4 და Prompt Guard 2: ხელოვნური ინტელექტის უსაფრთხოების ახალი მულტიმოდალური მოდელები
წარმოგიდგენთ Llama Guard 4-ს, მულტიმოდალურ მოდელს, რომელიც შექმნილია გამოსახულებებსა და ტექსტში სახიფათო კონტენტის აღმოსაჩენად, მათ შორის „jailbreak“-ის თავიდან ასაცილებლად. მასთან ერთად, Llama Prompt Guard 2 აძლიერებს დაცვას „prompt injection“-ებისა და სხვა მავნე შეტევებისგან, რაც უზრუნველყოფს ხელოვნური ინტელექტის უსაფრთხო და მოქნილ მოდერაციას. ეს მოდელები მნიშვნელოვნად აუმჯობესებენ AI სისტემების დაცვას საწარმოო გარემოში.
Vectara-ს HHEM ლიდერბორდი Hugging Face-ის შაბლონით LLM-ის „ჰალუცინაციის“ შესაფასებლად
კომპანია Vectara-მ წარმოადგინა ჰიუზის ჰალუცინაციის შეფასების მოდელი (HHEM), ღია კოდის ინსტრუმენტი, რომელიც ზომავს დიდი ენობრივი მოდელების (LLM) მიერ „ჰალუცინაციის“ (უაზრო ტექსტის გენერირება) ხარისხს. მოდელი აფასებს როგორც ღია კოდის, ასევე კომერციულ LLM-ებს, ხაზს უსვამს მათ შორის არსებულ განსხვავებებს. HHEM ლიდერბორდის მართვის საჭიროების გამო, Vectara-მ Hugging Face-ის ახალი ლიდერბორდის შაბლონები გამოიყენა და გამოუშვა HHEM ლიდერბორდი. ეს ინიციატივა მიზნად ისახავს LLM „ჰალუცინაციების“ შეფასების დე

ხილვად-ენობრივი მოდელების ტრანსფორმაცია: ბოლო ერთი წლის მიღწევები
სტატია მიმოიხილავს ხილვად-ენობრივი მოდელების (VLMs) განვითარებას ბოლო ერთი წლის განმავლობაში, LLaVA-ს თავდაპირველი წარმატებიდან უფრო მძლავრი, კომპაქტური და მრავალფეროვანი არქიტექტურების გამოჩენამდე. განხილულია ახალი პარადიგმები, როგორიცაა 'ნებისმიერი-ნებისმიერზე' (any-to-any) მოდელები, მულტიმოდალური RAG, მსჯელობის მოდელები და მცირე ზომის VLMs-ის ტენდენცია, რომლებსაც შეუძლიათ სამომხმარებლო მოწყობილობებზე მუშაობა.
MetaAI-ის Wav2Vec2-BERT: გაუმჯობესებული მეტყველების ამოცნობა დაბალრესურსიან ენებზე
MetaAI-მ გამოუშვა Wav2Vec2-BERT, ხელოვნური ინტელექტის მოდელი მეტყველების ავტომატური ამოცნობისთვის (ASR), რომელიც Seamless Communication-ის ნაწილია. ორიგინალური Wav2Vec2-ის გაუმჯობესებული ვერსია, Wav2Vec2-BERT, გაწვრთნილია 4.5 მილიონ საათზე მეტ აუდიო მონაცემზე 143-ზე მეტ ენაზე. ის მნიშვნელოვნად აღემატება Whisper-ის მოდელს სიჩქარითა და რესურსების ეფექტურობით, განსაკუთრებით დაბალრესურსიან ენებზე, როგორიცაა მონღოლური, სადაც Whisper-ი დაბალ შედეგებს აჩვენებს. Wav2Vec2-BERT-ს შეუძლია მიაღწიოს კონკურენ

Kaggle აუმჯობესებს Hugging Face მოდელების ინტეგრაციას: უკეთესი ხილვადობა და გამოყენებადობა
Kaggle-მა დღეიდან დაიწყო ახალი ინტეგრაცია Hugging Face-თან, რომელიც მნიშვნელოვნად აუმჯობესებს Hugging Face-ის მოდელების აღმოჩენადობასა და გამოყენებას Kaggle-ის პლატფორმაზე. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს მარტივად გადავიდნენ მოდელებს შორის და გამოიყენონ ისინი Kaggle Notebook-ებში წინასწარ შევსებული კოდის ფრაგმენტებით. Kaggle ასევე აქტიურად მუშაობს ოფლაინ შეჯიბრებებში Hugging Face მოდელების უწყვეტი გამოყენების გადაწყვეტილებაზე, მონაცემთა უსაფრთხოების მაღალი სტანდარტების დაცვით.
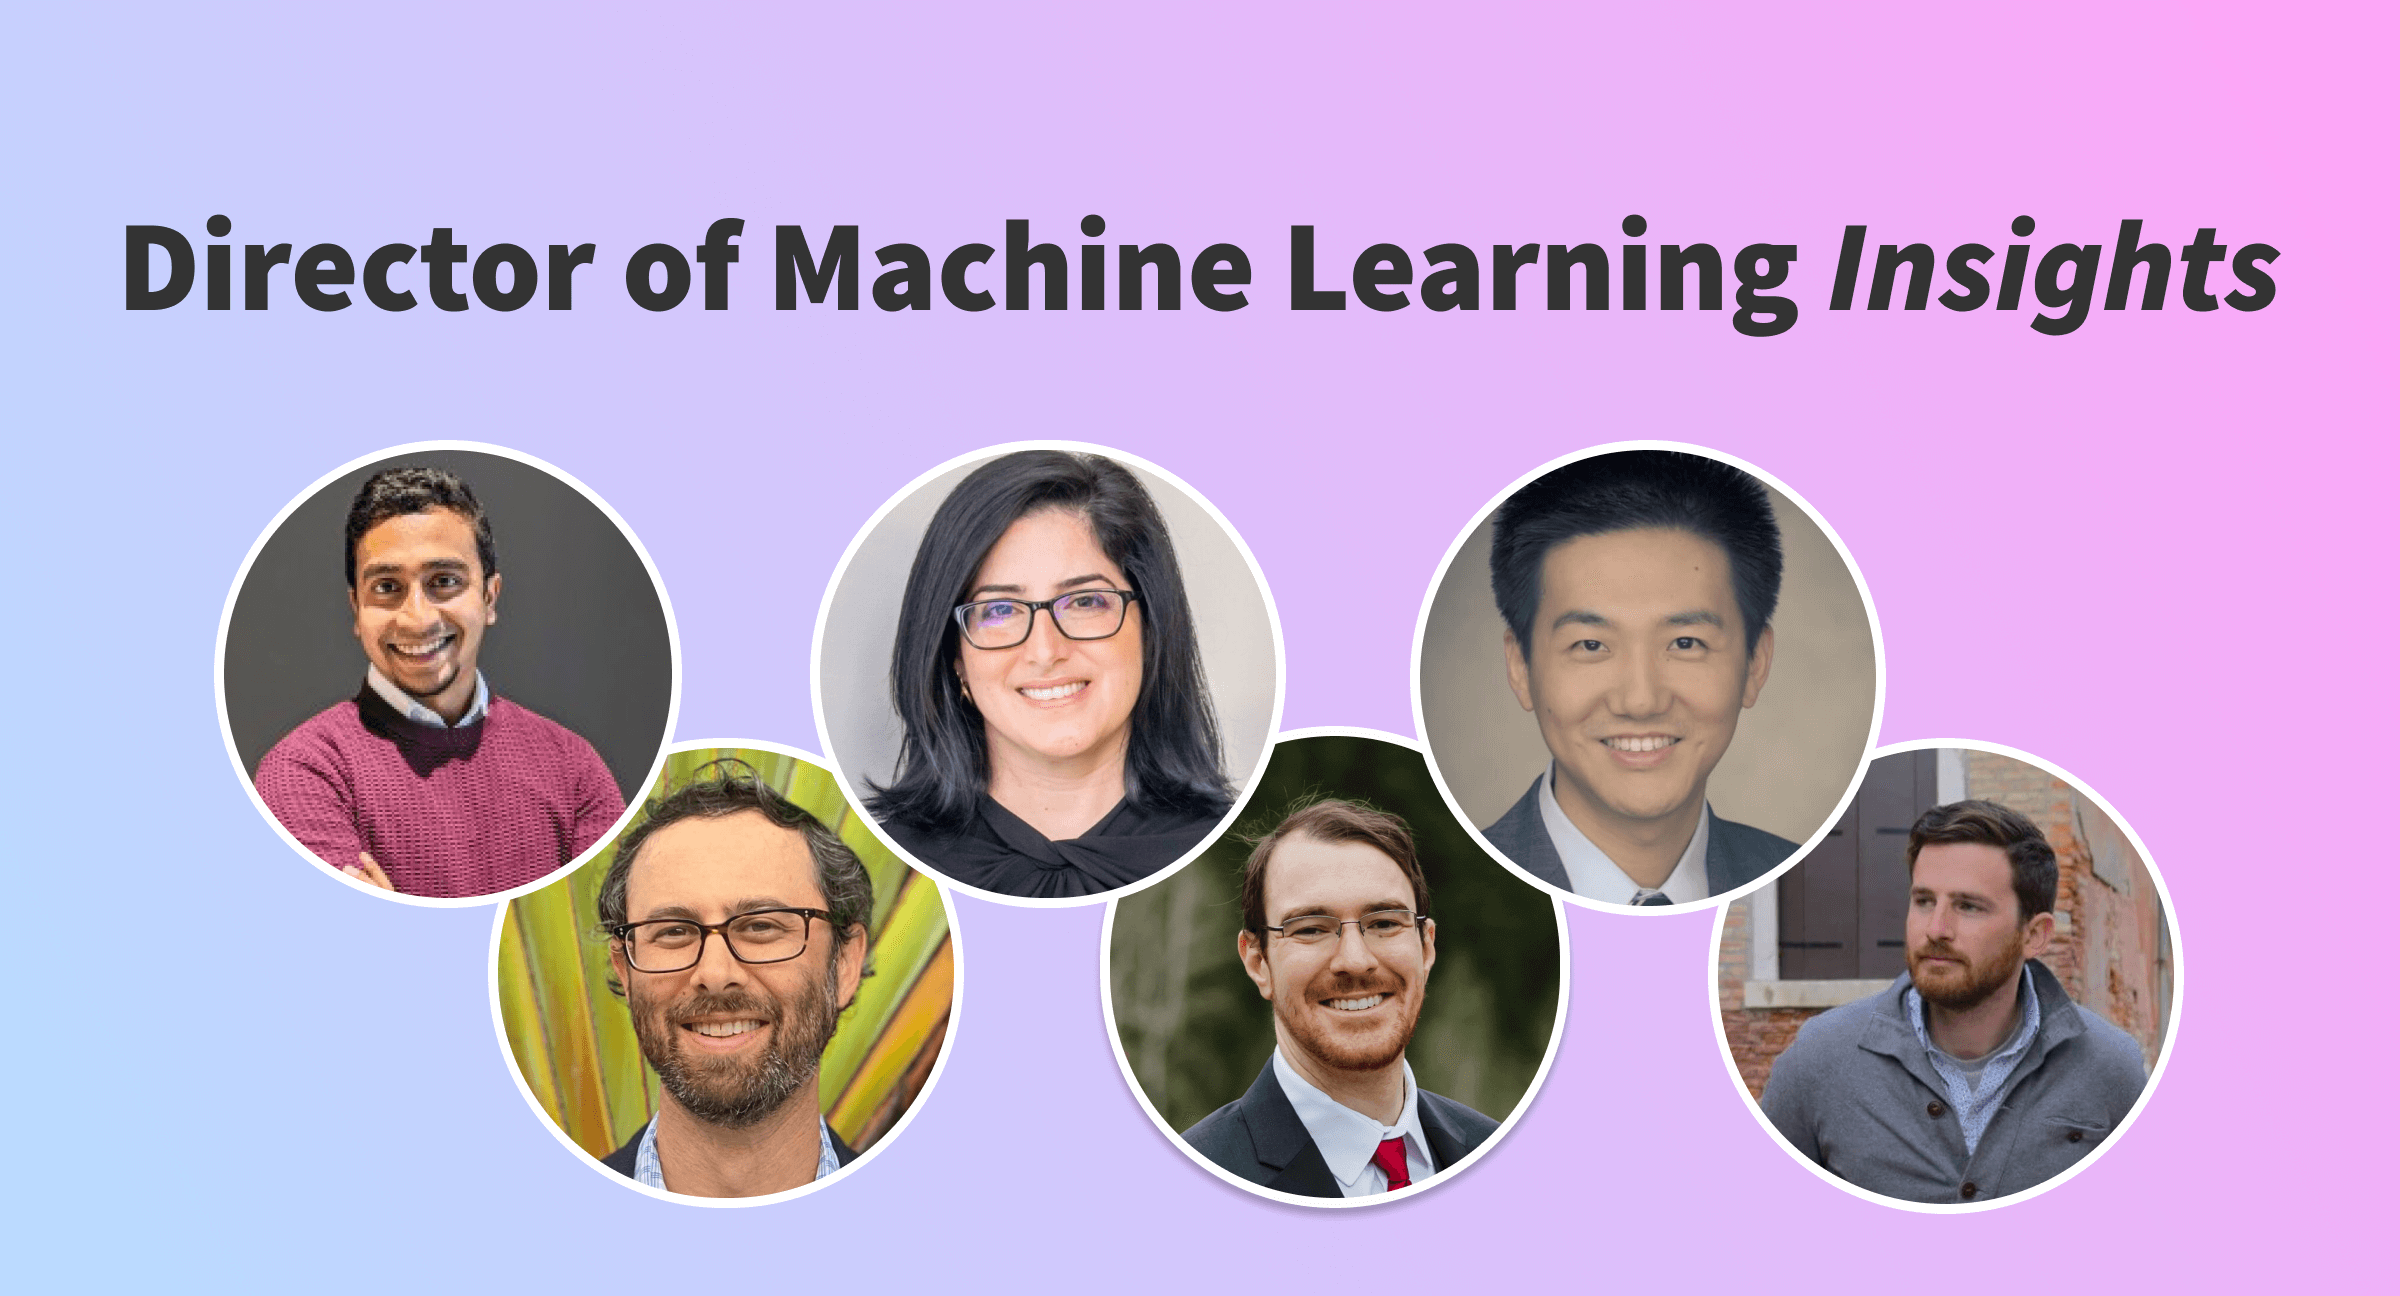
წამყვანი ML დირექტორების შეხედულებები: ხელოვნური ინტელექტის გავლენა ინდუსტრიებზე
მანქანური სწავლების (ML) და მონაცემთა მეცნიერების დირექტორებს უაღრესად რთული მოთხოვნები აქვთ თავიანთ როლებში. ამ სტატიების სერიაში, ჩვენ წარმოგიდგენთ ML დირექტორების უნიკალურ შეხედულებებს მიმდინარე ML ტენდენციებსა და ინდუსტრიულ განვითარებაზე, დაწყებული ჯანდაცვიდან ფინანსებამდე, ელექტრონულ კომერციამდე და სხვა სფეროებამდე. ისინი გაგვიზიარებენ გამოცდილებას ML-ის პრაქტიკული გამოყენების შესახებ რეალურ სამყაროში, ისეთი ინოვაციების ჩათვლით, როგორიცაა ნახშირბადის ემისიების შემცირება ტრანსპორტირებაში ან

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
ახალი LLM ლიდერბორდი რეალურ ბიზნეს სცენარებში ენის მოდელების შეფასებისთვის
ეს ლიდერბორდი მიზნად ისახავს ენის დიდი მოდელების (LLM) მუშაობის შეფასებას რეალური ბიზნეს ამოცანების კონტექსტში. ის მხარს უჭერს 6 მრავალფეროვან დავალებას, როგორიცაა FinanceBench და იურიდიული კონფიდენციალურობა, და ზომავს მოდელების ეფექტურობას ისეთი მეტრიკებით, როგორიცაა სიზუსტე, ჩართულობა და ტოქსიკურობა. ლიდერბორდი შემუშავდა იმისათვის, რომ დაეხმაროს მომხმარებლებს პრაქტიკული გამოყენებისთვის საუკეთესო მოდელის არჩევაში და აქტიურად ცდილობს თავიდან აიცილოს ტესტ-კომპლექტის დაბინძურება ზოგიერთი მონაცემთა
დიდი ენობრივი მოდელების (LLMs) მაღალეფექტური განთავსება: TGI და AWS Inferentia2 Amazon SageMaker-ში
ტექსტის გენერირების ინფერენცია (TGI) წარმოადგენს სპეციალურად შექმნილ გადაწყვეტას დიდი ენობრივი მოდელების (LLMs) მასშტაბური განთავსებისა და სერვისისთვის. TGI უზრუნველყოფს მაღალეფექტურ ტექსტის გენერაციას Tensor Parallelism-ისა და უწყვეტი დაჯგუფების გამოყენებით Llama-ს, Mistral-ის და სხვა პოპულარული ღია LLM-ებისთვის. AWS Inferentia2-თან ინტეგრაცია Amazon SageMaker-ში TGI-ს აქცევს მძლავრ ალტერნატივად GPU-ებისთვის LLM აპლიკაციების შესაქმნელად. ეს ინტეგრაცია ამარტივებს მოდელების განთავსებას და შენარჩუ
Gradio 3.0 და Gradio Blocks: მანქანური სწავლების დემოების შექმნის რევოლუცია
2019 წლიდან Gradio-ს ბიბლიოთეკით 600 000-ზე მეტი მანქანური სწავლების დემო აშენდა. დღეს წარმოდგენილია Gradio 3.0, რომელიც მოიცავს ფრონტენდის სრულ განახლებას, თანამედროვე ტექნოლოგიების (როგორიცაა Svelte) გამოყენებით, რამაც გამოიწვია სწრაფი მუშაობა და დახვეწილი ვიზუალური ესთეტიკა. გარდა ამისა, ახალი დაბალდონიანი ენა, Gradio Blocks, დეველოპერებს საშუალებას აძლევს შექმნან კომპლექსური, მორგებული ვებ აპლიკაციები უშუალოდ Python-ში, რაც უზრუნველყოფს განლაგებისა და მონაცემთა ნაკადზე მეტ კონტროლს. ამ მოვლე
Hugging Face-ის ფელოუშიპის პროგრამა: ღია წყაროს კონტრიბუტორების მხარდაჭერა და გავლენის გაზრდა
Hugging Face-ის ფელოუშიპის პროგრამა მიზნად ისახავს ღია წყაროს მანქანური სწავლების კონტრიბუტორების გაძლიერებას. პროგრამა სთავაზობს რესურსებს, აღიარებას და დამხმარე საზოგადოებას, რათა მონაწილეებმა გაზარდონ თავიანთი გავლენა და განახორციელონ ის პროექტები, რაზეც ყოველთვის ოცნებობდნენ. ფელოუშიპი მხარს უჭერს მრავალფეროვნებას და მიესალმება ნებისმიერი წარმომავლობის მქონე პირებს, ხაზს უსვამს ინდივიდუალურ წვლილს სფეროს დემოკრატიზაციაში.
LoRA ადაპტერების შერწყმის ახალი მეთოდები AI მოდელებში
ეს პოსტი Hugging Face-ის PEFT ბიბლიოთეკაში LoRA ადაპტერების შერწყმის ინოვაციურ მეთოდებს წარმოგიდგენთ. ის დეტალურად განიხილავს, თუ როგორ შეიძლება ერთი და იგივე საბაზისო მოდელიდან მიღებული სხვადასხვა ადაპტერების გაერთიანება, რათა მიღებულ იქნეს ოპტიმალური შედეგები, მეხსიერების შეზღუდვის მიუხედავად. აღწერილია კონკატენაციის, შეწონილი ჯამის, ამოცანის არითმეტიკისა და TIES მეთოდები, კოდის მაგალითებითა და სამომავლო გეგმებით.
მოდელების შერწყმა: LoRA ადაპტერების გაერთიანების ახალი მიდგომები PEFT-ში
ამ პოსტში წარმოდგენილია 🤗 PEFT-ის ფარგლებში შემუშავებული LoRA ადაპტერების შერწყმის ახალი, ოპტიმიზებული მეთოდები. განხილულია სტანდარტული მოდელების გაერთიანების მიდგომები, მეხსიერების ინტენსივობის გამოწვევები და შემოთავაზებულია სხვადასხვა ტექნიკა, მათ შორის კონკატენაცია, მატრიცების შეწონილი ჯამი და დავალების არითმეტიკა (Task Arithmetic). სტატია მოიცავს კოდის მაგალითებს, შთამბეჭდავ შედეგებსა და სამომავლო გეგმებს.