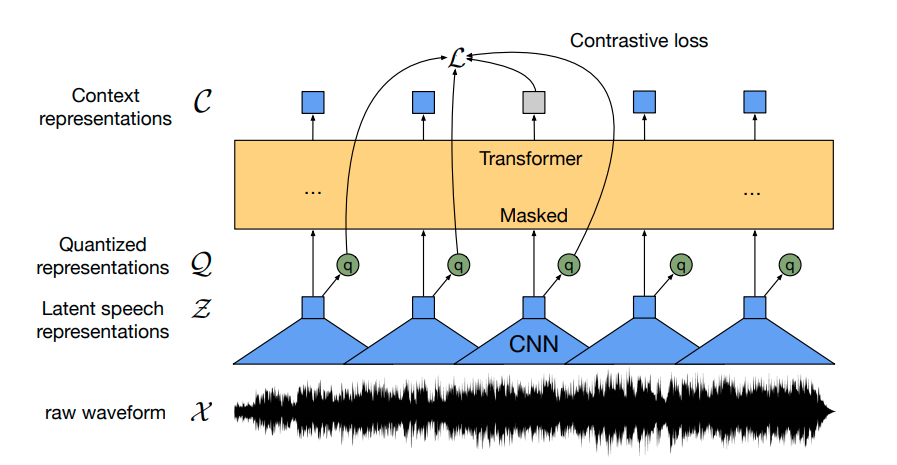
Wav2Vec2: გარღვევა მეტყველების ამოცნობაში მინიმალური მარკირებული მონაცემებით
Wav2Vec2, რევოლუციური ხელოვნური ინტელექტის მოდელი, სწავლობს მეტყველების მძლავრ წარმოდგენებს დიდი მოცულობის არამარკირებული აუდიო მონაცემებიდან, კონტრასტული წინასწარი ვარჯიშის ინოვაციური მეთოდის გამოყენებით. მან აჩვენა უპრეცედენტო შედეგები ავტომატური მეტყველების ამოცნობის (ASR) სფეროში, მიაღწია უმაღლეს დონეს მაშინაც კი, როდესაც დამატებითი ვარჯიში (fine-tuning) ხდება სულ რაღაც 10 წუთის მარკირებულ მეტყველების მონაცემებზე. ეს მას ქმნის მაღალეფექტურ გადაწყვეტილებად ძლიერი ASR სისტემების შესაქმნელად, რ
OpenAI-მ Deep Research გამოუშვა: ვებ-დათვალიერების სისტემა და ღია კოდით მისი რეპროდუცირების მცდელობები
OpenAI-მ წარმოადგინა „Deep Research“ – ინოვაციური სისტემა, რომელიც ვებ-კონტენტს აჯამებს და კითხვებზე პასუხობს. სისტემამ შთამბეჭდავი შედეგები აჩვენა General AI Assistants (GAIA) ბენჩმარკზე, მიაღწია თითქმის 67%-იან სიზუსტეს საშუალოდ და 47.6%-ს რთულ „დონე 3“ კითხვებზე. Deep Research აგებულია დიდ ენობრივ მოდელზე (LLM) და აგენტურ ჩარჩოზე, რომელიც მას ინსტრუმენტების გამოყენებაში ეხმარება. მიუხედავად OpenAI-ს მიერ აგენტური ჩარჩოს დეტალების არგამჟღავნებისა, ღია კოდის საზოგადოებამ 24-საათიანი მისია დაიწყ
Hugging Face და Amazon სტრატეგიულ პარტნიორობას აცხადებენ ხელოვნური ინტელექტისა და NLP განვითარების დასაჩქარებლად
Hugging Face-მა და Amazon-მა სტრატეგიული პარტნიორობის შესახებ განაცხადეს, რომლის მიზანია კომპანიებისთვის უახლესი მანქანური სწავლის მოდელების გამოყენების გამარტივება და მოწინავე ბუნებრივი ენის დამუშავების (NLP) ფუნქციების უფრო სწრაფად მიწოდება. პარტნიორობის ფარგლებში, Hugging Face იყენებს Amazon Web Services-ს (AWS) როგორც სასურველ ღრუბლოვან პროვაიდერს. თანამშრომლობის პირველი ნაბიჯი არის Hugging Face-ის ახალი ღრმა სწავლის კონტეინერების (DLCs) წარდგენა, რაც მნიშვნელოვნად გაამარტივებს Transformer მ

Open R1 პროექტი წარმოგიდგენთ OpenR1-Math-220k: მათემატიკური მსჯელობის ახალ, მასშტაბურ მონაცემთა ნაკრებს
Open R1 პროექტი, რომლის მიზანია DeepSeek R1-ის ტრენინგის პროცესებისა და სინთეზური მონაცემების აღდგენა, სიამოვნებით აცხადებს OpenR1-Math-220k-ის შექმნას – მათემატიკური მსჯელობისთვის განკუთვნილი პირველი ფართომასშტაბიანი მონაცემთა ნაკრები. ეს პოსტი დეტალურად აღწერს მის შექმნის პროცესს, მათ შორის 512 H100 გრაფიკული პროცესორის გამოყენებას გენერაციისთვის და ხარისხის უზრუნველსაყოფად წესებზე დაფუძნებული (Math Verify) და დიდი ენობრივი მოდელებზე დაფუძნებული (Llama-3.3-70B-Instruct) ვალიდაციის მეთოდების კო
Open R1 პროექტი: OpenR1-Math-220k მონაცემთა ნაკრების წარდგენა მათემატიკური მსჯელობისთვის
Open R1 პროექტი, რომლის მიზანია DeepSeek R1-ის დაკარგული კომპონენტების – კერძოდ, საწვრთნელი პაიპლაინისა და სინთეზური მონაცემების – რეკონსტრუქცია, უკვე ორი კვირაა მიმდინარეობს. ამ პოსტში წარმოდგენილია OpenR1-Math-220k: ჩვენი პირველი ფართომასშტაბიანი მონაცემთა ნაკრები მათემატიკური მსჯელობისთვის. განხილულია საზოგადოების ძალისხმევა მცირე, მაღალი ხარისხის მონაცემთა ნაკრებების შესაქმნელად და მსჯელობის მოდელებიდან „აზროვნების ჯაჭვის“ (chain-of-thought) სიგრძის კონტროლის მეთოდები. სტატია დეტალურად აღწერ

ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნა: ახალი ინსტრუმენტები საზოგადოებისთვის
ამ სტატიაში განვიხილავთ ვიდეო გენერაციის მონაცემთა ნაკრებების შექმნისთვის შემუშავებულ ახალ ინსტრუმენტებს, რომლებიც მიზნად ისახავს ამ პროცესის გამარტივებას, სურათების გენერაციის მსგავსად. წარმოდგენილია ღია კოდის სკრიპტები მცირე მასშტაბისთვის და video2dataset დიდი მასშტაბისთვის. დეტალურად აღიწერება მონაცემთა დამუშავების 3-ეტაპიანი კონვეიერი, ფილტრაციის სტრატეგიები (მათ შორის pwatermark-ისა და ესთეტიკური ქულების გამოყენებით) და მათი გავლენა ვიდეო გენერაციის მოდელების ხარისხზე. მიზანია, საზოგადოებას
Hugging Face Hub: მონაცემთა გადაცემის და შენახვის ოპტიმიზაცია დედუპლიკაციის ახალი მიდგომებით
Hugging Face Hub-ზე ხელოვნური ინტელექტის მოდელებისა და მონაცემთა ნაკრებების სწრაფი ზრდა მოითხოვს ეფექტურ მონაცემთა მართვას. სტატია აღწერს, თუ როგორ უმკლავდება Xet გუნდი გამოწვევებს, რომლებიც დაკავშირებულია დედუპლიკაციასთან, ტრადიციული მიდგომების შეზღუდვებთან და მასშტაბირებადობასთან. ნაცვლად იმისა, რომ ფოკუსირება მხოლოდ მცირე ბლოკების დედუპლიკაციაზე მოხდეს, რაც ინფრასტრუქტურას გადატვირთავს, Xet გუნდმა შეიმუშავა ინოვაციური, ბლოკებზე დაფუძნებული მიდგომა Rust-ში დაწერილი xet-core და hf_xet ინტეგრაცი
Hugging Face-ის Xet გუნდის ინოვაციური მიდგომა მონაცემთა გადაცემის დაჩქარებისთვის
Hugging Face-ის Xet გუნდი მონაცემთა დედუპლიკაციას თეორიიდან პრაქტიკაში ნერგავს, რათა მნიშვნელოვნად დააჩქაროს AI დეველოპერებისთვის Hub-ზე მონაცემების ატვირთვა და ჩამოტვირთვა. იმის ნაცვლად, რომ მხოლოდ დედუპლიკაციის მაქსიმიზაციაზე გაამახვილონ ყურადღება, რამაც შეიძლება დიდი დამატებითი ხარჯები გამოიწვიოს, მათი მიდგომა მიზნად ისახავს სწრაფი ექსპერიმენტებისა და თანამშრომლობის ხელშეწყობას. ეს გულისხმობს მონაცემთა გადაადგილების, შენახვისა და განვითარების მთლიანი პროცესის ოპტიმიზაციას ჩანკებზე დაფუძნებული
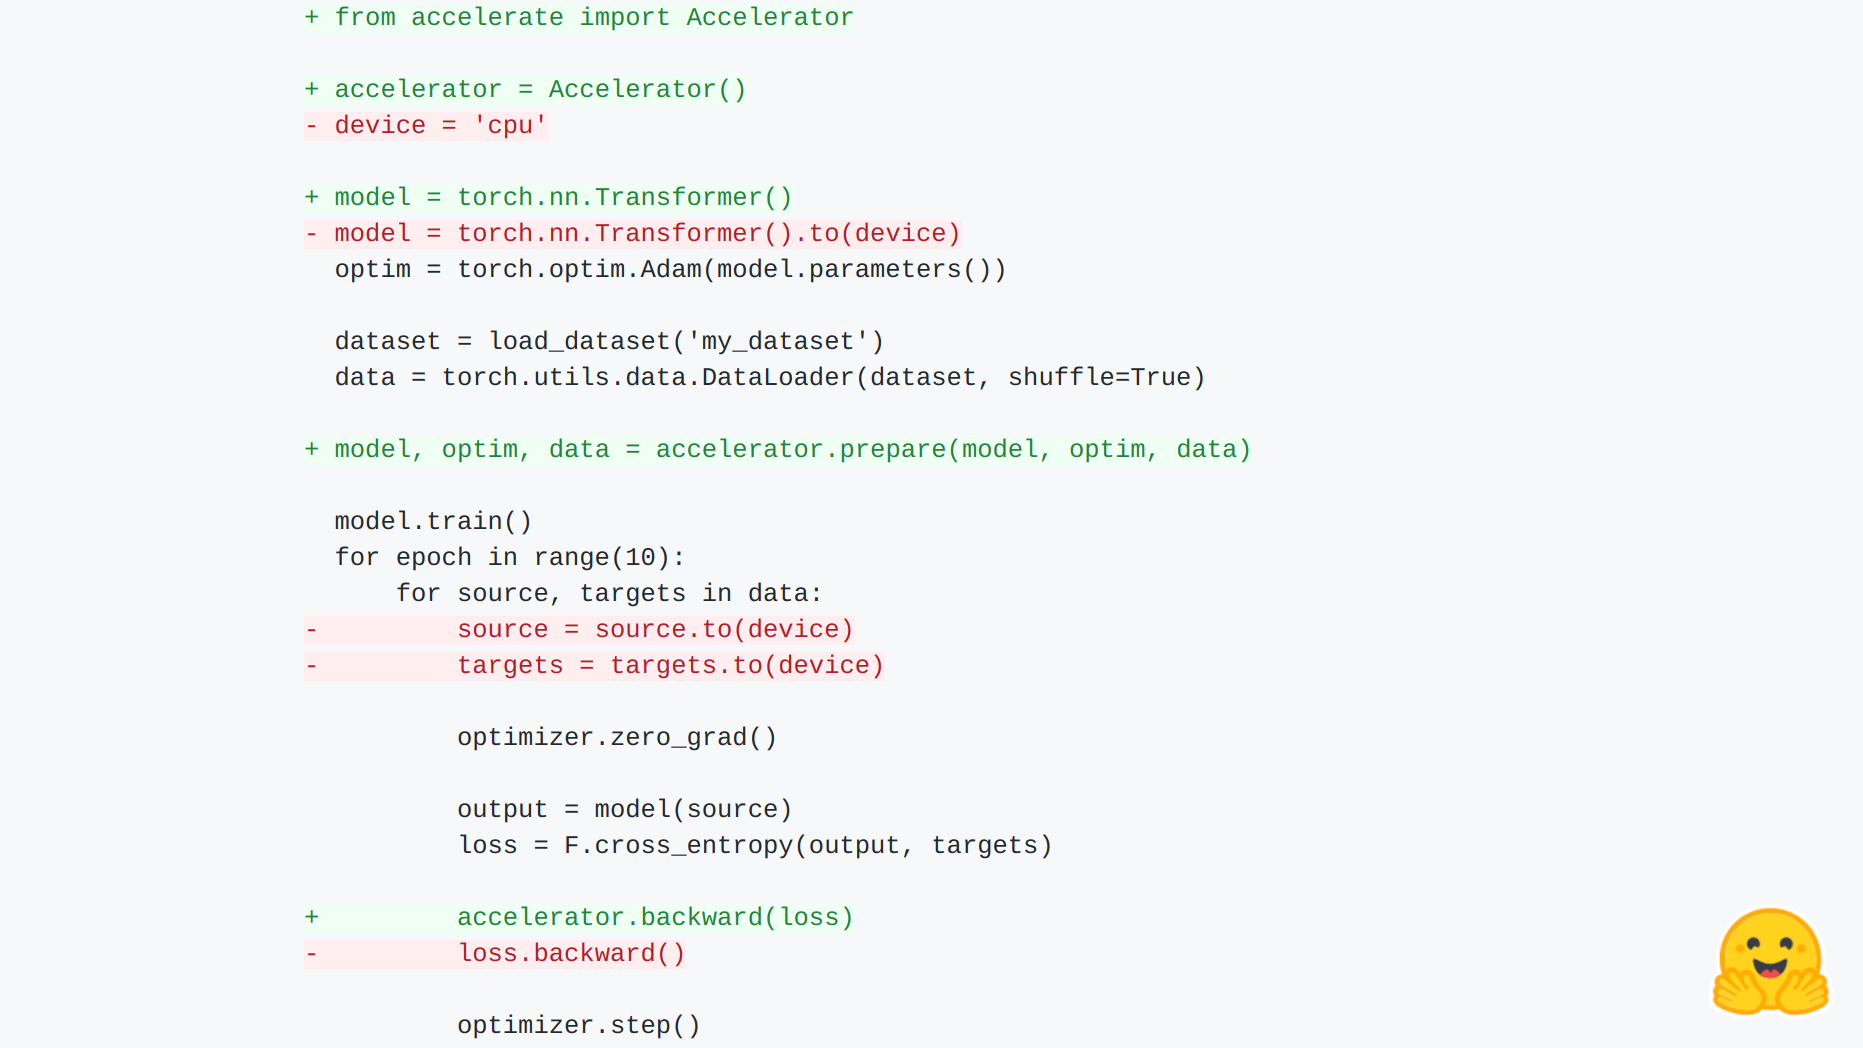
🤗 Accelerate: გაამარტივეთ PyTorch-ის განაწილებული ტრენინგი სრული კონტროლის შენარჩუნებით
🤗 Accelerate არის PyTorch-ის მომხმარებლებისთვის შექმნილი ბიბლიოთეკა, რომელიც ამარტივებს განაწილებული ტრენინგისა და შერეული სიზუსტის გამოყენებას. ის საშუალებას აძლევს მომხმარებლებს, სრულად აკონტროლონ თავიანთი სავარჯიშო ციკლები, თავიდან აიცილონ რთული შაბლონური კოდის წერა და მარტივად გაუშვან სკრიპტები სხვადასხვა მოწყობილობაზე (მრავალ-GPU, TPU) მინიმალური ცვლილებებით. ბიბლიოთეკა აბსტრაგირებს რუტინულ კოდს და უზრუნველყოფს მარტივ API-ს, რაც გაცილებით მოსახერხებელს ხდის რთული ტრენინგის კონფიგურაციებს.
T2I-Adapters-ის ახალი ერა: Stable Diffusion XL-ის გაუმჯობესებული შესაძლებლობები
ControlNet-ის მაღალი გამოთვლითი ხარჯებისა და ზომის პრობლემების საპასუხოდ, T2I-Adapters გვთავაზობს ეფექტურ გადაწყვეტას გამოსახულების გენერაციისთვის. ის უფრო კომპაქტურია და ხმაურის შემცირების პროცესში მხოლოდ ერთხელ მუშაობს. Diffusers-ის გუნდმა და T2I-Adapter-ის ავტორებმა Stable Diffusion XL-ისთვის (SDXL) T2I-Adapters-ის მხარდაჭერა დანერგეს, რამაც შესაძლებელი გახადა SDXL-ის მაღალი ხარისხის გენერაციის შენარჩუნება გაუმჯობესებული სიჩქარით, მეხსიერებითა და კონტროლის შესაძლებლობებით. ეს ბლოგპოსტი წარმოა

როგორ დავხვეწოთ Llama 2 70B PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკები და გამოწვევების გადაჭრა
ეს ბლოგპოსტი დეტალურად განიხილავს Llama 2 70B მოდელის დახვეწას PyTorch FSDP-ის გამოყენებით. სტატია ფოკუსირებულია ძირითად გამოწვევებზე, როგორიცაა CPU RAM-ის გადატვირთვა, შუალედური ჩეკპოინტების შენახვის სირთულეები და VRAM-ის მოხმარების ოპტიმიზაცია. წარმოდგენილია გადაწყვეტები Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მეშვეობით, ასევე განხილულია Accelerate-ის გამოყენება SLURM-თან ერთად. მოცემულია საჭირო რესურსები და კონფიგურაციები შედეგების რეპროდუცირებისთვის.
Llama 2 70B-ის დახვეწა PyTorch FSDP-ის გამოყენებით: საუკეთესო პრაქტიკა და გამოწვევების გადაწყვეტა
ამ ბლოგ-პოსტში განხილულია Llama 2 70B მოდელის დახვეწის პროცესი PyTorch FSDP-ის გამოყენებით, Hugging Face Transformers, Accelerate და TRL ინსტრუმენტების მოშველიებით. დეტალურად არის აღწერილი FSDP-ის მოქმედების პრინციპი, რომელიც ოპტიმიზატორის მდგომარეობებს, გრადიენტებსა და პარამეტრებს მოწყობილობებს შორის ანაწილებს. ასევე, განხილულია ძირითადი გამოწვევები, როგორიცაა CPU RAM-ის მაღალი მოთხოვნები, შუალედური საკონტროლო წერტილების ნელი შენახვა და NCCL Timeout შეცდომები. სტატია გვთავაზობს გადაწყვეტებს ტრე
DeDLOC: რევოლუციური მეთოდი ხელოვნური ინტელექტის კოლაბორაციული წვრთნისთვის
წარმოგიდგენთ DeDLOC-ს — ახალ მეთოდს კოლაბორაციული განაწილებული სწავლებისთვის, რომელსაც შეუძლია მოერგოს მონაწილეთა ქსელურ და აპარატურულ შეზღუდვებს. ჩვენ ვაჩვენებთ, რომ ის წარმატებით გამოიყენება რეალურ სცენარებში: 40 მოხალისის დახმარებით წინასწარ გაიწრთვნა sahajBERT, ბენგალური ენის მოდელი, რომელმაც მიაღწია თითქმის უახლეს ხარისხს, გაცილებით დიდ მოდელებთან შედარებით, რომლებიც ასობით მაღალი კლასის ამაჩქარებელს იყენებენ. ეს მეთოდი გვთავაზობს გამოსავალს ხელოვნური ინტელექტის მოდელების წვრთნის მაღალი ღირ

Hugging Face და IISc/ARTPARK ინდოეთის ლინგვისტური მრავალფეროვნების მხარდასაჭერად Vaani მონაცემთა ნაკრებს აფართოებენ
Hugging Face-ისა და IISc/ARTPARK-ის პარტნიორობა მიზნად ისახავს Vaani მონაცემთა ნაკრების ხელმისაწვდომობისა და გამოყენებადობის გაუმჯობესებას, რაც ხელს შეუწყობს AI სისტემების განვითარებას ინდოეთის მრავალფეროვანი ენების უკეთ გასაგებად. Project Vaani, რომელიც 2022 წელს IISc/ARTPARK-მა და Google-მა დაიწყეს, არის პიონერული ინიციატივა ღია კოდის მრავალმოდალური მონაცემთა ნაკრების შესაქმნელად, რომელიც ინდოეთის ლინგვისტურ მრავალფეროვნებას ასახავს. ამ მონაცემთა ნაკრებს უკვე მოიცავს 54 ენას და მოიცავს სპონტან
3D Gaussian Splatting: რევოლუციური ტექნოლოგია 3D გრაფიკაში
3D Gaussian Splatting არის უახლესი რასტერიზაციის ტექნიკა, რომელიც 3D გარემოს წარმოსახვის ახალ სტანდარტებს აწესებს. სამკუთხედების ნაცვლად გაუსიანების გამოყენებით, ის უზრუნველყოფს მაღალი ხარისხის სცენების რეალურ დროში რენდერინგს, რამაც დიდი ყურადღება მიიპყრო კომპიუტერული გრაფიკის სფეროში. სტატია დეტალურად განიხილავს ამ მეთოდის მუშაობის პრინციპებს, მისი მომზადების პროცესს და პოტენციურ გავლენას მომავალ ტექნოლოგიებზე, მათ შორის ინკარნირებული ხელოვნური ინტელექტის კვლევაზე.
3D Gaussian Splatting: რა არის და რატომ იპყრობს ის ყურადღებას?
3D Gaussian Splatting არის რასტერიზაციის ინოვაციური ტექნიკა, რომელიც საშუალებას იძლევა მაღალი ხარისხის 3D სცენების რეალურ დროში რენდერირებისთვის. ის იყენებს გაუსიანებს სამკუთხედების ნაცვლად, რათა შექმნას სივრცის მკვრივი წარმოდგენა. მეთოდი იწყება SfM-ით წერტილოვანი ღრუბლის შეფასებით, რასაც მოჰყვება გაუსიანებად გარდაქმნა და სტოქასტური გრადიენტული დაშვების გამოყენებით წვრთნა. მისი პოტენციალი მოიცავს ანიმაციას, ანარეკლებს და მნიშვნელოვან გავლენას Embodied AI-ის კვლევაზე, თუმცა მისი სრული ინტეგრაცია

Cohere For AI-მ Aya Vision წარადგინა: ახალი მულტილინგვური და მულტიმოდალური AI მოდელი
Cohere For AI-მ გამოუშვა Aya Vision, მულტილინგვური და მულტიმოდალური მოდელების უახლესი ოჯახი, რომელიც 23 ენაზე ენისა და ვიზუალური ინფორმაციის გაგებისთვის მძლავრი საფუძველია. ის ეფუძნება Aya Expanse-ის წარმატებას და აფართოებს მას მოწინავე ტექნიკების გამოყენებით. Aya Vision-ს შეუძლია შეასრულოს ისეთი ამოცანები, როგორიცაა გამოსახულების აღწერა, ვიზუალური შეკითხვებზე პასუხის გაცემა და ტექსტის გენერაცია. მოდელი მნიშვნელოვნად აღემატება თავისი ზომის ბევრ სხვა მოდელს და ხელმისაწვდომია ღია წონით კვლევისთვის

Hugging Face Hub-ის უსაფრთხოება JFrog-ის სკანერის ინტეგრაციით ძლიერდება
Hugging Face-მა JFrog-ის სკანერი თავის პლატფორმაზე დაამატა, რათა Hugging Face Hub-ზე უსაფრთხოება გააუმჯობესოს. ახალი სკანერი ამცირებს ცრუ დადებით შედეგებს და მოდელის წონებში არსებულ კოდს ღრმად აანალიზებს პოტენციური მავნე გამოყენების გამოსავლენად, განსაკუთრებით ისეთი მოწყვლადი სერიალიზაციის ფორმატებისთვის, როგორიცაა Pickle. ყველა საჯარო მოდელის რეპოზიტორი ავტომატურად დასკანირდება, რაც საზოგადოებას მოდელების უსაფრთხოდ გაზიარებაში ეხმარება.

Yaak-ი და LeRobot-ი L2D-ს, მსოფლიოში უდიდეს მულტიმოდალურ მონაცემთა ბაზას, წარადგენენ რობოტიკის ხელოვნური ინტელექტისთვის
კომპანია Yaak-მა, 🤗-ის LeRobot გუნდთან თანამშრომლობით, გამოაცხადა Learning to Drive (L2D) — მსოფლიოში უდიდესი მულტიმოდალური მონაცემთა ბაზა. L2D მიზნად ისახავს რობოტიკის ხელოვნური ინტელექტის პოტენციალის განბლოკვას ავტონომიური მართვის სფეროში, განსაკუთრებული მხარდაჭერით LeRobot-ის ტრენინგის პაიპლაინებისთვის. მონაცემთა ბაზა მოიცავს რეალურ მართვის სცენარებს 60 ელექტრომობილიდან, რომლებსაც გერმანიის 30 ქალაქში ავტოსკოლები მართავდნენ. ის განასხვავებს ექსპერტისა და სტუდენტის მართვის პოლიტიკებს, ბუნებრივ

Google-მა Gemma 3 წარადგინა: მულტიმოდალური ხელოვნური ინტელექტის მოდელების ახალი თაობა
Google-მა გამოუშვა Gemma 3, Gemma მოდელების ოჯახის ახალი ვერსია. ეს მოდელები, რომელთა პარამეტრების რაოდენობა 1 მილიარდიდან 27 მილიარდამდე მერყეობს, მხარს უჭერს 140-ზე მეტ ენას, შეუძლია როგორც გამოსახულებების, ისე ტექსტის დამუშავება, აქვს 128k ტოკენამდე კონტექსტური ფანჯარა და ინტეგრირებულია Hugging Face-ის ეკოსისტემასთან. Gemma 3-ის მოდელები, განსაკუთრებით Gemma-3-27B-IT, ეტალონურ ტესტებში აჭარბებს Gemma 2-27B IT-სა და Gemini 1.5-Pro-ს, რაც Google-ის ღია წონის დიდი ენობრივი მოდელების უახლეს მიღწე
ჩატის მოდელების ეფექტურობის გასაღები: ფორმატის მნიშვნელობა და Jinja შაბლონები
ეს სტატია განმარტავს, თუ რამდენად კრიტიკულია ჩატის ფორმატის შეხამება იმ ფორმატთან, რომელზეც ხელოვნური ინტელექტის მოდელები იყო გაწვრთნილი. არასწორი ფორმატის გამოყენება იწვევს მუშაობის სერიოზულ, ჩუმ გაუარესებას. Hugging Face-ის ტოკენიზატორების ახალი `chat_template` ატრიბუტი, რომელიც Jinja შაბლონებს იყენებს, მიზნად ისახავს ამ პრობლემის გადაჭრას საუბრების სწორად ფორმატირებით, რითაც უზრუნველყოფს მოდელის ოპტიმალურ მუშაობას და ხელს უშლის „განაწილების ცვლილებას“.
Wav2Vec2 და XLS-R: გარღვევა მეტყველების ავტომატური ამოცნობის ტექნოლოგიაში
2020 წელს გამოშვებული Wav2Vec2 მოდელიდან დაწყებული, Facebook AI-ის მრავალენოვანი XLSR ვერსიის გავლით, 2021 წლის ნოემბერში წარმოდგენილი XLS-R წარმოადგენს მნიშვნელოვან მიღწევას მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. XLS-R, რომელიც გაწვრთნილია 128 ენაზე ნახევარ მილიონ საათამდე აუდიო მონაცემზე, უზრუნველყოფს კონტექსტუალიზებულ მეტყველების წარმოდგენებს და აჩვენებს შთამბეჭდავ გაუმჯობესებას მეტყველების ამოცნობის, თარგმანისა და ენის იდენტიფიკაციის ამოცანებში. სტატია დეტალურად განმარტავს ამ მოდელე
კოდის გენერაციის მოდელის წვრთნის დეტალები: Python-ის მაგალითზე
სტატია დეტალურად აღწერს პითონის კოდის გენერაციის მოდელის შექმნისა და წვრთნის კომპლექსურ პროცესს. ის მოიცავს მონაცემთა მოპოვებას GitHub-იდან, 180 GB-იანი მონაცემთა ნაკრების გაწმენდას დუბლიკატებისაგან Codex-ის ევრისტიკის გამოყენებით (რაც 50 GB-იან გაწმენდილ ნაკრებს იძლევა). შემდეგ აღწერილია სპეციალიზებული ტოკენაიზერის წვრთნა, GPT-2 Large-ზე დაფუძნებული მოდელის ინიციალიზაცია სპეციალური კორექტირებით, და ეფექტიანი სავარჯიშო ციკლის დაყენება 🤗 Accelerate ბიბლიოთეკის გამოყენებით განაწილებული (multi-GPU)
Perceiver: ტრანსფორმერის არქიტექტურის შეზღუდვების დაძლევა ხელოვნურ ინტელექტში
ეს სტატია განიხილავს Transformer-ის მოდელის რევოლუციურ ზეგავლენას ხელოვნური ინტელექტის (AI) სფეროზე, თუმცა ხაზს უსვამს მის მნიშვნელოვან შეზღუდვას: თვითყურადღების მექანიზმის გამო, ის ცუდად მასშტაბირდება მაღალი განზომილების მონაცემებთან. სტატია წარმოგიდგენთ Perceiver-ის არქიტექტურას, როგორც ამ პრობლემის გადაჭრის საშუალებას. Perceiver იყენებს ლატენტურ ცვლადებსა და ჯვარედინ ყურადღებას, რაც უზრუნველყოფს ხაზოვან დამოკიდებულებას შეყვანის ზომაზე და საშუალებას აძლევს მას ეფექტურად იმუშაოს მრავალფეროვან მ