
„ZDNET გირჩევთ“: რას ნიშნავს ეს ზუსტად?
ZDNET-ის რეკომენდაციები ეფუძნება ხანგრძლივ ტესტირებას, კვლევასა და დამოუკიდებელ მიმოხილვებს, რაც უზრუნველყოფს, რომ სარედაქციო კონტენტი არასოდეს იყოს გავლენის ქვეშ რეკლამის განმთავსებლების მხრიდან. მათი მიზანია ზუსტი ინფორმაციის მიწოდება ჭკვიანური შესყიდვების გადაწყვეტილებების მისაღებად. 2026 წლის თებერვლის განახლებაში ZDNET განიხილავს საუკეთესო უფასო VPN სერვისებს და Proton VPN-ს ასახელებს საუკეთესო არჩევნად მისი მყარი უსაფრთხოების მახასიათებლების, „ლოგების არშენახვის“ პოლიტიკისა და გამტარუნარია

ZDNET-ის რეკომენდაციები: რა დგას მათ უკან და როგორ გამოვიყენოთ Windows-ის ძველი სარეზერვო ხელსაწყო
ZDNET დეტალურად განმარტავს, თუ რას ნიშნავს მათი „რეკომენდაციები“, რაც ეფუძნება საათობით ტესტირებას, კვლევასა და შედარებით შოპინგს. გამოცემა ხაზს უსვამს სარედაქციო დამოუკიდებლობასა და სიზუსტეს, რათა მკითხველს დაეხმაროს ჭკვიანი გადაწყვეტილებების მიღებაში. ამასთანავე, სტატია გთავაზობთ დეტალურ სახელმძღვანელოს Windows-ის ჩაშენებული, თუმცა მოძველებული სარეზერვო ხელსაწყოს გამოყენების შესახებ. განმარტებულია მისი ფუნქციონალი, შეზღუდვები, რჩევები მონაცემთა შენახვისთვის და გაფრთხილებები მისი მოძველების შეს

YouTube TV-ის აბონენტებო: აღმოაჩინეთ ფარული ფასდაკლება და დაზოგეთ 80 დოლარამდე
YouTube TV ზოგიერთ აბონენტს სთავაზობს ფარულ ფასდაკლებას, რომელიც 80 დოლარამდე დაზოგვის საშუალებას იძლევა. ამ შეთავაზების აღმოჩენა მარტივია, თუმცა ის ღიად არ არის რეკლამირებული და ძირითადად დესკტოპ ბრაუზერის საშუალებითაა ხელმისაწვდომი. სავარაუდოდ, ეს ფასდაკლება ფეხბურთის სეზონის დასრულებას უკავშირდება. ვინც წინა მსგავსი შეთავაზებით ისარგებლა, შესაძლოა ამჯერად აღარ იყოს უფლებამოსილი.

ხელოვნური ინტელექტის განვითარებას გამოთვლითი სიმძლავრე განაპირობებს და არა „საიდუმლო სოუსი“, აჩვენებს MIT-ის კვლევა
მასაჩუსეტსის ტექნოლოგიური ინსტიტუტის (MIT) მკვლევართა კვლევამ, რომელიც 809 დიდ ენობრივ მოდელს (LLM) მოიცავდა, აჩვენა, რომ მოდელების წარმადობის ზრდას ძირითადად განაპირობებს წვრთნისთვის გამოყენებული გამოთვლითი სიმძლავრის მოცულობა. დასკვნის თანახმად, ალგორითმული ინოვაციები ან კომპანიების უნიკალური „საიდუმლო სოუსი“ გაცილებით ნაკლებ გავლენას ახდენს, რაც ხაზს უსვამს გამოთვლით რესურსებზე მუდმივი წვდომის კრიტიკულ მნიშვნელობას ხელოვნური ინტელექტის სფეროში ლიდერობის შესანარჩუნებლად.
ხელოვნური ინტელექტის შეცდომების გამოსწორება: ინტერაქტიული ასისტენტის ტესტირება Keras Chatbot Arena-ზე
ეს სტატია აღწერს ექსპერიმენტს, რომელიც მიზნად ისახავს შეამოწმოს, რამდენად ეფექტურად შეუძლიათ დიდ ენობრივ მოდელებს (LLM) საკუთარი შეცდომების გამოსწორება მარტივი ინგლისური უკუკავშირის საფუძველზე. ავტორი ქმნის სპეციალურ გარემოს Gradio-ზე Spaces-ით, Keras-ის, JAX-ისა და TPUs-ის გამოყენებით, რათა ერთდროულად რამდენიმე ჩეთბოტთან იმუშაოს და შეაფასოს მათი უნარი, მოახდინონ API ზარების გენერირება და შეასწორონ შეცდომები. განხილულია ტექნიკური დეტალები და მიდგომები მოდელების მრავალ ბირთვზე ოპტიმიზაციისთვის, მ
ტრანსფორმერები დროითი სერიების პროგნოზირებაში: Autoformer-ის ინოვაცია და ეფექტურობის დადასტურება
ამ პოსტში განხილულია Transformer მოდელების ეფექტურობა დროითი სერიების პროგნოზირებისთვის. წარმოდგენილია Informer მოდელი, რომელმაც 2021 წლის AAAI-ის საუკეთესო ნაშრომის ჯილდო მოიპოვა. მიუხედავად იმისა, რომ ზოგიერთი კვლევა, მათ შორის DLinear-ის, ეჭვქვეშ აყენებს მათ ეფექტურობას, ემპირიული მონაცემები ადასტურებს, რომ ტრანსფორმერები, განსაკუთრებით Autoformer მოდელი, საგრძნობლად აჭარბებენ მარტივ ხაზოვან მოდელებს. სტატია დეტალურად განიხილავს Autoformer-ის საკვანძო ინოვაციებს: დაშლის ფენას (Decomposition L
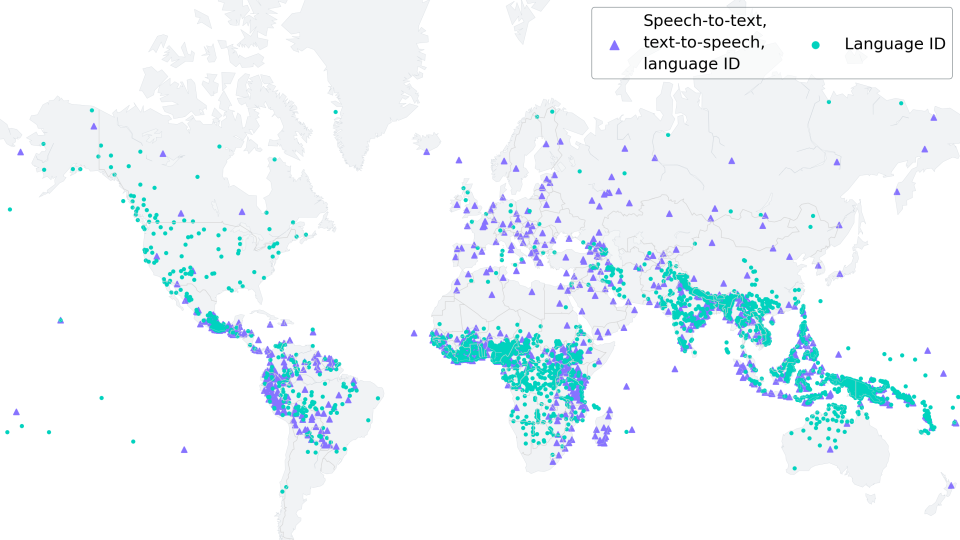
MMS: ხელოვნური ინტელექტი მრავალენოვანი მეტყველების ამოცნობისა და გადაშენების პირას მყოფი ენების გადასარჩენად
Meta AI-ის უახლესი მოდელი, Massive Multilingual Speech (MMS), რევოლუციას ახდენს მეტყველების ავტომატური ამოცნობის (ASR) სფეროში. მას შეუძლია 1,100-ზე მეტი ენის იდენტიფიცირება, ტრანსკრიფცია და გენერირება, მათ შორის გადაშენების პირას მყოფი ენებისაც. ადაპტერის გაწვრთნის ინოვაციური მეთოდის წყალობით, MMS აღწევს სიტყვების შეცდომის საოცრად დაბალ მაჩვენებლებს მინიმალური დამატებითი გაწვრთნით, რაც განსაკუთრებით ეფექტურია დაბალი რესურსების მქონე ენებისთვის. ეს ტექნოლოგია პოტენციურად გადამწყვეტ როლს ითამაშებ
Meta AI-ის რევოლუციური MMS მოდელი: 1100-ზე მეტი ენის მხარდაჭერა და გადაშენების პირას მყოფი ენების შენარჩუნება
Meta AI-მ წარმოადგინა Massive Multilingual Speech (MMS) მოდელი, რომელსაც შეუძლია 1100-ზე მეტი ენის ამოცნობა, ტრანსკრიფცია და გენერაცია. ეს ინოვაციური სისტემა, რომელიც იყენებს „ადაპტერის“ წვრთნის მეთოდს, მნიშვნელოვნად ამცირებს შეცდომის მაჩვენებელს მცირე რესურსების მქონე ენებისთვის და ხელს უწყობს გადაშენების პირას მყოფი ენების შენარჩუნებას, რადგან მათთვის წერილობითი ჩანაწერების შექმნასა და მშობლიურ ენაზე კომუნიკაციას უწყობს ხელს. MMS-ის ადაპტერის წვრთნა უფრო ეფექტურია მეხსიერების თვალსაზრისით, უფრ

როგორ გავიგოთ და ოპტიმიზაცია გავუკეთოთ GPU მეხსიერებას PyTorch-ში
ეს გაკვეთილი ეტაპობრივად განმარტავს, თუ როგორ მოვახდინოთ GPU მეხსიერების გამოყენების ვიზუალიზაცია და გაგება PyTorch-ში ტრენინგის დროს. ის მოიცავს მეხსიერების მოთხოვნების შეფასებას, გამოყენების ოპტიმიზაციას PyTorch-ის პროფილის ხელსაწყოების მეშვეობით და დეტალურ ანალიზს იმის შესახებ, თუ როგორ იქცევა მეხსიერება მოდელის შექმნის, წინსვლის, უკუგადაცემის და ოპტიმიზატორის ნაბიჯების განმავლობაში, მათ შორის დიდი ენობრივი მოდელების (LLM) რეალურ სცენარებში.

დიდი ენობრივი მოდელების (LLMs) ნახშირბადის კვალი: ოფიციალური ვერსიები vs. საზოგადოებრივი „ფაინ-ტიუნები“
ბოლო ერთი წლის განმავლობაში, გაიზარდა ცნობიერება იმის შესახებ, რომ დიდი ენობრივი მოდელების (LLMs) გამოყენებას ტექსტის გენერირებისთვის მნიშვნელოვანი გარემოსდაცვითი გავლენა აქვს, განსაკუთრებით ინფერენციის ფაზაში. Open LLM Leaderboard-ში ნახშირბადის ემისიების შეფასებების ინტეგრირებით, მიზანია გამჭვირვალობის უზრუნველყოფა და მოდელების შემქმნელების წახალისება, დააბალანსონ შესრულება გარემოსდაცვით პასუხისმგებლობასთან. კვლევამ გამოავლინა, რომ საზოგადოების მიერ შექმნილი „ფაინ-ტიუნები“ ხშირად უფრო ნახშირბა
vdr-2b-multi-v1: მრავალენოვანი ჩაშენების მოდელი ვიზუალური დოკუმენტების ეფექტური მოძიებისთვის
Hugging Face-ის მიერ წარდგენილია vdr-2b-multi-v1, მრავალენოვანი ჩაშენების მოდელი, რომელიც განკუთვნილია ვიზუალური დოკუმენტების მოძიებისთვის სხვადასხვა ენასა და დომენში. ეს მოდელი აკოდირებს დოკუმენტის გვერდის სქრინშოტებს მკვრივ ერთვექტორულ წარმოდგენებად, რაც შესაძლებელს ხდის ვიზუალურად მდიდარი მრავალენოვანი დოკუმენტების ძიებას და მოთხოვნას OCR-ის, მონაცემთა ამოღების კონვეიერების ან დანაწილების გარეშე. იგი აგებულია MrLight/dse-qwen2-2b-mrl-v1-ზე და გაწვრთნილია ვრცელ, თვითშექმნილ მონაცემთა ბაზაზე. L
ხელოვნური ინტელექტის აგენტების აღზევება: სარგებელი, რისკები და მომავლის გზა
დიდი ენობრივი მოდელების (დემ) შესაძლებლობების სწრაფმა განვითარებამ განაპირობა „ხელოვნური ინტელექტის აგენტების“ (ხი აგენტები) გაჩენა – სისტემების, რომლებსაც შეუძლიათ ციფრულ სამყაროში ავტონომიური მოქმედება, მომხმარებლის მიზნების შესაბამისად. სტატია იკვლევს ამ ტექნოლოგიის დაპირებას, მათ შორის ამოცანების კომბინირების, ახალი სიტუაციების ანალიზისა და მიზნების მისაღწევად გაუგებარი ქმედებების განხორციელების უნარს. თუმცა, ყურადღება ექცევა მნიშვნელოვან რისკებსაც, განსაკუთრებით სისტემის ავტონომიის ზრდასთან

ახალი მეთოდი სტატიკური ემბედინგის მოდელების საწვრთნელად: 100-400-ჯერ უფრო სწრაფი CPU-ზე
ეს ბლოგპოსტი წარმოგიდგენთ მეთოდს სტატიკური ემბედინგის მოდელების საწვრთნელად, რომლებიც CPU-ზე 100-400-ჯერ უფრო სწრაფად მუშაობენ, ვიდრე უახლესი მოდელები, ხარისხის უმეტესი ნაწილის შენარჩუნებით. ეს ხსნის უამრავ საინტერესო გამოყენების შესაძლებლობას, მათ შორის მოწყობილობაზე და ბრაუზერში გაშვებას, Edge Computing-ს, დაბალენერგეტიკულ და ჩაშენებულ აპლიკაციებს. ჩვენ გამოვიყენეთ ეს მიდგომა ორი უკიდურესად ეფექტური ემბედინგის მოდელის მოსამზადებლად: sentence-transformers/static-retrieval-mrl-en-v1 ინგლისური ინ
Hugging Face-ის TGI წარმოგიდგენთ ახალ Backends არქიტექტურას: გამარტივებული LLM-ების განთავსება და გაუმჯობესებული წარმადობა
Hugging Face-მა წარმოადგინა TGI Backends, ახალი არქიტექტურა Text-Generation-Inference (TGI)-ისთვის, რომელიც მიზნად ისახავს LLM-ების განთავსების პროცესის გამარტივებას და ოპტიმალური წარმადობის უზრუნველყოფას. ეს სიახლე აერთიანებს სხვადასხვა ინფერენსინგის გადაწყვეტებს ერთიან ფრონტენდ ფენაში, რაც მომხმარებლებს საშუალებას აძლევს მარტივად შეცვალონ ბეკენდები მათი მოდელირების, აპარატურის და წარმადობის მოთხოვნების შესაბამისად.
EsperBERTo: ხელოვნური ინტელექტის მოდელის შექმნა და ტრენინგი ესპერანტოზე
ამ პოსტში წარმოდგენილია, თუ როგორ ხდება ხელოვნური ინტელექტის მცირე ენობრივი მოდელის, EsperBERTo-ს, შექმნა და ტრენინგი ესპერანტოზე. მოდელი, რომელიც ზომით DistilBERT-ის მსგავსია, იყენებს სპეციალურად ოპტიმიზებულ ტოკენიზატორს და შემდგომში ადაპტირდება სიტყვის ნაწილების ამოცნობის ამოცანისთვის. ესპერანტო, როგორც ხელოვნური და ადვილად სასწავლი ენა, შერჩეულია დემონსტრაციისთვის, რათა ნათლად გამოჩნდეს მოდელის შესაძლებლობები.

დიდი ენობრივი მოდელების კონტექსტის ფანჯრის გამოწვევები: KV Cache-ის მეხსიერების ოპტიმიზაცია KVPress-ით
დიდი ენობრივი მოდელების (LLM) გაფართოებული კონტექსტის ფანჯრები წარმოუდგენელ შესაძლებლობებს იძლევა, თუმცა KV Cache-ის მიერ მოხმარებული მეხსიერების მართვას ართულებს. მაგალითად, 1 მილიონი ტოკენის დამუშავება Llama 3-70B-ით 330 GB-ს მოითხოვს მხოლოდ KV Cache-ისთვის. NVIDIA-ს მიერ შემუშავებული KVPress ამ პრობლემის გადასაჭრელად კომპრესიის ინოვაციურ ტექნიკას გვთავაზობს, რომელიც მეხსიერების მოხმარებას ამცირებს მოდელის სიზუსტის შენარჩუნებით.
LLM-ების კონფიდენციალურობისა და ინტელექტუალური საკუთრების დაცვა: Zama-ს გადაწყვეტა ჰომომორფული დაშიფვრით
დიდი ენობრივი მოდელების (LLM) ფართო გამოყენების მიუხედავად, მომხმარებლის მონაცემთა კონფიდენციალურობის საკითხი კვლავ გადაუჭრელ პრობლემად რჩება, რადგან არსებობს სენსიტიური ინფორმაციის LLM სერვისის მიმწოდებელთან გაჟონვის რისკი. Zama გვთავაზობს ინოვაციურ გადაწყვეტას სრულად ჰომომორფული დაშიფვრის (FHE) გამოყენებით, რომელიც საშუალებას აძლევს LLM-ებს, იმუშაონ დაშიფრულ მონაცემებზე. ეს მეთოდი იცავს როგორც მომხმარებლის კონფიდენციალურობას, ასევე მოდელის ინტელექტუალურ საკუთრებას, პროგნოზების ხარისხის შენარჩუ
Hugging Face Hub-ის მონაცემთა ნაკრებების მეტამონაცემების გაუმჯობესება მანქანური სწავლების საშუალებით
Hugging Face Hub, როგორც მანქანური სწავლების რესურსების ცენტრალური საცავი, აუმჯობესებს მონაცემთა ნაკრებების მეტამონაცემებს ხელოვნური ინტელექტის გამოყენებით. ახალი ინიციატივის ფარგლებში, მანქანური სწავლების ალგორითმები ამოიცნობენ ენას იმ მონაცემთა ნაკრებებში, რომლებსაც არ აქვთ ენის მეტამონაცემები, ხოლო ავტომატიზებული „ბიბლიოთეკარი-ბოტები“ ამ ინფორმაციას მეტამონაცემებში დაამატებენ. ეს პროექტი მიზნად ისახავს რესურსების მოძიების გაადვილებას და Hub-ზე წარმოდგენილი ენობრივი მიკერძოებების უკეთ გაგებას.

Hugging Face აერთიანებს სერვერულ ინფერენსზე წვდომას ახალი პარტნიორობითა და ფუნქციებით
Hugging Face-მა, საკუთარი სერვერული Inference API-ის ხანგრძლივი მასპინძლობის შემდეგ, გადაწყვიტა ფოკუსირება თანამშრომლობაზე, დიდი მონაცემთა ნაკრებებისა და მოდელების შენახვაზე, ვერსიონირებასა და გავრცელებაზე. ამის პარალელურად, კომპანია მომხმარებლებს სთავაზობს მარტივ და ერთიან წვდომას სერვერულ ინფერენსზე წამყვანი პროვაიდერების მეშვეობით. ეს ნაბიჯი აძლიერებს AI მოდელების ხელმისაწვდომობას, გვთავაზობს მოქნილ ფასებს პირდაპირი და მარშრუტიზებული მოთხოვნებისთვის, და უზრუნველყოფს დამატებით ბენეფიტებს PRO მ

ხელოვნური ინტელექტი ხელოვნებაში: ღია კოდის მოდელების გარდამტეხი წელი (2024-ის მიღწევები და 2025-ის მოლოდინები)
ბოლო რამდენიმე წელი, განსაკუთრებით კი 2024, გარდამტეხი აღმოჩნდა ხელოვნური ინტელექტის (AI) ღია კოდის მოდელებისა და ინსტრუმენტებისთვის ხელოვნებითი გამოყენების კუთხით. ამ მიმოხილვაში განვიხილავთ 2024 წლის მთავარ მიღწევებს, როგორიცაა DiT არქიტექტურის და Flux.1-ის გამოჩენა, პერსონალიზაციის ტექნიკების გაუმჯობესება და „ნულოვანი ოპტიმიზაციის“ მეთოდების აღმასვლა გამოსახულების გენერაციაში. სტატია ასევე მიმოიხილავს ვიდეოს გენერაციის სფეროში არსებულ გამოწვევებს და 2025 წლის მოლოდინებს, რომელიც AI და ხელოვნე
PyTorch/XLA და Hugging Face: გაუმჯობესებული მხარდაჭერა Cloud TPU-ებზე მოდელების ვარჯიშისთვის
PyTorch-TPU პროექტის ფარგლებში, რომელიც Facebook PyTorch-ისა და Google TPU-ის გუნდების თანამშრომლობით დაიწყო 2019 წელს, Hugging Face-თან ახალი ინტეგრაცია განხორციელდა. ეს ინტეგრაცია PyTorch-ის მომხმარებლებს საშუალებას აძლევს, ეფექტურად გააფართოვონ თავიანთი ხელოვნური ინტელექტის მოდელები Cloud TPU-ებზე, Hugging Face-ის ტრენერების ნაცნობი ინტერფეისის შენარჩუნებით. ეს სიახლე მნიშვნელოვნად ამარტივებს და აჩქარებს ღრმა სწავლის მოდელების ვარჯიშის პროცესს.

Adyen-ისა და Hugging Face-ის DABstep: ხელოვნური ინტელექტის მოდელების გამოწვევა მონაცემთა ანალიზში
Adyen-მა და Hugging Face-მა ერთობლივად შექმნეს DABstep – ახალი ბენჩმარკი, რომელიც 450-ზე მეტ მონაცემთა ანალიზის ამოცანას მოიცავს. მისი მიზანია ხელოვნური ინტელექტის (AI) უახლესი მოდელების შესაძლებლობების შეფასება მრავალსაფეხურიან აზროვნებაში. კვლევამ აჩვენა, რომ მიუხედავად განვითარებისა, AI აგენტები DABstep-ზე მხოლოდ 16%-იან სიზუსტეს აღწევენ, რაც მიუთითებს ამ სფეროში მნიშვნელოვანი პროგრესის საჭიროებაზე. ბენჩმარკი მოითხოვს, რომ AI მოდელებმა გამოავლინონ ტექნიკური უნარები, დომენური ცოდნა და კრეატიულ

Physical Intelligence-ი წარმოგიდგენთ π0-ს და π0-FAST-ს: რობოტების მრავალმხრივი კონტროლისთვის
კომპანია Physical Intelligence-მა შექმნა π0 და π0-FAST – პროტოტიპული გენერალისტი რობოტ მოდელები, რომლებიც მიზნად ისახავს ხელოვნურ ინტელექტსა და ფიზიკურ სამყაროს შორის არსებული უფსკრულის ამოვსებას. ეს ხედვა-ენა-მოქმედების (VLA) მოდელები, რომლებიც გაწვრთნილია მრავალფეროვან რობოტულ მონაცემებზე, გამოირჩევიან მრავალმხრივი კონტროლით სხვადასხვა ამოცანასა და რობოტის ტიპებზე, ნაკადის შესაბამისობის (flow matching) მეთოდის გამოყენებით ეფექტური, რეალურ დროში მოქმედების გენერაციისთვის. ისინი სძლევენ ტრადიციუ
Wav2Vec2: ახალი ეპოქა მეტყველების ავტომატურ ამოცნობაში
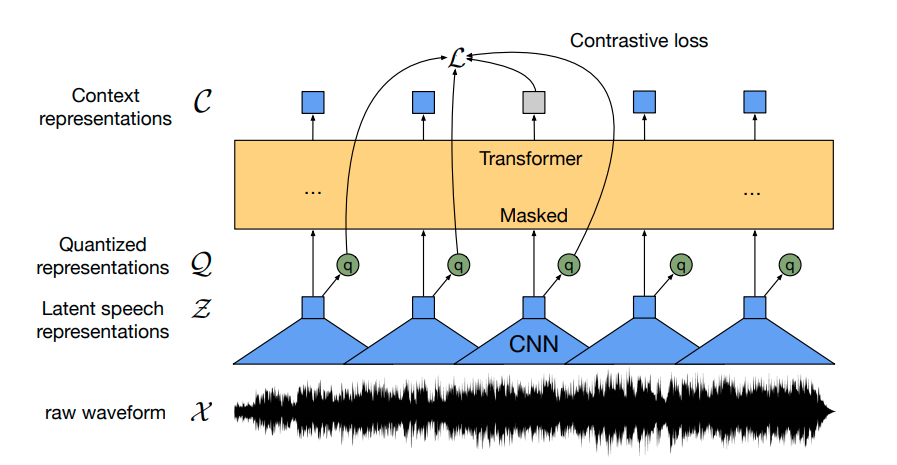
Wav2Vec2 წარმოადგენს ინოვაციურ მოდელს, რომელიც იყენებს კონტრასტულ წინასწარ წვრთნას 50 000 საათზე მეტი არადანიშნული მეტყველების მონაცემებიდან მძლავრი წარმოდგენების შესასწავლად. BERT-ის მსგავსად, ის ნიღბავს ფუნქციის ვექტორებს კონტექსტუალიზებული წარმოდგენების მისაღებად. მოდელმა აჩვენა კონკურენტული შედეგები თანამედროვე ავტომატური მეტყველების ამოცნობის (ASR) სისტემებთან, მინიმალური, სულ რაღაც 10 წუთის, დანიშნულ მონაცემებზე დამატებითი წვრთნის შემდეგ. ეს სტატია დეტალურად განმარტავს Wav2Vec2-ის წინასწარ