
Hugging Face აძლიერებს ხელოვნური ინტელექტის მოდელების გაშვებას Whisper-ის დახმარებით: საზოგადოება და ეფექტურობა ცენტრში
Hugging Face-ი თავის Inference Endpoints-ს უფრო საზოგადოებაზე ორიენტირებულს ხდის, რაც ნებისმიერს აძლევს საშუალებას, წვლილი შეიტანოს ხელოვნური ინტელექტის მოდელების ეფექტურ განლაგებაში. განსაკუთრებული ყურადღება ექცევა Whisper მოდელებს, რომელთა გაშვებაც ოპტიმიზებულია vLLM-ის, CUDA-ს გრაფიკების და დინამიური კვანტიზაციის გამოყენებით, რის შედეგადაც Whisper Large V3-ისთვის შესრულების სიჩქარე (RTFx) თითქმის 8-ჯერ იზრდება. პლატფორმა უზრუნველყოფს მარტივ განლაგებას და რეალურ დროში ტრანსკრიფციის აპლიკაციები
Hugging Face-ის ინფერენსის საბოლოო წერტილები: Whisper მოდელების საოცარი ოპტიმიზაცია საზოგადოებისთვის
Hugging Face ხსნის თავის ინფერენსის საბოლოო წერტილებს (Inference Endpoints) საზოგადოებისთვის, რაც ხელს უწყობს ღია კოდის წვლილს და AI მოდელების ოპტიმიზებულ განთავსებას. ახალი Whisper-ის საბოლოო წერტილი, vLLM პროექტის გამოყენებით, აჩვენებს თითქმის 8-ჯერ გაუმჯობესებას RTFx-ში, ტრანსკრიფციის ხარისხის დაკარგვის გარეშე. პლატფორმა ასევე გთავაზობთ მოწინავე ოპტიმიზაციებს NVIDIA GPU-ებზე და საშუალებას აძლევს მომხმარებლებს, მარტივად განათავსონ საკუთარი ASR კონვეიერები.

Kaggle აუმჯობესებს Hugging Face მოდელების ინტეგრაციას: უკეთესი ხილვადობა და გამოყენებადობა
Kaggle-მა დღეიდან დაიწყო ახალი ინტეგრაცია Hugging Face-თან, რომელიც მნიშვნელოვნად აუმჯობესებს Hugging Face-ის მოდელების აღმოჩენადობასა და გამოყენებას Kaggle-ის პლატფორმაზე. ეს ინტეგრაცია მომხმარებლებს საშუალებას აძლევს მარტივად გადავიდნენ მოდელებს შორის და გამოიყენონ ისინი Kaggle Notebook-ებში წინასწარ შევსებული კოდის ფრაგმენტებით. Kaggle ასევე აქტიურად მუშაობს ოფლაინ შეჯიბრებებში Hugging Face მოდელების უწყვეტი გამოყენების გადაწყვეტილებაზე, მონაცემთა უსაფრთხოების მაღალი სტანდარტების დაცვით.
ღია კოდის LLM-ები აგენტურ სისტემებს აძლიერებენ: Mixtral-მა GPT-3.5-საც კი აჯობა
ღია კოდის დიდი ენობრივი მოდელები (LLM) ახლა მიაღწიეს ისეთ დონეს, რომ შეუძლიათ აგენტური სამუშაო პროცესების მართვა, Mixtral-8x7B-მა კი ტესტებში GPT-3.5-საც კი აჯობა. სტატია წარმოგიდგენთ `smolagents`-ს, ახალ ბიბლიოთეკას აგენტების შესაქმნელად, და განმარტავს, თუ როგორ შეიძლება LLM-ების ინტეგრირება ხელსაწყოებთან „LLM აგენტების“ შესაქმნელად. ის დეტალურად განიხილავს ReAct აგენტების (მსჯელობა + მოქმედება) კონცეფციას, აჩვენებს მათ შექმნას LangChain-ის ChatHuggingFace კლასის გამოყენებით და წარმოადგენს ტესტ
წამყვანი ML დირექტორების შეხედულებები: ხელოვნური ინტელექტის გავლენა ინდუსტრიებზე
მანქანური სწავლების (ML) და მონაცემთა მეცნიერების დირექტორებს უაღრესად რთული მოთხოვნები აქვთ თავიანთ როლებში. ამ სტატიების სერიაში, ჩვენ წარმოგიდგენთ ML დირექტორების უნიკალურ შეხედულებებს მიმდინარე ML ტენდენციებსა და ინდუსტრიულ განვითარებაზე, დაწყებული ჯანდაცვიდან ფინანსებამდე, ელექტრონულ კომერციამდე და სხვა სფეროებამდე. ისინი გაგვიზიარებენ გამოცდილებას ML-ის პრაქტიკული გამოყენების შესახებ რეალურ სამყაროში, ისეთი ინოვაციების ჩათვლით, როგორიცაა ნახშირბადის ემისიების შემცირება ტრანსპორტირებაში ან
Hugging Face და Google Cloud-ი აძლიერებენ პარტნიორობას ღია AI-ს დემოკრატიზაციისთვის
Hugging Face-ი და Google Cloud-ი ღრმა სტრატეგიულ პარტნიორობას აცხადებენ, რომლის მიზანია კომპანიებს საშუალება მისცეს, შექმნან საკუთარი ხელოვნური ინტელექტი ღია მოდელებისა და ღია კოდის ტექნოლოგიების გამოყენებით. თანამშრომლობა მოიცავს ღია მეცნიერებას, ღია კოდს, ღრუბლოვან სერვისებსა და აპარატურას, რათა მომხმარებლებს გაუმარტივდეს Hugging Face-ის უახლესი ღია მოდელების და Google Cloud-ის ინფრასტრუქტურის (როგორიცაა Vertex AI და TPU) გამოყენება. პარტნიორობა გააძლიერებს AI კვლევის ხელმისაწვდომობას და უზრუნ
როგორ გავიგოთ მომხმარებლის საჭიროებები HuggingFace AutoTrain-ისა და Kili-ის დახმარებით: აქტიური სწავლების დანერგვა
ეს სტატია იკვლევს ავტომატური მანქანური სწავლების (Auto ML) და აქტიური სწავლების გამოყენებას მომხმარებლის საჭიროებების გასაგებად, ტექსტის კლასიფიკაციისა და სენტიმენტების ანალიზზე ფოკუსირებით. ის დეტალურად აღწერს, თუ როგორ უნდა შეიქმნას აქტიური სწავლების მილსადენი HuggingFace AutoTrain-ისა და Kili-ის, მონაცემებზე ორიენტირებული AI ვარჯიშის პლატფორმის გამოყენებით. პროცესი მოიცავს მომხმარებლის მიმოხილვების ანოტირებას, კლასიფიკაციის მოდელების შექმნას (როგორც AutoTrain-ით, ისე მის გარეშე) და სენტიმენტე

Microsoft Azure-ი Hugging Face-თან თანამშრომლობას აფართოებს: 10,000-ზე მეტი AI მოდელი Azure AI Foundry-ზე
Microsoft-მა და Hugging Face-მა გააფართოვეს სტრატეგიული თანამშრომლობა, რის შედეგადაც Azure AI Foundry-ზე 10,000-ზე მეტი Hugging Face-ის ღია მოდელი გახდა ხელმისაწვდომი. ეს ინიციატივა დეველოპერებსა და საწარმოებს საშუალებას აძლევს, მარტივად განათავსონ AI აპლიკაციები ტექსტთან, აუდიოსთან და გამოსახულებებთან სამუშაოდ, ღია კოდის გამჭვირვალობისა და Azure-ის უსაფრთხო, საწარმოო დონის ინფრასტრუქტურის გამოყენებით. თანამშრომლობა მიზნად ისახავს AI-ის ინოვაციის დაჩქარებას და ორგანიზაციებს საკუთარი AI ბედის კონ

დიდი ML მოდელების სწავლება: FullyShardedDataParallel (FSDP) შესაძლებლობები
მანქანური სწავლების (ML) მოდელების მუდმივად მზარდი მასშტაბები აპარატურულ შეზღუდვებს წარმოქმნის. ეს სტატია იკვლევს, თუ როგორ უმკლავდება განაწილებული სწავლება, კერძოდ PyTorch-ის FullyShardedDataParallel (FSDP) ფუნქცია, ამ გამოწვევას. ჩვენ ვადარებთ FSDP-ის წარმადობას DDP-სთან GPT-2 მოდელების გამოყენებით, ვაჩვენებთ FSDP-ის უნარს, მოახდინოს უფრო დიდი პაკეტის ზომების დამუშავება და კიდევ უფრო დიდი მოდელების სწავლება, რითაც ხელმისაწვდომს ხდის მძლავრ ML ტექნოლოგიებს.
დიდი ML მოდელების ეფექტური ვარჯიში: PyTorch FSDP-ის გამოყენება განაწილებულ სისტემებში
მანქანური სწავლების (ML) მოდელების მზარდი ზომისა და პარამეტრების გამო, სპეციალისტებს უჭირთ მათი ვარჯიში სტანდარტულ აპარატურაზე, მიუხედავად იმისა, რომ დიდი მოდელები უფრო სწრაფად სწავლობენ და მაღალ წარმადობას ავლენენ. ამ გამოწვევის საპასუხოდ, განაწილებული სწავლება ხდება გადამწყვეტი. ეს სტატია იკვლევს მონაცემთა პარალელიზმს ZeRO კონცეფციის გამოყენებით და კონკრეტულად PyTorch-ის უახლეს ფუნქციას, FullyShardedDataParallel (FSDP)-ს. DeepSpeed-ისა და FairScale-ის მიერ დანერგილი ZeRO-ის იდეები, PyTorch-ში
ღრმა განმტკიცებითი სწავლება: ხელოვნური ინტელექტის მომავალი (სრული კურსის პირველი ნაწილი)
ეს სტატია ღრმა განმტკიცებითი სწავლების კურსის შესავალი ნაწილია, რომელიც ხელოვნური ინტელექტის ერთ-ერთ ყველაზე მომხიბვლელ სფეროს ეხება. აქ განმარტებულია, თუ როგორ სწავლობს აგენტი გარემოში ქცევას მოქმედებების შესრულებითა და შედეგების დანახვით. განიხილება დარგის მნიშვნელოვანი მიღწევები და მოწოდებულია დეტალური ინფორმაცია უფასო კურსის შესახებ, სადაც შეისწავლით თეორიასა და პრაქტიკას ცნობილი ბიბლიოთეკების გამოყენებით.

Intel Xeon-ზე StarCoder-ის 7X-ზე მეტი დაჩქარება: LLM-ების ოპტიმიზაციის ახალი ეტაპი
კოდის გენერირების მოდელების მზარდი პოპულარობის ფონზე, ეს სტატია წარმოგიდგენთ დიდი ენობრივი მოდელების (LLM) ოპტიმიზაციის უახლეს შედეგებს Intel Xeon-ზე, განსაკუთრებული აქცენტით პოპულარულ StarCoder მოდელზე. ნაჩვენებია StarCoder-15B მოდელის 7-ჯერ მეტი ინფერენსის დაჩქარება Intel-ის მე-4 თაობის Xeon პროცესორებზე 8-ბიტიანი და 4-ბიტიანი კვანტიზაციისა და ასისტენტური გენერაციის ინტეგრაციის გზით. კვლევა ასევე ხაზს უსვამს SmoothQuant ალგორითმის გამოყენებას და მის დადებით გავლენას მოდელის სიზუსტესა და წარმად
Hugging Face Hub-ი აფართოებს fastai-ის შესაძლებლობებს: ღრმა სწავლის მოდელების გაზიარება ერთი ხაზით
Hugging Face-ი, რომლის მიზანია მანქანური სწავლების დემოკრატიზაცია, სიამაყით აცხადებს fastai-თან ახალ ინტეგრაციას. ეს ინტეგრაცია fastai-ის მომხმარებლებს საშუალებას აძლევს, მარტივად გააზიარონ და ატვირთონ ღრმა სწავლის მოდელები Hugging Face Hub-ზე Python-ის ერთი ხაზის გამოყენებით. სტატიაში ხაზგასმულია fastai-ის წვლილი ღრმა სწავლების ხელმისაწვდომობაში და აღწერილია Hub-ის, როგორც მოდელების, მონაცემთა ნაკრებებისა და ML დემოების ცენტრალური პლატფორმის, უპირატესობები. ინტეგრაცია მოიცავს ვერსიის კონტროლს G
ახალი LLM ლიდერბორდი რეალურ ბიზნეს სცენარებში ენის მოდელების შეფასებისთვის
ეს ლიდერბორდი მიზნად ისახავს ენის დიდი მოდელების (LLM) მუშაობის შეფასებას რეალური ბიზნეს ამოცანების კონტექსტში. ის მხარს უჭერს 6 მრავალფეროვან დავალებას, როგორიცაა FinanceBench და იურიდიული კონფიდენციალურობა, და ზომავს მოდელების ეფექტურობას ისეთი მეტრიკებით, როგორიცაა სიზუსტე, ჩართულობა და ტოქსიკურობა. ლიდერბორდი შემუშავდა იმისათვის, რომ დაეხმაროს მომხმარებლებს პრაქტიკული გამოყენებისთვის საუკეთესო მოდელის არჩევაში და აქტიურად ცდილობს თავიდან აიცილოს ტესტ-კომპლექტის დაბინძურება ზოგიერთი მონაცემთა
PatchTST: ინოვაციური მოდელი დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით
ICLR 2023-ზე წარდგენილი PatchTST მოდელი რევოლუციურ მიდგომას გვთავაზობს დროითი რიგების გრძელვადიანი პროგნოზირებისთვის ტრანსფორმერების გამოყენებით. მოდელი ეფუძნება ინდივიდუალური დროითი რიგების „პაჩებად“ დაყოფას, რაც არაერთ სარგებელს იძლევა. სტატიაში აღწერილია PatchTST-ის ვარჯიში Electricity მონაცემთა ნაკრებზე და მისი ტრანსფერული სწავლის შესაძლებლობები ETTh1 მონაცემთა ნაკრებზე, სადაც ნაჩვენებია მნიშვნელოვანი გაუმჯობესება ნულოვანი სწავლის (zero-shot), წრფივი გამოძიების (linear probing) და სრული ფაინ
დიდი ენობრივი მოდელების (LLMs) მაღალეფექტური განთავსება: TGI და AWS Inferentia2 Amazon SageMaker-ში
ტექსტის გენერირების ინფერენცია (TGI) წარმოადგენს სპეციალურად შექმნილ გადაწყვეტას დიდი ენობრივი მოდელების (LLMs) მასშტაბური განთავსებისა და სერვისისთვის. TGI უზრუნველყოფს მაღალეფექტურ ტექსტის გენერაციას Tensor Parallelism-ისა და უწყვეტი დაჯგუფების გამოყენებით Llama-ს, Mistral-ის და სხვა პოპულარული ღია LLM-ებისთვის. AWS Inferentia2-თან ინტეგრაცია Amazon SageMaker-ში TGI-ს აქცევს მძლავრ ალტერნატივად GPU-ებისთვის LLM აპლიკაციების შესაქმნელად. ეს ინტეგრაცია ამარტივებს მოდელების განთავსებას და შენარჩუ
ხელოვნური ინტელექტის მორგება ღია მოდელებზე: კონსტიტუციური AI და ახალი ინსტრუმენტი llm-swarm
სტატია წარმოგიდგენთ კონსტიტუციურ ხელოვნურ ინტელექტს (CAI), როგორც დიდი ენობრივი მოდელების (LLMs) მომართვის ინოვაციურ ტექნიკას მომხმარებლის მიერ განსაზღვრული პრინციპების გამოყენებით, რაც მნიშვნელოვნად ამცირებს ძვირადღირებული ადამიანური უკუკავშირის საჭიროებას. იგი გვთავაზობს CAI-ის ღია მოდელებით განხორციელების სრულყოფილ გზამკვლევს, მათ შორის ახალ ინსტრუმენტ llm-swarm-ს მასშტაბური სინთეზური მონაცემების გენერირებისთვის. განხილულია CAI მონაცემთა ნაკრებების შექმნისა და მოდელების, მაგალითად Mistral-7B-
NPHardEval: ახალი დინამიური ჩარჩო დიდი ენობრივი მოდელების მსჯელობის უნარის შესაფასებლად
NPHardEval წარმოგიდგენთ ინოვაციურ, დინამიურ და სირთულეზე დაფუძნებულ ჩარჩოს დიდი ენობრივი მოდელების (LLMs) მსჯელობის უნარების მკაცრი შეფასებისთვის. ის მოიცავს 900 ალგორითმულ კითხვას NP-რთული სირთულის კლასიდან და ქვედა დონეებიდან, რომლებიც ყოველთვიურად განახლდება მოდელების ზედმეტი მორგების თავიდან ასაცილებლად. NPHardEval გამოირჩევა გამოთვლითი სირთულის კლასების გამოყენებით, რაც LLM-ის აზროვნების უნარების რაოდენობრივ და მტკიცე შეფასებას უზრუნველყოფს, რეალურ სამყაროში არსებული გამოწვევების ასახვით.

LLM-ების ოპტიმიზაცია: TRL-ის ახალი მიდგომა GRPO სწავლების მეხსიერების შესამცირებლად
დიდი ენობრივი მოდელების (LLM) დახვეწა განმტკიცებითი სწავლის (RL) გამოყენებით გადამწყვეტია რთული ქცევების მისაღწევად. ტრადიციულად ამისთვის გამოიყენება PPO ალგორითმი RLHF-თან ერთად, რაც, თუმცა, რესურსმომხმარებელია და მრავალი მოდელის მეხსიერებაში ჩატვირთვას მოითხოვს. DeepSeek-ის R1 მოდელთან ერთად პოპულარობას იძენს ჯგუფური შედარებითი პოლიტიკის ოპტიმიზაცია (GRPO), რომელიც იყენებს შემოწმებად ჯილდოს ფუნქციებს გარე ჯილდოს მოდელის გარეშე, რაც მნიშვნელოვან გაუმჯობესებას იძლევა. მიუხედავად ამისა, RL სწავლე
Gradio 3.0 და Gradio Blocks: მანქანური სწავლების დემოების შექმნის რევოლუცია
2019 წლიდან Gradio-ს ბიბლიოთეკით 600 000-ზე მეტი მანქანური სწავლების დემო აშენდა. დღეს წარმოდგენილია Gradio 3.0, რომელიც მოიცავს ფრონტენდის სრულ განახლებას, თანამედროვე ტექნოლოგიების (როგორიცაა Svelte) გამოყენებით, რამაც გამოიწვია სწრაფი მუშაობა და დახვეწილი ვიზუალური ესთეტიკა. გარდა ამისა, ახალი დაბალდონიანი ენა, Gradio Blocks, დეველოპერებს საშუალებას აძლევს შექმნან კომპლექსური, მორგებული ვებ აპლიკაციები უშუალოდ Python-ში, რაც უზრუნველყოფს განლაგებისა და მონაცემთა ნაკადზე მეტ კონტროლს. ამ მოვლე
წარმოდგენილია SegMoE: ექსპერტთა ნარევი Stable Diffusion მოდელებისთვის
SegMoE წარმოადგენს ინოვაციურ არქიტექტურას, რომელიც აერთიანებს მრავალ მოდელს ერთში Feed-Forward ფენების MoE ფენებით ჩანაცვლებით. ეს საშუალებას აძლევს Stable Diffusion მოდელებს უფრო ეფექტურად და ზუსტად გენერირდეს სურათები. ახალი პაკეტით შესაძლებელია საკუთარი MoE მოდელების მარტივად შექმნა და იგი აუმჯობესებს „prompt“ გაგებას, თუმცა აღინიშნება VRAM-ის მაღალი მოხმარება და გარკვეული სისუსტე ერთეულ SD მოდელებთან შედარებით.

ხელოვნური ინტელექტის აგენტების ევოლუცია: სტრუქტურული კოდის გენერაციის უპირატესობა
კვლევა იკვლევს ხელოვნური ინტელექტის აგენტების არქიტექტურის ევოლუციას, ადარებს ტრადიციულ JSON აგენტებს, CodeAgent-ებს და ახალ სტრუქტურულ CodeAgent-ებს. ეს უკანასკნელი აერთიანებს კოდის მოქნილობასა და სტრუქტურული გამომავალი მონაცემების სანდოობას, რაც მნიშვნელოვნად ამცირებს ანალიზის (parsing) შეცდომებს და აუმჯობესებს აგენტების მუშაობას. ნაჩვენებია, რომ სტრუქტურული გენერაცია აიძულებს აგენტებს, უფრო მკაფიოდ გამოხატონ თავიანთი მსჯელობა, თუმცა აღინიშნება, რომ ამ მიდგომის სრული პოტენციალი ვლინდება მაღალი
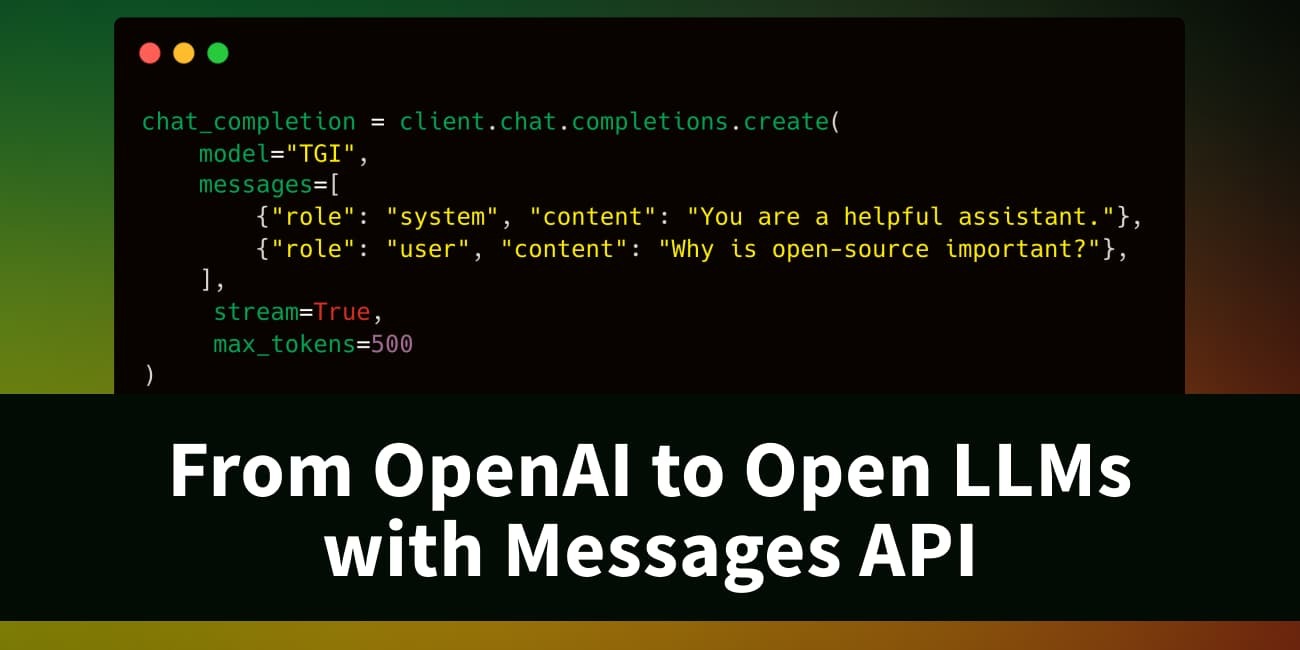
TGI-ის Messages API: უწყვეტი გადასვლა ღია LLM-ებზე OpenAI-ის თავსებადობით
TGI (Text Generation Inference) 1.4.0 ვერსიიდან მოყოლებული, გთავაზობთ Messages API-ს, რომელიც სრულად თავსებადია OpenAI-ის Chat Completion API-თან. ეს ინოვაცია მომხმარებლებს საშუალებას აძლევს, მარტივად და შეუფერხებლად გადავიდნენ OpenAI-ის მოდელებიდან ღია დიდი ენის მოდელებზე (LLM-ებზე), არსებული კლიენტის ბიბლიოთეკების ან მესამე მხარის ხელსაწყოების (როგორიცაა LangChain და LlamaIndex) გამოყენებით. სტატია დეტალურად აღწერს მოდელების Hugging Face Inference Endpoints-ზე განთავსების, ტექნიკური კონფიგურაც
TRL და vLLM-ის კოლოკაცია: ხელოვნური ინტელექტის მოდელების წვრთნის რევოლუცია GPU-ების ოპტიმიზაციით
ტრადიციულად, დიდი ენობრივი მოდელების (LLM) GRPO ალგორითმით წვრთნა, vLLM-ის სერვერის რეჟიმში გამოყენებისას, გრაფიკული პროცესორების (GPU) არაეფექტურ გამოყენებას იწვევდა. TRL-ის v0.18.0 ვერსიიდან, vLLM-თან ერთობლივი მუშაობის (კოლოკაციის) მხარდაჭერა საშუალებას იძლევა, წვრთნა და ინფერენცია ერთსა და იმავე GPU-ებზე განხორციელდეს. ეს მიდგომა მნიშვნელოვნად ამცირებს უქმ დროს, აუმჯობესებს გამტარუნარიანობას და ამარტივებს განლაგებას, რაც LLM-ების წვრთნას უფრო სწრაფს, ეკონომიურს და მასშტაბირებადს ხდის.