Hugging Face-ი აფართოებს Deep Reinforcement Learning-ის ეკოსისტემას Unity ML-Agents-ით: ახალი თამაში და საზოგადოება
Hugging Face-ი, Unity ML-Agents-ის გამოყენებით, ღრმა გაძლიერებითი სწავლების მკვლევრებისა და ენთუზიასტებისთვის ეკოსისტემას აფართოებს. ამ ინიციატივის ფარგლებში წარმოდგენილია თამაში „Snowball Fight“ და ახალი Discord სერვერი საზოგადოების ჩართულობისთვის.
კოდის გენერაციის მოდელის წვრთნის დეტალები: Python-ის მაგალითზე
სტატია დეტალურად აღწერს პითონის კოდის გენერაციის მოდელის შექმნისა და წვრთნის კომპლექსურ პროცესს. ის მოიცავს მონაცემთა მოპოვებას GitHub-იდან, 180 GB-იანი მონაცემთა ნაკრების გაწმენდას დუბლიკატებისაგან Codex-ის ევრისტიკის გამოყენებით (რაც 50 GB-იან გაწმენდილ ნაკრებს იძლევა). შემდეგ აღწერილია სპეციალიზებული ტოკენაიზერის წვრთნა, GPT-2 Large-ზე დაფუძნებული მოდელის ინიციალიზაცია სპეციალური კორექტირებით, და ეფექტიანი სავარჯიშო ციკლის დაყენება 🤗 Accelerate ბიბლიოთეკის გამოყენებით განაწილებული (multi-GPU)

Embedding მოდელების ოპტიმალური განთავსება Hugging Face Inference Endpoints-ზე: მაღალი წარმადობა და ხარჯთეფექტურობა
ამ სტატიაში განხილულია, თუ როგორ განვათავსოთ ღია კოდის Embedding მოდელები Hugging Face Inference Endpoints-ზე Text Embedding Inference (TEI) გადაწყვეტის გამოყენებით. ხაზგასმულია Embedding მოდელების უპირატესობა დიდი ენობრივი მოდელების (LLM-ების) მიმართ ზომისა და ინფერენსის სიჩქარის კუთხით. სტატია დეტალურად აღწერს Inference Endpoints-ის მახასიათებლებს, როგორიცაა ავტომატური მასშტაბირება და ნულამდე მასშტაბირება, და წარმოადგენს TEI-ს, როგორც მაღალი წარმადობისა და ხარჯთეფექტურობის გარანტს. ნაჩვენებია,

DeepSeek-V3-0324: AI მოდელის ჩუმი გამოშვება გაუმჯობესებული შესაძლებლობებით
ამ კვირაში DeepSeek-მა ჩუმად გამოუშვა DeepSeek-V3-ის განახლებული ვერსია, DeepSeek-V3-0324, რომელიც ახლა MIT ლიცენზიით არის ხელმისაწვდომი. ეს ახალი მოდელი, რომელიც ორიგინალ V3-თან ერთნაირ არქიტექტურას იზიარებს, ფოკუსირებულია ინსტრუქციების შესრულების, კოდირებისა და მათემატიკური შესაძლებლობების გაუმჯობესებაზე. ის აჩვენებს ძლიერ შედეგებს ბენჩმარკებში, ხშირად GPT-4.5-ის დონეზე. სტატია ასევე განიხილავს მოდელის გამოყენების მეთოდებსა და უსაფრთხოების მნიშვნელოვან ასპექტებს, როგორიცაა ჩამოტვირთვის უსაფრთხ
GPT-J-ის ეფექტური დეპლოირება Amazon SageMaker-ისა და Hugging Face-ის გამოყენებით
სტატია განიხილავს EleutherAI-ის GPT-J მოდელის წარმოებაში ინტეგრაციის გამოწვევებს, განსაკუთრებით მეხსიერების მოხმარებისა და ჩატვირთვის ხანგრძლივი დროის თვალსაზრისით. ის წარმოადგენს გადაწყვეტას Amazon SageMaker-ისა და Hugging Face Inference Toolkit-ის გამოყენებით, PyTorch-ის მოდელების შენახვის ოპტიმიზებული მეთოდის მეშვეობით, რაც მნიშვნელოვნად ამცირებს ჩატვირთვის დროს (1 წუთი და 23 წამიდან 7.7 წამამდე) და GPT-J-ს საწარმოო სცენარებისთვის თავსებადს ხდის.
NLP მოდელების შედარებითი ანალიზი: RoBERTa, Mistral-7b და Llama-2-7b LoRA-ს გამოყენებით კატასტროფის ტვიტების კლასიფიკაციისთვის
ბუნებრივი ენის დამუშავების (NLP) სწრაფად განვითარებად სამყაროში, ენობრივი მოდელების შედარება გადამწყვეტია მათი ოპტიმალური გამოყენებისთვის კონკრეტულ ამოცანებში. ეს პოსტი ეძღვნება სამი მოდელის – RoBERTa, Mistral-7b და Llama-2-7b – შედარებას კატასტროფების შესახებ ტვიტების კლასიფიკაციის პრობლემაში. კვლევაში გამოყენებულია PEFT (Parameter-Efficient Fine-Tuning) ტექნიკის LoRA (Low-Rank Adaptation) მეთოდი, რომელიც მნიშვნელოვნად ამცირებს პარამეტრების რაოდენობას მოდელის წვრილად მორგებისას. განხილულია თითო
Llama 2-ის ეფექტური განთავსება AWS Inferentia2-ზე Hugging Face Optimum Neuron-ის მეშვეობით
Hugging Face-ის ბლოგზე ადრე წარდგენილი AWS Inferentia2-ის გაფართოების შედეგად, ახლა შესაძლებელია დიდი ენობრივი მოდელების (LLM) განთავსება ტექსტის გენერაციისთვის AWS Inferentia2 ინსტანციებზე Optimum Neuron-ის გამოყენებით. სტატია დეტალურად აღწერს Llama 2-ის განთავსების პროცესს, გთავაზობთ რეკომენდაციებს Hugging Face Neuron Deep Learning AMI-ზე ან Amazon SageMaker-ზე განთავსების შესახებ და განმარტავს მოდელების კომპილაციასა და ექსპორტს. ასევე, მოცემულია Inferentia2-ზე ტექსტის გენერაციის ეფექტურობის ა

LLM შეფასების კრიტიკული ხარვეზები DROP ბენჩმარკში: ნორმალიზაციისა და „გაჩერების ტოკენების“ პრობლემა
Open LLM Leaderboard-ზე DROP ბენჩმარკის დამატების შემდეგ, მოდელების f1-ქულებმა მოულოდნელად დაბალი შედეგები აჩვენა. გამოკვლევამ გამოავლინა ორი ძირითადი პრობლემა: არასწორი ნორმალიზაცია, რომელიც უგულებელყოფდა რიცხვით პასუხებს არასტანდარტული სიცარიელის სიმბოლოების გამო, და წერტილის (.) „გაჩერების ტოკენად“ გამოყენება. ამ ხარვეზების აღმოფხვრა, მათ შორის \n სიმბოლოზე დაყოფა, მნიშვნელოვნად აუმჯობესებს ქულების კორელაციას საერთო შესრულებასთან. თუმცა, სრული ხელახალი შეფასება ძვირი და შრომატევადია, რაც მიუთ
Wav2Vec2: ტრანსფორმერული მოდელების შეზღუდვების დაძლევა ხანგრძლივი აუდიო ფაილების დამუშავებისას
Wav2Vec2, როგორც ტრანსფორმერული მოდელი, აწყდება თანმიმდევრობის სიგრძის შეზღუდვებს, რაც იწვევს პრობლემებს დიდ აუდიო ფაილებთან მუშაობისას. ტრადიციული დაყოფის მეთოდები ხშირად ამცირებს შედეგების ხარისხს კონტექსტის დაკარგვის გამო. ეს სტატია განმარტავს, თუ როგორ იძლევა Wav2Vec2-ის CTC სტრუქტურა საშუალებას, განხორციელდეს მდგრადი მეტყველების ამოცნობა ძალიან დიდ ფაილებზე, „striding“ ტექნიკის გამოყენებით. ასევე განხილულია ენის მოდელების (LM) ინტეგრაცია WER მაჩვენებლის გასაუმჯობესებლად და მოდელის გამოყენებ

Visual Salamandra: ახალი თაობის მულტიმოდალური AI ევროპული ენების აქცენტით
ენის ტექნოლოგიების ლაბორატორიამ წარმოადგინა Visual Salamandra, ინოვაციური მულტიმოდალური AI მოდელი, რომელიც აერთიანებს Google-ის SigLIP ენკოდერს Salamandra Instructed 7B მოდელთან. ეს სისტემა შექმნილია ვიზუალურ და ტექსტურ მონაცემებს შორის ხარვეზის შესავსებად, რის შედეგადაც მას შეუძლია გაიგოს და შექმნას კონტექსტურად ზუსტი პასუხები მრავალფეროვანი შეყვანის საფუძველზე, მათ შორის სურათებიდან, ვიდეოებიდან და ტექსტური ინსტრუქციებიდან. Visual Salamandra გამოირჩევა მრავალენოვანი ინკლუზიურობით, განსაკუთრები
ემოციური ანალიზი: ყოვლისმომცველი გზამკვლევი პითონის გამოყენებით
ეს სტატია განმარტავს, თუ როგორ გახდა ემოციური ანალიზი, რომელიც ადრე მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, ახლა ყველასთვის გამოსაყენებელი ხელოვნური ინტელექტის (AI) ინსტრუმენტების წყალობით. იგი მოიცავს ემოციური ანალიზის არსს, მის გამოყენებას მონაცემების ფართომასშტაბიანი დამუშავებისთვის და გაჩვენებთ, თუ როგორ უნდა დაიწყოთ პითონით, Hugging Face Hub-ზე არსებული მოდელების გამოყენებით, მანქანური სწავლის წინასწარი გამოცდილების გარეშე.
სენტიმენტების ანალიზი ყველასთვის: როგორ გამოვიყენოთ ხელოვნური ინტელექტის თანამედროვე ხელსაწყოები
წარსულში სენტიმენტების ანალიზი მხოლოდ სპეციალისტებისთვის იყო ხელმისაწვდომი, მაგრამ ხელოვნური ინტელექტის საზოგადოების მიერ შექმნილმა ინოვაციურმა ხელსაწყოებმა ის ყველასთვის მარტივად ხელმისაწვდომი გახადა. ეს სახელმძღვანელო გვიჩვენებს, თუ როგორ შეიძლება Python-ისა და Hugging Face Hub-ის გამოყენებით ტექსტის ემოციური პოლარობის იდენტიფიცირება, მონაცემების მასშტაბური დამუშავება და მოდელების ოპტიმიზაცია კონკრეტული ამოცანებისთვის, გამოცდილების გარეშეც კი.

გამოსახულებების ტოკენიზაცია და ViT მოდელების დახვეწა გამოსახულების კლასიფიკაციისთვის
ეს სტატია განიხილავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია ტრანსფორმატორის მოდელებისთვის, ნატურალური ენის დამუშავების (NLP) ამოცანების ანალოგიით. დეტალურად არის აღწერილი 🤗 datasets-ისა და 🤗 transformers-ის გამოყენებით ViT (Vision Transformer) მოდელის წინასწარი წვრთნა და დახვეწა გამოსახულების კლასიფიკაციის ამოცანებისთვის. მოცემულია ინსტრუქციები მონაცემთა ჩამოტვირთვის, დამუშავების, გამოსახულების ტრანსფორმაციებისა და წვრთნის კონვეიერის დაყენების შესახებ, მათ შორის ისეთი კომპონენტების, როგორიც
ხელოვნური ინტელექტი: გამოსახულებების ტოკენიზაცია და ViT მოდელების წვრთნა
ეს სტატია განმარტავს, თუ როგორ ხდება გამოსახულებების ტოკენიზაცია წინადადებების მსგავსად, რაც მათ საშუალებას აძლევს, დამუშავდეს ტრანსფორმერული მოდელებით. დეტალურად არის აღწერილი 🤗 datasets-ის გამოყენებით მონაცემთა მომზადება, ViTImageProcessor-ის ინტეგრირება და წინასწარ გაწვრთნილი ViT მოდელების დაზუსტება. მიმოხილულია ტრენინგის კონფიგურაციის, შეფასების მეტრიკების განსაზღვრისა და ეფექტური წვრთნის კონვეიერის აგების პროცესები, რაც მნიშვნელოვან წინსვლას წარმოადგენს გამოსახულების კლასიფიკაციის ამოცანებშ

Cohere Hugging Face Hub-ზე: ინოვაციური AI მოდელები საწარმოებისთვის
კომპანია Cohere Hugging Face Hub-ის მხარდაჭერილი ინფერენს პროვაიდერი გახდა, რაც პირველი შემთხვევაა, როდესაც მოდელის შემქმნელი პირდაპირ ემსახურება საკუთარ მოდელებს პლატფორმაზე. Cohere, თავისი ყოვლისმომცველი, უსაფრთხო AI გადაწყვეტილებებით, რომელიც მოიცავს გენერაციულ AI-ს, ემბედინგსა და რანჟირების მოდელებს, განკუთვნილია საწარმოო გამოყენებისთვის. მათი მოდელები, როგორებიცაა Command R+, Aya, Command R და Aya Vision, ახლა ხელმისაწვდომია უსერვერო ინფერენსისთვის, რაც ხაზს უსვამს მრავალენოვან მხარდაჭერას,

დიდი ენობრივი მოდელების ოპტიმიზაცია: ინფერენციის ფაზების გამოწვევები
კომპანია TNG-ი დიდი ენობრივი მოდელების (LLM) თვით-ჰოსტინგის გამოცდილებას გვიზიარებს, სადაც 24 H100 GPU-ს კლასტერი საათში 5000-ზე მეტ ინფერენციას ამუშავებს. სტატიაში დეტალურად არის განხილული ტოკენების გენერაციის ავტორეგრესიული ბუნება, KV ქეშის როლი და განსხვავება 'პრეფილის' (პირველი ტოკენის გენერაცია) და 'დეკოდირების' (შემდგომი ტოკენების გენერაცია) ფაზებს შორის. განმარტებულია, თუ როგორ მოქმედებს ეს ფაზები შეყოვნებაზე (latency) და გამტარუნარიანობაზე (throughput), და როგორ გამოიყენება GPU რესურსები
სემანტიკური სეგმენტაცია SegFormer-ით: ავტონომიური სისტემების გაუმჯობესება
სემანტიკური სეგმენტაცია გამოსახულების თითოეული პიქსელის კლასიფიკაციის ამოცანაა, რაც გამოსახულების ანალიზის უფრო ზუსტი მეთოდია. მას ფართო გამოყენება აქვს ისეთ სფეროებში, როგორიცაა სამედიცინო გამოსახულება და ავტონომიური მართვა. სტატია განიხილავს SegFormer მოდელს, რომელიც იყენებს ტრანსფორმერებს სემანტიკური სეგმენტაციისთვის და წარმოადგენს უახლეს მიღწევებს ამ სფეროში. ნაჩვენებია, თუ როგორ იქმნება და მუშავდება სპეციალიზებული მონაცემთა ნაკრები პიცის მიმწოდებელი რობოტისთვის, რაც უზრუნველყოფს მის ეფექტურ
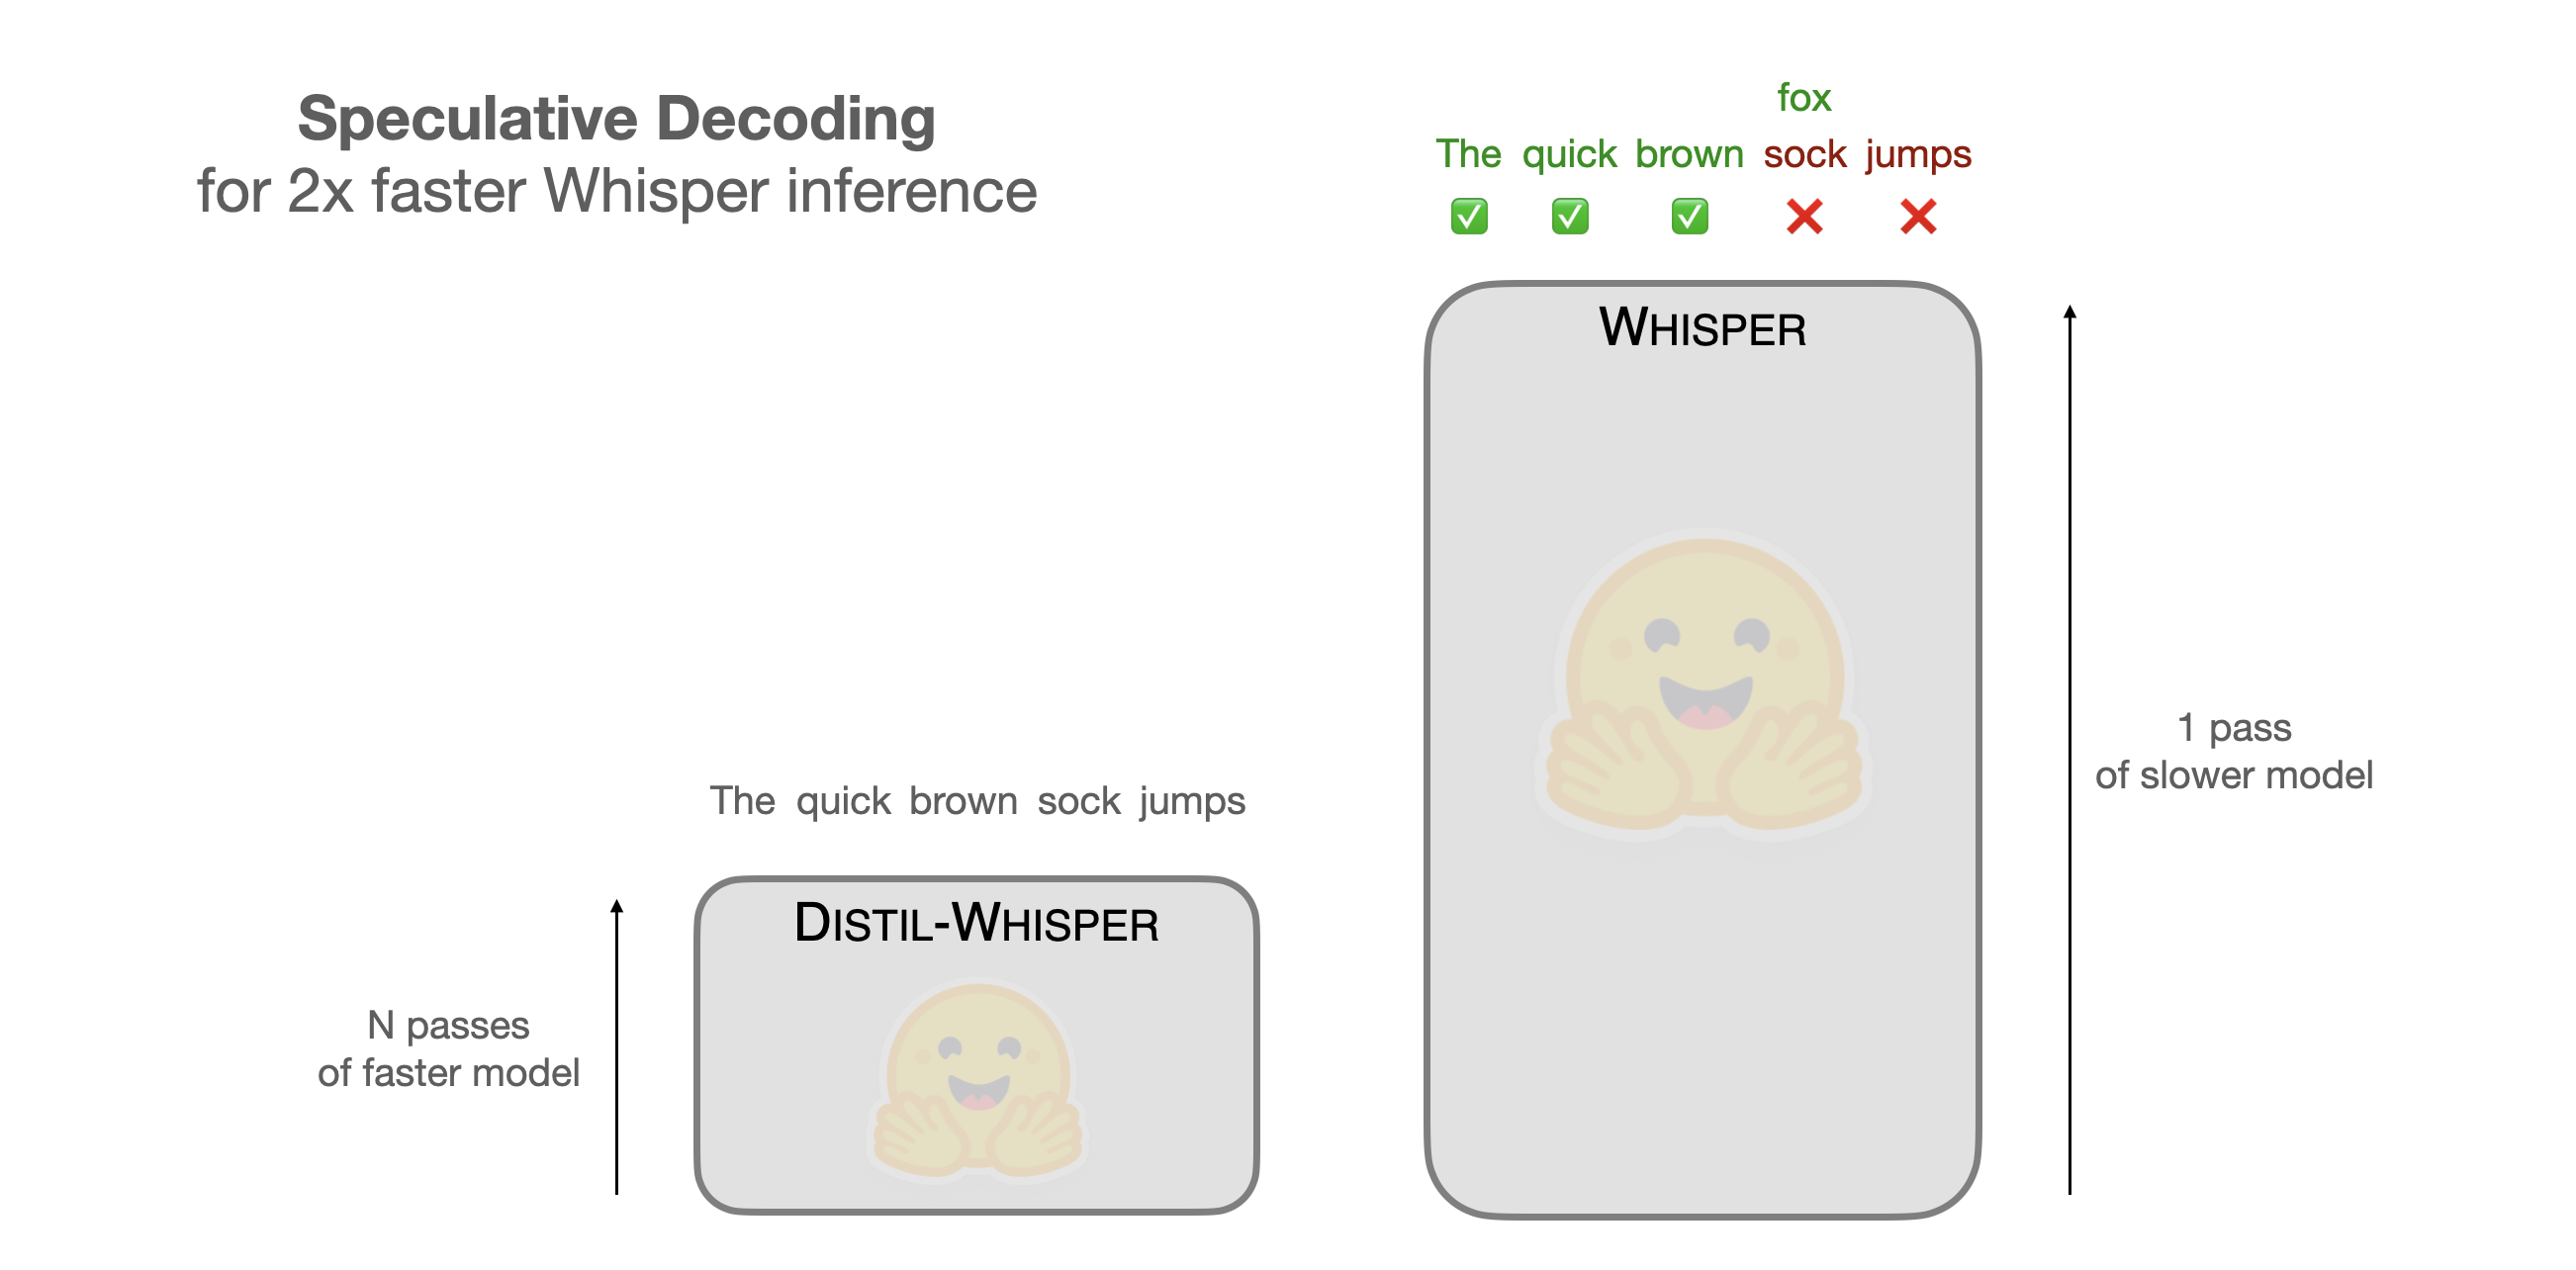
Whisper-ის სიჩქარის გაორმაგება: Speculative Decoding-ის ინოვაციური მეთოდი
მიუხედავად Whisper-ის ტრანსკრიფციის გამორჩეული სიზუსტისა, მისი დამუშავების (ინფერენციის) დრო საკმაოდ ნელია. ეს სტატია წარმოადგენს Speculative Decoding-ის მეთოდს, რომელიც Whisper-ის ინფერენციის დროს 2-ჯერ ამცირებს, სიზუსტის შენარჩუნებით. ეს ინოვაციური მიდგომა უზრუნველყოფს ზუსტად იგივე შედეგებს, რაც მოდელის სტანდარტული გამოყენებისას მიიღება, რაც მას არსებული Whisper-ის სისტემებისთვის იდეალურ ალტერნატივად აქცევს.

olmOCR-ის გაუმჯობესება: სრული დოკუმენტის კონტექსტის ამოცნობა სათაურებისა და ქვედა კოლონტიტულების ჩათვლით
olmOCR ხშირად უგულებელყოფს მნიშვნელოვან ინფორმაციას დოკუმენტების სათაურებსა და ქვედა კოლონტიტულებში, რაც მის საწყის სატრენინგო მონაცემთა ბაზის თავისებურებებით იყო განპირობებული. ამ პრობლემის გადასაჭრელად, მკვლევრებმა olmOCR-ის მოდელი დახვეწეს Qwen2.5-VL-72B-Instruct-ის მიერ გენერირებული 8,000 დოკუმენტისგან შემდგარი ახალი მონაცემთა ბაზის გამოყენებით. შედეგად, მოდელი ახლა სრულყოფილად იღებს მთელ კონტენტს, მათ შორის ადრე გამოტოვებულ მონაცემებსაც, რაც გადამწყვეტია ბიზნეს აპლიკაციებისთვის, როგორიცაა ი
ახალი მიდგომა SDXL Dreambooth LoRA-ს გაწვრთნისთვის: Pivotal Tuning-ისა და Prodigy ოპტიმიზატორის კომბინაცია
Replicate-ის SDXL Cog ტრენერში გამოყენებული Pivotal Tuning ტექნიკისა და Kohya ტრენერში გამოყენებული Prodigy ოპტიმიზატორის (სხვა მრავალ ოპტიმიზაციასთან ერთად) შერწყმით, მიღწეულია შესანიშნავი შედეგები SDXL-ისთვის Dreambooth LoRA-ების გაწვრთნაში. LoRA Dreambooth-ით დახვეწილი SDXL მოდელები საოცარ შედეგებს იძლევა ახალი კონცეფციების დაფიქსირებაში, მცირე რაოდენობის გამოსახულებების გამოყენებით, თანაც ინარჩუნებენ SDXL-ის ესთეტიკასა და ხარისხს და მოითხოვენ შედარებით მცირე გამოთვლით რესურსებს. ტრენინგის სკ
SDXL Dreambooth LoRA ტრენინგის რევოლუცია: Pivotal Tuning-ისა და Prodigy ოპტიმიზატორის კომბინაციით
ამ სტატიაში წარმოდგენილია Dreambooth LoRA-ების SDXL-ისთვის ოპტიმიზაციის ახალი მეთოდი, რომელიც აერთიანებს Replicate-ის SDXL Cog ტრენერში გამოყენებულ Pivotal Tuning ტექნიკას Kohya ტრენერის Prodigy ოპტიმიზატორთან. ეს მიდგომა, სხვა მრავალ ოპტიმიზაციასთან ერთად, უზრუნველყოფს საუკეთესო შედეგებს ახალი კონცეფციების აღბეჭდვაში მცირე რაოდენობის გამოსახულებების გამოყენებით, SDXL-ის ესთეტიკური ხარისხისა და გამოსახულების სიზუსტის შენარჩუნებით, ამასთანავე მოითხოვს შედარებით ნაკლებ გამოთვლით რესურსებს. გაეცანი
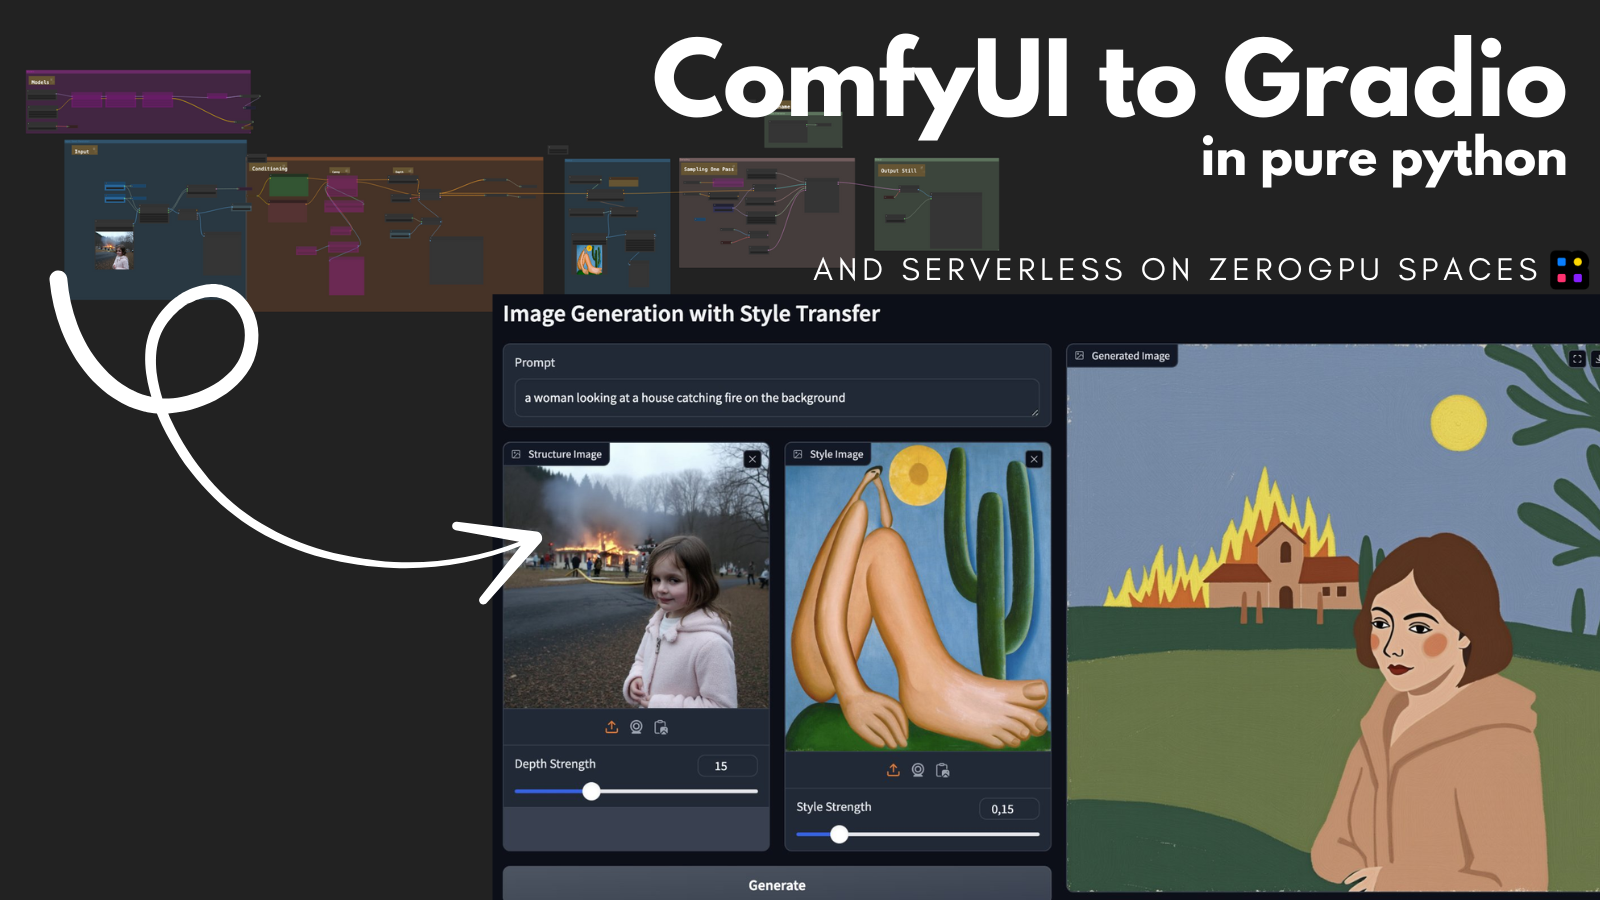
ComfyUI-ის სამუშაო პროცესის Gradio აპლიკაციად გარდაქმნა და Hugging Face Spaces-ზე უფასო განთავსება: სრული გზამკვლევი
ეს გაკვეთილი დეტალურად აღწერს, თუ როგორ უნდა გარდაქმნათ რთული ComfyUI სამუშაო პროცესი მარტივ Gradio აპლიკაციად და განათავსოთ იგი Hugging Face Spaces ZeroGPU სერვერულ სტრუქტურაზე უფასოდ. პროცესი მოიცავს ComfyUI-to-Python-Extension-ის გამოყენებით სამუშაო პროცესის Python სკრიპტად ექსპორტს, Gradio ინტერფეისის შექმნას ექსპორტირებული სკრიპტისთვის და მოდელების Hugging Face-ის ვერსიებთან დაკავშირებას ეფექტური განთავსებისთვის. გაკვეთილი ეფუძნება Nathan Shipley-ის Flux[dev] Redux + Flux[dev] Depth ComfyUI
მომხმარებელთა მხარდაჭერის ავტომატიზაცია NLP-ის გამოყენებით: უკმაყოფილო კლიენტების იდენტიფიკაცია
წინამდებარე სტატია განმარტავს, თუ როგორ შეიძლება ბუნებრივი ენის დამუშავების (NLP) მოდელების გამოყენება მომხმარებელთა მხარდაჭერის პროცესების ნაწილობრივი ავტომატიზაციისთვის. განხილულია ჰიპოთეტური შემთხვევა, სადაც NLP გამოიყენება განსაკუთრებით უკმაყოფილო მომხმარებლების შეტყობინებების იდენტიფიცირებისა და პრიორიტეტულობისთვის, რაც ზრდის პასუხის ეფექტურობასა და კლიენტების კმაყოფილებას. მოცემულია ნაბიჯები გამოყენების შემთხვევის განსაზღვიდან მონაცემთა ნაკრებებისა და მოდელების შერჩევამდე Hugging Face-ის პ
PatchTSMixer: IBM Research-ისა და Hugging Face-ის რევოლუციური მოდელი დროითი სერიების მოდელირებისთვის
IBM Research-მა Hugging Face-თან ერთად წარმოადგინა PatchTSMixer, ინოვაციური მოდელი, რომელიც Transformers ბიბლიოთეკაშია ინტეგრირებული. ეს მოდელი შექმნილია მრავალვარიანტული დროითი სერიების ეფექტური მოდელირებისთვის, მსუბუქი შერევის გამოყენებით პაჩებს, არხებსა და დამალულ მახასიათებლებს შორის. PatchTSMixer მნიშვნელოვნად აღემატება არსებულ MLP და Transformer მოდელებს პროგნოზირებაში, აჩვენებს 8-60%-იან გაუმჯობესებას და ამცირებს მეხსიერების მოხმარებასა და შესრულების დროს. იგი მხარს უჭერს ტრანსფერულ სწავლ