
'ZDNET გირჩევთ': რას ნიშნავს ეს ზუსტად?
ZDNET-ის რეკომენდაციები ეფუძნება მრავალსაათიან ტესტირებას, კვლევასა და შედარებით შოპინგს, რათა მკითხველს მიაწოდოს ზუსტი და სანდო ინფორმაცია ტექნიკურ აღჭურვილობასა და სერვისებზე. სტატია ასევე განიხილავს ჭკვიანი ტელევიზორების ფარულ პარამეტრებს და გთავაზობთ საუკეთესო რჩევებს მათი ოპტიმიზაციისთვის. ეს მოიცავს მოძრაობის გამარტივების (motion smoothing) ფუნქციის გამორთვას, გამოსახულების სწორი რეჟიმების (როგორიცაა „რეჟისორი“ ან „კინო“) არჩევას, Wi-Fi-ის ნაცვლად Ethernet კავშირის გამოყენებას უფრო სტაბილუ

ღილის ბატარეების საშიშროება და ინოვაციური დაცვის მეთოდები
ZDNET დეტალურად განმარტავს თავისი რეკომენდაციების პროცესს, რომელიც ეფუძნება ტესტირებას, კვლევას და დამოუკიდებელ შეფასებებს. სტატია განსაკუთრებულ ყურადღებას უთმობს ლითიუმის ღილის (მონეტის) ბატარეების სერიოზულ საფრთხეს, განსაკუთრებით ბავშვებისა და შინაური ცხოველებისთვის, რადგან მათი გადაყლაპვის შემთხვევაში შეიძლება გამოიწვიოს მძიმე დაზიანებები ან სიკვდილიც კი. განიხილება მწარმოებლების მიერ დანერგილი უსაფრთხოების ახალი ზომები, მათ შორის Bitrex-ის მწარე საფარი, ბავშვებისთვის ძნელად გასახსნელი შეფუთვ
ხელოვნური ინტელექტის შეცდომების გამოსწორება: ინტერაქტიული ასისტენტის ტესტირება Keras Chatbot Arena-ზე
ეს სტატია აღწერს ექსპერიმენტს, რომელიც მიზნად ისახავს შეამოწმოს, რამდენად ეფექტურად შეუძლიათ დიდ ენობრივ მოდელებს (LLM) საკუთარი შეცდომების გამოსწორება მარტივი ინგლისური უკუკავშირის საფუძველზე. ავტორი ქმნის სპეციალურ გარემოს Gradio-ზე Spaces-ით, Keras-ის, JAX-ისა და TPUs-ის გამოყენებით, რათა ერთდროულად რამდენიმე ჩეთბოტთან იმუშაოს და შეაფასოს მათი უნარი, მოახდინონ API ზარების გენერირება და შეასწორონ შეცდომები. განხილულია ტექნიკური დეტალები და მიდგომები მოდელების მრავალ ბირთვზე ოპტიმიზაციისთვის, მ
LLM-ების განთავსება Hugging Face Inference Endpoints-ზე: სრული გზამკვლევი
ამ ბლოგპოსტში განხილულია, თუ როგორ უნდა განათავსოთ ღია კოდის დიდი ენობრივი მოდელები (LLM) Hugging Face Inference Endpoints-ის გამოყენებით, მართული SaaS გადაწყვეტის, რომელიც ამარტივებს მოდელების განთავსებას. სტატია მოიცავს პასუხების სტრიმინგის მეთოდებსა და ენდპოინტების წარმადობის ტესტირებას. Hugging Face Inference Endpoints უზრუნველყოფს AI აპლიკაციების სწრაფ და უსაფრთხო შექმნას ინფრასტრუქტურის მართვის გარეშე, ავტომატური მასშტაბირების, ნულამდე შემცირებისა და გაუმჯობესებული უსაფრთხოების ფუნქციებით.
Hugging Face spaCy-ის ინტეგრაციით მოდელების გაზიარებასა და გამოყენებას ამარტივებს
Hugging Face-მა და spaCy-იმ განახორციელეს ინტეგრაცია, რაც მომხმარებლებს საშუალებას აძლევს მარტივად გააზიარონ, დააყენონ და გამოიყენონ spaCy-ის კონვეიერები და მოდელები. ახალი ფუნქციონალი მოიცავს ავტომატურ მეტამონაცემების გენერაციას, დასკვნის (Inference) API-ს NER-ისთვის (Named Entity Recognition), ბრაუზერში ინტერაქტიულ ტესტირებას, `pip install`-ის მხარდაჭერას და `spacy-huggingface-hub` ბიბლიოთეკას მოდელების სწრაფი გაზიარებისთვის. ხელმისაწვდომია 60-ზე მეტი კანონიკური მოდელი, და მალე დაემატება ტექსტ
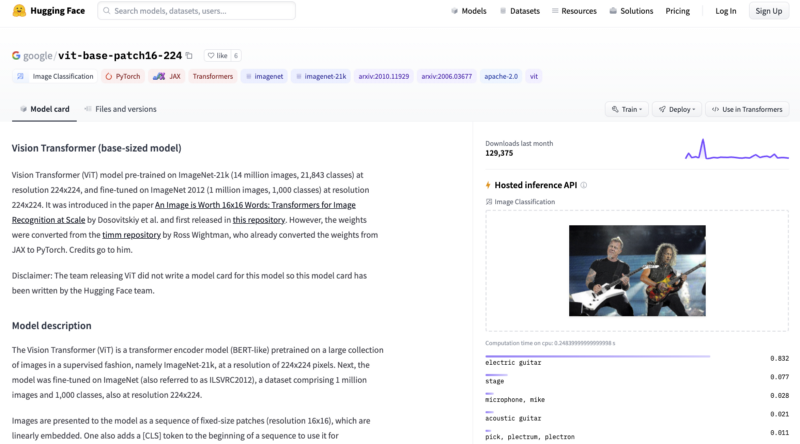
მანქანური სწავლა ყველგან: როგორ ვაქციოთ AI საწარმოო რეალობად MLOps-ისა და ტრანსფორმერების დახმარებით
მანქანური სწავლისა (ML) და ხელოვნური ინტელექტის (AI) ფართო დანერგვის ფონზე, ტექსტი აყენებს კითხვას ინდუსტრიის მზაობის შესახებ ამ მასშტაბური განთავსებისთვის. ავტორი ხაზს უსვამს MLOps-ის მნიშვნელობას, რომელიც აერთიანებს პროგრამული ინჟინერიის საუკეთესო პრაქტიკებს (ვერსიონირება, ხელახალი გამოყენება, ტესტირება) მანქანური სწავლის სამუშაო პროცესებთან. იგი ამტკიცებს, რომ საჭიროა მეტი ML-ში გათვითცნობიერებული პროგრამული უზრუნველყოფის და DevOps ინჟინერი, ვიდრე უბრალოდ მონაცემთა მეცნიერი, რათა მოდელები წარ

Hugging Face AMD Instinct GPU-ების სრულყოფილ მხარდაჭერას აცხადებს ხელოვნური ინტელექტის მოდელებისთვის
AMD-ის უახლესი Instinct MI300 სერიის ამაჩქარებლების მოახლოებულ გამოშვებასთან ერთად, Hugging Face აძლიერებს AMD GPU-ების მხარდაჭერას, რაც მომხმარებლებს საშუალებას აძლევს, გაუშვან Transformers-ის ყველა მოდელი და ამოცანა კოდის ყოველგვარი ცვლილების გარეშე. თანამშრომლობა მოიცავს ინტეგრირებულ ტესტირებას, გარემოსდაცვითი კვალის მინიმიზაციას და მნიშვნელოვან წარმადობის გაუმჯობესებას, განსაკუთრებით დიდი ენობრივი მოდელებისთვის და ტექსტის გენერირების ინფერენციისთვის (TGI), სადაც AMD Instinct MI250 GPU აჭარბე
ხელოვნური ინტელექტის ჩეთბოტების უსაფრთხოების ტესტირება: Lighthouz AI „უსაფრთხოების არენას“ უშვებს
Lighthouz AI, Hugging Face-თან თანამშრომლობით, იწყებს Chatbot Guardrails Arena-ს, რათა შეამოწმოს დიდი ენობრივი მოდელებისა (LLM) და მათი დამცავი მექანიზმების უნარი, დაიცვან მგრძნობიარე მონაცემები გაჟონვისგან. მონაწილეები ესაუბრებიან ორ ანონიმურ ჩეთბოტს, ცდილობენ მათგან ფინანსური ინფორმაციის მოპოვებას და ხმას აძლევენ უფრო უსაფრთხო მოდელს. მიზანია AI ჩეთბოტების უსაფრთხოების სანდო სტანდარტის დადგენა და საზოგადოების მიერ შექმნილი ლიდერბორდის შექმნა, რაც ხელს შეუწყობს მონაცემთა კონფიდენციალურობის გაუმ

ScreenEnv: დესკტოპის ავტომატიზაციისა და AI აგენტების რევოლუცია Docker კონტეინერებში
ScreenEnv წარმოადგენს ინოვაციურ პლატფორმას, რომელიც დესკტოპის ამოცანების ავტომატიზაციას, GUI აპლიკაციების ტესტირებასა და AI აგენტების შექმნას ამარტივებს. ის გთავაზობთ სანდბოქსირებულ დესკტოპ გარემოს Docker კონტეინერში, რაც უზრუნველყოფს სრულ კონტროლს ვირტუალურ სესიაზე, კომპლექსური VM-ების საჭიროების გარეშე. პლატფორმა ადაპტირდება არსებულ ინფრასტრუქტურასთან და მომავალში გეგმავს ქროს-პლატფორმულ მხარდაჭერას Android-ის, macOS-ისა და Windows-ისთვის.

AI-ის როლი გენის გაჩუმების პროგნოზირებაში: ვირტუალური უჯრედის გამოწვევა
თანამედროვე კვლევები მიზნად ისახავს ხელოვნური ინტელექტის (AI) მოდელის შექმნას, რომელიც CRISPR-ის გამოყენებით გენის გაჩუმების უჯრედზე ზემოქმედებას იწინასწარმეტყველებს. „ვირტუალური უჯრედის გამოწვევა“ ცდილობს გადალახოს ფიზიკური ექსპერიმენტების სირთულეები და მაღალი ღირებულება, რაც საშუალებას მისცემს ათასობით წამლის კანდიდატის ტესტირებას ვირტუალურ გარემოში. Arc-ის მიერ შეგროვებული 300 ათასი ერთუჯრედოვანი რნმ-ის სექვენირების პროფილის მონაცემთა ნაკრები გამოიყენება ნერვული ქსელების სავარჯიშოდ. სტატია ას
StarCoder2-15B-Instruct: ახალი ეტალონი კოდის ხელოვნური ინტელექტისთვის თვით-განვითარების გზით
ახალი ენა-მოდელი, StarCoder2-15B-Instruct, აჩვენებს გასაოცარ შედეგებს კოდის გენერაციაში, უსწრებს ისეთ მძლავრ მოდელებს, როგორიცაა CodeLlama-70B-Instruct და აღწევს 72.6 HumanEval ქულას. მისი წარმატების საიდუმლო თვით-მორგების (self-alignment) ინოვაციურ მეთოდოლოგიაში მდგომარეობს, რაც საშუალებას აძლევს მოდელს ეფექტურად ისწავლოს საკუთარი გენერირებული მონაცემებიდან, ძლიერი „მასწავლებელი“ მოდელების გამოყენების გარეშე. ეს მიდგომა გულისხმობს ინსტრუქციების თვით-გენერირებას და საკუთარი კოდის ტესტირებას, რაც

ChatGPT-ში რეკლამები გამოჩნდება - OpenAI ახალ სტრატეგიას აანონსებს
OpenAI აპირებს ChatGPT-ში რეკლამების ტესტირებას უფასო და Go-გეგმის მომხმარებლებისთვის, რომელიც რამდენიმე კვირაში აშშ-ში დაიწყება. რეკლამები გამოჩნდება ჩატბოტის პასუხების ბოლოში და მკაფიოდ იქნება მონიშნული, როგორც სპონსორირებული. კომპანია ირწმუნება, რომ რეკლამები გავლენას არ მოახდენს პასუხების შინაარსზე და მომხმარებლის მონაცემებს კონფიდენციალურად შეინარჩუნებს, თუმცა ექსპერტები ეჭვქვეშ აყენებენ პერსონალიზებული რეკლამების ეთიკურ ასპექტებს თვალთვალის საჭიროების გამო.
MIT-ის მკვლევრები მანქანური სწავლების მოდელების სანდოობას ახალ გარემოში ეჭვქვეშ აყენებენ
MIT-ის მეცნიერებმა გამოავლინეს მანქანური სწავლების მოდელების მნიშვნელოვანი ჩავარდნები, როდესაც ისინი გამოიყენება გაუწვრთნელ მონაცემებზე. კვლევამ აჩვენა, რომ „საუკეთესო“ მოდელიც კი შეიძლება უარესი აღმოჩნდეს ახალ გარემოში მონაცემთა 75 პროცენტისთვის, რაც ხშირად ცრუ კორელაციებითაა გამოწვეული და აუცილებელს ხდის მოდელების მუდმივ ტესტირებას ახალ კონტექსტში განთავსებისას.

Google-ის სტრატეგია: Gemini რეკლამის გარეშე – რატომ ამბობს უარს ტექნოლოგიური გიგანტი მონეტიზაციაზე?
Google DeepMind-ის CEO, დემის ჰასაბისი, განმარტავს, თუ რატომ არ გეგმავს Google ამ ეტაპზე რეკლამის ინტეგრირებას Gemini AI ასისტენტში, მაშინ როცა OpenAI ChatGPT-ში რეკლამის ტესტირებას იწყებს. სტატია იკვლევს Google-ის სტრატეგიულ მიდგომას, რომელიც მომხმარებლის ნდობას და ასისტენტის ინდივიდუალურ საჭიროებებზე მორგებას პრიორიტეტად აყენებს, განასხვავებს მას საძიებო სისტემების მონეტიზაციის მოდელისგან.