მაღალი ხარისხის მთარგმნელის ადაპტირება: გამოწვევები და პროცესი
სტატია დეტალურად აღწერს Facebook FAIR-ის WMT19-ის ახალი ამბების მთარგმნელობითი სისტემის `transformers` ბიბლიოთეკასთან ადაპტირების (porting) პროცესს. პროექტის მიზანი იყო მაღალი ხარისხის მთარგმნელის ადაპტირება, რისთვისაც თავდაპირველი სისტემის დეტალური შესწავლა გახდა საჭირო. ავტორი განიხილავს პროექტის კომპლექსურობის დაძლევას მცირე ამოცანებად დაყოფით, წინასწარ გაწვრთნილი en-ru/ru-en მოდელებთან მუშაობის უპირატესობებს და ლექსიკონების განსხვავებების (გაერთიანებული vs. ცალკეული) დამუშავების თავისებურებე

ღია კოდის ვიდეო გენერაციის მოდელების აღზევება: დგას თუ არა AI „Stable Diffusion-ის მომენტის“ ზღურბლზე?
ბოლო დროს შეინიშნება ღია კოდის ვიდეოს გენერაციის მოდელების, მათ შორის CogVideoX, Mochi-1, Hunyuan და LTX Video-ს სწრაფი ზრდა, რაც ბადებს კითხვას, დგას თუ არა ვიდეო საზოგადოება ხელოვნური ინტელექტის „Stable Diffusion-ის მომენტის“ ზღურბლზე. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, ხაზს უსვამს ისეთ შეზღუდვებს, როგორიცაა მოძრაობის ხარისხი, დროითი თანმიმდევრულობა და მეხსიერების მაღალი მოთხოვნები. Diffusers-ის გუნდი აქტიურად მუშაობს ამ გამოწვევების გადასაჭრელად სხვადასხ
DeepSeek-R1-ის გარღვევა მსჯელობის მოდელებში და Open-R1 პროექტი: საიდუმლოების გამჟღავნებისკენ
DeepSeek-R1-ის ახალი მოდელი, რომელიც OpenAI-ის o1-ს უტოლდება ან აღემატება, დეტალური ტექნიკური ანგარიშით გამოვიდა, რამაც ხელოვნური ინტელექტის საზოგადოებაში დიდი აჟიოტაჟი გამოიწვია. მოდელი ეფუძნება ინოვაციურ მიდგომას, მათ შორის გაძლიერებულ სწავლებას ადამიანის ზედამხედველობის გარეშე. თუმცა, DeepSeek-მა არ გაასაჯაროვა თავისი მონაცემთა ნაკრებები და კოდი, რამაც Open-R1 პროექტი გააჩინა, რომელიც მიზნად ისახავს DeepSeek-R1-ის „რეცეპტის“ რეკონსტრუქციას, გამჭვირვალობის გაზრდას და ღია წყაროს მსჯელობის მოდელ
DeepSeek-R1-ის რევოლუცია: ღია წყაროს ინიციატივა მსჯელობის მოდელების გასახსნელად
DeepSeek-R1-ის გამოშვებამ ხელოვნური ინტელექტის სამყაროში მნიშვნელოვანი გარღვევა მოახდინა, წარმოადგინა მსჯელობის უნარის მქონე მოდელი, რომელიც OpenAI-ის o1-ზე არანაკლებ ან უკეთესად მუშაობს. მისი შექმნის მეთოდოლოგია, განსაკუთრებით კი გაძლიერებითი სწავლის (RL) გამოყენება ადამიანის ზედამხედველობის გარეშე, დეტალურად იქნა აღწერილი. მიუხედავად იმისა, რომ მოდელის წონები ღიაა, მისი სავარჯიშო მონაცემები და კოდი საიდუმლოდ დარჩა. ამის საპასუხოდ, Open-R1 პროექტი მიზნად ისახავს DeepSeek-R1-ის მონაცემთა და სავა
100-ჯერ გაზრდილი წარმადობა: დიდი AI მოდელების ოპტიმიზაცია Hugging Face-ის ინფრასტრუქტურაზე
მიუხედავად იმისა, რომ დიდი ენობრივი მოდელების ექსპერიმენტირება მარტივია, მათი მაქსიმალური წარმადობით პროდუქციაში განთავსება რთული საინჟინრო გამოწვევაა. Hugging Face გთავაზობთ გადაწყვეტას თავისი Accelerated Inference API-ის მეშვეობით, რომელიც უზრუნველყოფს 100-ჯერ გაზრდილ სიჩქარეს და მასშტაბირებადობას. სტატია დეტალურად აღწერს ოპტიმიზაციის სხვადასხვა დონეს – ბიბლიოთეკების გამოყენებიდან აპარატურის სპეციფიკურ მოდიფიკაციამდე – და ხაზს უსვამს Hugging Face-ის ექსპერტიზასა და პარტნიორობებს ტექნიკის წამყვ

Hugging Face აერთიანებს სერვერულ ინფერენსზე წვდომას ახალი პარტნიორობითა და ფუნქციებით
Hugging Face-მა, საკუთარი სერვერული Inference API-ის ხანგრძლივი მასპინძლობის შემდეგ, გადაწყვიტა ფოკუსირება თანამშრომლობაზე, დიდი მონაცემთა ნაკრებებისა და მოდელების შენახვაზე, ვერსიონირებასა და გავრცელებაზე. ამის პარალელურად, კომპანია მომხმარებლებს სთავაზობს მარტივ და ერთიან წვდომას სერვერულ ინფერენსზე წამყვანი პროვაიდერების მეშვეობით. ეს ნაბიჯი აძლიერებს AI მოდელების ხელმისაწვდომობას, გვთავაზობს მოქნილ ფასებს პირდაპირი და მარშრუტიზებული მოთხოვნებისთვის, და უზრუნველყოფს დამატებით ბენეფიტებს PRO მ
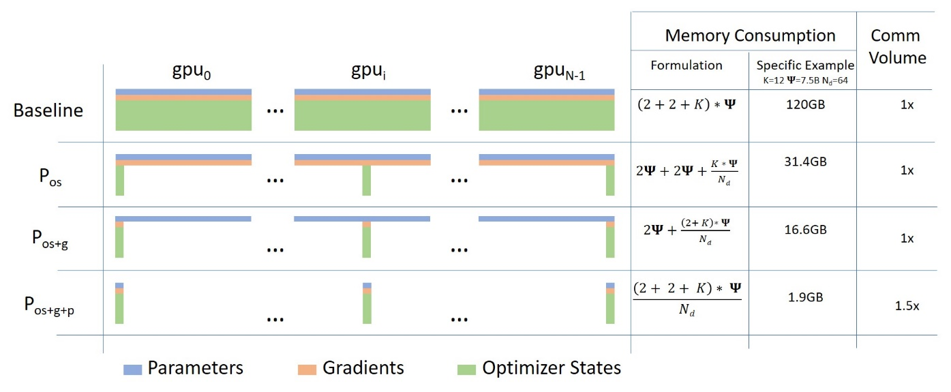
ZeRO, DeepSpeed და FairScale: ხელოვნური ინტელექტის მოდელების ვარჯიშის მეხსიერების ოპტიმიზაცია
სტატია მიმოიხილავს ხელოვნური ინტელექტის მოდელების ზრდასთან დაკავშირებულ მეხსიერების პრობლემებს და წარმოგიდგენთ ZeRO-ს, DeepSpeed-სა და FairScale-ს, როგორც ამ პრობლემის გადაჭრის საშუალებებს. განხილულია ამ ტექნოლოგიების ინტეგრაცია და ეფექტურობა მოდელების ვარჯიშის პროცესში, როგორც მრავალი, ისე ერთი GPU-ს გამოყენებისას, ხაზგასმულია მნიშვნელოვანი გაუმჯობესებები მუშაობის სიჩქარესა და მეხსიერების გამოყენებაში.

DeepSeek-R1 მოდელების გამოშვება და განთავსება AWS-სა და Hugging Face-ზე: ახალი შესაძლებლობები ხელოვნურ ინტელექტში
DeepSeek-მა გამოუშვა თავისი DeepSeek-R1 მოდელი, რომელიც მნიშვნელოვნად აუმჯობესებს მსჯელობითი ამოცანების გადაჭრას, როგორიცაა მათემატიკა და კოდირება, OpenAI-ის მსგავსად. Hugging Face, Amazon Web Services-თან თანამშრომლობით, დეველოპერებს სთავაზობს ამ მოდელების მარტივად განთავსებასა და დახვეწას AWS სერვისებზე, მათ შორის Inference Endpoints-სა და Amazon SageMaker-ზე. სტატია დეტალურად აღწერს განთავსების პროცესს Python SageMaker SDK-ისა და Jumpstart-ის გამოყენებით, ასევე Neuron ინსტანციებზე, რაც ხელს უ

ხელოვნური ინტელექტი ხელოვნებაში: ღია კოდის მოდელების გარდამტეხი წელი (2024-ის მიღწევები და 2025-ის მოლოდინები)
ბოლო რამდენიმე წელი, განსაკუთრებით კი 2024, გარდამტეხი აღმოჩნდა ხელოვნური ინტელექტის (AI) ღია კოდის მოდელებისა და ინსტრუმენტებისთვის ხელოვნებითი გამოყენების კუთხით. ამ მიმოხილვაში განვიხილავთ 2024 წლის მთავარ მიღწევებს, როგორიცაა DiT არქიტექტურის და Flux.1-ის გამოჩენა, პერსონალიზაციის ტექნიკების გაუმჯობესება და „ნულოვანი ოპტიმიზაციის“ მეთოდების აღმასვლა გამოსახულების გენერაციაში. სტატია ასევე მიმოიხილავს ვიდეოს გენერაციის სფეროში არსებულ გამოწვევებს და 2025 წლის მოლოდინებს, რომელიც AI და ხელოვნე

Deepseek R1-ის 'აჰა მომენტი' და მისი ხელახლა შექმნა GRPO-სა და Countdown თამაშის მეშვეობით
Deepseek R1-ის გამოშვებამ ინდუსტრია შეძრა, რადგან ის არის ღია მოდელი, რომელიც OpenAI-ის o1-ს ეჯიბრება კომპლექსური მსჯელობის ამოცანებში. მოდელი გამოირჩევა „აჰა მომენტით“ – თვითვერიფიკაციის უნარით ადამიანური ჩარევის გარეშე. ეს ბლოგ პოსტი მიზნად ისახავს ამ უნიკალური ქცევის ხელახლა შექმნას Group Relative Policy Optimization (GRPO) და Countdown თამაშის გამოყენებით, დისტრიბუციულ ტრენინგზე ფოკუსირებით Deepspeed-ისა და vLLM-ის მეშვეობით.

Adyen-ისა და Hugging Face-ის DABstep: ხელოვნური ინტელექტის მოდელების გამოწვევა მონაცემთა ანალიზში
Adyen-მა და Hugging Face-მა ერთობლივად შექმნეს DABstep – ახალი ბენჩმარკი, რომელიც 450-ზე მეტ მონაცემთა ანალიზის ამოცანას მოიცავს. მისი მიზანია ხელოვნური ინტელექტის (AI) უახლესი მოდელების შესაძლებლობების შეფასება მრავალსაფეხურიან აზროვნებაში. კვლევამ აჩვენა, რომ მიუხედავად განვითარებისა, AI აგენტები DABstep-ზე მხოლოდ 16%-იან სიზუსტეს აღწევენ, რაც მიუთითებს ამ სფეროში მნიშვნელოვანი პროგრესის საჭიროებაზე. ბენჩმარკი მოითხოვს, რომ AI მოდელებმა გამოავლინონ ტექნიკური უნარები, დომენური ცოდნა და კრეატიულ
Hugging Face AWS Marketplace-ზე: AI-ის დანერგვის გამარტივება ბიზნესისთვის
Hugging Face-ის AWS Marketplace-ზე ინტეგრაცია აადვილებს კომპანიებისთვის დიდი ენობრივი მოდელების გამოყენებას და ხელოვნური ინტელექტის (AI) დანერგვას. AWS-ის მომხმარებლებს ახლა შეუძლიათ მარტივად გამოიწერონ Hugging Face სერვისები, ხოლო გადახდები ავტომატურად აისახება მათ AWS გადასახადში. ეს ინიციატივა არა მხოლოდ ამარტივებს პროცესს, არამედ სთავაზობს დამატებით უსაფრთხოების ფუნქციებს Enterprise Hub-ის მეშვეობით, რაც ტექნოლოგიას უფრო მეტ დეველოპერსა და ბიზნესს მიაწვდის.
IDEFICS: ღია მულტიმოდალური AI მოდელი გამჭვირვალე კვლევისთვის
IDEFICS, 80 მილიარდი პარამეტრის მულტიმოდალური ხელოვნური ინტელექტის (AI) მოდელი, რომელიც Flamingo-ს ღია წყაროს რეპროდუქციას წარმოადგენს, უკვე ხელმისაწვდომია. მისი შექმნისას დიდი აქცენტი გაკეთდა გამჭვირვალობაზე, გამოყენებულ იქნა მხოლოდ საჯაროდ ხელმისაწვდომი მონაცემები და შეფასდა პოტენციური მიკერძოებები. მოდელი მიზნად ისახავს მულტიმოდალური AI სისტემების სფეროში უფრო ღია კვლევების წახალისებას და მისი დემო ვერსიები Hugging Face Hub-ზეა განთავსებული.
OpenAI-მ Deep Research გამოუშვა: ვებ-დათვალიერების სისტემა და ღია კოდით მისი რეპროდუცირების მცდელობები
OpenAI-მ წარმოადგინა „Deep Research“ – ინოვაციური სისტემა, რომელიც ვებ-კონტენტს აჯამებს და კითხვებზე პასუხობს. სისტემამ შთამბეჭდავი შედეგები აჩვენა General AI Assistants (GAIA) ბენჩმარკზე, მიაღწია თითქმის 67%-იან სიზუსტეს საშუალოდ და 47.6%-ს რთულ „დონე 3“ კითხვებზე. Deep Research აგებულია დიდ ენობრივ მოდელზე (LLM) და აგენტურ ჩარჩოზე, რომელიც მას ინსტრუმენტების გამოყენებაში ეხმარება. მიუხედავად OpenAI-ს მიერ აგენტური ჩარჩოს დეტალების არგამჟღავნებისა, ღია კოდის საზოგადოებამ 24-საათიანი მისია დაიწყ
მომხმარებელთა შეფასებების სენტიმენტური ანალიზის მიკროსერვისის შექმნა Google Cloud-ზე
სტატია აღწერს მიკროსერვისის შექმნის პროცესს, რომელიც Discord-ში დატოვებულ მომხმარებელთა შეფასებებს ავტომატურად აანალიზებს და მათ პოზიტიურ ან ნეგატიურ შინაარსს განსაზღვრავს. ავტორი განიხილავს საწყის სირთულეებს მოდელის ჩატვირთვისა (როგორიცაა .h5 ფაილის ტიპის გაგება) და შესაბამისი ღრუბლოვანი პლატფორმის შერჩევისას (AI-Platform Prediction, App Engine, Cloud Run). საბოლოოდ, წარმოადგენს Cloud Run-სა და PyTorch-ზე დაფუძნებულ, Docker-ის გამოყენებით განხორციელებულ გადაწყვეტას, რომელიც ოპტიმიზირებულია მეხს
Hugging Face წარმოგიდგენთ SafeCoder-ს: უსაფრთხო, თვით-ჰოსტინგით AI პროგრამისტს საწარმოებისთვის
Hugging Face-ის SafeCoder მიზნად ისახავს პროგრამული უზრუნველყოფის შემუშავების პროდუქტიულობის გაზრდას საწარმოებში, სრულად შესაბამისი, თვით-ჰოსტინგითა და უსაფრთხო AI კოდის ასისტენტის შეთავაზებით. გადაწყვეტა ეფუძნება ღია კოდის მოდელებს, როგორიცაა StarCoder, და უზრუნველყოფს მონაცემთა კონფიდენციალურობასა და იურიდიულ შესაბამისობას, რადგან კომპანიებს საშუალებას აძლევს, საკუთარ ინფრასტრუქტურაზე დაახვეწონ LLM-ები, მესამე მხარესთან კოდის გაზიარების გარეშე.

არაბული LLM ლიდერბორდების აღზევება: გამოწვევები და ინოვაციები
არაბულენოვანი დიდი ენობრივი მოდელების (LLM) მზარდი ხელმისაწვდომობის ფონზე, 2024 წელს დაიწყო რამდენიმე სპეციალიზებული ლიდერბორდის გაშვება, რომლებმაც მნიშვნელოვნად გააუმჯობესეს არაბული ხელოვნური ინტელექტის მოდელების შეფასება. ამ ინიციატივებმა, მათ შორის Open Arabic LLM Leaderboard (OALL), Balsam Index-მა და AraGen Leaderboard-მა, გადაჭრა არსებული გამოწვევები და სწრაფად მოიპოვა პოპულარობა, გახდა რა ცენტრალური პლატფორმები არაბული AI საზოგადოებისთვის. მათ ხაზი გაუსვეს არაბული ენის უნიკალური სირთულეებ

Open R1 პროექტი: OpenR1-Math-220k მონაცემთა ნაკრების წარდგენა მათემატიკური მსჯელობისთვის
Open R1 პროექტი, რომლის მიზანია DeepSeek R1-ის დაკარგული კომპონენტების – კერძოდ, საწვრთნელი პაიპლაინისა და სინთეზური მონაცემების – რეკონსტრუქცია, უკვე ორი კვირაა მიმდინარეობს. ამ პოსტში წარმოდგენილია OpenR1-Math-220k: ჩვენი პირველი ფართომასშტაბიანი მონაცემთა ნაკრები მათემატიკური მსჯელობისთვის. განხილულია საზოგადოების ძალისხმევა მცირე, მაღალი ხარისხის მონაცემთა ნაკრებების შესაქმნელად და მსჯელობის მოდელებიდან „აზროვნების ჯაჭვის“ (chain-of-thought) სიგრძის კონტროლის მეთოდები. სტატია დეტალურად აღწერ
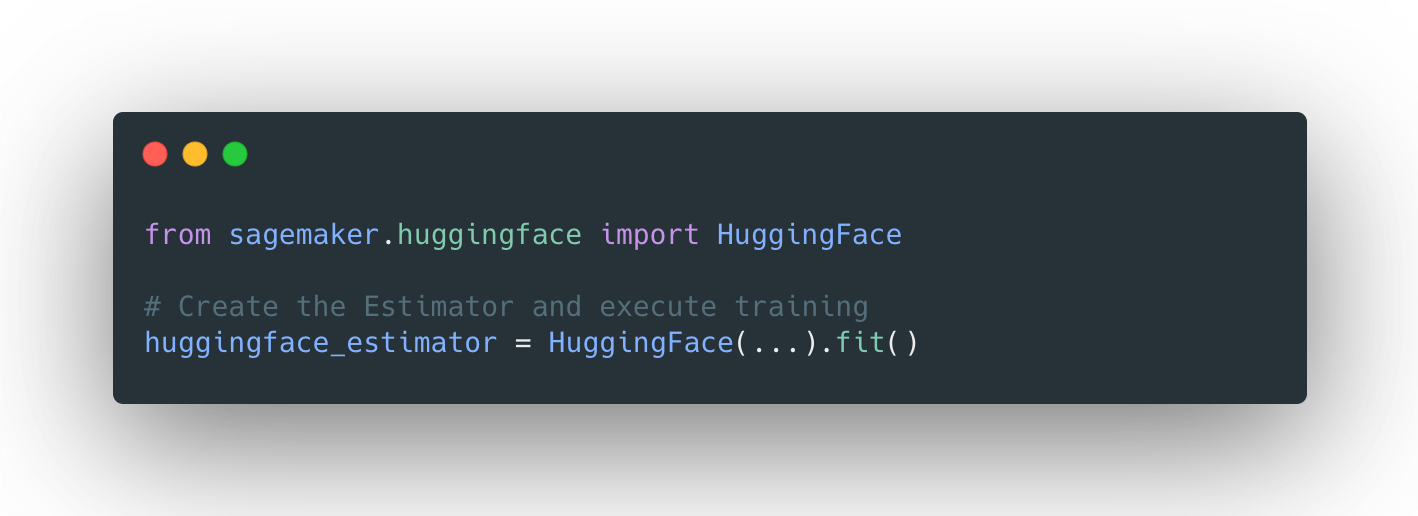
Hugging Face Transformers-ისა და AWS SageMaker-ის ინტეგრაცია: მარტივი და სწრაფი AI მოდელების ტრენინგი
Hugging Face-ისა და AWS SageMaker-ის გუნდებმა ერთობლივად შექმნეს Transformers-ის ოპტიმიზებული ღრმა სწავლების კონტეინერები, რაც მნიშვნელოვნად აჩქარებს Transformers-ზე დაფუძნებული მოდელების ტრენინგს. ახალი HuggingFace estimator-ის წყალობით SageMaker Python SDK-ში, ტრენინგის დაწყება კოდის ერთი ხაზითაა შესაძლებელი. ეს ინტეგრაცია დეტალურად აღწერილია ბლოგ-პოსტში, რომელიც მოიცავს დაწყების მაგალითებსა და დოკუმენტაციას. სტატია განმარტავს, თუ როგორ ხდება Facebook-ის BART-large-cnn მოდელის დახვეწა Samsum მ
Hugging Face-ის Xet გუნდის ინოვაციური მიდგომა მონაცემთა გადაცემის დაჩქარებისთვის
Hugging Face-ის Xet გუნდი მონაცემთა დედუპლიკაციას თეორიიდან პრაქტიკაში ნერგავს, რათა მნიშვნელოვნად დააჩქაროს AI დეველოპერებისთვის Hub-ზე მონაცემების ატვირთვა და ჩამოტვირთვა. იმის ნაცვლად, რომ მხოლოდ დედუპლიკაციის მაქსიმიზაციაზე გაამახვილონ ყურადღება, რამაც შეიძლება დიდი დამატებითი ხარჯები გამოიწვიოს, მათი მიდგომა მიზნად ისახავს სწრაფი ექსპერიმენტებისა და თანამშრომლობის ხელშეწყობას. ეს გულისხმობს მონაცემთა გადაადგილების, შენახვისა და განვითარების მთლიანი პროცესის ოპტიმიზაციას ჩანკებზე დაფუძნებული
AI აუდიო გენერაცია: AudioLDM 2-ის სიჩქარის რეკორდი - 10 წამი 1 წამში
AudioLDM 2, ტექსტიდან აუდიოს გენერირების ხელოვნური ინტელექტის მძლავრი მოდელი, ადრე გამოირჩეოდა ნელი მუშაობით, 10-წამიანი აუდიოს შესაქმნელად 30 წამზე მეტი სჭირდებოდა. ახალი ბლოგ პოსტი დეტალურად აღწერს, თუ როგორ იქნა მიღწეული ინფერენციის დროის 10-ჯერ შემცირება, კოდისა და მოდელის ოპტიმიზაციების, მათ შორის ნახევრად ზუსტი გამოთვლებისა და Flash Attention-ის გამოყენებით. შედეგად, შესაძლებელია 10-წამიანი აუდიო ნიმუშის გენერირება მხოლოდ 1 წამში, ხარისხის მინიმალური გაუარესებით, Hugging Face Diffusers ბიბ

AI მოდელების მასშტაბური ინფერენციის ოპტიმიზაცია: ხარჯი და შეყოვნება
ეს სტატია დეტალურად აღწერს მეთოდოლოგიას ენკოდერული მოდელების გამოყენებით მასშტაბური კლასიფიკაციისა და ემბედინგის ამოცანებისთვის ხარჯებისა და შეყოვნების გამოსათვლელად და ოპტიმიზაციისთვის. განხილულია მოდელების არქიტექტურები, აპარატურული ხარჯების ბენჩმარკინგი და ოპტიმიზაციის ჩარჩო. გამოყენებულია ისეთი ინსტრუმენტები, როგორიცაა Inference Endpoints აპარატურის შერჩევისთვის, Hugging Face Hub განთავსებისთვის, Infinity ინფერენციის სერვერისთვის და Grafana-ს k6 დატვირთვის ტესტირებისთვის. მოცემულია პრაქტიკულ

Fireworks.ai და Hugging Face: ელვისებურად სწრაფი სერვერის გარეშე AI დასკვნა ახლა ხელმისაწვდომია
Fireworks.ai ინტეგრირდა Hugging Face-ის ეკოსისტემაში, რაც მომხმარებლებს საშუალებას აძლევს, ელვისებურად სწრაფად გაუშვან სერვერის გარეშე დასკვნები (serverless inference) საყვარელ AI მოდელებზე. ეს თანამშრომლობა ამარტივებს პროცესს, გთავაზობთ მოქნილ ბილინგის ვარიანტებს და PRO მომხმარებლებისთვის განკუთვნილ უპირატესობებს, მათ შორის ყოველთვიურ კრედიტებს.

Few-Shot Learning ხელოვნურ ინტელექტში: GPT-Neo და აჩქარებული დასკვნის API
სტატია განმარტავს „Few-Shot Learning“ (რამდენიმე მაგალითზე დაფუძნებული სწავლების) კონცეფციას, როგორც მანქანური სწავლების ტექნიკას, რომელიც მოდელს მცირე რაოდენობის მონაცემებით წვრთნის. განხილულია მისი გამოყენება ბუნებრივი ენის დამუშავებაში (NLP) დიდი ენობრივი მოდელების, როგორიცაა EleutherAI GPT-Neo და OpenAI GPT-3, მეშვეობით. სტატია ასევე მიმოიხილავს Hugging Face-ის აჩქარებული დასკვნის (Accelerated Inference) API-ის როლს, ამ ტექნიკის ოპტიმიზაციას, გამოწვევებს (მაგ., მოდელის მგრძნობელობა მაგალითებ