
BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს
Hugging Face-ის ვალდებულება ეთიკური ხელოვნური ინტელექტისადმი: ღია თანამშრომლობა და ახალი საინფორმაციო ბიულეტენი
Hugging Face, რომელიც ღია წყაროს კომპანიად ჩამოყალიბდა, ტექნოლოგიების სფეროში ძირითადი ეთიკური ღირებულებების, როგორიცაა თანამშრომლობა, პასუხისმგებლობა და გამჭვირვალობა, საფუძველზეა დაფუძნებული. კომპანია აქტიურად ავითარებს ხელოვნური ინტელექტის (AI) ეთიკურ ასპექტებს, სადაც რეპროდუცირებადობა, აუდიტირებადობა და სისტემების გაგება ცენტრალურ ადგილს იკავებს. ამ ძალისხმევის ფარგლებში, Hugging Face-მა ახლახან გამოუშვა საინფორმაციო ბიულეტენი „ეთიკა და საზოგადოება“, რომელიც მიზნად ისახავს AI-ს ეთიკური საკით
Hugging Face-ის ეთიკური ხედვა ხელოვნურ ინტელექტში: მომავლის ფორმირება თანამშრომლობითა და გამჭვირვალობით
Hugging Face, რომელიც დაარსდა ეთიკურ პრინციპებზე (თანამშრომლობა, პასუხისმგებლობა, გამჭვირვალობა), აქტიურად ნერგავს ამ ღირებულებებს ხელოვნური ინტელექტის განვითარებაში. კომპანია ხაზს უსვამს ღიაობის, რეპროდუცირებადობის, აუდიტურობისა და გაგების მნიშვნელობას. ახალი ინიციატივებით, როგორიცაა „ეთიკისა და საზოგადოების“ ბიულეტენი, Hugging Face მიზნად ისახავს AI-ს მომავლის ფორმირებას, ეთიკური საკითხების გადაჭრას მთელი საზოგადოების ჩართულობით და ღია დისკუსიის ხელშეწყობით.

TextQuests: ახალი ბენჩმარკი ხელოვნური ინტელექტის აგენტების შესაძლებლობების შესაფასებლად
ახალი ბენჩმარკი, TextQuests, იყენებს 25 კლასიკურ Infocom-ის ინტერაქციულ მხატვრულ თამაშს, რათა შეაფასოს ხელოვნური ინტელექტის აგენტების უნარი, იმუშაონ ავტონომიურად რთულ საძიებო გარემოში. იგი ავლენს LLM-ების გამოწვევებს ხანგრძლივი კონტექსტის გაგებაში, როგორიცაა ჰალუცინაციები და სივრცითი მსჯელობის სირთულეები.
როგორ განვაახლოთ Hugging Face ორგანიზაცია Enterprise Hub-მდე AWS ანგარიშის გამოყენებით
გაიგეთ, თუ როგორ უნდა განაახლოთ თქვენი Hugging Face ორგანიზაცია Enterprise Hub-მდე AWS Marketplace-ის მეშვეობით, რათა ისარგებლოთ გაფართოებული უსაფრთხოების ფუნქციებით, წვდომის კონტროლით და ხელოვნური ინტელექტის კერძოდ და უსაფრთხოდ შექმნის შესაძლებლობით GDPR-თან შესაბამის და SOC2 Type 2 სერტიფიცირებულ პლატფორმაზე.

Arm KleidiAI და SDOT: გენერაციული ხელოვნური ინტელექტი მილიარდობით მოწყობილობაზე, მათ შორის ძველ მოდელებზეც
Arm-ის KleidiAI, SDOT CPU ფუნქციის გამოყენებით, გენერაციულ ხელოვნურ ინტელექტს (GenAI) ხელმისაწვდომს ხდის მოწყობილობების ფართო სპექტრზე – უახლესი ფლაგმანური მოდელებიდან დაწყებული, ხუთ წლამდე ძველი სმარტფონებითა და Raspberry Pi 5-ით დამთავრებული. ეს მიიღწევა პოპულარულ AI ფრეიმვორკებში ჩაშენებული ოპტიმიზაციებით და ExecuTorch 0.7 ბეტაში ნაგულისხმევი ჩართვით, რაც უზრუნველყოფს დიდი ენობრივი მოდელების (LLM) ეფექტურ მუშაობას კოდის შეცვლის გარეშე და მნიშვნელოვანი წარმადობის გაუმჯობესებით.

მოდელის კონტექსტის პროტოკოლი (MCP): ხელოვნური ინტელექტის ახალი ერა კვლევის ავტომატიზაციაში
მოდელის კონტექსტის პროტოკოლი (MCP) არის სტანდარტი, რომელიც აგენტურ მოდელებს საშუალებას აძლევს, დაუკავშირდნენ გარე ინსტრუმენტებსა და მონაცემთა წყაროებს. ეს ხელოვნურ ინტელექტს აძლევს შესაძლებლობას, ბუნებრივი ენის გამოყენებით ავტომატიზირება მოახდინოს კვლევის პროცესში, პლატფორმებს შორის გადართვისა და ინფორმაციის ჯვარედინი შემოწმების ჩათვლით, რაც მნიშვნელოვნად ზრდის კვლევის ეფექტურობას.

განახლება, 2025 წლის ოქტომბერი: Claude-ის Hugging Face-თან დაკავშირება მოწინავე გამოსახულების გენერაციისთვის
სტატიაში დეტალურად არის აღწერილი, თუ როგორ დავაკავშიროთ Claude Hugging Face-ის MCP სერვერთან, რათა გამოვიყენოთ ხელოვნური ინტელექტის მოწინავე გამოსახულების გენერაციის მოდელები, როგორიცაა Krea და Qwen-Image. ეს აფართოებს Claude-ის შესაძლებლობებს რეალისტური ვიზუალის შექმნისა და ტექსტის ზუსტი რენდერინგის მიმართულებით, Anthropic-ის პოლიტიკის განახლების შემდეგ.

NVIDIA-მ 6 მილიონიანი მულტილინგვური მსჯელობის მონაცემთა ნაკრები და Nemotron Nano 2 9B გამოუშვა
NVIDIA განაგრძობს ღია ეკოსისტემის მხარდაჭერას 6 მილიონიანი მულტილინგვური მსჯელობის მონაცემთა ნაკრების გამოშვებით, რომელიც ხუთ ენაზეა ნათარგმნი. ამასთან ერთად, წარდგენილია Nemotron Nano 2 9B მოდელი, რომელიც ხელოვნური ინტელექტის შესაძლებლობებს გაუმჯობესებული არქიტექტურითა და კონფიგურირებადი შესრულებით ზღვრულ მოწყობილობებზე აფართოებს. ეს ნაბიჯი ხაზს უსვამს კომპანიის ერთგულებას მოდელების განვითარებაში ღიაობისა და გამჭვირვალობის მიმართ.
Microsoft-ისა და Hugging Face-ის თანამშრომლობა Azure-ზე ხელოვნური ინტელექტის შექმნას ამარტივებს
Microsoft და Hugging Face აცხადებენ თანამშრომლობის გაღრმავებას, რაც მომხმარებლებს საშუალებას აძლევს, Azure-ზე ღია მოდელებით ხელოვნური ინტელექტი (AI) უფრო მარტივად ააწყონ. სიახლეები მოიცავს პოპულარული დიდი ენობრივი მოდელების (LLM) პირდაპირ ინტეგრაციას Azure AI Studio-ში, ახალი AMD Instinct MI300 GPU-ზე დაფუძნებული ვირტუალური მანქანების ხელმისაწვდომობას მაღალი წარმადობისთვის და Hugging Face Spaces-ის ინტეგრაციას VS Code-თან, რაც დეველოპერებისთვის AI აპლიკაციების შექმნას საგრძნობლად აჩქარებს.

Hugging Face-ი და AMD ხელოვნური ინტელექტის განვითარებას AMD Instinct MI300 GPU-ების ინტეგრაციით აძლიერებენ
Hugging Face-ი და AMD აცხადებენ თანამშრომლობის გაფართოებას უახლესი თაობის AMD Instinct MI300 GPU სერვერების Hugging Face პლატფორმაში სრულფასოვანი ინტეგრაციის მიზნით. ეს ნაბიჯი დეველოპერებს საშუალებას მისცემს, მარტივად განათავსონ და მაქსიმალური წარმადობით გამოიყენონ ხელოვნური ინტელექტის მოდელები, კოდის შეცვლის გარეშე, ადგილობრივი გარემოდან დაწყებული Azure-ის საწარმოო ვირტუალურ მანქანებამდე. ინტეგრაცია მოიცავს CI/CD-ის გაუმჯობესებას, TGI-ის (text-generation-inference) ოპტიმიზაციას Meta Llama ოჯახი

SAIR: მონაცემთა ნაკრები, რომელიც რევოლუციას ახდენს ხელოვნური ინტელექტით წამლების დიზაინში
SAIR არის ღია კოდის მონაცემთა ნაკრები, რომელიც უფასოდ არის ხელმისაწვდომი CC BY 4.0 ლიცენზიით, რაც მას მყისიერად გამოსაყენებელს ხდის კომერციული და არაკომერციული კვლევა-განვითარების მიმართულებებისთვის. იგი წარმოადგენს სტრატეგიულ აქტივს, რომელიც ავსებს მონაცემთა დიდი ხნის არსებულ ხარვეზს ხელოვნური ინტელექტის (AI) მეშვეობით წამლების დიზაინში. SAIR აძლიერებს ფარმაცევტულ, ბიოტექნოლოგიურ და ტექ-ბიო ლიდერებს კვლევა-განვითარების დასაჩქარებლად, სამიზნე ჰორიზონტების გასაფართოებლად და AI მოდელების გასაძლიერ
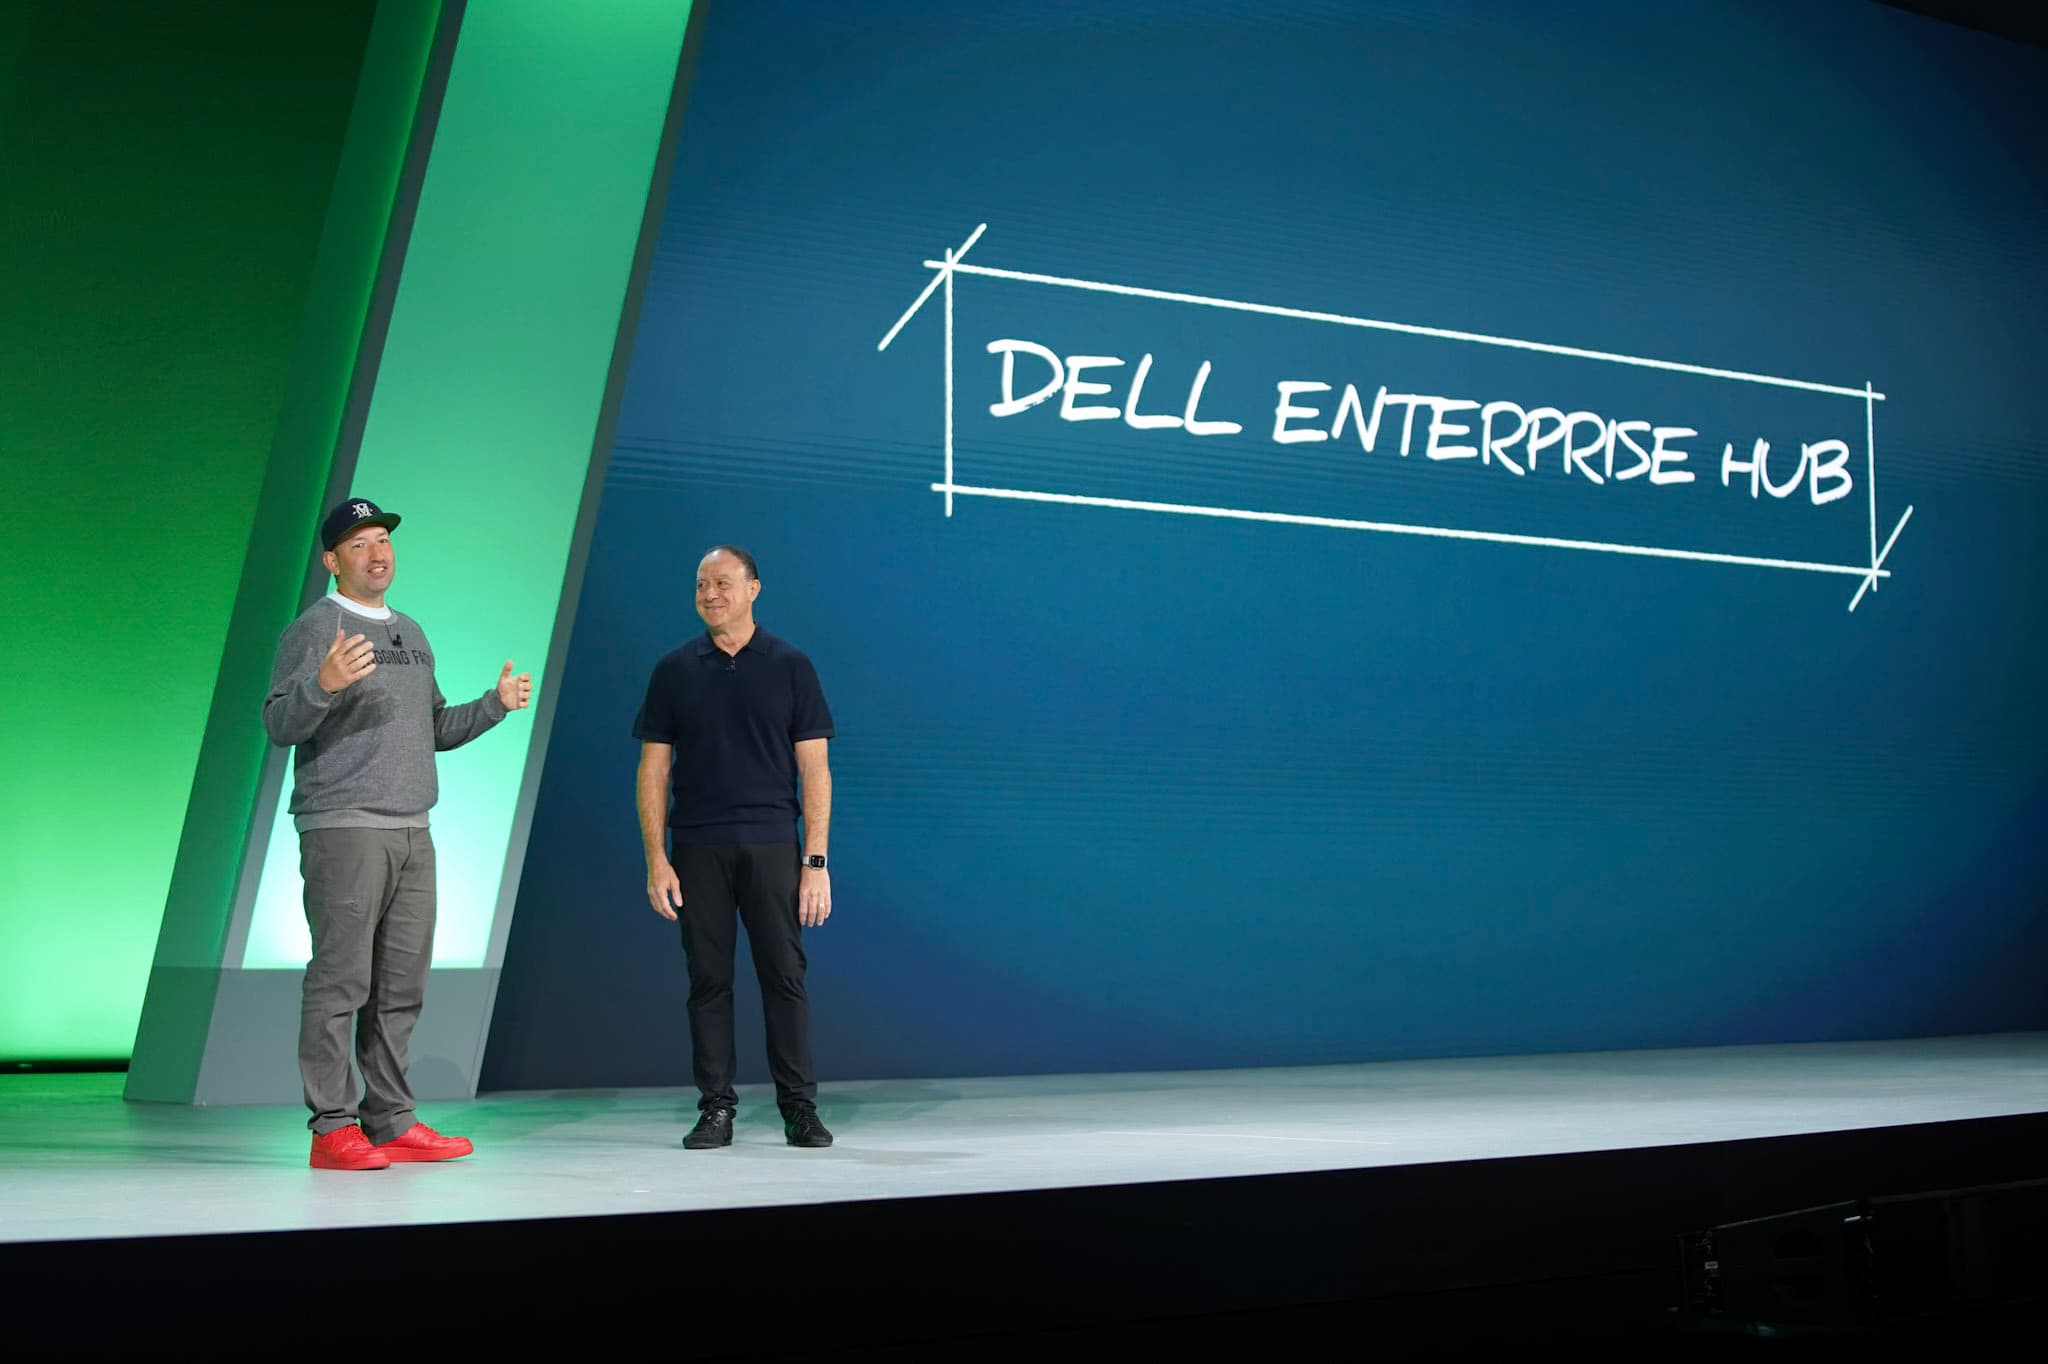
დღეს წარვადგენთ Dell Enterprise Hub-ს: ღია მოდელების მარტივი წვრთნა და განთავსება Dell-ის პლატფორმებზე
Dell Enterprise Hub, Hugging Face-ის ახალი შეთავაზება, ამარტივებს ღია ხელოვნური ინტელექტის მოდელების (როგორიცაა Llama 3 და Mixtral) ლოკალურ წვრთნასა და განთავსებას Dell-ის პლატფორმების გამოყენებით. ის კვირების საინჟინრო სამუშაოს წუთებამდე ამცირებს, გვთავაზობს შერჩეულ მოდელებს და უზრუნველყოფს უსაფრთხო, შესაბამის დახვეწასა და განთავსებას საწარმოს გარემოში.
Dell Enterprise Hub-ის გაშვება Hugging Face-ზე: ხელოვნური ინტელექტის მოდელების მარტივი ტრენინგი და განთავსება ადგილზე
Dell Technologies-ისა და Hugging Face-ის პარტნიორობის ფარგლებში, წარმოდგენილია Dell Enterprise Hub. ეს ახალი პლატფორმა საშუალებას აძლევს საწარმოებს, მარტივად მოამზადონ და განათავსონ ღია ხელოვნური ინტელექტის მოდელები საკუთარ ინფრასტრუქტურაზე (on-premises), Dell-ის პლატფორმების გამოყენებით. Dell Enterprise Hub მნიშვნელოვნად ამცირებს განთავსების დროს კვირებიდან წუთებამდე, უზრუნველყოფს მონაცემთა უსაფრთხოებას, კონფიდენციალურობასა და შესაბამისობას, და გთავაზობთ წვდომას უახლეს ღია მოდელებზე, როგორიცაა
AWS Inferentia2 აფართოებს ხელოვნური ინტელექტის შესაძლებლობებს Hugging Face-ის მომხმარებლებისთვის
Amazon Web Services (AWS) აცხადებს, რომ მისი უახლესი მანქანური სწავლების ჩიპი, Inferentia2, სრულად ხელმისაწვდომია Hugging Face Hub-ის მომხმარებლებისთვის. ეს ინტეგრაცია მნიშვნელოვნად ამარტივებს დიდი ენობრივი მოდელების (LLMs) და სხვა AI მოდელების განთავსებასა და გამოყენებას AWS SageMaker-ზე და Hugging Face Inference Endpoints-ის მეშვეობით. Inferentia2 ინსტანციები გვთავაზობს მაღალ წარმადობას, ხარჯთეფექტურობას და მხარდაჭერას 100,000-ზე მეტი მოდელისა და ამოცანისთვის, მათ შორის Llama 3-ისთვის, რაც ხელ

AI აგენტების გაძლიერება მონაცემთა მეცნიერებაში: Jupyter Agent-იდან Kaggle-ის მაღალი ხარისხის მონაცემებამდე
სტატია დეტალურად აღწერს Jupyter Agent-ის შექმნასა და განვითარებას, ხელოვნური ინტელექტის აგენტის, რომელიც შექმნილია Jupyter Notebook-ებში კოდის უშუალო შესასრულებლად მონაცემთა ანალიზისა და მონაცემთა მეცნიერების ამოცანების გადასაჭრელად. ხაზგასმულია ძალისხმევა მცირე ენობრივი მოდელების გაძლიერებაზე აგენტური ამოცანებისთვის, რათა მათ კონკურენცია გაუწიონ დიდ მოდელებს. პროექტი მოიცავს მაღალი ხარისხის სავარჯიშო მონაცემების გენერირებას Kaggle-ის ნოუთბუქებიდან, მოდელების დახვეწას და მათ შეფასებას DABStep-ის

NVIDIA-მ წარადგინა Palmyra-mini AI მოდელები გაუმჯობესებული მსჯელობის უნარებით
NVIDIA-მ გამოუშვა Palmyra-mini ხელოვნური ინტელექტის მოდელების ახალი სერია, მათ შორის 'მოაზროვნე' ვარიანტები, რომლებიც გაწვრთნილია აზროვნების ჯაჭვის (CoT) მიდგომით. ეს მოდელები მნიშვნელოვნად აუმჯობესებენ ლოგიკური აზროვნების უნარებს და ხელმისაწვდომია GGUF და MLX კვანტიზაციით. სერია მოიცავს მოდელებს, რომლებიც გამოირჩევიან რთული ამოცანების გადაჭრითა და მაღალი ქულებით სხვადასხვა ბენჩმარკებზე, რაც მათ მრავალმხრივ გადაწყვეტილებად აქცევს გენერაციული და ლოგიკური ამოცანებისთვის.

AI კონტენტის გამჭვირვალობა: Hugging Face აადვილებს წყლის ნიშნების დამატებას
Hugging Face წარმოგიდგენთ მარტივ გზას ხელოვნური ინტელექტის მიერ გენერირებულ კონტენტზე ხილული წყლის ნიშნების დასამატებლად Gradio-ს გამოყენებით. ეს ინიციატივა მიზნად ისახავს AI-გენერირებული სურათების, ვიდეოების, აუდიოსა და ტექსტების იდენტიფიცირების სირთულის დაძლევას, გამჭვირვალობის გაზრდას და მომხმარებლებისთვის ნდობის ამაღლებას. კომპანია დეველოპერულ საზოგადოებას მოუწოდებს, მიიღონ ეს პრაქტიკა პოტენციური კანონმდებლობის თავიდან ასაცილებლად.

RiskRubric.ai: ხელოვნური ინტელექტის მოდელების რისკების სტანდარტიზებული შეფასება
Hugging Face-ის ჰაბზე არსებული 500,000-ზე მეტი AI მოდელის უსაფრთხოებისა და სანდოობის შეფასების გამოწვევის საპასუხოდ, Cloud Security Alliance-მა და Noma Security-მ, Haize Labs-ისა და Harmonic Security-ის მონაწილეობით, წამოიწყეს RiskRubric.ai ინიციატივა. ეს პლატფორმა უზრუნველყოფს AI მოდელების რისკების გამჭვირვალე, სტანდარტიზებულ შეფასებას ექვსი ძირითადი სვეტის მიხედვით: გამჭვირვალობა, სანდოობა, უსაფრთხოება, კონფიდენციალურობა, უვნებლობა და რეპუტაცია. მიზანია დეველოპერებსა და ორგანიზაციებს დაეხმაროს
ხელოვნური ინტელექტის ტექსტიდან გამოსახულების გენერაციის ლიდერბორდი ადამიანის შეფასებებით
კომპანია Artificial Analysis-მა შექმნა ტექსტიდან გამოსახულების გენერაციის ხელოვნური ინტელექტის მოდელების ლიდერბორდი, რომელიც ადამიანის შეფასებებზე დაყრდნობით ზომავს მათ ხარისხს. ELO ქულები ეფუძნება 45,000-ზე მეტ ადამიანურ შეფასებას „Image Arena“-დან. ლიდერბორდზე წარმოდგენილია წამყვანი ღია კოდის და კომერციული მოდელები, როგორიცაა Midjourney, DALL·E და Stable Diffusion. საზოგადოებას შეუძლია მონაწილეობა მიიღოს შეფასების პროცესში და მიიღოს პერსონალიზებული რეიტინგი.
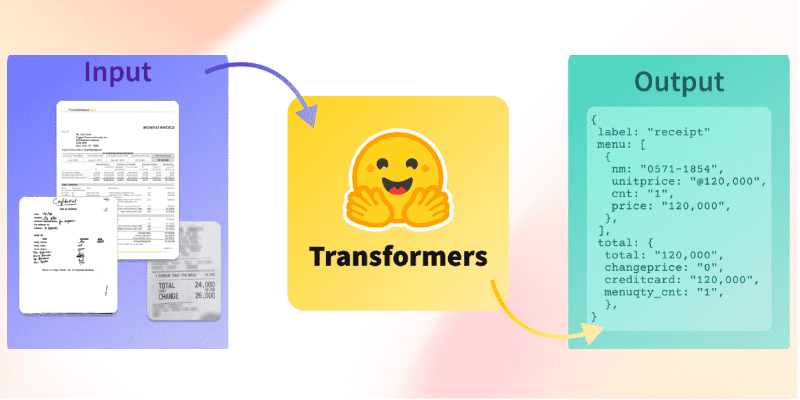
დოკუმენტების ხელოვნური ინტელექტი: OCR-დან დამუშავებამდე წამყვანი მოდელების გამოყენებით
ეს პოსტი იკვლევს დოკუმენტების ხელოვნურ ინტელექტს (Document AI), რომელიც მოიცავს მონაცემთა მეცნიერების სხვადასხვა ამოცანას, როგორიცაა ოპტიკური სიმბოლოების ამოცნობა (OCR), დოკუმენტების კლასიფიკაცია, განლაგების ანალიზი და დამუშავება (parsing). მასში წარმოდგენილია გამოყენების შემთხვევების ტაქსონომია, ხაზგასმულია საუკეთესო ღია კოდის მოდელები (მაგ., LayoutLM, Donut, DiT) და განხილულია ძირითადი ასპექტები, როგორიცაა ლიცენზირება, მონაცემთა მომზადება და შეფასების მეტრიკა. ტექსტი ხაზს უსვამს მულტიმოდალურ მ

Meta-მ Gaia2 წარმოადგინა: ახალი ბენჩმარკი AI აგენტებისთვის
კომპანია Meta-მ წარმოადგინა Gaia2, ახალი აგენტური ბენჩმარკი, რომელიც GAIA-ს გაგრძელებაა და მიზნად ისახავს ხელოვნური ინტელექტის აგენტების მნიშვნელოვნად უფრო რთული ქცევების ანალიზს. Gaia2 გამოვიდა Meta-ს ღია Agents Research Environments (ARE) ფრეიმვორქთან ერთად, რაც საშუალებას იძლევა აგენტების გაშვებას, გამართვას და შეფასებას რეალური სამყაროს მსგავს პირობებში. ბენჩმარკი აფასებს აგენტებს ინტერაქციულ ქცევაში, ბუნდოვანი ან დროში შეზღუდული მოთხოვნების შესრულებაში, ხმაურიან გარემოში ადაპტირებასა და ხელ

Transformers-ის დოკუმენტაციის მასშტაბური განახლება: რატომ გახდა ის აუცილებელი
Transformers-ის ბიბლიოთეკის დოკუმენტაცია, რომელიც თავდაპირველად მანქანური სწავლების ინჟინრებსა და მკვლევრებზე იყო მორგებული, ხელოვნური ინტელექტის (AI) სწრაფი განვითარების ფონზე მოუწესრიგებელი და მოძველებული გახდა. მიმდინარეობს მასშტაბური რედიზაინი, რათა დოკუმენტაცია გახდეს კოდზე ორიენტირებული, გადაწყვეტილებებისკენ მიმართული და მომხმარებელზე მორგებული, განსაკუთრებით კი დეველოპერებისთვის. მიზანია, უზრუნველყოს მისი ზრდა და ადაპტაცია მომავალ საჭიროებებთან, სიხისტე კი მოქნილობით ჩანაცვლდეს.

SyGra: ხელოვნური ინტელექტის მონაცემთა მომზადების პროცესის გამარტივება
ხელოვნური ინტელექტის (AI) მოდელებთან მუშაობისას, მონაცემთა მომზადება უსასრულო გამოწვევებს აჩენს. SyGra წარმოადგენს low-code/no-code ფრეიმვორკს, რომელიც ამარტივებს მონაცემთა ნაკრებების შექმნას, ტრანსფორმაციას და ოპტიმიზაციას LLM-ებისა და SLM-ებისთვის, რაც დეველოპერებს საშუალებას აძლევს, ფოკუსირება მოახდინონ მოდელების განვითარებაზე.