Hugging Face-ის Diffusers ბიბლიოთეკა 1 წლის ხდება: ინოვაციები და ღია ხელოვნური ინტელექტის მომავალი
Hugging Face-ის Diffusers ბიბლიოთეკა, რომელიც მიზნად ისახავს მანქანური სწავლების დემოკრატიზაციას და ეთიკური ხელოვნური ინტელექტის განვითარებას, 1 წლის გახდა. ამ ხნის განმავლობაში, საზოგადოების დახმარებით, ბიბლიოთეკას დაემატა უმნიშვნელოვანესი ფუნქციები, მათ შორის გაუმჯობესებული ტექსტი-გამოსახულებად გენერაცია (DeepFloyd IF, SDXL), ტექსტი-ვიდეოდ და ტექსტი-3D-დ გარდაქმნის შესაძლებლობები, გამოსახულების რედაქტირების ახალი მეთოდები, მნიშვნელოვანი ოპტიმიზაციები სიჩქარისთვის და უსაფრთხოების მექანიზმები არ

ხელოვნური ინტელექტის ვიდეო გენერაციის მოდელები: მიმდინარე მდგომარეობა და ოპტიმიზაციის გზები
ღია კოდის პროექტებში ვიდეოს გენერაციის მოდელების სწრაფი განვითარება შეინიშნება, რამაც შეიძლება გამოიწვიოს „Stable Diffusion მომენტის“ განმეორება ვიდეო საზოგადოებაში. ეს სტატია მიმოიხილავს ვიდეოს გენერაციის მოდელების მიმდინარე მდგომარეობას, მათ შეზღუდვებს (კერძოდ, მოძრაობის ხარისხს, თანმიმდევრულობასა და კონსისტენტურობას დროის განმავლობაში) და არქიტექტურულ თავისებურებებს, როგორიცაა 3D ვიდეო ტოკენების დამუშავება. ყურადღება ექცევა Diffusers-ის გუნდის მიერ შემოთავაზებულ მეხსიერების ოპტიმიზაციის ტექნი
ენკოდერ-დეკოდერ მოდელების ეფექტური წვრთნა: წინასწარ გაწვრთნილი კომპონენტების გამოყენების უპირატესობები
ახალი კვლევა გვთავაზობს ენკოდერ-დეკოდერ მოდელების წვრთნის ინოვაციურ მეთოდს, რომელიც მნიშვნელოვნად ამცირებს გამოთვლით ხარჯებს. BERT-ისა და GPT2-ის მსგავსი წინასწარ გაწვრთნილი ენკოდერის ან/და დეკოდერის კომპონენტების გამოყენებით, შესაძლებელია მაღალხარისხიანი შედეგების მიღწევა თანმიმდევრობა-თანმიმდევრობაზე ამოცანებში, როგორიცაა ტექსტის შეჯამება და მანქანური თარგმანი, სრული წინასწარი წვრთნის გარეშე. ეს მიდგომა ხელს უწყობს ხელოვნური ინტელექტის განვითარებას მცირე რესურსების მქონე გუნდებისთვისაც.

DeepSeek R1-ის გამოშვებიდან ორი კვირა: ღია-R1 პროექტის მიღწევები და გამოწვევები
სტატია აჯამებს ღია-R1 პროექტის განვითარებას, რომელიც DeepSeek R1-ის სასწავლო კონვეიერისა და სინთეზური მონაცემების რეპლიკაციას ისახავს მიზნად. მიღწევებს შორისაა DeepSeek-ის შეფასების ქულების რეპროდუცირება და GRPO-ის ინტეგრაცია TRL-ში. პროექტი DeepSeek R1-ის ხანგრძლივი პასუხების გამო GPU მეხსიერებისა და გენერაციის ეფექტურობის გამოწვევების წინაშე დგას, თუმცა ინფერენსის ოპტიმიზაციაში მნიშვნელოვანი პროგრესია. ინიციატივამ მედიის ფართო ინტერესიც გამოიწვია.

Hugging Face და IISc/ARTPARK ინდოეთის ლინგვისტური მრავალფეროვნების მხარდასაჭერად Vaani მონაცემთა ნაკრებს აფართოებენ
Hugging Face-ისა და IISc/ARTPARK-ის პარტნიორობა მიზნად ისახავს Vaani მონაცემთა ნაკრების ხელმისაწვდომობისა და გამოყენებადობის გაუმჯობესებას, რაც ხელს შეუწყობს AI სისტემების განვითარებას ინდოეთის მრავალფეროვანი ენების უკეთ გასაგებად. Project Vaani, რომელიც 2022 წელს IISc/ARTPARK-მა და Google-მა დაიწყეს, არის პიონერული ინიციატივა ღია კოდის მრავალმოდალური მონაცემთა ნაკრების შესაქმნელად, რომელიც ინდოეთის ლინგვისტურ მრავალფეროვნებას ასახავს. ამ მონაცემთა ნაკრებს უკვე მოიცავს 54 ენას და მოიცავს სპონტან
ხელოვნური ინტელექტი და მისი განვითარება: გამოწვევები, MLOps-ის მნიშვნელობა და ტრანსფორმერების აღზევება
ხელოვნური ინტელექტი (ხი) და მანქანური სწავლება (მს) სულ უფრო ხშირად გამოიყენება კრიტიკულ ინფრასტრუქტურაში, თუმცა ჩნდება კითხვები ინდუსტრიის სიმწიფისა და მასშტაბური დანერგვის შესახებ. სტატია განიხილავს მყარი მს-სამუშაო პროცესების შექმნის აუცილებლობას, ხაზს უსვამს MLOps-ის, როგორც DevOps-ის გაგრძელების, მნიშვნელობას და ამტკიცებს, რომ პროგრამული უზრუნველყოფის და DevOps ინჟინრები, რომლებსაც ესმით მანქანური სწავლება, უფრო მეტად არიან საჭირო, ვიდრე უბრალოდ მონაცემთა მეცნიერები. ასევე, ყურადღება ექცევა

Hugging Face-ის მუშაობა ხელოვნური ინტელექტის ეთიკაზე: რეგულაციების ფორმირება და ღიაობის ხელშეწყობა
Hugging Face დეტალურად აღწერს თავის ფართომასშტაბიან მუშაობას ხელოვნური ინტელექტის ეთიკის სფეროში, მათ შორის ევროკავშირის, დიდი ბრიტანეთისა და აშშ-ის კანონმდებლებთან თანამშრომლობას მომავალი რეგულაციების ჩამოსაყალიბებლად. კომპანია ხაზს უსვამს ღიაობის, ანგარიშვალდებულებისა და დემოკრატიზაციისადმი თავის ერთგულებას საჯარო გამოსვლებით, კვლევებითა და ახალი რესურსებით, რითაც ხაზგასმულია ადამიანური ღირებულებების ცენტრალური როლი პასუხისმგებლიანი ხელოვნური ინტელექტის განვითარებაში. ასევე აღინიშნება გუნდის მ

NVIDIA-ს რევოლუციური AI სიახლეები: Cosmos Transfer, Physical AI Dataset და Isaac GR00T N1
NVIDIA-მ წარადგინა ხელოვნური ინტელექტის (AI) სამი მნიშვნელოვანი სიახლე: Cosmos Transfer, რომელიც ზრდის ვირტუალური სამყაროს სცენების გენერირების სიზუსტეს; Physical AI Dataset, ღია კოდის მონაცემთა ნაკრები რობოტიკის ვარჯიშისთვის; და Isaac GR00T N1, მსოფლიოში პირველი ღია ფუნდამენტური მოდელი ჰუმანოიდური რობოტების მსჯელობისა და უნარებისთვის. ეს ინოვაციები მიზნად ისახავს ვირტუალური სამყაროების, რობოტიკისა და ავტონომიური სისტემების განვითარებას.
ხელოვნური ინტელექტის ღია მიდგომების წარმატება: რატომ არის ის სასიცოცხლოდ მნიშვნელოვანი?
ხელოვნური ინტელექტის (AI) განვითარებაში ღია მიდგომები არამხოლოდ უფრო გამჭვირვალე, ადაპტირებადი და მეცნიერულად დასაბუთებულია, არამედ მუდმივად აჭარბებს კომერციული შეთავაზებების წარმადობას. უახლესი მაგალითები, როგორიცაა OlympicCoder-ისა და OLMo 2-ის წარმატებები, ადასტურებს, რომ მძლავრი AI სტრატეგია ღია და კოლაბორაციულ განვითარებას უნდა ეფუძნებოდეს, რათა ხელი შეუწყოს ტექნოლოგიის წარმადობას, დანერგვასა და უსაფრთხოებას. სტატია გვთავაზობს სამ ძირითად რეკომენდაციას AI-ის ტექნიკური და ეკონომიკური წარმატე

ღრმა სწავლის დაჩქარება Intel Xeon CPU-ებზე: ტრანსფერული სწავლის ახალი შესაძლებლობები
გრაფიკული პროცესორების (GPU) ნაცვლად, ტრანსფერული სწავლის განვითარება ღრმა სწავლის მოდელების ოპტიმიზაციისთვის CPU-ზე დაფუძნებულ კლასტერებს საინტერესო ალტერნატივად აქცევს. ეს სტატია განმარტავს, თუ როგორ შეიძლება PyTorch-ის სასწავლო ამოცანების დაჩქარება Intel Xeon Scalable CPU სერვერების გამოყენებით, Ice Lake არქიტექტურაზე დაფუძნებული ვირტუალური მანქანების კლასტერის შექმნით და წარმადობაზე ოპტიმიზებული პროგრამული ბიბლიოთეკების ინსტალაციით, როგორიცაა Intel extension for PyTorch და oneCCL.
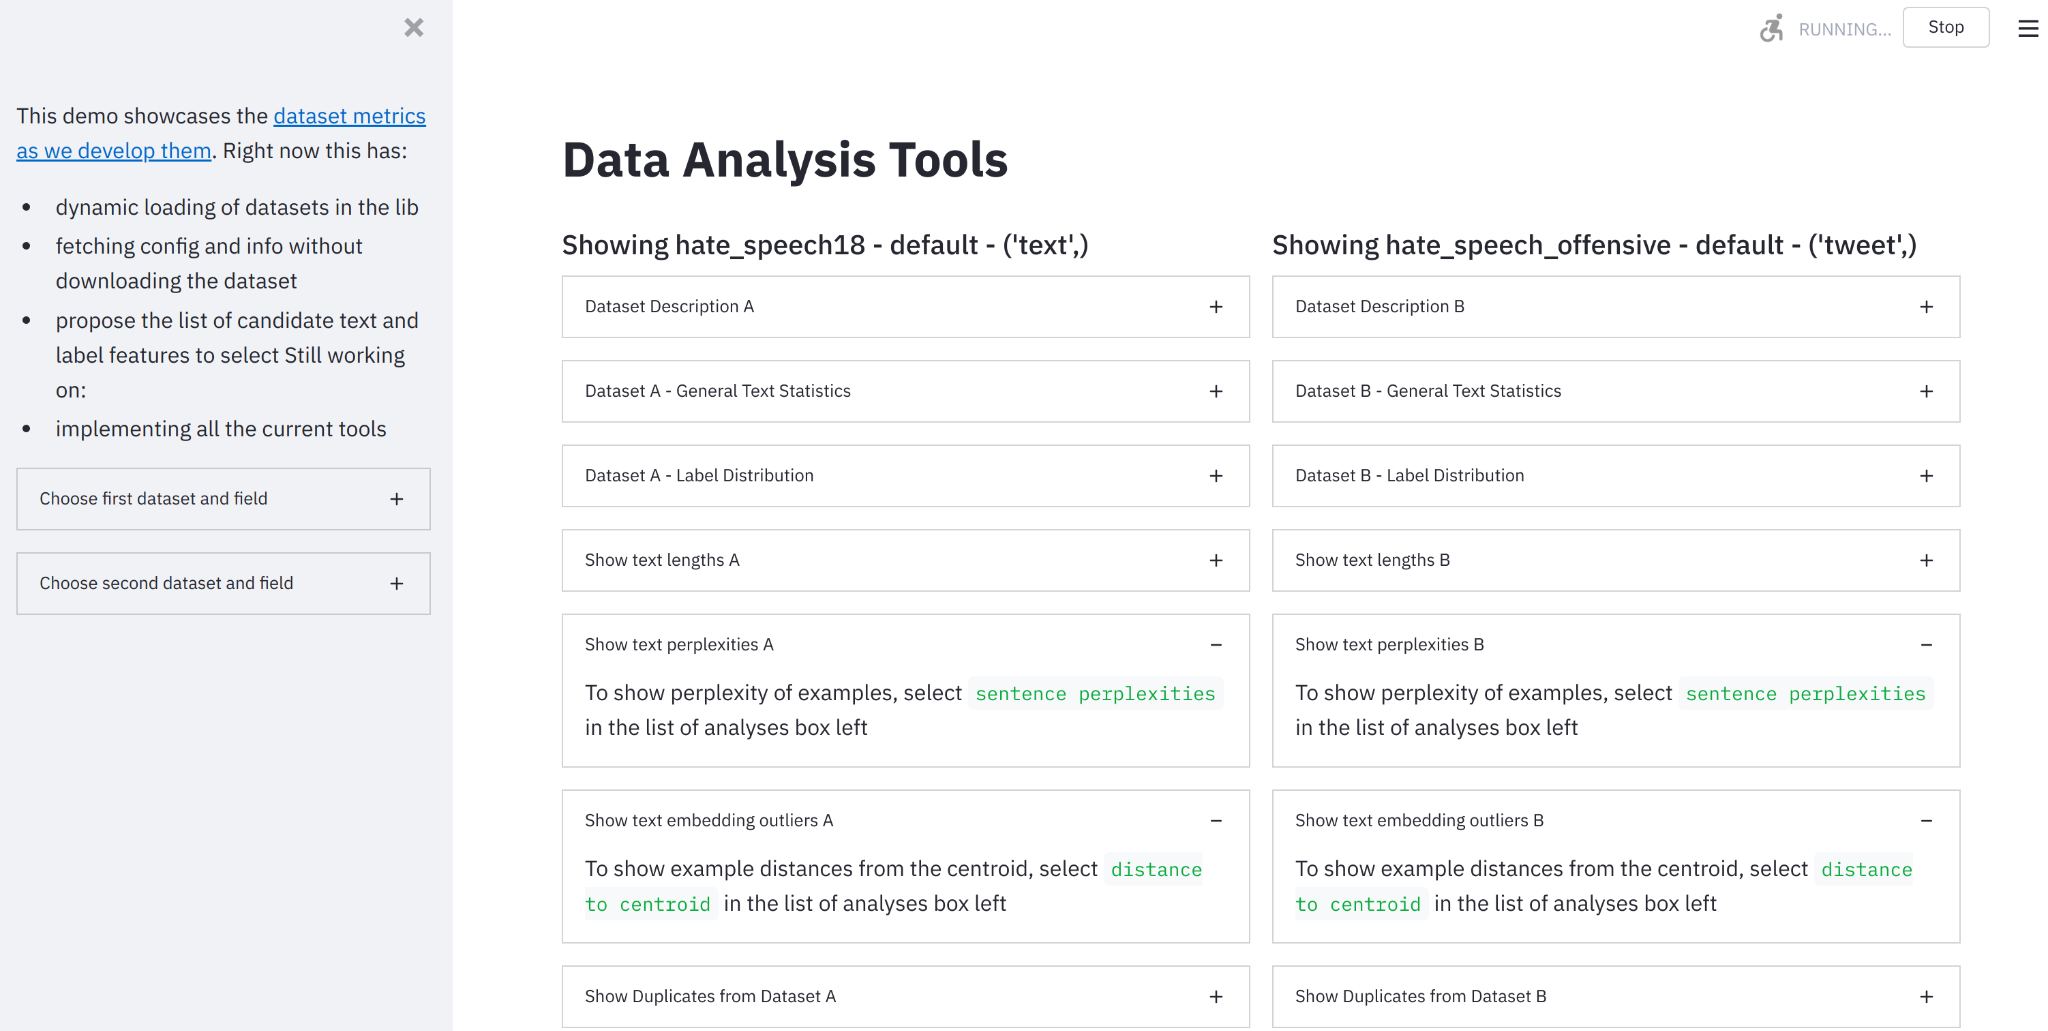
Hugging Face წარმოგიდგენთ მონაცემთა გაზომვის ხელსაწყოს AI მონაცემთა პასუხისმგებლიანი განვითარებისთვის
Hugging Face-ის გუნდმა გამოუშვა ღია კოდის Python ბიბლიოთეკა და უკოდო ინტერფეისი, სახელწოდებით „მონაცემთა გაზომვის ხელსაწყო“ (Data Measurements Tool - DMT). ეს ინსტრუმენტი მიზნად ისახავს მანქანური სწავლების მონაცემთა ნაკრებების გაგებას, შექმნას, კურირებასა და შედარებას. DMT პასუხობს ხელოვნური ინტელექტის განვითარებაში მონაცემთა გააზრებული ანალიზის ხარვეზს, განსაკუთრებით „დიდი მონაცემების“ გამოყენებისას არსებულ მიკერძოებებსა და ხარვეზებს. ის მომხმარებლებს საშუალებას აძლევს ავტომატურად გამოთვალონ მნ
Hugging Face: კონფიდენციალური მონაცემების ცენტრალიზებული მართვა Infisical-ით
Hugging Face-ის ინფრასტრუქტურის მრავალღრუბლოვან გარემოში განვითარებასთან ერთად, საინჟინრო გუნდმა მოითხოვა კონფიდენციალური მონაცემების მართვის უფრო მოქნილი, უსაფრთხო და ცენტრალიზებული მეთოდი. HashiCorp Vault-ის მსგავსი გადაწყვეტილებების შეფასების შემდეგ, მათ აირჩიეს Infisical მისი დეველოპერებისთვის მოსახერხებელი სამუშაო პროცესების, მრავალღრუბლოვანი აბსტრაქციისა და უსაფრთხოების მძლავრი შესაძლებლობების გამო. ამ მიგრაციამ მნიშვნელოვნად გააუმჯობესა უსაფრთხოების პოზიცია Kubernetes Operator-თან, CI/CD
NLP მოდელების შედარებითი ანალიზი: RoBERTa, Mistral-7b და Llama-2-7b LoRA-ს გამოყენებით კატასტროფის ტვიტების კლასიფიკაციისთვის
ბუნებრივი ენის დამუშავების (NLP) სწრაფად განვითარებად სამყაროში, ენობრივი მოდელების შედარება გადამწყვეტია მათი ოპტიმალური გამოყენებისთვის კონკრეტულ ამოცანებში. ეს პოსტი ეძღვნება სამი მოდელის – RoBERTa, Mistral-7b და Llama-2-7b – შედარებას კატასტროფების შესახებ ტვიტების კლასიფიკაციის პრობლემაში. კვლევაში გამოყენებულია PEFT (Parameter-Efficient Fine-Tuning) ტექნიკის LoRA (Low-Rank Adaptation) მეთოდი, რომელიც მნიშვნელოვნად ამცირებს პარამეტრების რაოდენობას მოდელის წვრილად მორგებისას. განხილულია თითო

Hugging Face-ის სასწავლო პლატფორმის მასშტაბური განახლება: NLP კურსი ახლა LLM კურსია
Hugging Face აცხადებს hf.co/learn პლატფორმის მასშტაბურ განახლებას, რომლის ფარგლებშიც პოპულარული NLP კურსი LLM კურსად გარდაიქმნა. ეს ცვლილება ასახავს ხელოვნური ინტელექტის სფეროში მიმდინარე სწრაფ განვითარებას, ამატებს ახალ თავებს დიდი ენობრივი მოდელების დახვეწასა და მსჯელობის მოდელების შექმნაზე, აფართოებს საზოგადოებასთან თანამშრომლობას და გეგმავს სერტიფიცირების პროგრამას მომავალში.

Gradio-ს 5-წლიანი გზა: როგორ გახდა ის AI ვებ აპლიკაციების სტანდარტი
5 წლის წინ Stanford-ის მკვლევრებისთვის შექმნილი Gradio დღეს მილიონობით დეველოპერს ეხმარება AI ვებ აპლიკაციების შექმნასა და გაზიარებაში. სტატია მიმოიხილავს Gradio-ს ზრდის სტრატეგიებს, მათ შორის, დაბალდონიანი API-ების განვითარებას მაღალი დონის აბსტრაქციების ნაცვლად, ვიწრო, მზარდ ნიშაზე ფოკუსირებას (ML ვებ აპლიკაციები) და მომხმარებლებისთვის გაზიარების მარტივი მექანიზმების შეთავაზებას.

Meta-მ Llama 4 მულტიმოდალური AI მოდელები გამოუშვა Hugging Face-ის ეკოსისტემისთვის
დღეს Meta-მ წარმოადგინა Llama 4-ის ახალი თაობის მძლავრი, მშობლიურად მულტიმოდალური AI მოდელები – Maverick და Scout. ეს მოდელები მნიშვნელოვან წინ გადადგმულ ნაბიჯს წარმოადგენს ხელოვნური ინტელექტის განვითარებაში, რომლებიც ინტეგრირებულია Hugging Face-ის ეკოსისტემაში. Llama 4 იყენებს ინოვაციურ ავტორეგრესიულ ექსპერტთა ნარევის (MoE) არქიტექტურას და მხარს უჭერს უზარმაზარ კონტექსტის სიგრძეებს (Scout-ისთვის 10 მილიონამდე ტოკენი), ასევე ტექსტური და გამოსახულების შეტანის დამუშავებას. მოდელები გაწვრთნილია 200

Hugging Face-ი Pollen Robotics-ს იძენს და ღია რობოტიკის მიმართულებას აძლიერებს
Hugging Face-მა Pollen Robotics შეიძინა, გუნდი, რომელიც 9 წელია ღია კოდის რობოტებს ქმნის. ეს ნაბიჯი Hugging Face-ის LeRobot-ის ინიციატივისა და ღია, ხელმისაწვდომი და კონფიდენციალური ხელოვნური ინტელექტის მქონე რობოტიკის ხედვის განვითარებას ემსახურება, რაც რობოტებს ყველასთვის ხელმისაწვდომს გახდის.

HELMET: ყოვლისმომცველი ბენჩმარკი გრძელკონტექსტური ენობრივი მოდელების შესაფასებლად
HELMET, რომელიც გასულ ოქტომბერს გამოვიდა, გახდა პოპულარული ინსტრუმენტი გრძელკონტექსტური ენობრივი მოდელების (LCLM) შესაფასებლად, რომელსაც იყენებენ ისეთი კომპანიები, როგორებიცაა Microsoft და AI21. მუდმივად განვითარებადი LCLM-ების გათვალისწინებით, HELMET გთავაზობთ ახალ, გაფართოებულ შეფასების მეთოდებს, რომლებიც წარმოდგენილი იქნება ICLR 2025-ზე. ეს ბენჩმარკი მიზნად ისახავს გადაჭრას არსებული შეფასების მეთოდების ნაკლოვანებები, უზრუნველყოფს მოდელების მრავალფეროვან, კონტროლირებად და საიმედო შედარებას რეა
რეტროსპექტივა: ღია დიდი ენობრივი მოდელები (LLM) 2023 წლამდე
ეს სტატია გთავაზობთ რეტროსპექტივას ღია დიდი ენობრივი მოდელების (LLM) განვითარებაზე, საუბრობს LLM-ების მიღების პროცესზე, მათ არქიტექტურაზე, სავარჯიშო მონაცემთა ნაკრებებზე, ტოკენიზაციაზე, ვარჯიშის ჰიპერპარამეტრებსა და ფაინ-ტიუნინგზე. განსაკუთრებული ყურადღება ეთმობა 2023 წლამდე არსებულ მნიშვნელოვან ღია მოდელებს, როგორიცაა BLOOM და OPT, რომლებიც დიდი როლი ითამაშეს ხელოვნური ინტელექტის საზოგადოების განვითარებაში.
Hugging Face იწვევს კანდიდატებს ხელოვნური ინტელექტის რეზიდენტურაზე: აქცენტით დივერსიასა და სოციალურ ზეგავლენაზე
Hugging Face აცხადებს მიღებას მანქანური სწავლების რეზიდენტურის პროგრამაზე, რომელიც მიზნად ისახავს ხელოვნური ინტელექტის დემოკრატიზაციას და პასუხისმგებლობით განვითარებას. პროგრამა ღიაა ყველა ფონის კანდიდატისთვის, განსაკუთრებული აქცენტით მათზე, ვისი პირადი გამოცდილებაც ასახავს საზოგადოების მარგინალიზებული ჯგუფების საჭიროებებს. აპლიკანტებს მოეთხოვებათ კვლევის გამოცდილება, პროგრამირების უნარები და სოციალურად პოზიტიური ზეგავლენის მოხდენის ინტერესი AI-ის საშუალებით. Hugging Face მხარს უჭერს მრავალფეროვ

MCP (Model Context Protocol): ახალი სტანდარტი AI აგენტებისა და LLM-ების ინტეგრაციისთვის
ბოლო კვირების განმავლობაში, MCP-ის (Model Context Protocol) სიღრმისეული შესწავლის შედეგად, ნათელი გახდა მისი მნიშვნელობა ხელოვნური ინტელექტის განვითარებაში. ეს არის მარტივი, მაგრამ ძლიერი სტანდარტული API, რომელიც დიდ ენობრივ მოდელებს (LLM) საშუალებას აძლევს, ეფექტურად გამოიყენონ სხვადასხვა ხელსაწყოები. სტატია დეტალურად აღწერს MCP კლიენტის განხორციელებას Typescript-ში და ხაზს უსვამს, თუ როგორ ამარტივებს ის Agentic AI-ს შექმნას. იგი განიხილავს LLM-ების „ფუნქციის გამოძახების“ შესაძლებლობებს და აჩვე
რატომ არღვევს Hugging Face-ის Transformers ბიბლიოთეკა DRY პრინციპს?
პროგრამული უზრუნველყოფის განვითარებაში ცნობილი „ნუ გაიმეორებ საკუთარ თავს“ (DRY) პრინციპის მიუხედავად, Hugging Face-ის Transformers ბიბლიოთეკა შეგნებულად უარს ამბობს მის გამოყენებაზე და იყენებს „ერთი მოდელის ფაილის პოლიტიკას“. ეს გადაწყვეტილება მიღებულია გარე კონტრიბუციების წახალისების, კოდის წაკითხვადობის გაუმჯობესების და მანქანური სწავლების სფეროს სწრაფი ევოლუციის გამო, რაც სტანდარტული ლოგიკური შაბლონების განსაზღვრას ართულებს.

ხილვად-ენობრივი მოდელების ტრანსფორმაცია: ბოლო ერთი წლის მიღწევები
სტატია მიმოიხილავს ხილვად-ენობრივი მოდელების (VLMs) განვითარებას ბოლო ერთი წლის განმავლობაში, LLaVA-ს თავდაპირველი წარმატებიდან უფრო მძლავრი, კომპაქტური და მრავალფეროვანი არქიტექტურების გამოჩენამდე. განხილულია ახალი პარადიგმები, როგორიცაა 'ნებისმიერი-ნებისმიერზე' (any-to-any) მოდელები, მულტიმოდალური RAG, მსჯელობის მოდელები და მცირე ზომის VLMs-ის ტენდენცია, რომლებსაც შეუძლიათ სამომხმარებლო მოწყობილობებზე მუშაობა.
წამყვანი ML დირექტორების შეხედულებები: ხელოვნური ინტელექტის გავლენა ინდუსტრიებზე
მანქანური სწავლების (ML) და მონაცემთა მეცნიერების დირექტორებს უაღრესად რთული მოთხოვნები აქვთ თავიანთ როლებში. ამ სტატიების სერიაში, ჩვენ წარმოგიდგენთ ML დირექტორების უნიკალურ შეხედულებებს მიმდინარე ML ტენდენციებსა და ინდუსტრიულ განვითარებაზე, დაწყებული ჯანდაცვიდან ფინანსებამდე, ელექტრონულ კომერციამდე და სხვა სფეროებამდე. ისინი გაგვიზიარებენ გამოცდილებას ML-ის პრაქტიკული გამოყენების შესახებ რეალურ სამყაროში, ისეთი ინოვაციების ჩათვლით, როგორიცაა ნახშირბადის ემისიების შემცირება ტრანსპორტირებაში ან