Hugging Face-ის მულტიმოდალური სწავლის ჯგუფი ხელოვნური ინტელექტის ეთიკურ პრინციპებს აფორმალებს
Hugging Face-ის მულტიმოდალური სწავლის ჯგუფმა დაასახელა ეთიკური პრინციპები თავისი ხელოვნური ინტელექტის პროექტისთვის, რაც მიზნად ისახავს გამჭვირვალობის, ადრეული უკუკავშირისა და პოტენციური ზიანის შემცირების უზრუნველყოფას. დოკუმენტი აღიარებს „ეთიკური ხელოვნური ინტელექტის“ არასრულყოფილ დეფინიციას და ხაზს უსვამს რისკებისა და სარგებლის შეფასების აუცილებლობას თითოეულ კონკრეტულ შემთხვევაში, ამასთან ერთად აცხადებს, რომ ეს არის მუშა პროცესში არსებული დოკუმენტი.
Twitter-ზე სენტიმენტების ანალიზი: დამწყებთათვის სრული გზამკვლევი
ეს გზამკვლევი მოიცავს ყველაფერს, რაც უნდა ისწავლოთ Twitter-ზე სენტიმენტების ანალიზის დასაწყებად, როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. თქვენ გაეცნობით Inference API-ის გამოყენებას კოდის რამდენიმე ხაზით ან Zapier-ის, უ-კოდო ხელსაწყოს მეშვეობით, ტვიტების შესაგროვებლად, გასაანალიზებლად და შედეგების Google Sheets-ში გასაგზავნად. ისწავლეთ, როგორ გამოიყენოთ მანქანური სწავლება ბრენდის მონიტორინგისთვის და მომხმარებლის უკუკავშირის გასაანალიზებლად.
Twitter-ზე სენტიმენტების ანალიზი: სრული გზამკვლევი
ეს გზამკვლევი წარმოგიდგენთ Twitter-ზე სენტიმენტების ანალიზის ყოვლისმომცველ, ნაბიჯ-ნაბიჯ პროცესს, რომელიც განკუთვნილია როგორც პროგრამისტებისთვის, ასევე არაპროგრამისტებისთვის. ის განმარტავს სენტიმენტების ანალიზის არსს, მის მნიშვნელობას ბიზნესისთვის და გვიჩვენებს, თუ როგორ შეიძლება ისეთი ხელსაწყოების გამოყენება, როგორიცაა Inference API, Zapier და Python-ის ბიბლიოთეკები, რათა ტვიტებიდან ღირებული ინფორმაცია მოვიპოვოთ, მომხმარებელთა უკუკავშირი აღმოვაჩინოთ და ბრენდის ხსენებებს რეალურ დროში დავაკვირდეთ.
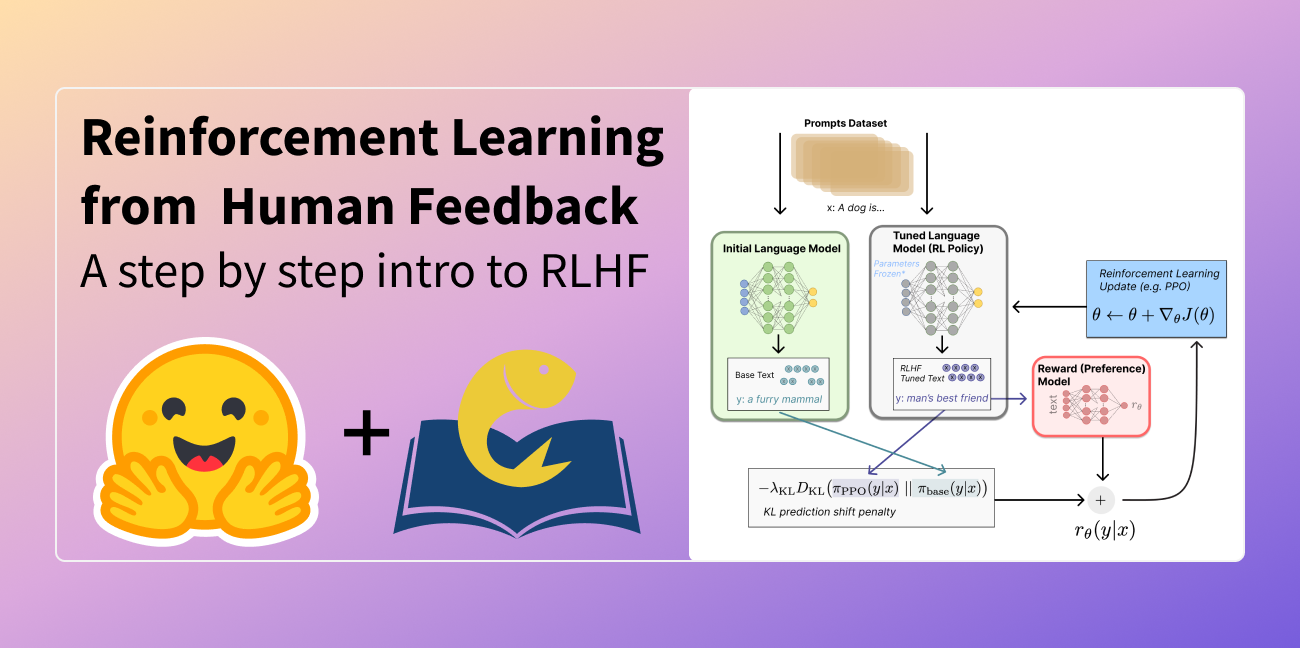
RLHF: როგორ აუმჯობესებს ადამიანის უკუკავშირი ენის მოდელებს?
RLHF (გაძლიერებული სწავლა ადამიანის უკუკავშირით) არის ინოვაციური მეთოდი, რომელიც ენის მოდელებს ადამიანის პრეფერენციებთან მისადაგებაში ეხმარება. ტრადიციული დანაკარგის ფუნქციებისა და მეტრიკების შეზღუდვების საპასუხოდ, RLHF იყენებს გაძლიერებული სწავლის ტექნიკას, რათა უშუალოდ მოახდინოს მოდელების ოპტიმიზაცია ადამიანის უკუკავშირის საფუძველზე. სტატია განმარტავს RLHF-ის კომპლექსურ პროცესს, მათ შორის წინასწარ გაწვრთნილი მოდელების გამოყენებას და ჯილდოს მოდელების შექმნას ადამიანის პრეფერენციების ინტეგრირები
AI თამაშების დიზაინში: ChatGPT, ენობრივი მოდელები და მათი გამოყენება
ეს სტატია აგრძელებს სერიას ხელოვნური ინტელექტის (AI) თამაშების განვითარებაში გამოყენების შესახებ. წინა ნაწილში განვიხილეთ AI ვიზუალური სტილის შესაქმნელად, ახლა კი ყურადღება გამახვილებულია AI-ის თამაშების დიზაინში გამოყენებაზე. კერძოდ, განხილულია, თუ როგორ შეიძლება ChatGPT-ის გამოყენება თამაშის იდეების გენერირებისთვის. სტატია დეტალურად ხსნის, რა არის ენობრივი მოდელი, როგორ მუშაობს ChatGPT (ტრანსფორმერებისა და ადამიანის უკუკავშირით გაძლიერებული სწავლის (RLHF) მექანიზმების ჩათვლით) და რა ხდის მას ა

რობერტ კენედი უმცროსის აუტისტური კომიტეტი ვაქცინების ირგვლივ სადავო შეხედულებებს აძლიერებს
აშშ-ის ჯანდაცვის მდივანმა რობერტ ფ. კენედი უმცროსმა უწყებათაშორისი აუტიზმის საკოორდინაციო კომიტეტი (IACC) ვაქცინების მოწინააღმდეგე პირებით დააკომპლექტა, რომლებსაც მიაჩნიათ, რომ აუტიზმს ვაქცინები იწვევს. აუტიზმის ადვოკატები შიშობენ, რომ ეს ჯგუფი საფრთხეს შეუქმნის ფსევდომეცნიერული მკურნალობის მეინსტრიმში დამკვიდრებას. ჯანდაცვის ექსპერტები და აუტიზმის ადვოკატები კენედის გადაწყვეტილებას ეწინააღმდეგებიან, რადგან არ არსებობს მტკიცებულება ვაქცინებსა და აუტიზმს შორის კავშირის დასამტკიცებლად. კომიტეტის წ

ChatGPT Health: ხელოვნური ინტელექტი ჯანმრთელობისთვის - შესაძლებლობები და საფრთხეები
OpenAI-მ 2026 წლის იანვარში გამოუშვა ChatGPT Health, ახალი სპეციალიზებული ფუნქცია, რომელიც მომხმარებლებს საკუთარი ჯანმრთელობის უკეთ გაგებასა და მართვაში ეხმარება. სერვისი სამედიცინო ჩანაწერებისა და ჯანმრთელობის აპლიკაციების დაკავშირების საშუალებას იძლევა პერსონალური რჩევებისთვის, თუმცა ის არ არის ხელმისაწვდომი ევროკავშირის ქვეყნებში. ექსპერტები სერიოზულ რისკებზე საუბრობენ, მათ შორის არასწორი ინფორმაციის მიწოდებაზე, სახიფათო სიმპტომების გამოტოვებაზე და პასუხისმგებლობის საკითხის ბუნდოვანებაზე, რამ
MIT-ის კვლევა: დიდი ენის მოდელების (LLM) რეიტინგები საოცრად მგრძნობიარეა მომხმარებლის უკუკავშირის მიმართ
MIT-ის მკვლევრებმა აღმოაჩინეს, რომ დიდი ენის მოდელების (LLM) რეიტინგული პლატფორმები საოცრად მგრძნობიარეა მომხმარებლის უკუკავშირის მიმართ. მათმა კვლევამ აჩვენა, რომ კრაუდსორსინგული მონაცემების მცირე ნაწილის ამოღებასაც კი შეუძლია რეიტინგების შეცვლა, რამაც შესაძლოა კომპანიები შეცდომაში შეიყვანოს საუკეთესო მოდელის არჩევისას. მკვლევრებმა შეიმუშავეს ეფექტური მეთოდი, რომელიც ავლენს შედეგების დამახინჯებაზე პასუხისმგებელ ინდივიდუალურ შეფასებებს, რაც ხაზს უსვამს რეიტინგების შეფასების უფრო მკაცრი სტრატეგიე