
არაბული AI მოდელების შეფასების პლატფორმისა და AraGen ეტალონის მნიშვნელოვანი განახლებები
მიმდინარე ძალისხმევის ფარგლებში, წარმოდგენილია მნიშვნელოვანი განახლებები არაბული AI მოდელების შეფასების პლატფორმაზე. ამოქმედდა Arabic-Leaderboards, რომელიც არაბული ენის მოდელების შეფასებისთვის ერთიან სივრცეს წარმოადგენს. დეკემბერში დაინერგა AraGen ეტალონი დინამიური შეფასების მეთოდოლოგიით, სადაც მონაცემთა ნაკრები სამი თვის განმავლობაში კონფიდენციალური რჩება სამართლიანი შეფასებისთვის. გაფართოვდა AraGen მონაცემთა ნაკრები და დაიხვეწა შემფასებელი სისტემის მოთხოვნები. მიუხედავად იმისა, რომ ახალმა განა
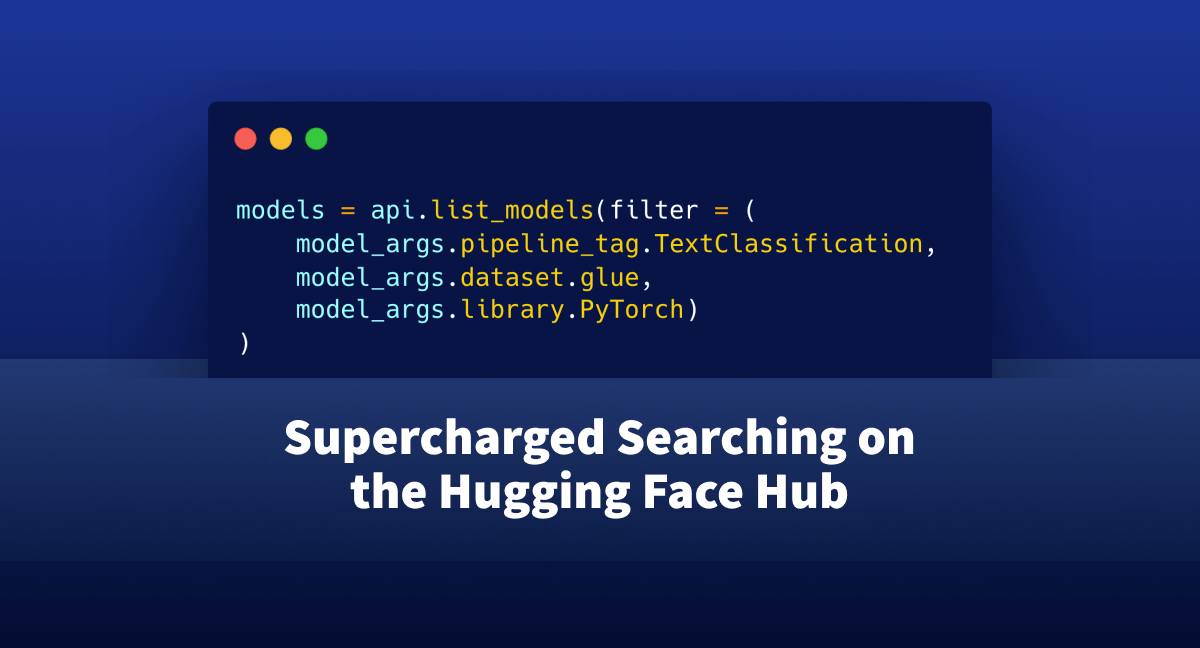
Hugging Face Hub-ის ძიების გამარტივება: პროგრამული ინტერფეისის ახალი შესაძლებლობები
სტატიაში წარმოდგენილია `huggingface_hub` ბიბლიოთეკის ახალი ფუნქციები, `ModelSearchArguments` და `ModelFilter`, რომლებიც მნიშვნელოვნად ამარტივებს Hugging Face Hub-ზე AI მოდელებისა და მონაცემთა ნაკრებების ძიებას პირდაპირ Python-ის ან Jupyter-ის გარემოდან. ეს სიახლე დეველოპერებს საშუალებას აძლევს, არ დატოვონ IDE და ეფექტურად მართონ რთული მოთხოვნები, რაც მნიშვნელოვნად აუმჯობესებს სამუშაო პროცესს.
წარმოგიდგენთ aMUSEd-ს: ეფექტურ არადიფუზიურ ტექსტიდან გამოსახულების გენერაციის მოდელს
გაეცანით aMUSEd-ს, Google-ის MUSE-ის ღია რეპროდუქციას. ეს არის სწრაფი, არადიფუზიური ტექსტიდან გამოსახულების გენერაციის მოდელი, რომელიც ეფუძნება ნიღბიანი გამოსახულების მოდელირების (MIM) მეთოდოლოგიას. მიუხედავად იმისა, რომ მისი ხარისხი არ არის უმაღლესი დონის, ის გვთავაზობს სტილის გადაცემის, გამოსახულების inpainting-ის შესაძლებლობებს და ხელს უწყობს MIM ფრეიმვორკების კვლევას. მოდელი გამოშვებულია ნებადართული ლიცენზიით, მარტივია მის დასაკონფიგურირებლად და მუშაობს დაბალი GPU VRAM მოთხოვნებით.
წამყვანი ML დირექტორების შეხედულებები: ხელოვნური ინტელექტის გავლენა ინდუსტრიებზე
მანქანური სწავლების (ML) და მონაცემთა მეცნიერების დირექტორებს უაღრესად რთული მოთხოვნები აქვთ თავიანთ როლებში. ამ სტატიების სერიაში, ჩვენ წარმოგიდგენთ ML დირექტორების უნიკალურ შეხედულებებს მიმდინარე ML ტენდენციებსა და ინდუსტრიულ განვითარებაზე, დაწყებული ჯანდაცვიდან ფინანსებამდე, ელექტრონულ კომერციამდე და სხვა სფეროებამდე. ისინი გაგვიზიარებენ გამოცდილებას ML-ის პრაქტიკული გამოყენების შესახებ რეალურ სამყაროში, ისეთი ინოვაციების ჩათვლით, როგორიცაა ნახშირბადის ემისიების შემცირება ტრანსპორტირებაში ან

AI-ის ძალა მუსიკალურ შემოქმედებაში: Arm-ის პროცესორებით სტუდიური ხმის გენერაცია პირდაპირ მოწყობილობაზე
პროგრამისტმა და მუსიკალურმა პროდიუსერმა შექმნა ინოვაციური აპლიკაცია, რომელიც Arm-ზე დაფუძნებული CPU-სა და ღია კოდის AI მოდელების გამოყენებით, პირდაპირ მოწყობილობაზე გენერირებს სტუდიური ხარისხის ჟღერადობას. ეს ინსტრუმენტი უზრუნველყოფს სწრაფ, პირად და შეუფერხებელ სამუშაო პროცესს მუსიკალური პროდიუსერებისთვის, რაც მათ საშუალებას აძლევს, წამებში შექმნან უნიკალური ხმები მარტივი მოთხოვნებით, ყოველგვარი ღრუბლოვანი სერვისების ან GPU-ს საჭიროების გარეშე. პროექტი გვიჩვენებს კონტენტის შექმნის მომავალს მოწყო
Haize Labs-მა და Hugging Face-მა დიდი ენობრივი მოდელების უსაფრთხოების ახალი ეტალონი, „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ წარადგინეს
დიდი ენობრივი მოდელების (დემ) კვლევის სწრაფი ტემპის ფონზე, Haize Labs-მა, Hugging Face-ის გულუხვი მხარდაჭერით, გამოაქვეყნა „წითელი გუნდის წინააღმდეგობის ბენჩმარკი“ (Red Teaming Resistance Benchmark). ეს ახალი ეტალონი მიზნად ისახავს მოწინავე დემ-ების მოწყვლადობების საფუძვლიან შემოწმებას ადამიანის მიერ შექმნილი, ბუნებრივი ენის მსგავსი მავნე მოთხოვნების (prompts) გამოყენებით, განსხვავებით ხელოვნური, ავტომატიზებული შეტევებისგან. ბენჩმარკი აფასებს მოდელების მდგრადობას არასასურველი ქცევების მიმართ, რო

vLLM-ის ოპტიმიზაცია: პრეფილის სტრატეგიები და გრძელი მოთხოვნების მართვა
სტანდარტულად, vLLM-ში პრეფილის ფაზა თანმიმდევრულად ამუშავებს მოთხოვნებს, რაც პრობლემური ხდება გრძელი "პრომპტების" შემთხვევაში, რადგან მათ შეუძლიათ შეაფერხონ შემდგომი მოთხოვნები და გაზარდონ შეყოვნება. მიუხედავად იმისა, რომ პარალელური პრეფილის მცდელობები არსებობდა, ისინი რესურსების ოპტიმიზაციის პრობლემებს აწყდებოდნენ. vLLM-ის უახლესმა განახლებამ წარმოადგინა გაუმჯობესებული სტრატეგია, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას გრძელი მოთხოვნების შეფერხების გარეშე, რაც მნიშვნელოვ
vLLM-ის ოპტიმიზაცია: პრეფილისა და დეკოდირების გამოწვევების დაძლევა
ეს სტატია განიხილავს დიდი ენობრივი მოდელების (LLM) ინფერენსის ოპტიმიზაციის გამოწვევებს vLLM-ში, განსაკუთრებით "პრეფილის" ფაზაში, სადაც გრძელ პრომპტებს შეუძლიათ შეაფერხონ მომდევნო მოთხოვნები. იგი აღწერს გაუმჯობესებულ სტრატეგიას, რომელიც იძლევა მოკლე მოთხოვნების პარალელური პრეფილის საშუალებას, ხოლო გრძელი მოთხოვნებისთვის თანმიმდევრულ დამუშავებას ინარჩუნებს. ასევე წარმოდგენილია "დეზაგრეგირებული პრეფილი" – უფრო რადიკალური გადაწყვეტა ტოკენის გენერაციის შენელების აღმოსაფხვრელად, თუმცა რესურსების უფრო

GaLore: გარღვევა ხელოვნური ინტელექტის მოდელების ვარჯიშში სამომხმარებლო GPU-ებზე
GaLore-ის ინოვაციური შესაძლებლობა, ავარჯიშოს 7 მილიარდ პარამეტრამდე ხელოვნური ინტელექტის მოდელები, როგორიცაა Llama არქიტექტურაზე დაფუძნებული მოდელები, სამომხმარებლო GPU-ებზე (მაგალითად, NVIDIA RTX 4090), წარმოადგენს მნიშვნელოვან გარღვევას. ეს მიიღწევა ოპტიმიზატორის მდგომარეობებისა და გრადიენტებისთვის საჭირო მეხსიერების მოთხოვნების მკვეთრი შემცირებით, დაბალი რანგის პროექციისა და 8-ბიტიანი სიზუსტის ოპტიმიზატორების კომბინაციით, რაც დიდ მოდელებს უფრო ხელმისაწვდომს ხდის ფართო მომხმარებლისთვის და ზღვა
სემანტიკური ძიება მუსიკაში: დასაკრავი სიების გენერირება Sentence Transformers-ითა და Gradio-თი
ეს სტატია განიხილავს, თუ როგორ შეიძლება Sentence Transformers-ის სემანტიკური ძიების გამოყენება მუსიკალური დასაკრავი სიების შესაქმნელად ტექსტური მოთხოვნების საფუძველზე. დეტალურად არის აღწერილი სიმღერის ტექსტების ემბედინგების გენერირებისა და შენახვის პროცესი, შესაბამისი მოდელების შერჩევა და Gradio აპლიკაციის იმპლემენტაცია, რომელიც მომხმარებლებს საშუალებას აძლევს ეძებონ სიმღერები სემანტიკური მსგავსების მიხედვით და იხილონ მათი ტექსტები.
AI-ის რევოლუცია მონაცემებთან ურთიერთობაში: DuckDB-NSQL-7B და ტექსტიდან SQL-ზე გადასვლა
ხელოვნური ინტელექტის (AI) და დიდი ენობრივი მოდელების (LLM) განვითარება რევოლუციას ახდენს მონაცემთა ანალიზში. ტრადიციულად, SQL ქუერების შექმნა მოითხოვდა სპეციალიზებულ ცოდნას, რაც ხელმისაწვდომობის ხარვეზს ქმნიდა. MotherDuck-მა და Numbers Station-მა წარმოადგინეს DuckDB-NSQL-7B, LLM, რომელიც სპეციალურად DuckDB SQL-ისთვისაა შექმნილი. ეს მოდელი მომხმარებლებს საშუალებას აძლევს, ბუნებრივი ენით ჩამოაყალიბონ მონაცემთა მოთხოვნები, რომლებსაც მოდელი ავტომატურად თარგმნის SQL ბრძანებებში. სტატიაში დეტალურად არ

BLOOM ინფერენსის ოპტიმიზაცია GPU-ებზე: წარმადობის ბენჩმარკინგი
ეს სტატია განიხილავს BLOOM ხელოვნური ინტელექტის მოდელის ინფერენსის ოპტიმიზაციას სხვადასხვა GPU კონფიგურაციებზე. მოცემულია აპარატურული მოთხოვნები 352GB bf16 წონებისთვის, სადაც რეკომენდებულია 8x80GB A100 GPU-ები, თუმცა განიხილება ალტერნატივებიც. სტატია აანალიზებს მოდელის ჩატვირთვის დროს და ტოკენების გენერირების წარმადობას (throughput) ისეთი გადაწყვეტების გამოყენებით, როგორიცაა Deepspeed-Inference და Accelerate, ასევე 8-ბიტიანი კვანტიზაცია მეხსიერების შესამცირებლად. ბენჩმარკინგის შედეგები აჩვენებს

Meta-მ Gaia2 წარმოადგინა: ახალი ბენჩმარკი AI აგენტებისთვის
კომპანია Meta-მ წარმოადგინა Gaia2, ახალი აგენტური ბენჩმარკი, რომელიც GAIA-ს გაგრძელებაა და მიზნად ისახავს ხელოვნური ინტელექტის აგენტების მნიშვნელოვნად უფრო რთული ქცევების ანალიზს. Gaia2 გამოვიდა Meta-ს ღია Agents Research Environments (ARE) ფრეიმვორქთან ერთად, რაც საშუალებას იძლევა აგენტების გაშვებას, გამართვას და შეფასებას რეალური სამყაროს მსგავს პირობებში. ბენჩმარკი აფასებს აგენტებს ინტერაქციულ ქცევაში, ბუნდოვანი ან დროში შეზღუდული მოთხოვნების შესრულებაში, ხმაურიან გარემოში ადაპტირებასა და ხელ

მონაცემთა ნაკრებების შექმნა: საზოგადოების ძალისხმევა და მრავალენოვანი ინიციატივები Hugging Face-ისგან
სტატია აღწერს Hugging Face-ის საზოგადოების მიერ მონაცემთა ნაკრებების შექმნის მიზნით გაწეულ ძალისხმევას. ინიციატივა მოიცავს მოთხოვნების (prompts) რანჟირების პროექტსა და მრავალენოვანი მოთხოვნების შეფასების პროექტს (MPEP), რომელიც მიზნად ისახავს ღია LLM-ებისთვის ენობრივი ბენჩმარკების გაუმჯობესებას. ხაზგასმულია საზოგადოების წვლილის მნიშვნელობა მყარი და ყოვლისმომცველი რესურსების შესაქმნელად.

ახალი კვლევა AI-ს მტკიცებებს ძირს უთხრის: მოდელები საავტორო უფლებებით დაცულ კონტენტს ინახავენ და იმეორებენ
სტენფორდისა და იელის უნივერსიტეტების ახალმა კვლევამ აჩვენა, რომ წამყვანი AI კომპანიების ენობრივი მოდელები, როგორიცაა OpenAI, Anthropic და Google, საავტორო უფლებებით დაცული სავარჯიშო მონაცემების ასლებს ინახავენ და არა მხოლოდ „შაბლონებს სწავლობენ“. ეს აღმოჩენა ფუნდამენტურად ეჭვქვეშ აყენებს კომპანიების იურიდიულ არგუმენტებს „კეთილსინდისიერი გამოყენების“ (fair use) შესახებ, ვინაიდან მოდელებს მარტივი მოთხოვნებით შეუძლიათ ცნობილი ნაწარმოებებიდან ათასობით სიტყვის სიტყვასიტყვით რეპროდუცირება.
Tipsy Chat: AI-ის ძალა გამოსახულების გენერაციისა და ინტერაქტიული მოთხრობებისთვის
Tipsy Chat აერთიანებს ხელოვნური ინტელექტის შესაძლებლობებს ტექსტური მოთხოვნებიდან მაღალი ხარისხის გამოსახულებების გენერირებისთვის, დიზაინის სპეციალური ცოდნის გარეშე. გარდა ამისა, ის გთავაზობთ ინტერაქტიულ როლურ თამაშებს AI პერსონაჟებთან, სადაც მომხმარებლებს შეუძლიათ სიუჟეტის განვითარება და სრულფასოვანი ციფრული სამყაროს შექმნა.
MIT-ის ახალი მიდგომა: მცირე ენის მოდელები ერთობლივი მუშაობით დიდებს ჯობნიან
მიუხედავად იმისა, რომ ენის მოდელები (LMs) უმჯობესდებიან სხვადასხვა ამოცანებში, მათ მაინც უჭირთ რთული და მკაცრი წესების მქონე მოთხოვნების შესრულება. ამ პრობლემის გადასაჭრელად, MIT-ის მკვლევრებმა შეიმუშავეს „DisCIPL“ – თანამშრომლობითი მიდგომა, სადაც დიდი ენის მოდელი (LLM) გეგმავს ამოცანას, შემდეგ კი მის შესრულებას მცირე მოდელებს ანაწილებს. ეს მეთოდი მცირე ენის მოდელებს საშუალებას აძლევს, მიაწოდონ უფრო ზუსტი და ეფექტური პასუხები, ვიდრე წამყვან LLM-ებს, როგორიცაა GPT-4o, და მიუახლოვდნენ მაღალი დონის

Google-ის AI ძიება იცვლება: SEO სტრატეგიები ახალი რეალობისთვის
Google-ის AI Overviews (AIO) ძიების შედეგებში მნიშვნელოვან ცვლილებებს განიცდის, რაც SEO სპეციალისტებს ახალი სტრატეგიების შემუშავებას ავალდებულებს. აღმოაჩინეთ, თუ როგორ იყენებს Google ხელოვნურ ინტელექტს სხვადასხვა ტიპის მოთხოვნებისთვის და რა კონტენტი იმსახურებს მაღალ ხილვადობას AI ეპოქაში.

AI ძიება ცვლის თამაშის წესებს: SEO-ს ევოლუცია AEO/GEO-ს ეპოქაში
ხელოვნური ინტელექტი რევოლუციას ახდენს ძიების სამყაროში, რაც SEO-ს სპეციალისტებს ახალი გამოწვევების წინაშე აყენებს. AEO/GEO-ს შესახებ მიმდინარე დებატები, AI ძიების ახალი მოდელები და კონტენტის ოპტიმიზაციის ცვალებადი მოთხოვნები განაპირობებს ციფრული მარკეტინგის მომავალს.